결론 먼저
기존 메모리 벤치마크에서 준최고 점수를 내던 에이전트들이 MemoryArena에서는 평균 태스크 성공률 0.12~0.17에 그칩니다. 그룹 여행 계획 환경에서는 모든 방법의 성공률이 0.00이었습니다.
핵심은 이겁니다. 기억을 ‘불러오는 것’과 기억을 ‘다음 행동에 쓰는 것’은 다른 능력입니다. 기존 벤치마크는 앞쪽만 측정했구요.
MemoryArena는 기억-에이전트-환경 루프 안에서 이 둘을 같이 측정합니다. 사람이 직접 만든 상호의존 서브태스크에서, 이전 세션에서 배운 것을 메모리로 증류하고 그 메모리로 뒤의 행동을 해결해야 점수가 나옵니다.
기준일: arXiv 2602.16313, 2026년 등록. ICML 2026 정규 논문으로 어셉트됐습니다.
핵심 요약 표
| 항목 | 값 |
|---|---|
| 논문 | MemoryArena: Benchmarking Agent Memory in Interdependent Multi-Session Agentic Tasks (arXiv 2602.16313) |
| 소속 | Stanford, UCSD, UIUC, Princeton, Pittsburgh, 2077AI |
| 문제 | 기존 벤치마크는 암기(recall)와 행동(action)을 분리해 측정 |
| 구성 | 번들 쇼핑, 그룹 여행 계획, 점진적 웹 검색, 수학·물리 형식 추론 |
| 규모 | 태스크당 평균 57 액션 스텝, 추론 트레이스 40k+ 토큰 |
| 핵심 결과 | 롱컨텍스트 에이전트 평균 SR 0.12~0.17, 그룹 여행은 전 방법 SR 0.00 |
| 데이터 | Hugging Face ZexueHe/memoryarena, CC-BY-4.0 |
| 원문 | https://arxiv.org/abs/2602.16313 |
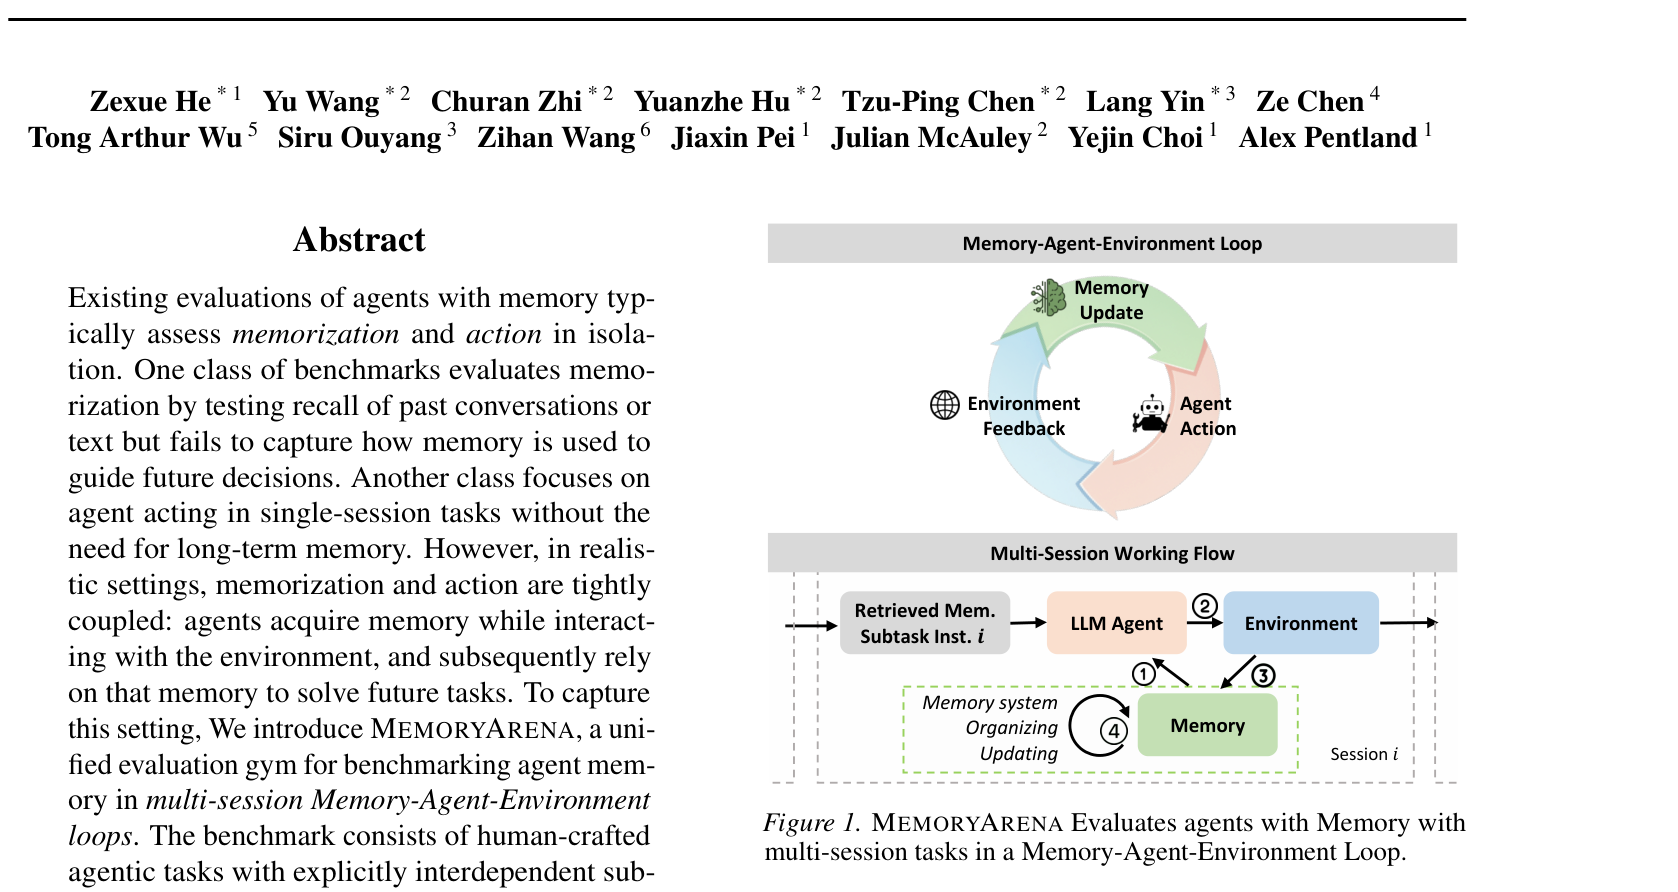
Figure 1 출처: arXiv 2602.16313, MemoryArena 티저 그림
기존 메모리 벤치마크의 한계
메모리 평가 벤치마크는 크게 두 부류로 나뉩니다.
첫 부류는 LoCoMo, LongMemEval, MemoryAgentBench, MemoryBench, EvoMem 같은 회상(recall) 중심입니다. 과거 대화를 읽고 단일 질문에 답하는 형태구요. 에이전트가 환경과 상호작용하며 메모리를 능동적으로 쓰는 과정은 없습니다.
다른 부류는 WebArena류 행동 벤치마크입니다. 여기는 액션은 있지만 단일 세션이라 장기 메모리가 필요 없습니다.
실제 환경에서는 둘이 묶여 있습니다. 초반 상호작용에서 호환성 조건이나 중간 추론 결과 같은 잠재 제약이 생기고, 환경은 이걸 다시 말해주지 않습니다. 에이전트가 스스로 보관했다가 뒤의 결정에 적용해야 하구요.
이전 글 환경 탐색 기반 에이전트 메모리 큐레이션과 맥락 임베딩 메모리 이식에서 다뤘던 문제의 평가 쪽을 본격적으로 다루는 작업입니다.
네 가지 평가 환경
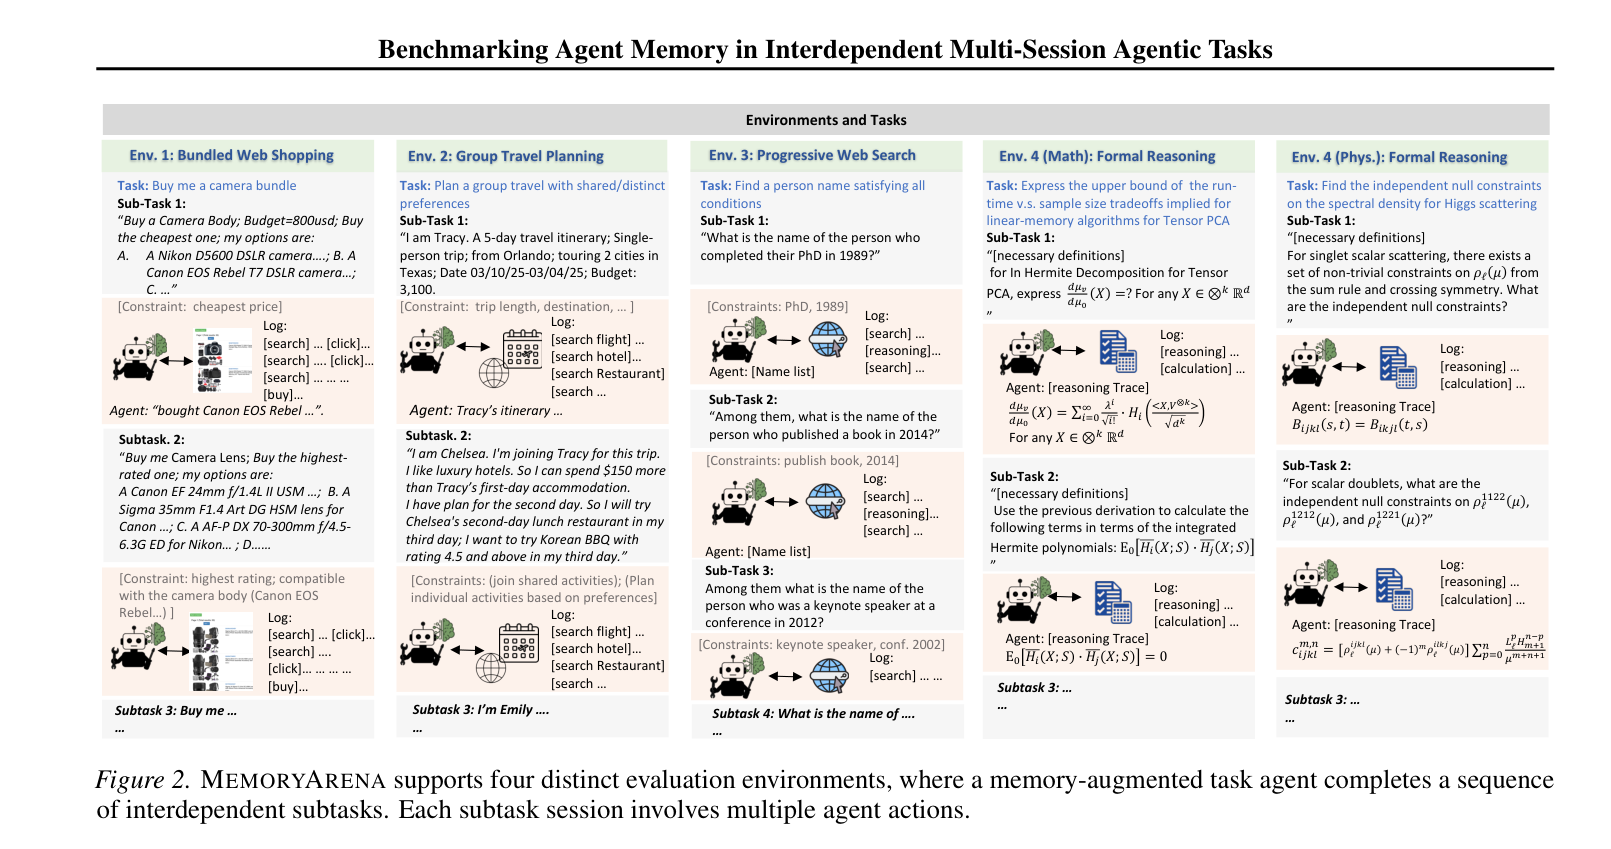
Figure 2 출처: arXiv 2602.16313, 네 평가 환경 구조
| 환경 | 서브태스크 min~max | 평균 트레이스 길이 | 태스크 수 |
|---|---|---|---|
| 번들 웹 쇼핑 | 6~6 | 41.5k | 150 |
| 그룹 여행 계획 | 5~9 | 40.6k | 270 |
| 점진적 웹 검색 | 2~16 | 122.4k | 256 |
| 수학 형식 추론 | 2~16 | 18.1k | 40 |
| 물리 형식 추론 | 2~12 | 14.1k | 20 |
번들 쇼핑은 WebShop 환경에서 관련 제품을 여러 번에 걸쳐 삽니다. 나중 구매가 이전 아이템 속성 회수에 의존하고, 교차 호환성 같은 전역 제약이 걸립니다.
그룹 여행 계획은 첫 여행자 일정에 참가자가 점점 붙는 구조입니다. 선임 참가자의 활동과 선호를 정확히 기억해야 새 제약과 기존 계획의 충돌을 풀 수 있구요. 의존 체인이 깊이 4까지 갑니다.
점진적 웹 검색은 검색 조건이 단계마다 하나씩 추가됩니다. 최종 답은 지금까지 들어온 모든 조건을 만족해야 합니다.
형식 추론은 학습 이론, 미분기하 같은 연구 수준 수학·물리 논문의 정리 증명을 나눠 놓은 겁니다. 앞 서브태스크에서 세운 정의와 보조정리를 뒤에서 재사용해야 합니다.
메인 결과: 성공률이 무너지는 지점
평가는 태스크 에이전트 GPT-5.1-mini에 메모리 방식을 바꿔 끼워서 돌렸습니다. 롱컨텍스트(전 히스토리를 프롬프트에 그대로 붙이기) 기준 결과입니다.
| 방식 | 전체 평균 SR |
|---|---|
| GPT-5.1-mini 롱컨텍스트 | 0.16 |
| GPT-4.1-mini 롱컨텍스트 | 0.12 |
| Gemini-3-Flash 롱컨텍스트 | 0.17 |
그룹 여행 계획은 모든 방법이 SR·PS 전부 0.00이라 논문이 별도 soft Progress Score(sPS)를 도입할 정도였습니다. sPS 기준으로도 GPT-5.1-mini 0.58, Gemini-3-Flash 0.76이 최고 수준이었습니다.
눈에 띄는 패턴은 SR과 PS의 격차입니다. 대부분 방법에서 서브태스크 단위 진척 점수(PS)는 성공률(SR)보다 훨씬 높습니다. 개별 서브태스크는 어느 정도 풀지만, 이걸 전역적으로 일관된 해답으로 통합하는 데 실패한다는 뜻입니다.
LoCoMo 같은 회상 벤치마크에서 준포화 점수를 내던 에이전트가 이 설정에서 무너지는 것이 이 논문의 핵심 관찰입니다.
외부 메모리와 RAG가 도움이 되는 조건
외부 메모리(Letta, Mem0, Mem0-g, Mirix, ReasoningBank)와 RAG(BM25, 텍스트 임베딩)가 항상 유리한 건 아니었습니다.
점진적 웹 검색과 형식 추론에서는 일관된 성능 향상이 있었습니다. 이 두 환경은 트레이스가 120k+ 토큰으로 길거나 도메인 추론이 무거워서, 롱컨텍스트가 주의 포화(attention saturation)와 오류 누적에 취약한 구간입니다. 외부 메모리가 정보를 선별·증류해 이를 완화해줍니다.
반대로 앞서 얻은 정보의 정확한 재사용이 필요한 작업, 예를 들어 형식 추론의 중간 결과 회수나 여행 계획의 정확한 활동·시간대 참조에서는 검색 기반이 더 강했습니다. 무거운 추상화·통합을 하는 외부 메모리보다 RAG의 SR@k 감쇠가 더 완만했습니다.
서브태스크 깊이 k가 깊어질수록 모든 방법의 성공률이 감쇠합니다. 평평하게 유지되는 방법은 없었고, 롱컨텍스트도 외부 메모리도 깊은 상호의존 태스크를 안정적으로 지탱하지 못한다는 결론입니다.
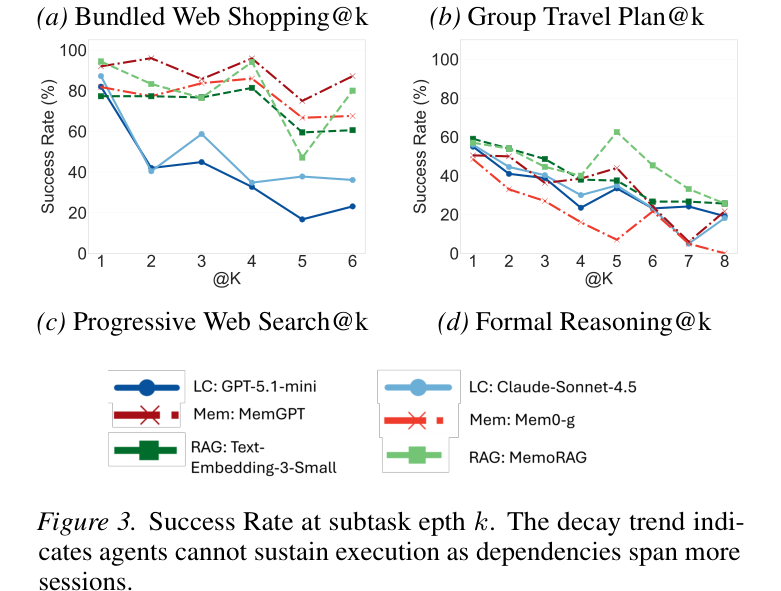
Figure 3 출처: arXiv 2602.16313, 서브태스크 깊이 k에서의 성공률 감쇠
레이턴시 트레이드오프도 있습니다. 외부 메모리 에이전트의 지연이 가장 크고, 롱컨텍스트가 가장 낮습니다. 롱컨텍스트는 성적이 몇몇 설정에서 경쟁력을 유지하면서도 지연이 가장 낮았습니다.
RAG와 외부 메모리의 트레이드오프는 RAG vs Cartridges 지식 주입 비교에서 다룬 선택 문제와 같은 축으로 볼 수 있구요, 긴 트레이스의 위험 측면은 MemRiskBench의 트레이스 기반 위험 평가와 이어집니다.
실무 관점 교훈
메모리 시스템 도입 결정을 벤치마크 회상 점수만으로 하지 마시구요, 실제 워크플로와 비슷한 다중 세션 태스크에서 측정하고 도입하세요.
정확한 재사용이 중요한 도메인(코드, 수학, 예약)에서는 복잡한 메모리 파이프라인보다 검색 기반이 나을 수 있습니다.
메모리 평가를 설계할 때 SR 하나만 보면 안 됩니다. PS와의 격차가 ‘부분 해결은 되는데 통합에 실패’하는 실패 모드를 숨겨줍니다.
한계도 적습니다. 환경 5개로 도메인 커버리가 제한적이구요, 태스크 에이전트를 GPT-5.1-mini로 고정한 메인 결과가 많습니다. 태스크당 평균 57스텝 실행이라 평가 비용도 작지 않습니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
- MemoryArena가 기존 벤치마크와 다른 점은 뭔가요? — 회상과 행동을 분리하지 않고, 다중 세션 상호의존 태스크 안에서 메모리 획득과 사용을 같이 평가합니다.
- 어떤 모델·메모리 시스템을 평가했나요? — GPT-5.1/4.1-mini, Gemini-3-Flash, Claude-Sonnet-4.5 롱컨텍스트와 Letta, Mem0, Mem0-g, Mirix, ReasoningBank, BM25/임베딩 RAG입니다.
- 데이터와 코드는 공개됐나요? — Hugging Face
ZexueHe/memoryarena로 데이터가 CC-BY-4.0으로 공개됐고, 프로젝트 페이지(memoryarena.github.io)에서 확인할 수 있습니다. - 롱컨텍스트와 외부 메모리 중 뭘 써야 하나요? — 정확한 정보 재사용이 중요하면 검색 계열, 트레이스가 매우 길고 추론이 무거우면 외부 메모리가 유리한 경향이 관측됐습니다.
참고
- 원문: He et al., “MemoryArena: Benchmarking Agent Memory in Interdependent Multi-Session Agentic Tasks”, arXiv:2602.16313 (ICML 2026)
- 프로젝트 페이지: https://memoryarena.github.io/
- 데이터: https://huggingface.co/datasets/ZexueHe/memoryarena
- 비교 대상 벤치마크: LoCoMo, LongMemEval, MemoryAgentBench, MemoryBench, EvoMem, WebArena