결론 먼저
문서를 컨텍스트에 넣는 RAG, 파라미터에 넣는 파인튜닝, KV 캐시에 넣는 Cartridges/Compaction 중 뭘 쓸지 정리했습니다. Amazon AGI 팀의 비교 실험 논문 “Where Should a Document Live: Context, Representations, or Parameters?”(arXiv:2609.17346) 결과입니다.
핵심은 이겁니다.
- 단일 문서 오라클 세팅에서는 Compaction(2×)이 평균 73.4로 ICL 상한(73.6)과 사실상 동일
- 문서를 여러 개 검색해 조합하는 현실 세팅에서는 Cartridges만 ICL과 동급이고, 파라미터 방식은 29점 뒤짐
- 근데 Cartridges는 압축률을 높이면 일반 능력이 깎임. HumanEval이 고압축에서 16점 하락
- 요약하면 모든 조건을 다 이기는 방법은 없고, 세팅별로 골라야 합니다
기준일: 2026-09-17 기준, arXiv v1 논문 수치입니다. 실험 모델은 Qwen3-8B(보조 검증 Gemma-3-12B)입니다.
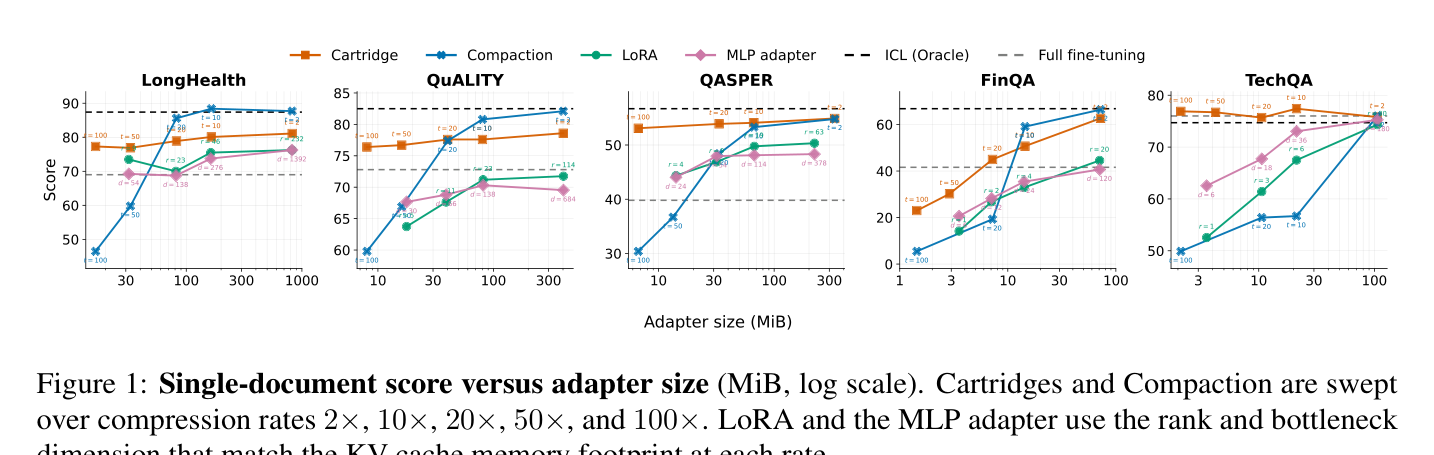 Figure 1. 단일 문서 설정: 어댑터 크기 대비 점수 (원문 Figure 1)
방법 비교 요약
| 방법 | 문서 위치 | 평균 점수(단일 문서) | 다중 문서 조합 | 치명적 망각 |
|---|---|---|---|---|
| No context | 없음 | 24.9 | — | — |
| ICL (RAG) | 컨텍스트 윈도우 | 73.6 (상한선) | 상한선 | 없음 |
| Cartridges | 압축 KV 캐시 | 70.6 | ICL과 동급 | 있음(코딩 −13%) |
| Compaction | 압축 KV 캐시 | 73.4 | 급격히 하락 | 없음 |
| LoRA (rank 64) | 가중치 | 64.5 | 병합 시 붕괴 | 없음 |
| MLP 어댑터 | 가중치 | 62.2 | 병합 시 붕괴 | 크면 발생 |
| Full fine-tuning | 전체 가중치 | 59.8 | (공동 학습 시 낫다) | 가장 심함 |
점수는 Qwen3-8B, 2× 압축/LoRA rank 64/MLP bottleneck 512 고정 조건, 5개 지식 QA 벤치마크(LongHealth, QuALITY, QASPER, FinQA, TechQA) 평균입니다.
문서를 어디에 둘 것인가: 세 후보
LLM이 사전학습에 없는 지식(사내 문서, 진료 기록, 법률 코퍼스)으로 질문에 답하려면 문서를 모델에 전달해야 합니다. 후보는 세 가지입니다.
- 컨텍스트 윈도우에 넣기 — RAG/ICL. 매 쿼리마다 문서 전체를 다시 prefill해야 해서 비용이 반복 발생합니다
- 파라미터에 넣기 — LoRA, MLP 어댑터, full fine-tuning. 문서를 한 번 학습해서 가중치에 저장합니다
- 잠재 표현에 넣기 — Cartridges, Compaction. 문서를 압축된 KV 캐시 prefix로 만들어서 추론 시 로드합니다
기존 연구는 위키피디아처럼 모델이 이미 본 문서로 평가해서 “재현”을 측정한 경우가 많았구요, 이 논문은 진짜 새 지식 주입을 5개 벤치마크에서 통제 비교한 점이 다릅니다.
단일 문서: Compaction이 ICL 상한과 동급
정답 문서 하나만 넣어주는 오라클 세팅입니다.
- No context가 24.9에 그친 걸 보면, 점수는 실제로 주입된 지식에서 나옵니다. FinQA에서 격차가 가장 컸습니다. 문서 표에서 숫자를 뽑아야 하는 태스크라서요
- Compaction 2×가 73.4로 ICL(73.6)과 거의 동일하고, Cartridges는 70.6입니다
- 파라미터 쪽 최강인 LoRA는 64.5, full fine-tuning은 59.8으로 최하입니다. full fine-tuning은 포맷이 무너지는 태스크(QASPER F1, FinQA 수식)에서 특히 약했습니다
압축률을 올리면 그림이 바뀝니다. Compaction은 급격히 무너져서 FinQA 66.4(2×) → 19.3(20×), LongHealth 87.7 → 46.5(100×)까지 떨어집니다. Cartridges는 거의 평평하게 유지돼요(LongHealth 81.1 → 77.3, TechQA 75.8 → 76.9). 저장 용량을 맞춰 비교하면 고압축 영역에서 Cartridges가 모든 데이터셋에서 파라미터 방식을 이깁니다.
다중 문서 조합: 여기서 Cartridges가 유일한 생존자
현실적인 RAG 세팅(청크 검색 → 문서 매핑 → 어댑터 조합)에서는 결과가 갈립니다.
- Cartridges는 k=1에서 k=10으로 늘어나도 유지되거나 올라갑니다. LongHealth 70.8 → 83.2, QuALITY 72.5 → 74.6
- Compaction은 모든 데이터셋에서 단조 하락합니다. TechQA 65.4 → 26.4까지
- LoRA 병합은 더 빨리 무너져요. TechQA 57.4 → 23.5(k=3), FinQA 34.5 → 4.9(k=3)
- 병합 방식을 바꿔도(TIES, DARE, concat) 소용없었습니다. 문제는 병합 연산자 선택이 아니라, 독립 학습된 어댑터를 조합하는 방식 자체입니다
- 문서 전체를 한 번에 학습하는 공동 학습(joint)이 병합보다 낫지만, 그마저도 조합된 Cartridges에는 못 미칩니다
정리하면 Compaction과 파라미터 주입은 단일 문서 세팅에서만 유효하고, 다중 문서 조합은 Cartridges만 지원합니다. 다만 이 결과는 Cartridges에 mixed training을 적용한 후속 연구(Hardalov et al., 2026) 덕분입니다.
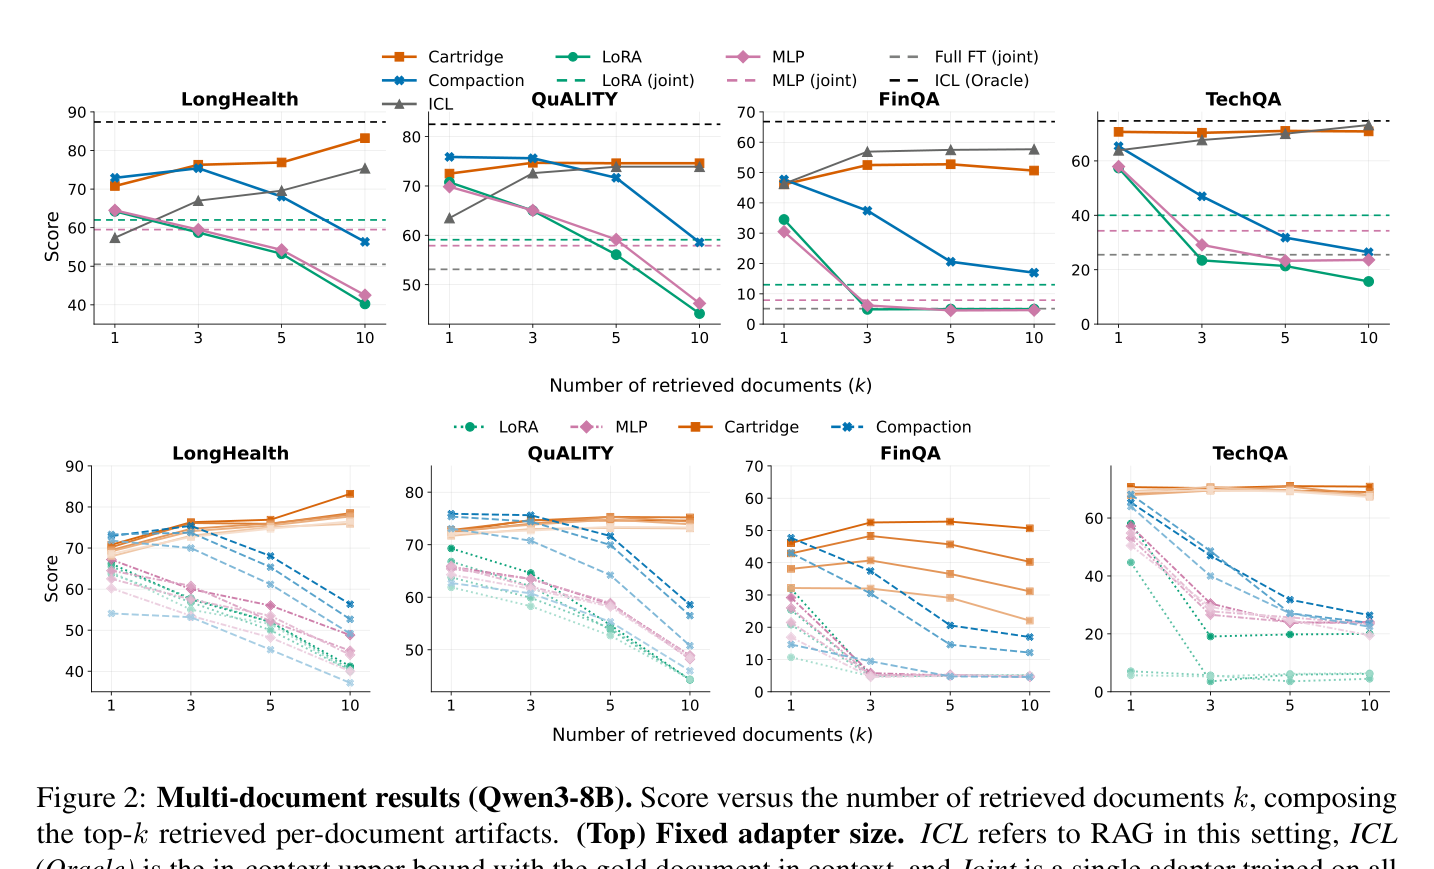 Figure 2. 다중 문서 조합 결과 (원문 Figure 2)
치명적 망각: 무료 점심은 없다
지식 주입이 일반 능력(GSM8K, HumanEval, IFEval, MMLU)을 깎는지도 측정했습니다.
- Compaction은 모든 압축률에서 베이스 모델 유지
- Cartridges는 평균 −6%, 특히 코딩에서 HumanEval이 고압축에서 −16점
- LoRA는 모든 rank에서 안정. MLP 어댑터는 bottleneck이 커지면 GSM8K가 92 → 60까지 하락
- full fine-tuning은 가장 심하게 망각합니다
논문의 해석이 흥미로운데요, 망각의 원인은 압축 KV 캐시 자체도 아니고 파라미터 수도 아니고 풀랭크(full-rank) 업데이트입니다. 저랭크 제약이 정규화 역할을 한다는 거예요. 그래서 파라미터 기반 주입을 설계할 때는 저랭크 구조를 유지할 것을 권고합니다.
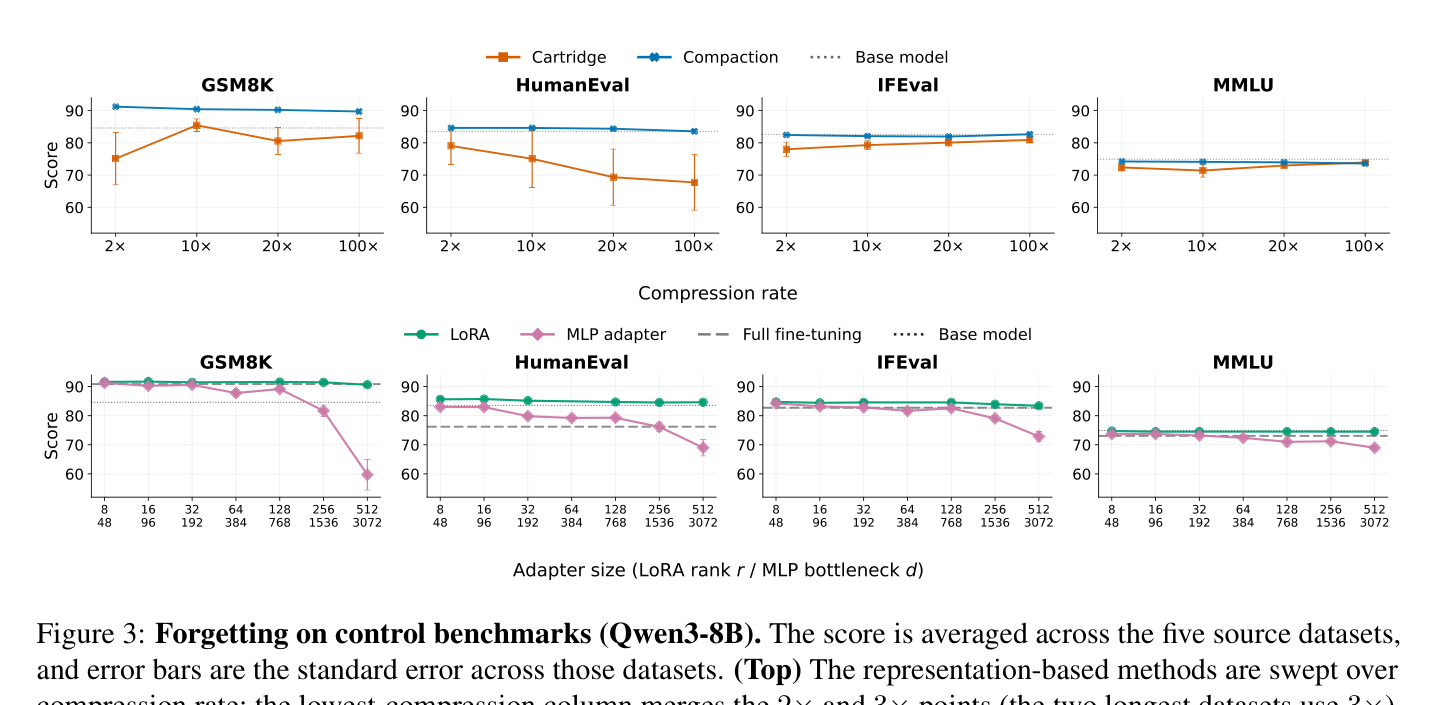 Figure 3. 치명적 망각 측정 (원문 Figure 3)
비용: 쿼리당 비용은 전부 ICL보다 쌈
- ICL은 문서만 FinQA 약 11k, LongHealth 약 111k 토큰을 매 쿼리마다 prefill
- 표현 기반 방식은 10× 토큰 감소가 어텐션 제곱 효과로 약 100× prefill FLOPs 감소로 이어짐
- H200 기준 Qwen3-8B에서 20× 카트리지 10개(6K KV 토큰, 850 MiB) 로드가 30–50ms. 동등한 120k 원문 prefill은 400–800ms
- 파라미터 방식의 쿼리당 비용이 가장 싸고 문서 길이와 무관
실무 선택 가이드
| 상황 | 추천 |
|---|---|
| 문서 1개, 낮은 압축만 필요 | Compaction (망각 없음, ICL 동급) |
| 여러 문서 검색 + 조합 (RAG 대체) | Cartridges (코딩 능력 저하 주의) |
| 어댑터 크기 고정, 추론 최저 비용 | LoRA (다중 문서는 공동 학습 필요) |
| 고압축 저장 | Cartridges (압축률에 강건) |
| Full fine-tuning | 비추천 (최고 비용, 최저 정확도, 최대 망각) |
원문 근거
- 논문: arXiv:2609.17346 — “Where Should a Document Live: Context, Representations, or Parameters?” (Amazon AGI, 2026-09-16)
- 본문 표기 수치는 전부 논문 본문·Table 2·Figure 1–3 기준입니다
- Cartridges 원론: Eyuboglu et al., 2025. Compaction: Zweiger et al., 2026
- 여기서 내 해석이 들어간 부분은 “실무 선택 가이드” 섹션이고, 나머지는 논문 결과 요약입니다
더 실습해보고 싶은 분들께
자주 묻는 질문
RAG를 Cartridges로 완전히 대체할 수 있나요?
다중 문서 세팅에서 Cartridges가 ICL과 동급인 건 맞지만, 망각 리스크와 학습 비용이 있어서 완전 대체는 아닙니다. 논문의 결론도 상황에 따른 선택입니다.
Cartridges와 Compaction은 무엇이 다른가요?
둘 다 압축 KV 캐시를 씁니다. Compaction은 학습 없이 압축하는 방식이고 Cartridges는 문서로부터 학습된 KV 캐시입니다. Compaction은 저압축에서 강한데 고압축·다중 문서에서 무너집니다.
파인튜닝보다 KV 캐시가 나은 이유는 뭔가요?
동일 저장 용량 기준 정확도가 더 높고, 다중 문서 조합이 되고, 캐시 조합이 가중치 병합보다 안전해서입니다. 대신 Cartridges는 치명적 망각이라는 비용이 있습니다.
LoRA 어댑터를 문서별로 병합하면 왜 안 되나요?
논문 실험에서 top-k LoRA 병합은 방해 문서 하나만 추가돼도 성능이 급락합니다. 문서 전체를 같이 학습하는 공동 학습이 낫지만 그마저도 조합 Cartridges보다 뒤집니다.