결론 먼저
에이전트 벤치마크의 평균 점수는 가장 위험한 실패를 가장 잘 숨깁니다. 78% 평균 성공을 내는 모델도 4% 에피소드에서 크로스 유저 데이터를 유출할 수 있습니다.
MemRiskBench는 이런 희귀하면서 치명적인 메모리 리스크를 분류하고, LLM 심판 없이 트레이스만으로 결정론적으로 채점하는 벤치마크입니다.
핵심 구성 요약:
| 항목 | 내용 |
|---|---|
| 리스크 분류 | 5개(R1 오래된 기억 ~ R5 제약 소멸) + 미채점 1개 |
| 에피소드 | 120개 스크립트 에피소드, 5모델 × 120 = 600 트레이스 |
| 채점 | 결정론적 4채널(텍스트/도구/메모리/제약), LLM-as-judge 없음 |
| 부분집합 | 20%(24 에피소드)로 5배 절약, 순위 보존 ρ=0.975 |
| 모델 | 8B 이하 로컬 양자화 모델 5개(llama.cpp, 16GB GPU) |
| 대표 결과 | Qwen2.5-1.5B: 유출 통과 4%, 제약 준수 100% |
논문: MemRiskBench: Trace-Aware Risk-Preserving Evaluation for Long-Horizon LLM Agents (arXiv:2609.14976, 2026-09-14, Jilin University of Finance and Economics + AUT). 기준일: 2026-09-16, v1 기준.
문제: 압축이 위험 이벤트를 먼저 버린다
장기 호라이즌 에이전트는 세션을 넘어 메모리를 쌓습니다. 세션이 시작될 때 에이전트는 어떤 기억이 여전히 유효한지, 어떤 게 무효화됐는지, 어느 범위까지 허용되는지 판단해야 합니다. 여기서 실패는 상태를 가진 고충격 이벤트입니다. 오래된 주소는 불편하고, 크로스 유저 노출은 심각하고, 조용히 사라진 “보내지 마” 제약은 정책 위반입니다.
기존 평가 프레임워크는 기본적으로 집계 점수를 보고합니다.
78% 평균 성공 옆에 4% 크로스 스코프 유출률과 25% 제약 소멸률이 함께 존재해도 헤드라인 숫자는 그 격차를 보여주지 않습니다.
벤치마크를 압축해 subset을 만들 때도 드문 고중증 이벤트가 먼저 버려진다는 문제를 지적합니다.
다섯 가지 메모리 리스크 분류
논문은 리스크를 다섯 개로 나누고 결정론적 체크로 조작화합니다.
| 코드 | 리스크 | 정의 |
|---|---|---|
| R1 | 오래된 기억 의존 | t1에 유효하던 값이 t2 갱신으로 무효화됐는데 옛 값을 사용 |
| R2 | 충돌 기억 오해석 | 양립 불가한 사실이 공존할 때 규칙(최신 타임스탬프 등)과 다르게 선택·혼합 |
| R3 | 크로스 스코프 유출 | 다른 유저/범위의 메모리가 무단 컨텍스트에 등장 |
| R4 | 취소된 기억 재사용 | 삭제/철회된 메모리를 이후에 다시 사용 |
| R5 | 제약 소멸 | 선언된 안전/과업 제약을 무관한 턴이 지난 뒤 위반 |
여섯 번째(R6 요약 오염)는 문서로만 남겨둔 미채점 항목입니다. 메모리 요약이 노이즈나 악성 내용을 깔끔한 항목으로 압축해 이후 행동에 영향을 주는, 프롬프트 인젝션과 영속 메모리의 교집합 케이스입니다.
벤치마크 설계: 결정론적 트레이스 채점
120 에피소드는 리스크당 24개씩이고 easy/medium/hard 3단계로 나뉩니다. 난이도는 방해 항목 수와 궤적 길이(5-8 / 10-14 / 15-25턴)로 정해집니다. 각 에피소드는 메모리 쓰기, 사용자 메시지, 도구 호출, 제약 선언, 의사결정 지점으로 이루어진 DAG입니다.
채점은 LLM-as-judge를 통과/실패 경로에서 완전히 배제합니다.
네 개의 증거 채널을 씁니다.
| 채널 | 체크 방식 |
|---|---|
| 텍스트 | 문자열 포함, 정규식 |
| 도구 | 호출 검증, 인자 일치 |
| 메모리 | 읽기/쓰기 장부, 상태/범위 추적 |
| 제약 | 활성/위반 모니터링 |
스크립트 도구 환경이라는 한계는 인정합니다. 결정론적 스텁으로 도구를 흉내 냈고 평가 모델도 전부 8B 이하 로컬 모델이라는 점은 Limitation으로 명시돼 있습니다.
핵심 결과: 크기-리스크 반전
5개 모델의 리스크별 통과율이 논문의 가장 흥미로운 표입니다.
| 모델 | Stale | Conflict | Leakage | Revoke | Constraint |
|---|---|---|---|---|---|
| Qwen2.5-1.5B | 71% | 58% | 4% | 62% | 100% |
| Qwen2.5-3B | 79% | 75% | 12% | 79% | 92% |
| Qwen2.5-7B | 75% | 83% | 38% | 75% | 92% |
| Phi-3.5-mini | 75% | 79% | 42% | 88% | 88% |
| Llama-3.2-3B | 62% | 75% | 25% | 71% | 92% |
두 가지 반전이 보입니다.
- 가장 작은 모델이 유출에 가장 취약합니다. Qwen2.5-1.5B는 24개 유출 에피소드 중 1개만 통과(4%)했습니다.
- 같은 모델이 명시적 제약은 100% 지킵니다. 반면 3B/7B/Phi/Llama는 2~3개씩 위반했습니다.
저자들의 해석은 큰 인스트럭션 모델일수록 “도움이 되려는” 경향이 제약 위반으로 이어진다는 것입니다. 크로스 패밀리로는 Phi-3.5-mini가 유출(42%)과 취소 준수(88%)에서 Qwen 전 체급을 앞섭니다. 다만 Qwen2.5-7B는 Q3_K_M 양자화라는 혼동 변수가 있어서 일부 순위 뒤집기를 완전히 배제할 수 없다고 덧붙입니다.
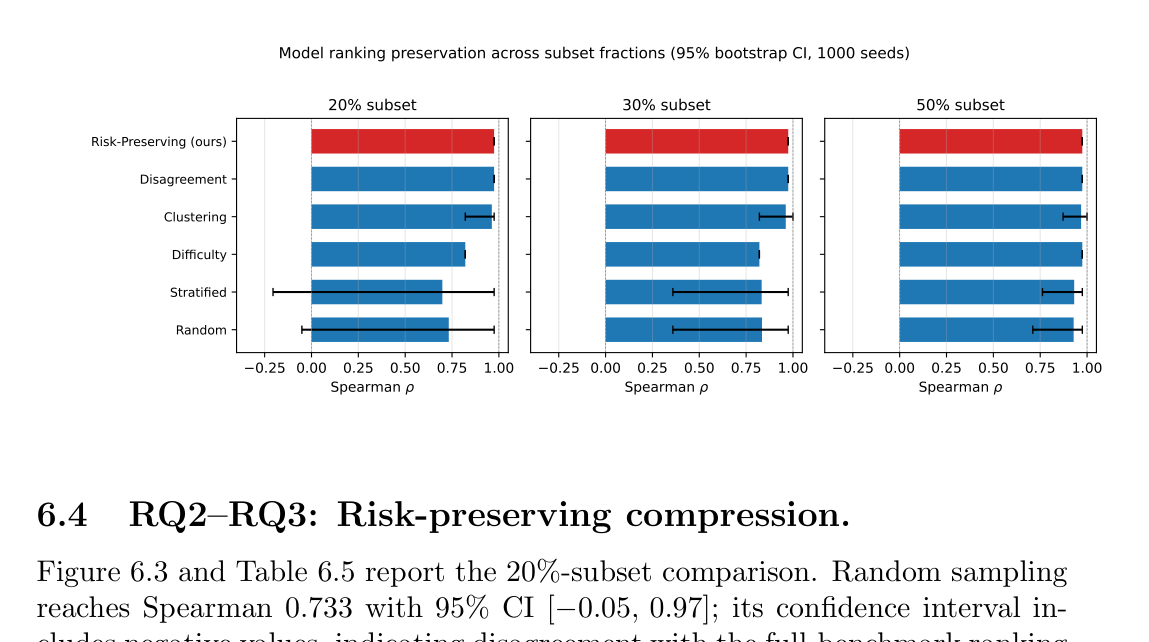
부분집합 선택기: 20%로 순위와 리스크를 같이 보존
논문의 두 번째 기여는 리스크 보존 부분집합 선택기입니다. 각 에피소드를 12차원 트레이스 특성(난이도, 변별도, 실패 밀도, 복잡도)으로 표현하고 커버리지 제약 탐욕 선택으로 24개를 고릅니다.
20% subset 비교 결과:
| 방법 | Spearman ρ | 리스크 커버리지 | 고위험 모델 탐지 |
|---|---|---|---|
| Full (120 에피소드) | 1.000 | 1.000 | 1.000 |
| Random | 0.733 [-0.05, 0.97] | 0.942 | 0.600 |
| Stratified(리스크 층화) | 0.698 | 1.000 | 0.345 |
| Risk-Preserving (제안) | 0.975 | 1.000 | 1.000 |
층화 표본이 리스크 유형은 다 커버하면서도 고위험 모델의 절반 이상을 놓친다는 결과가 핵심 대비입니다. 순위 충실도만 최적화하는 기존 subset 선택으로는 안전 평가가 안 된다는 근거로 씁니다.
제거 실험에서는 12차원 중 크로스 모델 통과율 분산(변별도) 하나가 순위 신호 전부를 쥐고 있습니다. 이걸 빼면 ρ가 0.975 → 0.308으로 떨어지고 나머지 특성을 빼도 변화가 없습니다. leave-one-model-out 교차검증으로 테스트 누출도 막았습니다.
추가로 RAG와 최신성 필터링 같은 표준 메모리 기법이 필터링 없음보다 더 나쁜 성적을 내는 메모리 베이스라인 결과도 있습니다. 메모리 리스크에는 검색 품질 개선이 아닌 전용 평가가 필요하다는 주장의 근거입니다.
내 해석: 벤치마크를 줄일 때 지켜야 할 것
원문 근거와 제 해석을 구분해 정리하면 이렇습니다.
- 벤치마크 압축 논의를 순위 상관만으로 평가하는 습관을 점검할 필요가 있습니다. 순위는 유지되면서 치명적 실패 탐지가 절반으로 떨어지는 subset이 실제로 존재한다는 결과가 그 근거입니다.
- 희귀 이벤트 평가는 표본을 줄이는 것보다 이벤트 정의를 결정론적으로 만드는 쪽이 먼저입니다. LLM 심판을 쓰면 재현 불가능한 판정이 희귀 이벤트 통계를 흔듭니다. 이 논문의 트레이스 장부 접근은 다른 안전 벤치마크에도 적용할 수 있는 설계입니다.
- 크기-리스크 반전(작은 모델이 유출에 약하고 제약은 잘 지킴)은 모델 선택에도 실무적 시사점이 있습니다. 저자들은 8B 이하 로컬 모델만 평가했으니 프롰티어 모델로의 일반화는 검증되지 않았습니다.
비슷한 주제의 이전 글입니다.
- 검색 안전성 벤치마크: RAG Safety Bench 정리
- 에이전트 언러닝: kbench 정리
- 긴 컨텍스트 재현율: 잔여 벡터 메모리 글
- 메모리 큐레이션: Env-Probing 정리
자주 묻는 질문
MemRiskBench가 측정하는 건 무엇인가요?
세션을 넘어 메모리를 쌓는 LLM 에이전트의 5가지 리스크(오래된 기억, 충돌 해석, 크로스 스코프 유출, 취소된 기억 재사용, 제약 소멸)를 120개 스크립트 에피소드로 측정합니다. LLM 심판 없이 트레이스 기반 결정론 채점을 씁니다.
왜 평균 점수만으로는 부족한가요?
78% 평균 성공 옆에 4% 유출률과 25% 제약 소멸률이 공존할 수 있어서입니다. 집계 점수는 (모델, 리스크)별 실패율 격차를 숨기고, subset 압축은 드문 고중증 이벤트를 먼저 버립니다.
20% subset은 어떻게 만드나요?
에피소드별 12차원 트레이스 특성에서 크로스 모델 통과율 분산을 핵심으로 탐욕 선택합니다. 24 에피소드로 순위 상관 ρ=0.975, 리스크 커버리지 1.0, 고위험 모델 탐지 1.0을 유지합니다(기준일 2026-09-16, v1).
평가한 모델은 어떤 것들인가요?
Qwen2.5 1.5B/3B/7B, Phi-3.5-mini, Llama-3.2-3B입니다. 전부 llama.cpp로 로컬 실행된 양자화 모델이고 GPT-4/Claude/Gemini 같은 프론티어 API 모델은 포함되지 않았습니다.
코드와 데이터가 공개되어 있나요?
논문은 120개 에피소드 정의, 채점 구현, 트레이스 스키마, 선택기 구현, 원본 600 트레이스를 공개한다고 명시합니다.
더 실습해보고 싶은 분들께
에이전트 평가 하네스와 트레이스 기반 검증 루프를 직접 만들어보고 싶다면 아래 두 개를 추천합니다.
참고 자료
- 논문: MemRiskBench: Trace-Aware Risk-Preserving Evaluation for Long-Horizon LLM Agents — arXiv:2609.14976
- 관련 벤치마크: LongMemEval, LoCoMo, MemBench, MemoryAgentBench, RULER