결론 먼저
에이전트가 긴 과제를 풀다가 한 발을 잘못 딛으면, 이후의 모든 관측이 오염됩니다. 대부분의 시스템은 이때 둘 중 하나를 합니다.
맥락에 “이렇게 고쳐라”는 피드백을 붙이거나, 아예 체크포인트로 되돌려버리거나. 근데 후자를 택하는 순간 그 사이에 배운 것들이 통째로 사라집니다. 되돌아간 에이전트는 같은 실수를 또 합니다.
이 논문의 아이디어는 단순합니다. 세계는 과거로 되돌리되, 반성은 지금으로 가져오는 것. RIR(Rollback-Induced Reflection)은 롤백 순간을 하나의 설계된 경계로 보고, 그 경계에서 무엇이 생존할지를 명시적으로 제어합니다. 기준일: 2026-09-20, arXiv 2609.18304 (2026-09-16 등록).
| 항목 | 내용 |
|---|---|
| 논문 | Rollback the World, Keep the Reflection |
| 소속 | 우한대학교 · Alibaba Group |
| arXiv | 2609.18304 (2026-09-16) |
| 벤치마크 | ALFWorld, ScienceWorld, GAIA |
| 결과 | DeepSeek-V3 평균 성공률 69.43%, 최고 대비 +6.57%p |
| 링크 | https://arxiv.org/abs/2609.18304 |
배경: 두 복구 방식의 막힘
롱호라이즌 태스크에서 오류는 누적됩니다. 한 번 틀린 행동이 이후 상태와 관측을 바꿔버립니다. 나중 판단이 오염된 문맥에 기반해 이뤄지는 거구요.
- 정보 수준 수정 (Reflexion류): 맥락에 교정 피드백을 추가. 근데 이미 바뀐 환경은 되돌리지 못하고, 오염된 관측이 문맥에 그대로 남습니다.
- 상태 복구 (GA-Rollback류): 체크포인트로 이전 상태 복원. 근데 그 사이 쌓은 유용한 경험까지 버립니다. 같은 실수를 반복할 수 있다는 뜻입니다.
논문은 이걸 롤백 경계 제어 문제로 정식화합니다. 개입 시점(WHEN)과 재개 지점(WHERE), 생존 정보(WHAT)를 함께 결정해야 한다는 뜻입니다.
방법: RIR 동작
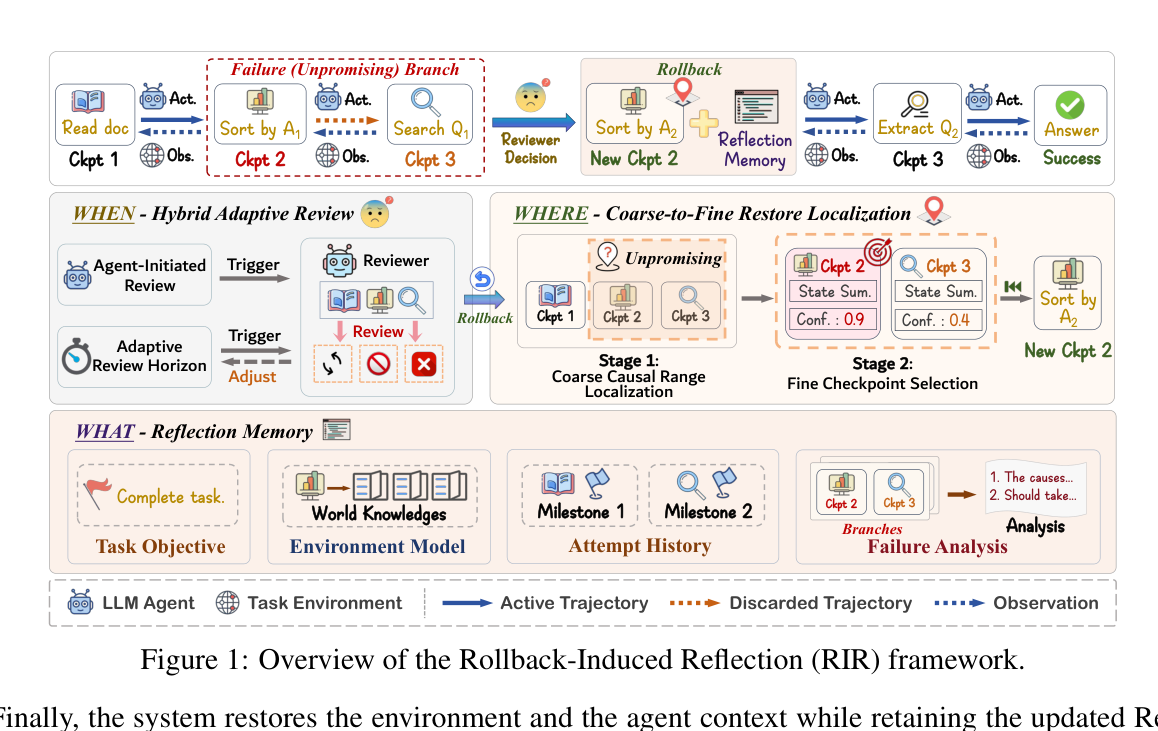
RIR은 세 가지 질문에 대한 답으로 동작합니다.
- WHEN — 하이브리드 적응형 리뷰. 에이전트가 스스로 rollback 도구를 호출하는 경우와, 컨트롤러가 동적 리뷰 주기로 정체·오류를 점검하는 경우를 섞습니다. 에이전트 자각 신호와 외부 안전망을 동시에 쓰는 겁니다.
- WHERE — 2단계 복원 지점 탐색. 먼저 궤적에서 실패 원인 구간을 대략 거르고(coarse causal range), 그 안의 체크포인트 상태 요약을 비교해 장애물을 제거하면서도 최대한 최신 지점을 고릅니다. 유효했던 진행 앞부분을 보존하기 위해서입니다.
- WHAT — 반성 메모리(Reflection Memory). 시도 이력(H), 환경 모델(E), 실패 분석(F) 세 필드로 나눠 관리합니다. 시도 이력은 달성한 이정표를 과거 사실로 기록하고, 환경 모델은 여러 시도에서 확증된 환경 지식을, 실패 분석은 직전 경로의 실패 조건을 담습니다. 현재 상태 주장은 여기에 두지 않습니다. 롤백 경계를 넘어 낡은 상태 주장이 새 경로를 오염시키는 걸 막기 위해서입니다.
수식으로 보면 (st, ht, M)이 롤백 연산을 거쳐 (sr, hr, M+)이 됩니다. 세계와 분기 문맥은 과거로 돌아가되, 반성 지식은 갱신돼서(M+) 함께 넘어갑니다.
성능
| 항목 | Qwen3-14B | DeepSeek-V3 |
|---|---|---|
| ReAct 기준 평균 SR | 39.20% | 62.86% |
| RIR 평균 SR | 47.00% | 69.43% (+6.57%p) |
벤치마크 세 곳(ALFWorld, ScienceWorld, GAIA)에서 두 백본 모두 일관되게 최고 성공률을 기록했습니다. 백본이 강해져도 격차가 유지된다는 점이 흥미롭습니다. 명시적 복구 메커니즘은 모델 능력 향상으로 대체되지 않는다는 관측이죠.
절제 실험: 롤백과 반성은 둘 다 필요
ScienceWorld + DeepSeek-V3 기준입니다.
| 변형 | SR | DR | 평균 스텝 | 롤백 수 |
|---|---|---|---|---|
| 반성만 | 70.48% | 0.738 | 36.5 | 0 |
| 롤백만 | 69.37% | 0.801 | 46.7 | 1.30 |
| RIR 전체 | 76.75% | 0.813 | 42.4 | 0.92 |
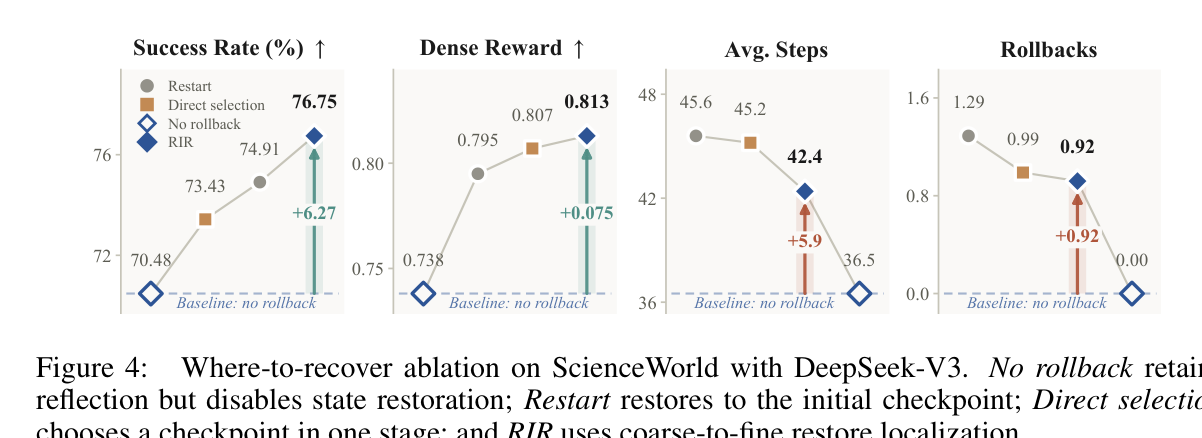
- 반성만 남기면 SR 70.48%로 6.27%p 떨어집니다. 정보 수준 교정만으로 상태 복구를 대체할 수 없다는 뜻입니다.
- 롤백만 하면 69.37%. 되돌리기만 하고 배우지 않으면 소용없습니다.
- 복원 지점을 한 번에 고르면(direct selection) 73.43%, 초기로 재시작하면 72%대. 어디로 되돌아갈지도 설계된 결정이 필요합니다.
하네스 관점 해석 (제 해석)
여기서부턴 제 해석입니다. 원문 주장과 구분해서 읽어주세요.
이 논문은 결국 롤백 책임을 하네스로 옮긴 설계입니다. rollback 도구 노출, 체크포인트 저장, 리뷰 주기 제어, 반성 메모리 유지를 전부 외부 실행층이 담당합니다. 모델은 의미적 판단만 하면 되는 구조구요.
실무 하네스에 바로 적용할 수 있는 포인트:
- 롤백 도구를 액션 스페이스에 넣되, 외부 스케줄 리뷰를 병행하세요.
- 롤백 시 컨텍스트 전체를 버리지 말고, 환경 모델/시도 이력/실패 분석 정도로 분리된 메모리만 살려두세요.
- 어디로 되돌릴지는 한 번에 고르지 말고 2단계로 범위를 줄이세요.
관련 정리: 이전 작업을 기억하는 최적화 에이전트 MAPLE 정리, 에이전트 회귀 테스트 Chronicle 정리
더 실습해보고 싶은 분들께
하네스와 롤백 루프를 직접 만들어보고 싶다면 아래 두 자료를 추천합니다.
자주 묻는 질문
- RIR이 기존 롤백 방식과 다른 점은 뭔가요? 롤백 시 반성 메모리를 함께 보존하고, 개입 시점과 재개 지점을 별도 제어로 설계한 점입니다. 기존은 되돌리면서 경험을 버리거나, 맥락만 고치고 환경 상태를 그대로 뒀습니다.
- 롤백 없이 반성만 남기면 안 되나요? 안 됩니다. 절제 실험에서 반성만 남긴 경우 SR 70.48%로 전체 RIR 76.75%보다 6.27%p 낮았습니다 (기준일 2026-09-20).
- 어떤 벤치마크에서 검증됐나요? ALFWorld, ScienceWorld, GAIA 세 곳이고, Qwen3-14B와 DeepSeek-V3 두 백본에서 일관된 향상을 보였습니다.
- 실무 에이전트에 바로 쓸 수 있나요? 핵심 아이디어(롤백 도구 노출, 외부 리뷰, 메모리 분리 보존)는 하네스 수준에서 구현 가능합니다. 논문 코드 공개 여부는 별도 확인이 필요합니다.