결론 먼저
LLM 에이전트 장애는 같은 코드를 다시 실행해도 재현되지 않는다. 온도 0에서도 추론이 비트 단위로 재현되지 않고, 도구가 읽는 외부 상태는 이미 바뀌었고, 재시도와 라우팅도 매번 달라진다. Microsoft의 Chronicle(arXiv 2609.20625, 2026-09-17 공개)은 이 문제를 에이전트의 비결정적 경계를 녹화한 뒤, 일부만 새 코드로 살려서 테스트하는 방식으로 푼다. 녹화된 장애 하나가 모델 호출 0회로 돌아가는 CI 회귀 테스트가 된다.
핵심 요약 표입니다(기준일 2026-09-19, arXiv v1).
| 항목 | 내용 |
|---|---|
| 논문 | Chronicle: Cut-Point Replay for Regression Testing of LLM Agents (arXiv 2609.20625) |
| 소속 | Microsoft (Tisha Chawla, Susheem Koul 공동 1저자) |
| 핵심 기능 | @boundary 어노테이션으로 모델/도구/라우팅 호출을 녹화, 선택적 리플레이로 회귀 테스트 생성 |
| 기록 오버헤드 | 경계 통과당 중앙값 23 µs (300 ms 모델 호출 대비 0.008%) |
| 리플레이 안정성 | 전체 리플레이 20회 반복 0 divergence, 모델 호출 0회 |
| 벤치마크 | 기록된 장애 6건(환불, 인보이스, 트레이드, 이메일, 페이아웃, 파일 삭제) |
| 뮤테이션 | 컷포인트 테스트 51/192 킬, 전체 스텁 베이스라인 0/192 |
| 코드 | github.com/theagentplane/chronicle |
문제 정의
기존 에이전트 인프라는 실행을 관찰할 뿐 테스트 가능하게 만들지 않는다. 트레이싱 도구(Arize Phoenix 등)는 실행 내역을 기록하고, 평가 프레임워크(promptfoo 등)는 출력의 적합성을 채점한다.
그런데 개발자가 실제로 묻는 질문은 다르다. “이 코드를 고쳤는데, 그때 그 장애가 고쳐지는지 확인해줘.” 이 질문에 답하려면 녹화된 실행의 특정 컴포넌트 하나만 바꿔서 돌리는 연산이 필요한데, 기존 도구에는 없었다. Chronicle이 이 간극을 메운다.
제안 방법: 기록, 재생, 검증
Chronicle은 세 단계로 구성된다.
1. 기록(Record)
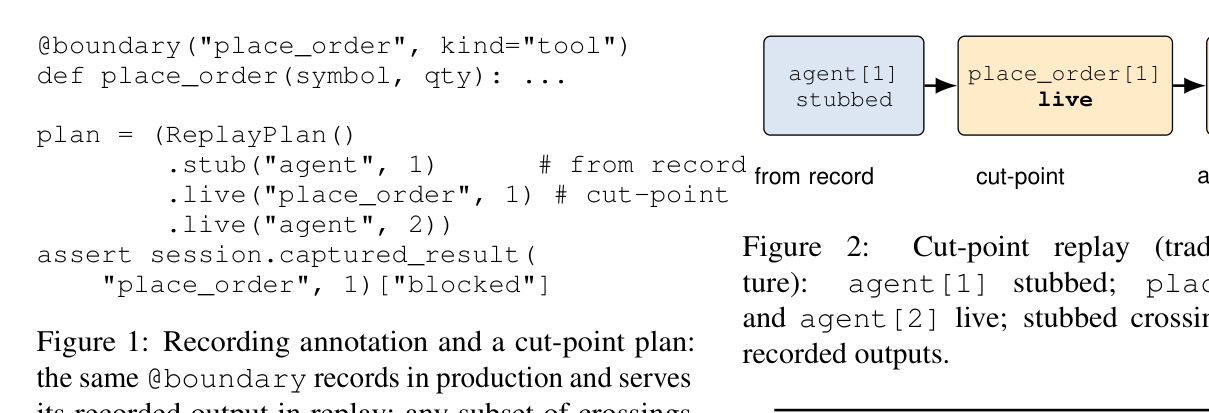
모델 호출, 도구 호출, 라우팅 결정 지점을 boundary로 정의한다. 개발자는 한 줄 어노테이션만 붙인다.
@boundary("place_order", kind="tool")
def place_order(symbol, qty): ...
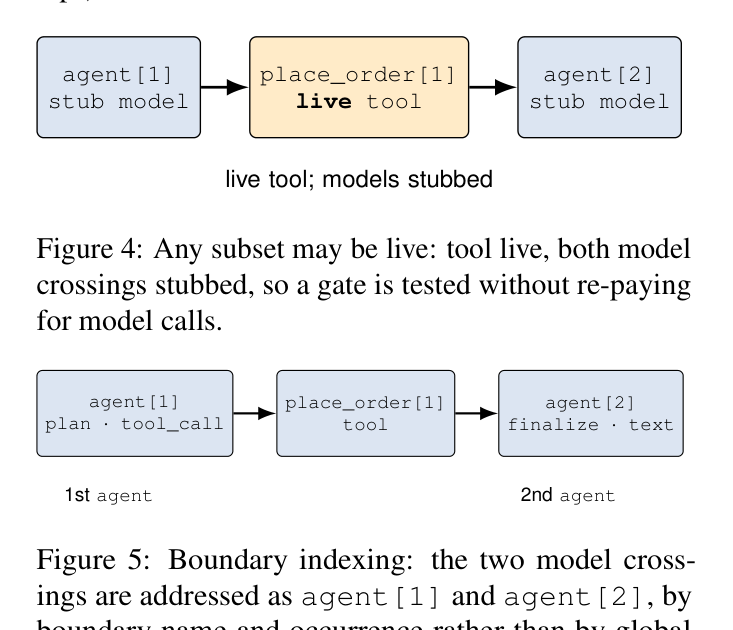
각 경계 실행(crossing)은 입력·출력·메타데이터(모델 버전, 샘플링 파라미터)를 담은 불변 엔벨로프로 저장된다. 저장 전 시크릿 리덕션이 적용되고, OpenTelemetry 스팬이 출력된다. 경로는 이름과 발생 순서로 주소가 매겨진다. 루프에서 3번 호출된 agent는 agent[1], agent[2], agent[3]이다.
주의점: 엔벨로프는 경계의 인터페이스만 담는다. 경계 내부가 시계나 DB 같은 숨은 상태를 읽으면 리플레이가 정확하지 않다.
2. 재생(Replay)
풀 리플레이는 모든 경계를 녹화값으로 서빙한다. 모델 호출 0회, 20회 반복해도 결과가 비트 단위로 동일했다.
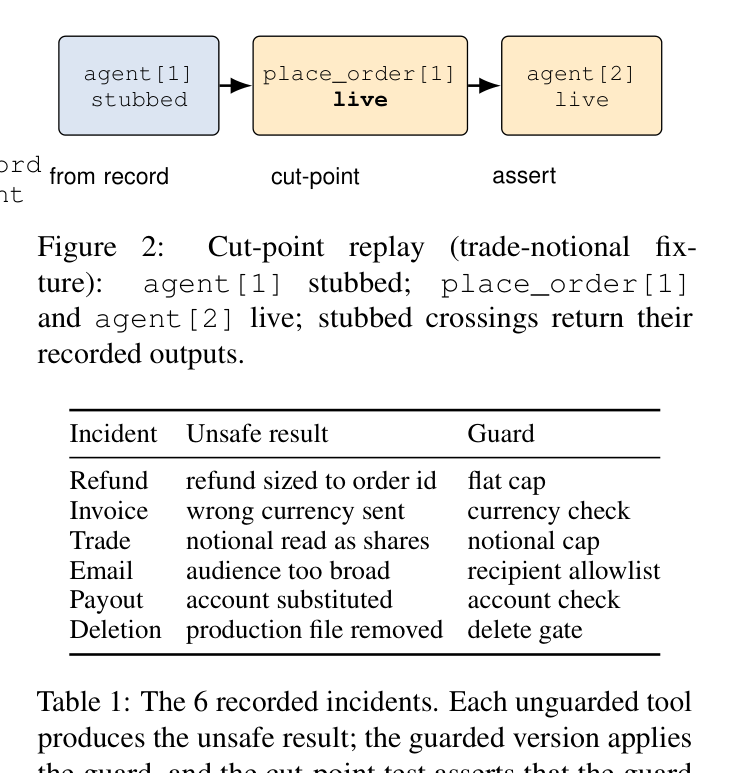
컷포인트 리플레이가 핵심이다. 선택한 경계만 새 코드로 실행(live)하고 나머지는 녹화값으로 서빙(stub)한다.
plan = (ReplayPlan()
    .stub("agent", 1)
    .live("place_order", 1)   # 컷포인트
    .live("agent", 2))
assert session.captured_result(
    "place_order", 1)["blocked"]
모델은 스텁하고 도구 게이트만 라이브로 돌리면 모델 비용을 다시 지불하지 않고 게이트 변경만 검증한다.
안전장치: 스텁된 경계가 녹화보다 많거나 적게 호출되면(루프 추가, 재시도 제거) 룩업이 실패하고 리플레이가 예외를 낸다. 이름별 호출 카운트 체크다. 한계는 카운트를 보존하는 순서 변경은 잡지 못한다는 것.
3. 검증(Test)
구조적 어서션으로 어떤 도구를 어떤 인자로 호출했는지, 가드된 행동이 거부됐는지 확인한다. 풀 리플레이에서는 결정적이라 모델 호출 없이 CI에서 돈다. 비구조적 속성(충실성, 안전성)용 LLM-as-judge는 자문(advisory)으로 제공되나 신뢰성은 평가하지 않았다.
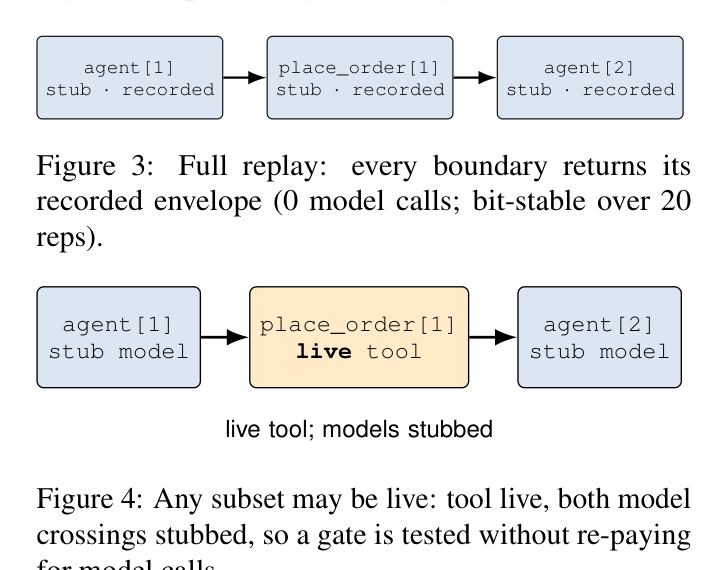
벤치마크: 기록된 장애 6건
인위적으로 만든 게 아니라 기록된 장애에서 왔다. 각각 Cemri et al.(2025) 멀티에이전트 실패 분류, 주로 task-verification 범주(실행 전 검증 누락)의 실제 실패 모드를 반영한다.
| 장애 | 위험 결과 | 가드 |
|---|---|---|
| Refund | 주문 ID에 맞춘 환불액 | 상한 cap |
| Invoice | 잘못된 통화 송금 | 통화 체크 |
| Trade | 개수를 notional로 오해 | notional cap |
| 수신 범위 과다 | 수신자 허용목록 | |
| Payout | 계좌 대체(주입) | 계좌 체크 |
| Deletion | 운영 파일 삭제 | 삭제 게이트 |
Trade 사례가 구체적이다. 가드 없는 도구는 약 1천 달러 요청에 1,000주(약 19만 달러)를 매도한다. 게이트가 있으면 차단된다.
왜 경계별 목업으론 안 되는가. 전체 스텁 베이스라인은 도구를 다시 실행하지 않으니 게이트가 있든 없든 녹화된 위험 결과를 그대로 반환한다. 판정이 도구 코드에 의존할 수 없다. 실제로 6건 전부에서 가드 없는 코드, 가드 수정, 무해한 편집을 똑같이 실패시켰다.
실험 결과
- 기록 오버헤드: 경계당 중앙값 23 µs, 저장 최대 1.44 KB. 로컬 Qwen3.5 4B 실측에서 기록 on/off 평균 지연 차이는 +91 ms(95% CI -59~+241 ms)로 0과 구별되지 않았다. 실행 간 변동성보다 4자리수 아래다.
- 결정성·비용: 풀 리플레이는 스위트 12개 모델 경계 중 0개 호출, 1,000회 풀 리플레이 비용 $0.00. 스위트 풀 패스 3.5 ms, 컷포인트 패스 3.6 ms.
- 장애 감지: 6/6에서 가드 없는 코드 실패, 가드 수정·무해 편집 통과. 무관한 표현 변경 30개도 통과.
- 뮤테이션: 가드 도구 1차 뮤턴트 192개 중 컷포인트 테스트는 51개 킬, 전체 스텁은 0개. 기록 입력에서 동작을 바꾸는 뮤턴트 82개 기준 62% 킬률이고, 살아남은 뮤턴트 중 위험 행동을 통과시키는 것은 0개였다.
한계와 내 판단
논문이 명시한 한계는 다음과 같다.
- 스트리밍 응답과 병렬 도구 호출을 캡처하지 않고, 스텁 경계의 예외 재발생도 아직 안 된다.
- 벤치마크 에이전트의 모델 경계가 결정적 시뮬레이션이라 비결정적 실제 프로바이더에서의 재현률은 측정하지 않았다.
- 3단계 소형 에이전트 6건이라 이 연구의 동기인 루프·재시도·멀티에이전트 라우팅은 커버하지 않는다.
- 비결정적 호출 지점 커버는 사용자 책임이다. 어노테이션 안 붙은 호출은 라이브로 실행돼 체크를 빠져나간다.
- LLM-as-judge는 구현만 되어 있고 신뢰성 평가는 없다.
내 판단을 붙이면, 장애를 CI 테스트로 만든다는 워크플로(장애 1회 녹화 → 트레이스+어서션 커밋 → 매 커밋 무료 실행)는 실무 에이전트 팀이 바로 써먹을 수 있는 패턴이다. 다만 녹화본이 프롬프트와 도구 인자를 통째로 담으니 리덕션 정책과 저장 위치 관리가 실제 도입의 병목이 될 것이다.
더 실습해보고 싶은 분들께
자주 묻는 질문
- Chronicle이 하는 일을 한 문장으로는? — 에이전트 실행을 비결정적 경계 단위로 녹화해, 일부 경계만 새 코드로 실행하는 컷포인트 리플레이로 장애를 CI 회귀 테스트로 만든다.
- 모델 호출 비용이 드나? — 풀 리플레이는 0회 호출이고 컷포인트도 스텁 대상은 재호출하지 않는다. 논문 측정에서 풀 스위트 1,000회 리플레이 비용은 $0.00이다.
- temperature 0이면 재현되지 않나? — 호스팅 환경에서 온도 0 설정도 비트 단위로 재현되지 않는다는 기존 측정(Atil et al., 2025)이 논문의 출발점이다. 여기에 도구 상태 변화와 재시도 변동이 더해진다.
- 기존 목업 테스트와 뭐가 다르나? — 손으로 쓴 목업 대신 실제 녹화에서 뽑은 엔벨로프를 쓰고, 원하는 경계만 라이브로 돌린다. 전체 스텁 베이스라인이 뮤턴트 0개를 잡은 것과 대비된다.
- 어디서 코드를 볼 수 있나? — github.com/theagentplane/chronicle에서 공개했다. 벤치마크 픽스처 6종도 함께 공개되어 있다.
참고 자료
- 논문: arXiv:2609.20625
- 코드: github.com/theagentplane/chronicle
- PDF: arXiv PDF