결론 먼저
Visual RAG에서 성능 병목의 상당 부분은 검색 품질보다 답 생성 직전의 증거 보존과 정리에서 나온다는 것이 이 논문의 핵심 주장입니다. SCoRE(Selection and COnsolidation for Robust Evidence)는 탐색 중 관련 관찰만 텍스트 증거 장부(ledger)에 남기고, 답 생성 직전에 원본 페이지 이미지를 다시 불러와 걸러내고 순서를 세우는 에이전트 루프입니다.
Qwen2.5-VL-7B 기준 결과는 이렇습니다.
| 항목 | 이전 최고(VISOR) | SCoRE | 차이 |
|---|---|---|---|
| SlideVQA Overall (%) | 72.37 | 77.16 | +4.79 |
| SlideVQA Multi-hop (%) | 53.62 | 62.26 | +8.64 |
| ViDoSeek Overall (%) | 74.87 | 75.31 | +0.44 |
| MMLongBench Overall (%) | 28.45 | 31.52 | +3.07 |
| 답에 남는 노이즈 페이지(장/쿼리) | 1.29 | 0.16 | 약 1/5 |
논문: Navigating Sparse Evidence: Agentic Visual RAG via Explicit Context Selection and Consolidation (arXiv:2609.15800, 2026-09-14, Soochow University + Baidu). 기준일: 2026-09-16, v1 기준.
배경: 페이지 단위 검색의 두 문제
VRAG는 슬라이드, 보고서, 스캔 PDF처럼 시각적으로 복잡한 문서에서 페이지 이미지를 검색해 답합니다. 저자들은 문제를 둘로 정리합니다.
- 증거 분포가 고르지 않음: 답이 한 페이지의 작은 영역에 몰려 있거나 여러 페이지에 흩어져 있습니다.
- 증거 정리가 암묵적: 기존 에이전트는 탐색 궤적 그대로 또는 압축된 텍스트 메모리로 답을 만들어서 탐색 노이즈가 답에 섞입니다.
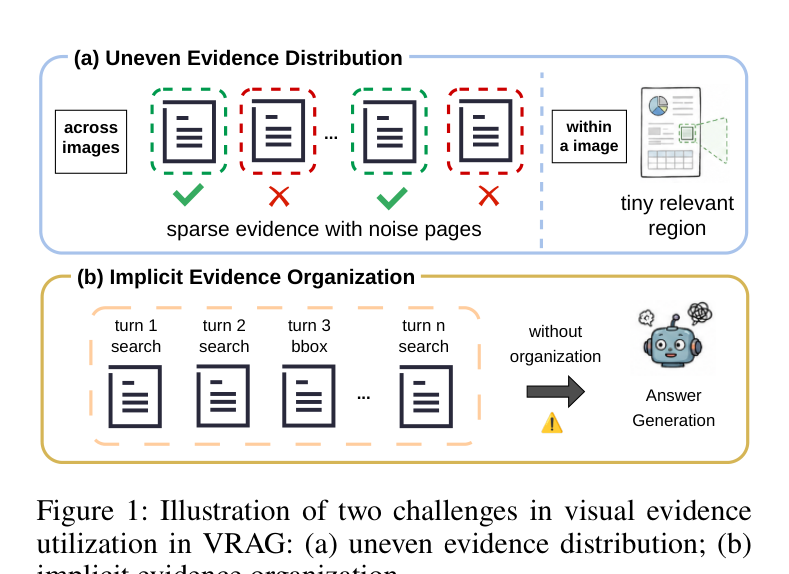
기존 방법의 위치는 이렇습니다. VRAG-RL은 시각 관찰을 궤적에 그대로 쌓고, VISOR는 관찰을 텍스트 증거 장부로 변환합니다. 근데 둘 다 답 생성 직전에 원본 이미지를 재구성해 순서까지 세우는 단계가 없습니다.
방법: 텍스트 증거 장부와 consolidate 액션
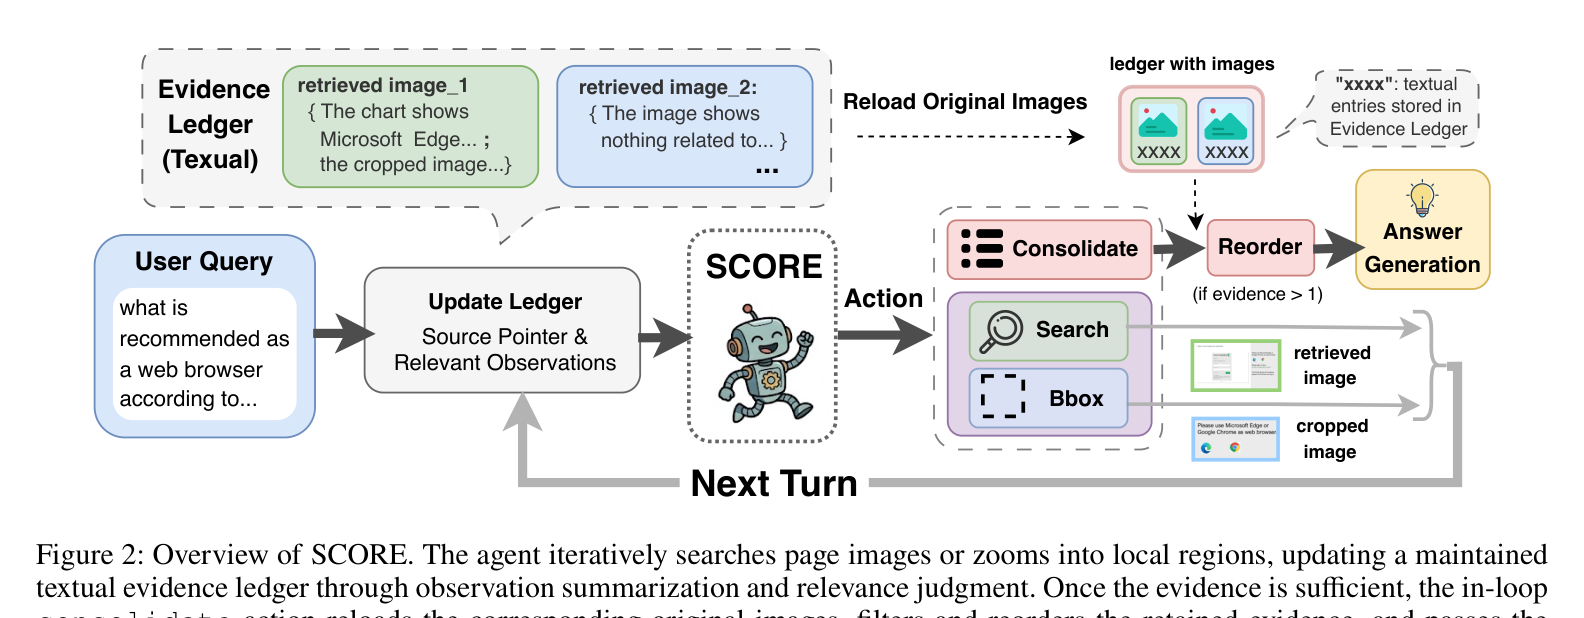
SCoRE는 하나의 에이전트 루프에서 두 개의 상태를 유지합니다. 텍스트 증거 장부 L과 상호작용 이력 H입니다. 각 턴마다 에이전트는 세 필드를 출력합니다.
| 출력 필드 | 내용 |
|---|---|
| observe | 현재 페이지/영역의 시각 내용 요약 |
| relevant | 관련성 이진 판단(yes/no) |
| action | 다음 행동: search / bbox / consolidate |
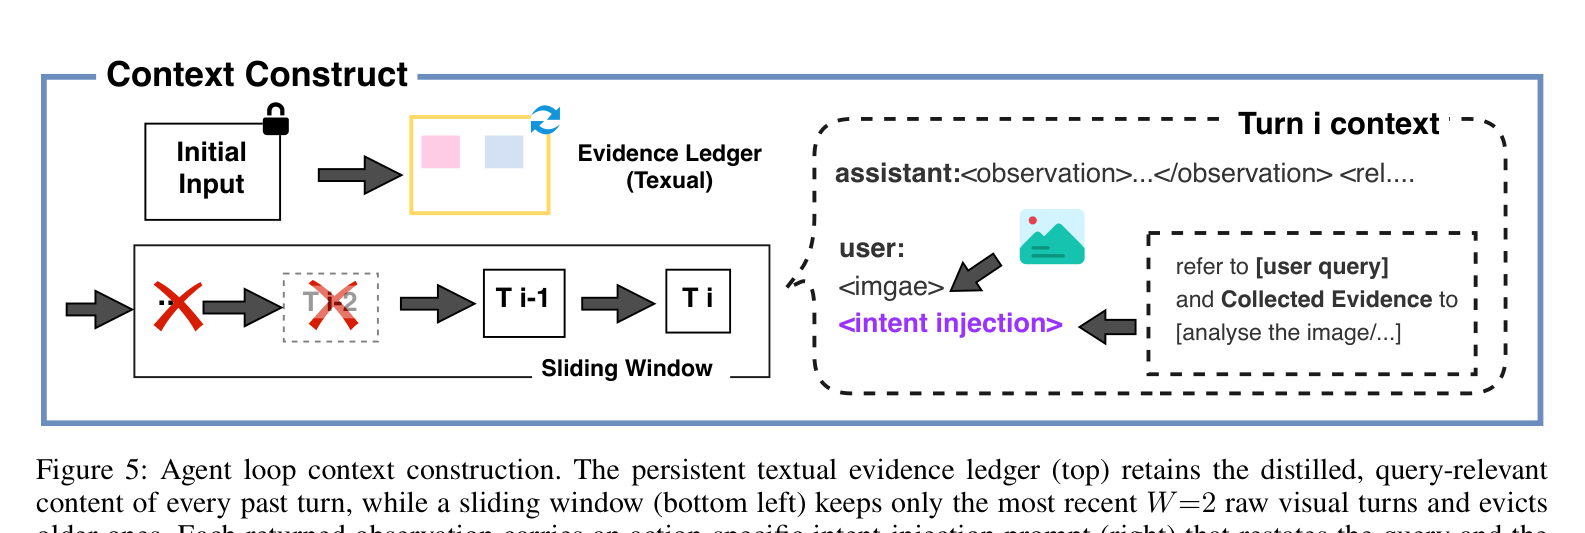
relevant=yes인 관찰만 장부에 소스 포인터(원본 페이지, bbox 좌표)와 함께 저장합니다. 원본 시각 컨텍스트는 최근 W=2턴만 유지해서 이미지 토큰 소비가 궤적 길이에 비례해 늘어나는 걸 막습니다. 관련 없는 관찰은 창이 밀리면서 버려집니다.
탐색이 끝나면 consolidate 액션이 장부가 참조하는 원본 페이지 이미지를 다시 불러오고, 여러 장이면 걸러내고 논리적 순서로 재배열해 답 생성에 넘깁니다. 최종 답에서 각 주장이 어떤 장부 항목에 근거하는지 인덱스로 연결해 클레임-이미지 근거 연결을 남깁니다. 탐색의 시행착오와 최종 추론이 분리되는 구조입니다.
학습: 필터링 콜드스타트 + 증거 인지 RL
학습은 두 단계입니다.
콜드스타트는 Qwen3.5-122B-A10B 교사 모델이 만든 궤적 중 정답이면서 골드 페이지 전체가 최종 장부에 담긴 궤적만 남겨 SFT합니다. SlideVQA 학습 분할에서 2,500개 궤적을 사용했습니다. 단순히 검색만 된 궤적은 버립니다.
이후 GRPO로 다중 턴 RL을 돌립니다(1,600 쿼리). 보상은 세 성분입니다.
| 보상 성분 | 정의 | 역할 |
|---|---|---|
| cov | 골드 페이지 중 최종 장부에 남은 비율(재현율) | 증거를 다 담게 유도 |
| cmp | 장부 중 골드 페이지 비율(정밀도) | 노이즈를 걷어내게 유도 |
| r_ans | LLM-as-judge 이진 정답 | 답 품질 |
보상식은 r = cov + 0.2·cmp + r_ans 단, cov=1일 때만 cmp와 r_ans가 활성화되고 cov<1이면 벌점 β=1을 받습니다. 골드 페이지를 버리고 cmp만 높이는 게임을 막는 구조입니다.
성능: 세 벤치마크 SOTA
7B 기준 주요 수치를 다시 정리하면 SlideVQA 77.16%, ViDoSeek 75.31%, MMLongBench 31.52%로 세 벤치마크 모두 최고값입니다. 3B 백본에서도 SlideVQA 70.47%, MMLongBench 28.51%로 동일 추세입니다.
특히 멀티홉 문제에서 이전 최고 대비 약 9점(53.62 → 62.26)이 올랐습니다. 여러 페이지에 흩어진 증거를 하나로 모으는 과정이 성능 차이를 만든다는 해석이 근거로 연결됩니다.
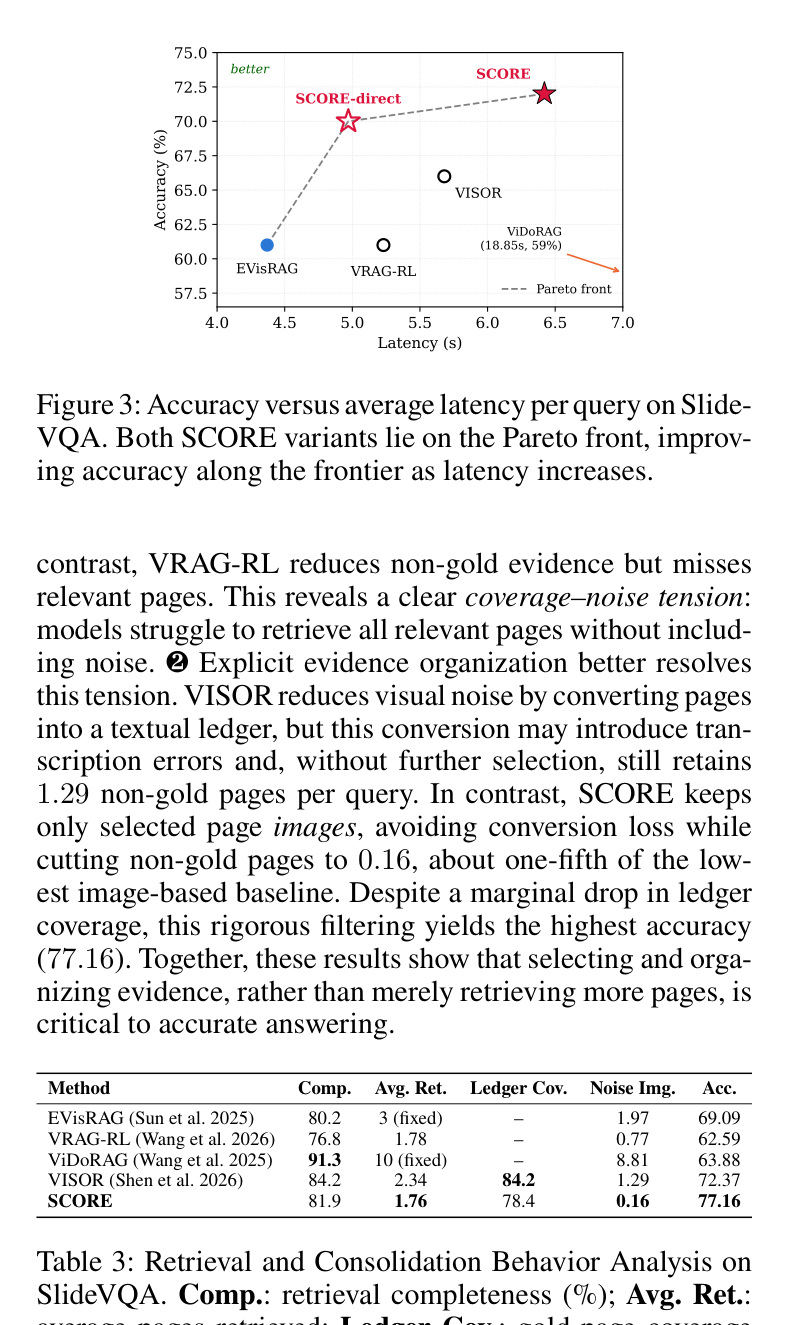
검색 행동 분석(Table 3)이 흥미롭습니다. ViDoRAG는 완전성 91.3%를 내지만 고정 10장을 검색해 쿼리당 노이즈 이미지 8.81장을 물고 갑니다. VISOR는 1.29장까지 줄이는데 SCoRE는 0.16장입니다. “더 많이 검색”보다 “고르고 정리” 쪽이 정확도를 만든다는 게 수치로 확인됩니다.
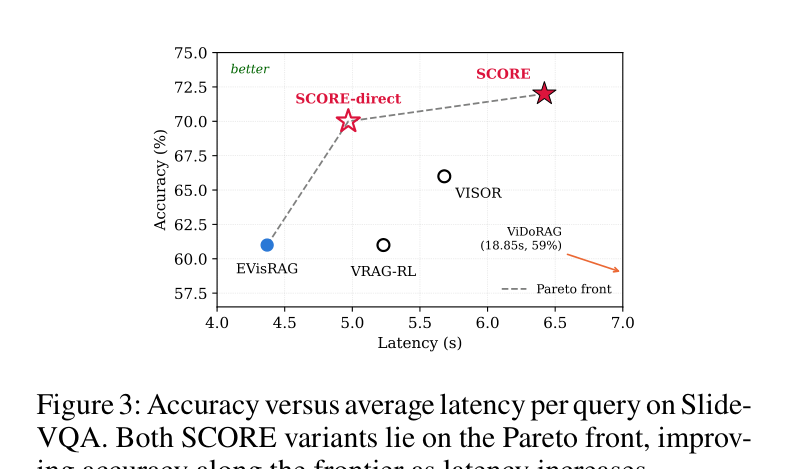
효율(Table 4)도 함께 봐야 합니다.
| 방법 | 평균 턴 | 평균 토큰 | 지연시간(초) | 정확도(%) |
|---|---|---|---|---|
| ViDoRAG | 6.22 | 23259 | 18.85 | 59 |
| VRAG-RL | 4.36 | 2932 | 5.23 | 61 |
| EVisRAG | 1 | 2514 | 4.37 | 61 |
| VISOR | 3.40 | 3162 | 5.68 | 66 |
| SCORE-direct | 2.83 | 2762 | 4.97 | 70 |
| SCORE | 3.65 | 3468 | 6.42 | 72 |
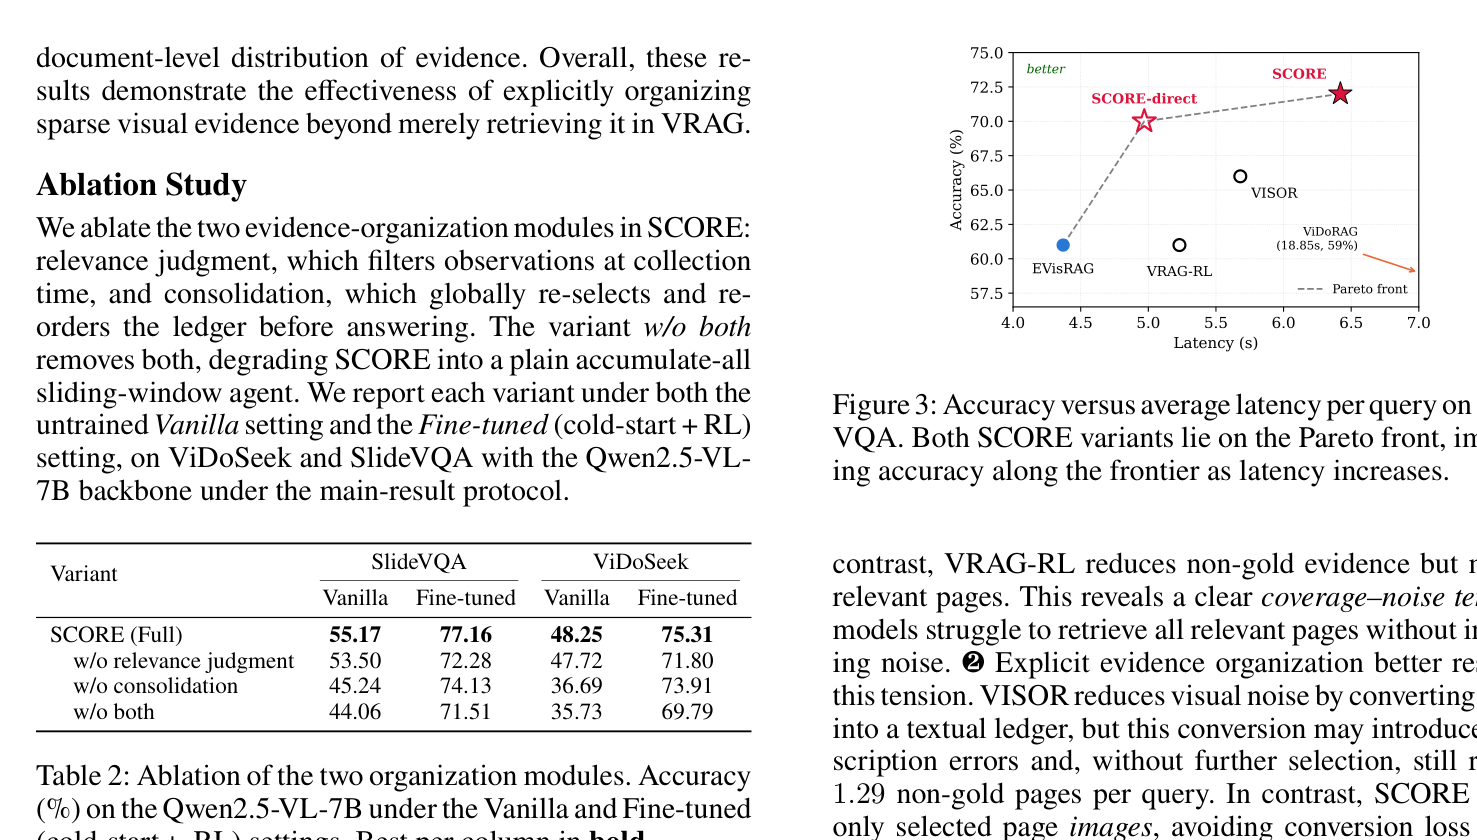
ViDoRAG 대비 토큰 6.7배 절약하면서 정확도는 13점 높습니다. 정리 단계의 원본 재로딩 비용보다 수렴이 빨라(평균 3.65턴) 절약 폭이 더 큽니다. 저자들은 이 비교를 정확도-지연시간 파레토 프론팅에서도 확인합니다.
제거 실험: 두 모듈의 역할이 학습 전후로 뒤집힘
Table 2가 주는 통찰이 제일 재밌는 부분입니다.
| 변형 | SlideVQA Vanilla | SlideVQA Fine-tuned | ViDoSeek Vanilla | ViDoSeek Fine-tuned |
|---|---|---|---|---|
| SCORE(Full) | 55.17 | 77.16 | 48.25 | 75.31 |
| 관련성 판단 제거 | 53.50 | 72.28 | 47.72 | 71.80 |
| 통합(consolidation) 제거 | 45.24 | 74.13 | 36.69 | 73.91 |
| 둘 다 제거 | 44.06 | 71.51 | 35.73 | 69.79 |
학습 전에는 통합 제거가 더 아픕니다(SlideVQA -9.9). 관련성 판단이 서툴러서 노이즈가 장부에 그대로 쌓이니 출구에서 걸러주는 통합이 필수입니다. 학습 후에는 반대로 관련성 판단 제거가 더 아픕니다(-4.9). 입구에서 장부를 깨끗하게 유지하는 능력을 학습했기 때문입니다. 즉 노이즈 제거 책임이 출구에서 입구로 이동했다는 분석입니다.
학습 단위 분해(Table 5)에서는 콜드스타트 SFT가 55.17 → 75.62로 대부분의 향상을 만들고 RL이 77.16까지 마무리합니다. RL은 이미 생긴 검색 정책을 다듬는 단계라는 해석입니다.
백본 크기에 따른 효과
프롬프팅만 하는 조건(Table 6)에서 SCoRE의 이득은 7B에서 +18.19로 최대이고 122B에서 +2.21까지 줄어듭니다. 큰 모델은 다중 이미지 추론과 노이즈 처리를 내부에서 어느 정도 해내기 때문입니다. 3B는 +11.79를 얻지만 통합 단계 실행 자체가 불안정해, 장부만 유지하고 선택·통합을 빼는 변형이 오히려 높습니다(42.26 vs 28.58). 명시적 구조의 이득은 중간 규모 백본에서 가장 큽니다.
내 해석: 다른 시스템에 옮겨 쓸 수 있는 부분
원문 근거와 제 해석을 구분해서 정리하면 이렇습니다.
- 텍스트 RAG에도 그대로 적용 가능한 패턴입니다. 검색 후 컨텍스트에 문서를 쌓기만 하는 구조라면, 답 생성 직전에 재선택-재정렬 단계를 하나 넣는 걸 먼저 시도할 만합니다. 이건 제 해석이고, 논문은 Visual RAG에서만 검증했습니다.
- 증거 커버리지를 보상의 게이트로 쓰는 설계는 다른 에이전트 RL에도 복사할 수 있는 구조입니다. 정밀도 보상만으로는 증거를 버리는 게임이 생기는데, 커버리지 완전 조건이 그 구멍을 막습니다.
- 컨텍스트 압축과 증거 보존의 분리도 참고할 만합니다. 이미지 토큰은 비싸니 최근 창만 두고, 오래된 증거는 텍스트 요약+포인터로 유지하는 방식은 긴 탐색 에이전트 전반에 적용됩니다.
비슷한 주제의 이전 글: 그래프 구조 검색 에이전트 Harness-G 정리, 시각 추론 도구 적응 BeaCon 정리, 긴 컨텍스트 재현율 관점의 잔여 벡터 메모리 글, 검색 안전성 벤치마크 RAG Safety Bench 글도 함께 보면 좋습니다.
자주 묻는 질문
SCoRE가 해결하는 문제가 뭔가요?
Visual RAG에서 증거가 흩어져 있고, 탐색 궤적의 노이즈가 답에 섞이는 문제입니다. 관찰 중 관련 것만 텍스트 장부에 남기고 답 생성 직전에 원본 이미지를 다시 불러와 정리해서 해결합니다.
기존 VISOR과 다른 점은 뭔가요?
VISOR는 관찰을 텍스트 장부로 변환해서 유지합니다. SCoRE는 여기서 더 나아가 답 생성 직전에 장부가 참조하는 원본 페이지 이미지를 재로딩하고, 선택·재정렬한 뒤 시각 증거로 답을 만듭니다. 텍스트 변환 손실도 피하고 노이즈 페이지도 0.16장까지 줄었습니다.
성능은 어느 정도인가요?
Qwen2.5-VL-7B 기준 SlideVQA 77.16%, ViDoSeek 75.31%, MMLongBench 31.52%입니다. 세 벤치마크 모두 이전 최고보다 높고, 멀티홉에서 약 9점 차이가 났습니다(기준일 2026-09-16, v1).
추가 학습 없이 프롬프팅만으로 쓸 수 있나요?
가능은 한데 백본에 따라 다릅니다. 프롬프팅만 하면 7B에서 가장 큰 이득(+18.19)이 있고, 3B는 선택·통합 실행이 불안정해 오히려 장부만 쓰는 변형이 낫습니다. 논문의 최고 성능은 콜드스타트 SFT + RL을 거친 모델입니다.
코드가 공개되어 있나요?
논문 본문에는 코드 링크가 명시되어 있지 않습니다. 백본은 Qwen2.5-VL 3B/7B, 검색기는 ColQwen2.5-v0.1을 사용했다고 명시되어 있습니다.
더 실습해보고 싶은 분들께
에이전트 루프와 증거 정리 구조를 직접 만들어보고 싶다면 아래 두 개를 추천합니다.
참고 자료
- 논문: Navigating Sparse Evidence: Agentic Visual RAG via Explicit Context Selection and Consolidation — arXiv:2609.15800
- HTML 버전: arxiv.org/html/2609.15800v1
- 비교 대상: VISOR(Shen et al. 2026), VRAG-RL(Wang et al. 2026), EVisRAG(Sun et al. 2025), ViDoRAG(Wang et al. 2025)