결론 먼저
원본 문서와 KV 캐시를 전부 버린 뒤에도, FFN 레이어에 잔차 벡터 하나만 넣어주면 저장된 문장이 그대로 재구성됩니다. 이 논문(arXiv 2609.12686, 고려대)은 이 성질을 써서 200만 토큰 컨텍스트에서 단일 팩트 질문 정확도 50–80%를 냈습니다. 같은 조건에서 비교한 training-free 기법들은 전부 0 또는 0에 가깝습니다. GPU 메모리는 입력 길이와 거의 무관하게 일정하게 유지됩니다.
| 항목 | 값 |
|---|---|
| 논문 | Residual Vector-based Reconstruction as Long-Context Recall Regardless of Context Window Size |
| arXiv | 2609.12686 (2026-09-11 공개) |
| 소속 | 고려대학교 (Ryu Myunghoon, XinYu Piao, Jong-Kook Kim) |
| 핵심 주장 | FFN 활성값에 인덱싱된 잔차 벡터로 원본 없이 사실 재구성 |
| 최대 평가 길이 | 2M 토큰 |
| 2M 토큰 QA1 정확도 | Phi-3.5-mini 50% / Qwen3-4B 67% / Llama-3.1-8B 80% |
| 모델 가중치 변경 | 없음 (완전 frozen) |
| 응답 시 GPU 메모리 | 9.3–10.3GB(소형 모델), 17.1–17.9GB(8B)로 거의 일정 |
문제 정의
LLM이 긴 문서를 다루면 토큰 단위 메모리가 입력 길이에 비례해서 늘어납니다. KV 캐시가 선형으로 커지고, 사전학습된 컨텍스트 창을 넘는 입력은 애초에 처리가 안 됩니다.
기존 접근은 크게 세 갈래입니다.
- 컨텍스트 확장: positional scaling, 롱컨텍스트 파인튜닝. 추가 학습이 필요하고 KV 캐시 문제는 그대로입니다.
- 압축/제거: StreamingLLM, 캐시 eviction, 프롬프트 압축(LLMLingua-2). 나중에 올 질문에 필요한 증거를 미리 지워버릴 수 있습니다.
- 검색(RAG): 원본을 보존하니까 안전하다는 장점이 있는데, 아카이브와 인덱스가 문서 길이에 비례하고 필요한 구간이 검색에 빠지면 답이 틀립니다.
이 논문은 네 번째 길을 제안합니다. 학습 없이, 모델은 얼리고, 사실 단위의 잔차 벡터만 바깥에 저장하는 방식입니다.
핵심 구조: 암기 단계와 응답 단계
전체 파이프라인은 두 단계입니다.
암기(memorization) 단계
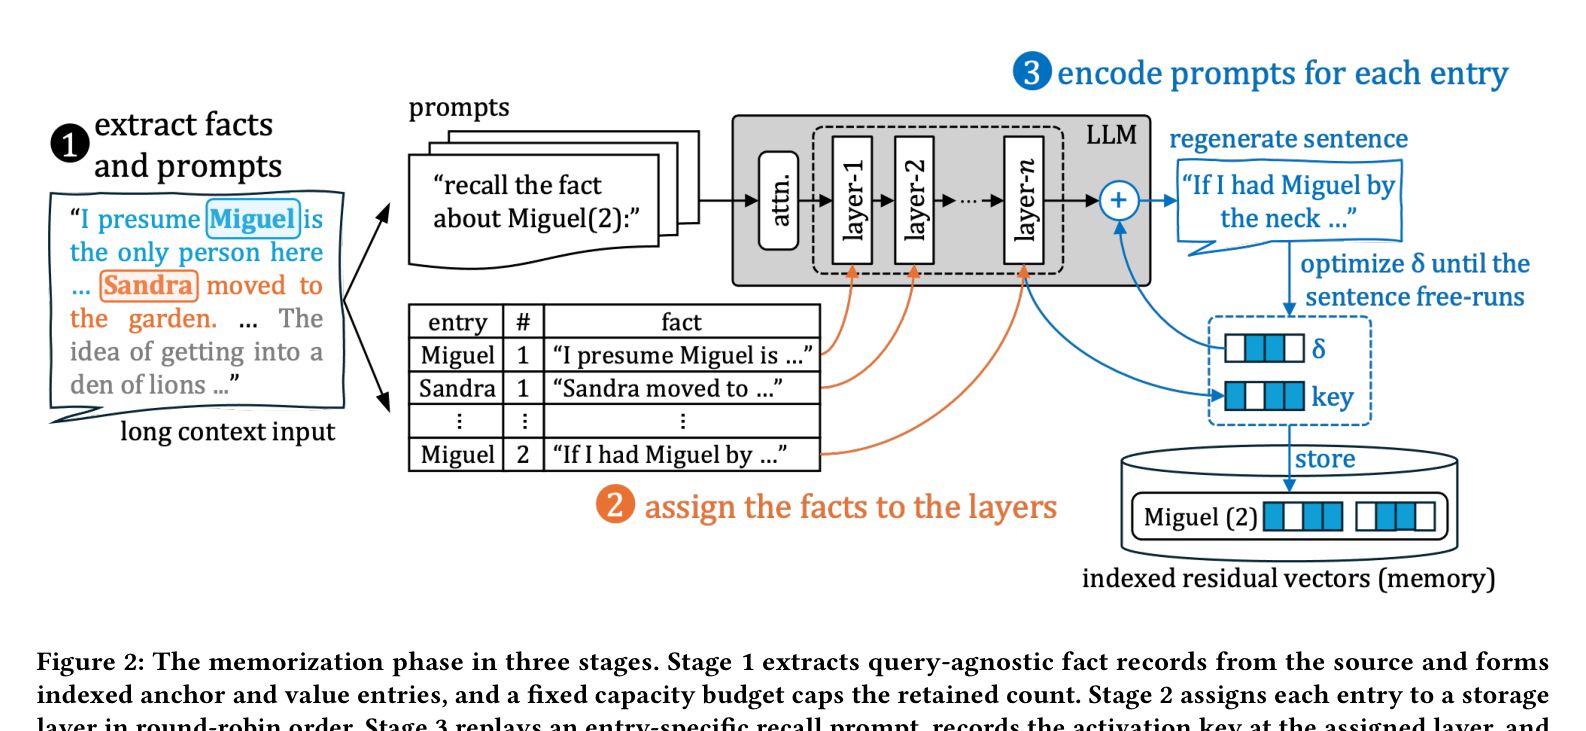
- 고정 크기 윈도우로 문서를 읽으면서 개체명·숫자·식별자가 들어간 문장을 후보로 추립니다. 이때는 질문이 없습니다. query-agnostic하게 사실 레코드(anchor, 인덱스, 원문 문장)를 만듭니다.
- 각 레코드를 FFN 저장 레이어에 라운드로빈으로 배정합니다.
- 레코드별 리콜 프롬프트를 재생하면서 해당 레이어의 활성 키를 기록하고, 저장 문장이 자기완성(free-run)될 때까지 잔차 벡터 δ를 최적화합니다.
저장 예산은 B = min(m̂·n_anc, K·C)로 정해집니다. 앵커 수 기반 정보 상한과 레이어 용량 상한 중 작은 쪽입니다. 원본 토큰과 KV 캐시는 이 단계가 끝나면 버립니다.
응답(response) 단계
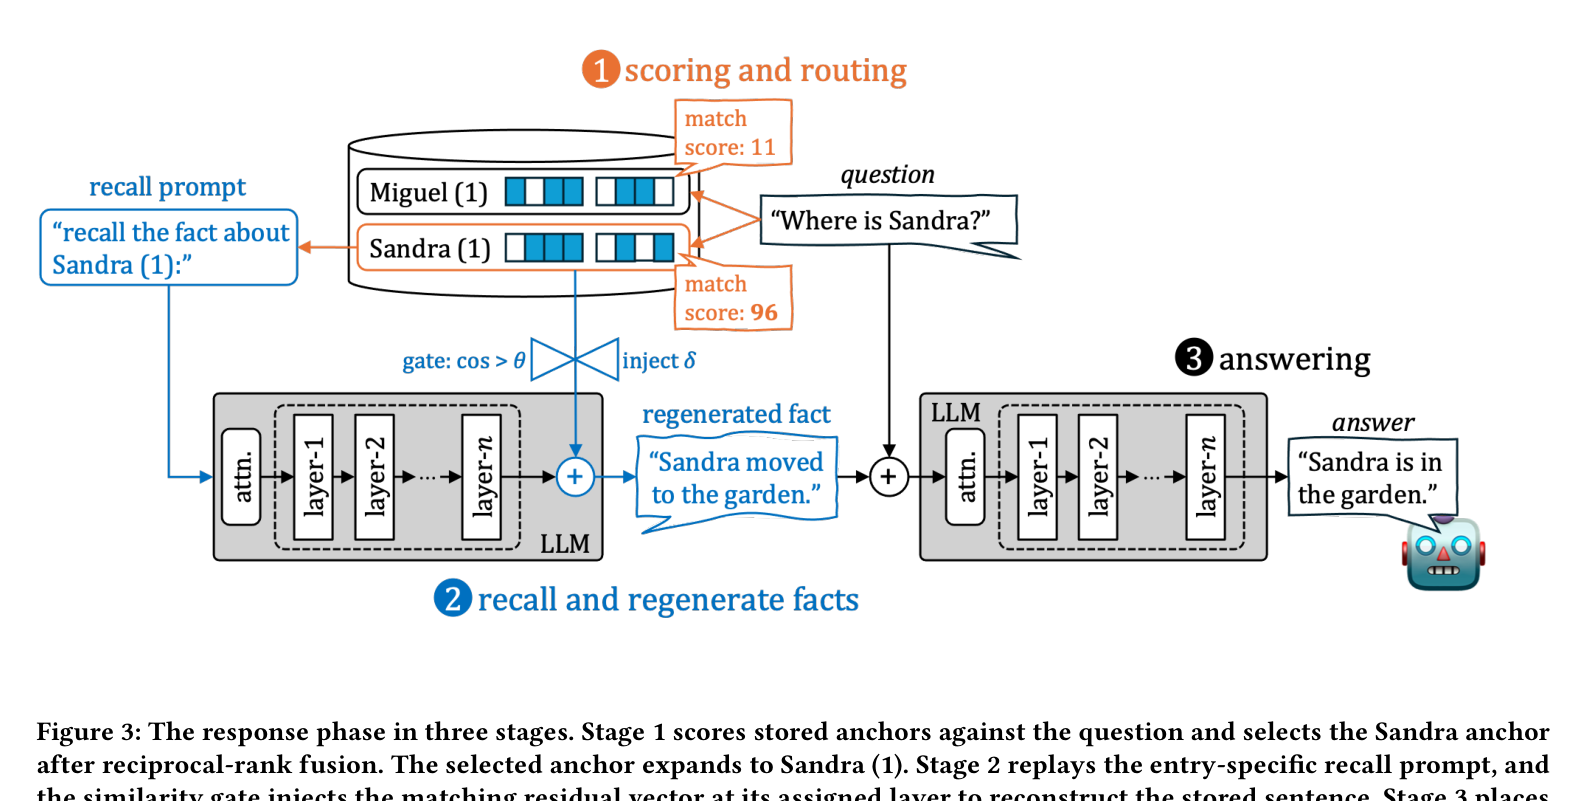
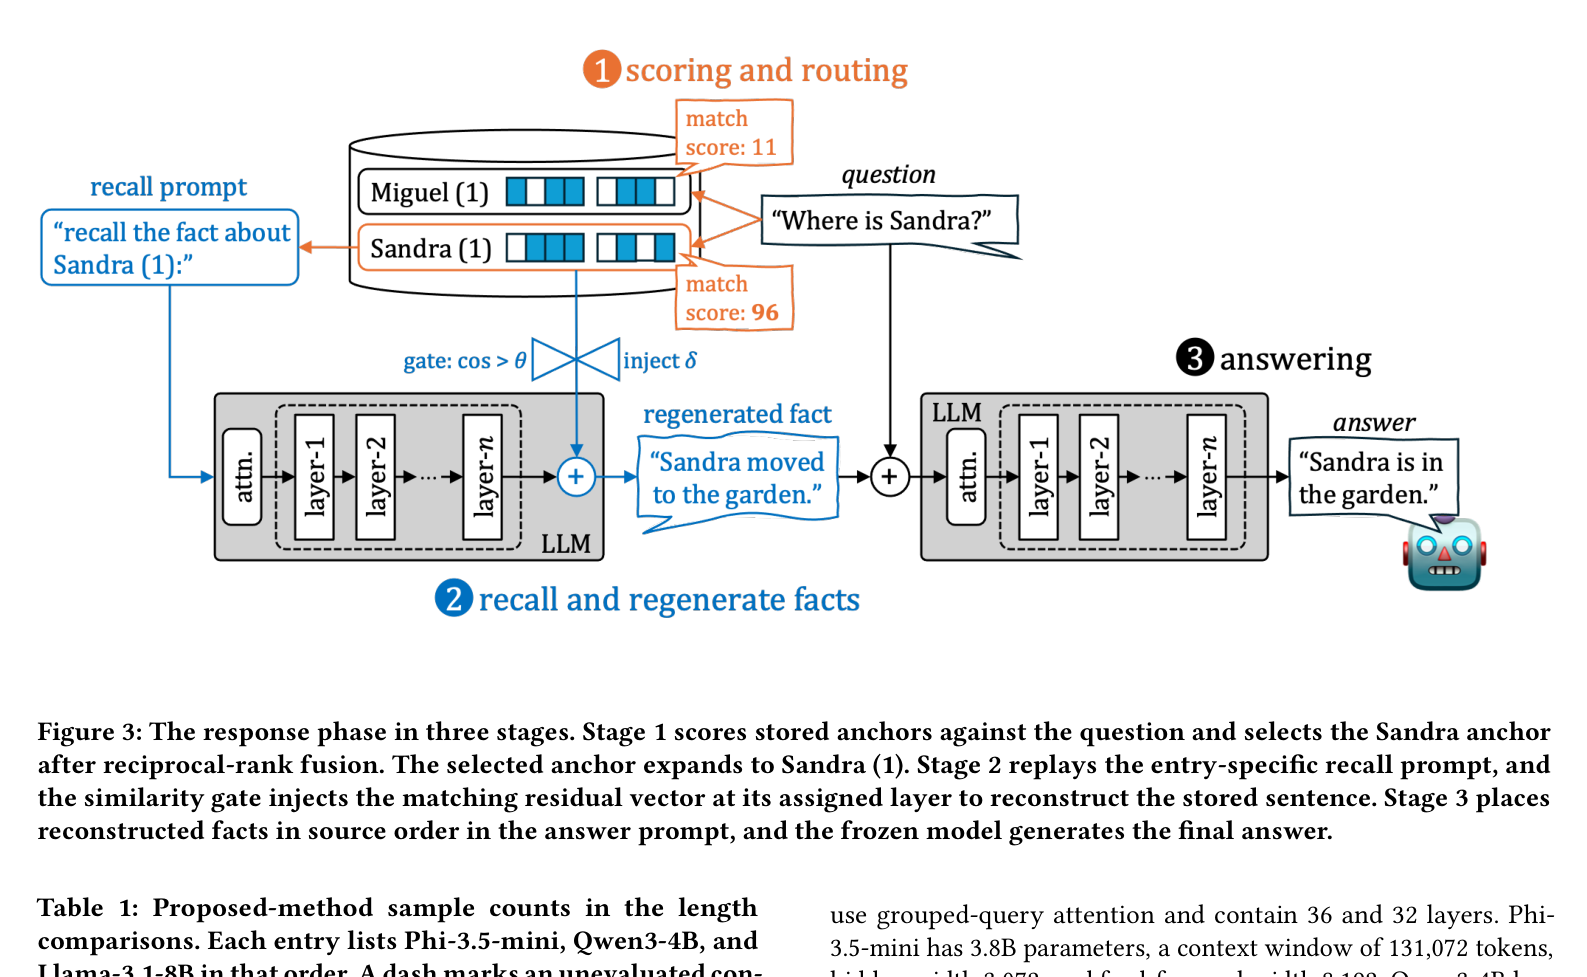
- 질문이 오면 저장된 앵커들을 스코어링해서 상호순위 융합으로 대상을 고릅니다.
- 선택된 엔트리의 리콜 프롬프트를 재생하고, 코사인 게이트가 통과되면 해당 레이어에 δ를 주입해서 저장 문장을 복원합니다.
- 복원된 사실들을 원문 순서대로 답 프롬프트에 넣고 frozen 모델이 최종 답을 생성합니다.
재구성은 결정적(deterministic)입니다. 같은 엔트리에 접근하면 매번 같은 문장이 디코딩됩니다. 저장 비용은 문장 하나당 잔차 벡터 하나입니다.
결과: 2M 토큰에서만 차이가 벌어진다
평가는 세 개의 frozen 모델(Phi-3.5-mini 3.8B, Qwen3-4B, Llama-3.1-8B)로 했고, 80GB A100 1장에서 돌렸습니다.
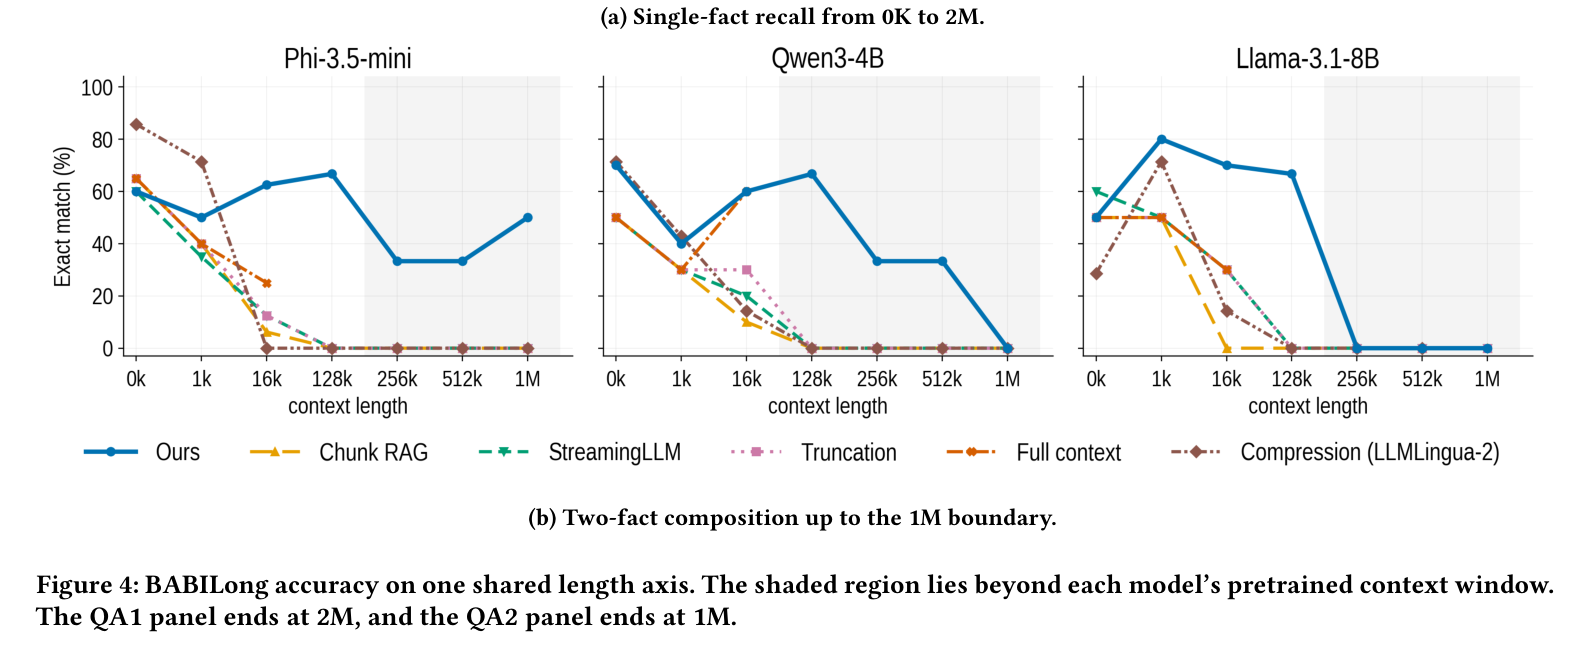
BABILong QA1(단일 팩트 리콜) 기준으로 짧은 입력(0K–1K)에서는 기법 간 우위가 불분명합니다. 차이는 컨텍스트 창을 넘는 구간에서 벌어집니다.
- 2M 토큰: 제안 방법 Phi-3.5-mini 50%, Qwen3-4B 67%, Llama-3.1-8B 80%. 비교 기법(압축, truncation, StreamingLLM, Chunk RAG)은 0 또는 사실상 0입니다.
- 128K 이상 전 구간에서 제안 방법은 모든 셀에서 0이 아닌 정확도를 유지.
- 압축 기법은 이 구간에서 전 구간 0.
QA2(두 팩트 조합)는 격차가 좁습니다. 1M에서 Phi-3.5-mini만 50%를 내고, Llama-3.1-8B는 QA1이 강해도 128K 이후 QA2가 0으로 떨어집니다. 단일 팩트 리콜이 잘 된다고 조합 추론까지 되는 건 아닙니다.
주의할 점: 1M/2M 셀은 셀당 1–5개 샘플입니다. 논문 스스로 가능성 확인(feasibility) 수치라고 못박습니다.
메모리 스케일링
응답 시점 피크 GPU 메모리는 4K에서 2M까지 거의 변하지 않습니다. 소형 두 모델은 9.3–10.3GB, Llama-3.1-8B는 17.1–17.9GB. 활성 스토어 증가는 이 범위에서 0.8GB 미만입니다. 저장된 팩트 메모리는 모든 조건에서 1GB 미만이었습니다.
Chunk RAG는 재랭커와 청크 인덱스 때문에 truncation 대비 4K에서 2.9–3.7GB, 2M에서 7.4–8.9GB를 추가로 씁니다. 정확도와 메모리 둘 다에서 제안 방법의 이점은 “거의 그대로인 GPU 사용량에서 선택적 리콜”이라는 요약이 맞습니다.
위치 민감성
파라프레이즈 세트에서 fact 위치(needle depth)를 바꿔봤을 때 제안 방법은 세 길이(16K/128K/2M) 모두 5개 위치 전부 100%였습니다. Chunk RAG는 72–73%, truncation/StreamingLLM은 꼬리 부근에서만 성공합니다. 원본을 버리기 때문에 위치 개념 자체가 응답 단계에 없다는 게 구조적 이유입니다.
스테이지별 실패 분석
논문의 강점은 실패를 추출/라우팅/재구성/답모델 네 단계로 나눠 분석한 부분입니다.
- 추출 실패: BABILong QA4는 관련 문장이 개체명·숫자·식별자 힌트를 안 가질 수 있어서 애초에 후보에 못 들어갑니다.
- 재구성 실패: RULER 롱 입력 실패는 라우팅 또는 재구성 단계에 몰려 있습니다. “Duchy” 같은 한 단어 짜리 generic 앵커가 원인인 케이스가 있습니다.
- 답모델 실패: QA3은 추출 커버리지가 100%이고 재구성 충실도 0.77 이상인데도 틀립니다. 증거를 갖고 있어도 frozen 모델이 조합을 못 하는 경우입니다.
- 라우팅 실패: NoLiMa 기반 프로브(256K)에서 어휘 중복이 낮은 직접 질문은 제안 방법 12.5%, Chunk RAG 87.5%. 질문과 앵커의 표면 대응이 약하면 라우팅이 무너집니다.
내 해석: 어디에 쓸 수 있나
원문 근거와 구분해서 제 해석을 적습니다.
- 이 방식은 “질문이 나중에 와도 되는 선택적 리콜”에 강합니다. 문서를 먼저 읽고 질문은 그 후에 오는 시나리오(회의록, 계약서, 장기 세션 에이전트)에 잘 맞습니다.
- RULER 결과가 모델별로 갈리는 점은 실무 경고입니다. 밀도 높은 백과성 산문에서는 Qwen3-4B가 Chunk RAG와 동률이고 Llama-3.1-8B는 2M에서 실패합니다. 자기 모델에 대한 검증 없이 도입하면 안 됩니다.
- 게이트 파라미터 θ를 0.75에서 0.45로 낮추면 Llama-3.1-8B는 정확도가 80%에서 40%로 떨어집니다. 관대한 게이트가 접근성을 높이는 대신 재구성 품질을 해칠 수 있다는 것도 튜닝 포인트입니다.
- 8B 이하 모델, 영어 벤치마크, 1장의 A100, 자동 채점이라는 범위 한계는 명확합니다. 사람의 신뢰나 장기 사용성은 측정되지 않았습니다.
광범위한 종합, 암시적 관계, 저장 안 된 컨텍스트는 여전히 원본 검색이나 full-context 처리가 더 적합하다는 게 논문 자신의 결론이고, 저도 동의합니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
컨텍스트 창이 큰 최신 모델도 이 기법이 필요한가요?
컨텍스트 창이 커져도 KV 캐시는 입력 길이에 비례해서 커지고, 창을 넘는 문서는 여전히 처리 자체가 안 됩니다. 이 논문은 창 크기와 무관하게 사실 예산 기반으로 메모리를 고정하는 게 목표입니다.
RAG와의 차이는 뭔가요?
RAG는 원본 문서와 인덱스를 보존하고 질문이 온 뒤에 구간을 골라 답맥락에 넣습니다. 이 논문은 원본을 버리고 사실 문장을 잔차 벡터로 인코딩했다가, 질문 시점에 문장을 복원해 넣습니다. 저장이 문장 단위이고 질문 전에 결정된다는 점이 다릅니다.
모델 가중치를 수정하나요?
안 합니다. frozen 모델의 FFN 활성 주소에 맞춘 외부 잔차 벡터만 최적화하고 주입합니다. 외부 스토어를 지우면 원래 모델로 완전히 돌아갑니다.
2M 토큰 50–80%라는 숫자는 신뢰할 수 있나요?
셀당 샘플이 1–5개인 feasibility 수준입니다. 논문도 정확한 추정보다는 가능성 확인용 수치라고 명시합니다. “다른 training-free 기법이 전부 실패하는 조건에서 동작한다”는 정성적 결론이 핵심입니다.
실무 도입 시 가장 큰 리스크는요?
라우팅입니다. 질문 표현이 저장된 앵커와 어휘적으로 다르면 리콜이 안 됩니다. 앵커를 어떻게 뽑는지, 파라프레이즈 질문을 얼마나 생성해두는지가 실제 성능을 좌우합니다.
참고
- 논문: arXiv:2609.12686
- HTML 전문: arxiv.org/html/2609.12686v1
- 기준일: 2026-09-15 (v1 기준 정리)