결론 먼저
ScienceBuddy의 핵심은 이겁니다. 하네스 개선과 모델 강화학습을 중첩 루프로 묶었다는 점입니다. 하네스만 바꿔도 검증 정확도가 31.1%에서 51.1%로 올라갔고, 모델 RL만으로도 문제 커버리지가 48.3%에서 67.8%로 늘었습니다. 둘을 번갈아 돌리는 게 이 논문의 구조입니다.
핵심 정보표
| 항목 | 내용 |
|---|---|
| 논문 | ScienceBuddy: Recursive-in-Recursive Self-Improvement for Interactive Scientific Agents |
| arXiv | 2609.17523 (2026-09 공개) |
| 코드 | github.com/Gen-Verse/ScienceBuddy |
| 핵심 기법 | 재귀 내 재귀: 하네스 진화(내부 루프) + 모델 RL(외부 루프) |
| 기반 모델 | Qwen3.5-4B (4B 소형 모델) |
| 학습 알고리즘 | GRPO + 루브릭 기반 보상 |
| 하네스 고정 시 정확도 | 검증 31.1% → 51.1% (+20.0pp) |
| 모델 RL만 적용 시 | 커버리지 48.3% → 67.8% (+19.5pp) |
| 도구 규모 | 224개 도구, 22개 모듈 |
기준일: 수치는 전부 논문(arXiv 2609.17523) 실험 섹션 기준입니다.
문제 설정
과학 연구 에이전트는 대화 안에서 답을 고치는 것과, 다음 작업에서 실제로 더 잘하는 것은 다르다는 문제의식에서 출발합니다. 연구자와의 협업 기록을 어떻게 지속 가능한 개선으로 바꿀 수 있을까요.
ScienceBuddy는 이 협업 기록에서 두 가지를 뽑아냅니다.
- 과학 작업: 요청·실행 기록·산출물을 재구성해 instruction, 입력 자산, 실행 환경을 갖춘 Harbor 태스크로 패키징
- 평가 루브릭: 작업 범위, 방법론 요구, 근거, 산출물 기준을 항목별 가중치로 구성
루브릭은 대화에서 자동 구성되지만, 연구자 승인을 정답 레이블로 쓰지 않는다는 원칙을 지킵니다. 실행 가능한 체크와 고정된 판정 모델로 채점합니다.
재귀 내 재귀 구조
논문 제목의 recursive-in-recursive가 핵심 구조입니다.
내부 루프(하네스 진화):
- 작업 모델 θ_k를 고정
- 고정 보조 모델(GPT-6 Astra)이 최근 궤적과 루브릭 평가를 진단
- 하네스에 한 항목씩 bounded edit 제안 — 스킬 하나 추가/삭제/수정, 명령 수정, 컨텍스트 설정 변경 중 하나
- 부모-후보를 동일한 개발 태스크·시드·예산에서 짝 평가
- 유효하고 점수 차 ΔS > 0일 때만 수용, 동점이면 부모 유지
외부 루프(모델 RL):
- 선택된 하네스 H★_k를 고정
- 환경 난이도를 파일럿 실행으로 보정하고 증강 변형 생성
- 루브릭 기반 보상 R_x(τ) = Σ w_c·v_c / Σ w_c 로 GRPO 업데이트 20회 수행
- θ_k+1이 나오면 상속된 하네스를 새 모델로 재평가 후 배포
각 사이클은 내부 탐색 10스텝 + RL 20업데이트로 구성되고, 논문은 3사이클(k=0,1,2)을 실행했습니다. 도구와 실행 인프라, 루브릭, 평가기는 루프 중에 바뀌지 않습니다.
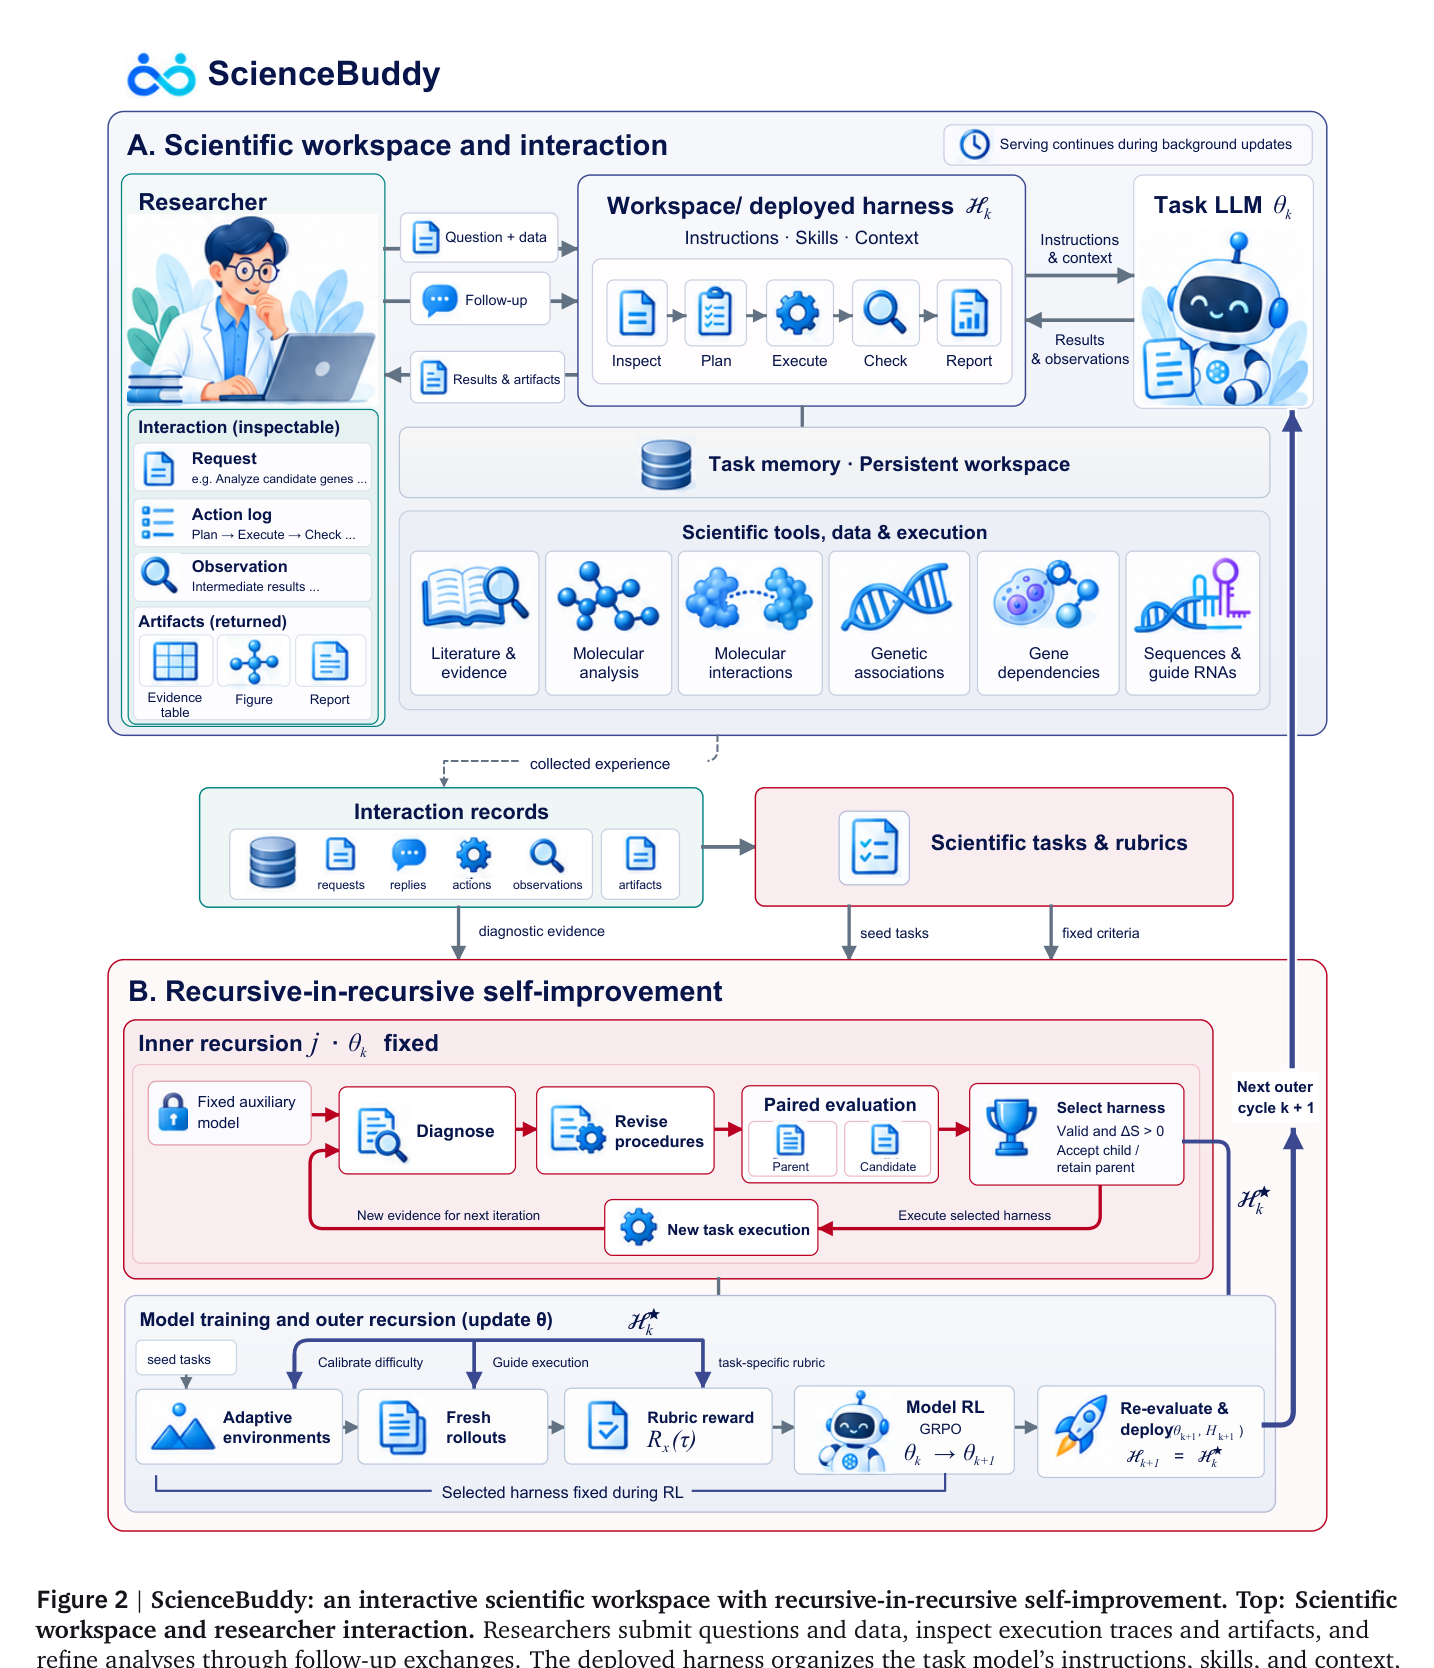 그림 2. 연구자 상호작용에서 학습 신호까지의 전체 구조. 출처: ScienceBuddy 논문, CC BY 4.0.
숫자로 보는 결과
하네스만 바꿨을 때 (4.3절)
LAB-Bench와 Biomni-Eval1 태스크에서 모델 가중치를 고정하고 하네스만 개선했습니다.
| 구분 | 정확도 |
|---|---|
| 초기 하네스 (검증 세트) | 31.1% |
| 선택된 하네스 (검증 세트) | 51.1% |
적응 배치 24회 동안 최고 배치 정확도는 75.0%까지 올라갔습니다. 선택된 하네스에 남은 것은 명령 4개와 scoped 스킬 9개로, Python 실행·스키마 검사·기록 조회·명시적 답 제출 절차였습니다.
모델 RL만 적용했을 때 (4.4절)
이번엔 초기 하네스를 고정하고 약 2시간 RL을 돌렸습니다. 문제 커버리지(pass@4 기준, 풀 수 있는 서로 다른 문제 비율)가 48.3%에서 67.8%로 늘었습니다.
두 루프를 3사이클 돌렸을 때 (4.2절)
검증 정확도가 사이클별로 38.9%→44.4%, 34.4%→46.7%, 61.1%→70.0%로 개선됐고, 훈련 전후 비교에서 정답 42.2%가 73.3%로 이동했습니다. 내역은 이렇습니다.
- 처음부터 맞고 계속 맞음: 40.0%
- 새로 풀게 된 문제: 33.3%
- 계속 틀림: 24.4%
- 더 이상 맞추지 못함: 2.2%
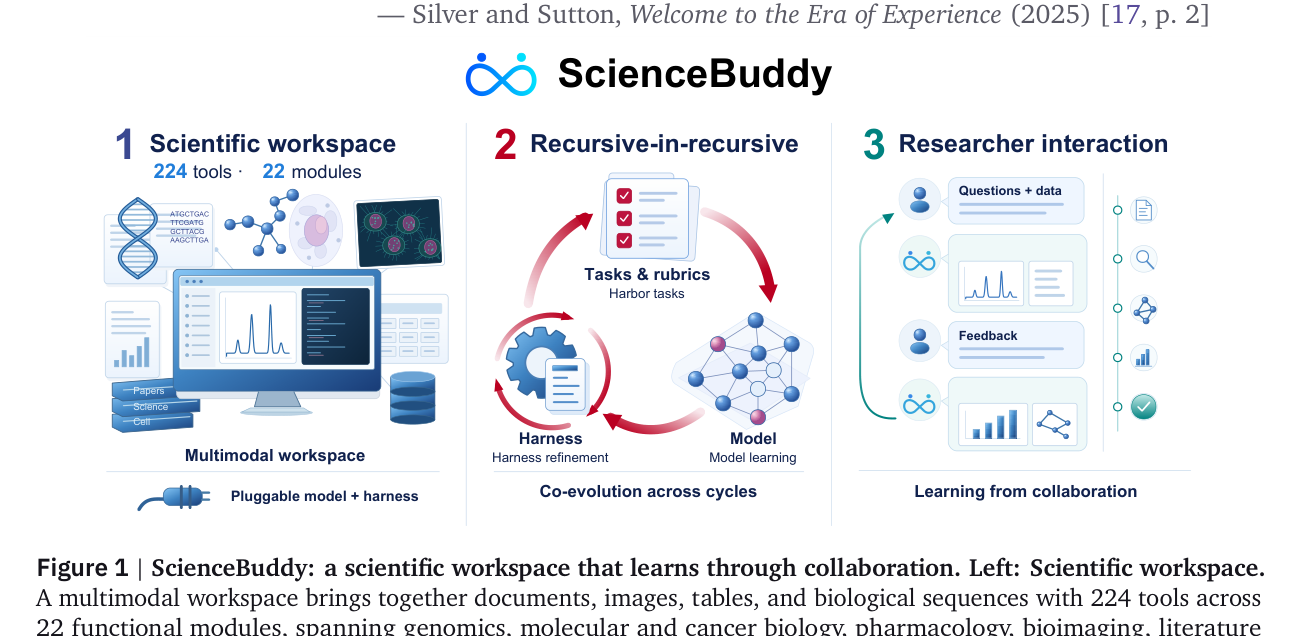 그림 1. 워크스페이스·재귀 구조·연구자 상호작용 개요. 출처: ScienceBuddy 논문, CC BY 4.0.
내 해석: 왜 이 구조가 유효한가
논문 근거와 제 해석을 나눠서 적습니다.
원문 근거로 명확한 부분은 하네스 개선과 모델 RL이 직교하는 이득을 낸다는 것입니다. 4.3절과 4.4절이 각각 한쪽을 고정하고 분리 측정한 실험입니다.
여기에 제 해석을 더하면, 이 구조의 실질적 장점은 개선 단위가 명시적이고 평가 가능하다는 점입니다. 하네스 수정은 한 번에 한 항목만 바꾸고 짝 평가로 수용/기각을 가리니, 무엇이 시스템을 좋게 만들었는지 추적할 수 있어요. 프롬프트 전체를 통째로 재작성하는 방식과의 차이입니다.
주의할 점도 있습니다. 진단·편집에 GPT-6 Astra라는 별도 보조 모델이 필요하고, 루프마다 짝 평가와 RL 예산이 듭니다. 개인 규모 하네스에 바로 적용하기엔 비용이 만만치 않습니다.
관련 글
- 하네스 교체 효과를 벤치마크로 측정한 Harness or Model? 정리
- 하네스 코드 진화를 다룬 Ecdysis 하네스 훈련 글
- 스킬 뱅크 방식의 HEXA in-context RL 정리
더 실습해보고 싶은 분들께
자주 묻는 질문
ScienceBuddy가 모델 가중치를 바꿔요, 하네스를 바꿔요?
둘 다입니다. 내부 루프는 모델을 고정하고 하네스(명령·스킬·컨텍스트 절차)만 바꾸고, 외부 루프는 선택된 하네스를 고정하고 GRPO로 모델을 학습합니다. 두 루프를 사이클마다 번갈아 돌립니다.
사용자 피드백이 그대로 정답 레이블이 되나요?
아니요. 논문은 연구자 응답이 루브릭 구성에 참고는 되지만 정답 ground truth로 자동 취급하지 않는다고 명시합니다. 채점은 실행 가능한 체크와 고정 판정 모델이 담당합니다.
작은 모델로도 돌아가나요?
예. 메인 실험이 Qwen3.5-4B 기준입니다. 다만 하네스 편집용 보조 모델(GPT-6 Astra)과 짝 평가 비용은 별도로 필요합니다.
하네스 개선만으로 얻는 이득은 어느 정도인가요?
모델 가중치 고정 상태에서 검증 정확도 31.1% → 51.1%(+20.0pp)입니다. 모델 학습 없이 절차 수정만으로 낸 이득치고 큽니다.