핵심 요약
Harness or Model? (arXiv:2609.11987)은 에이전트 코딩 시스템에서 하네스가 미치는 영향을 분리 측정한 논문입니다. 모델을 고정하고 하네스만 교체하는 페어 대조를 프라이빗·오염 통제 태스크 풀(80개 고정)에서 수행했고, 800회 계획 중 792회를 채점했습니다. 결과는 어느 하네스도 평균 우위를 확보하지 못했다는 것입니다.
| 항목 | 수치 |
|---|---|
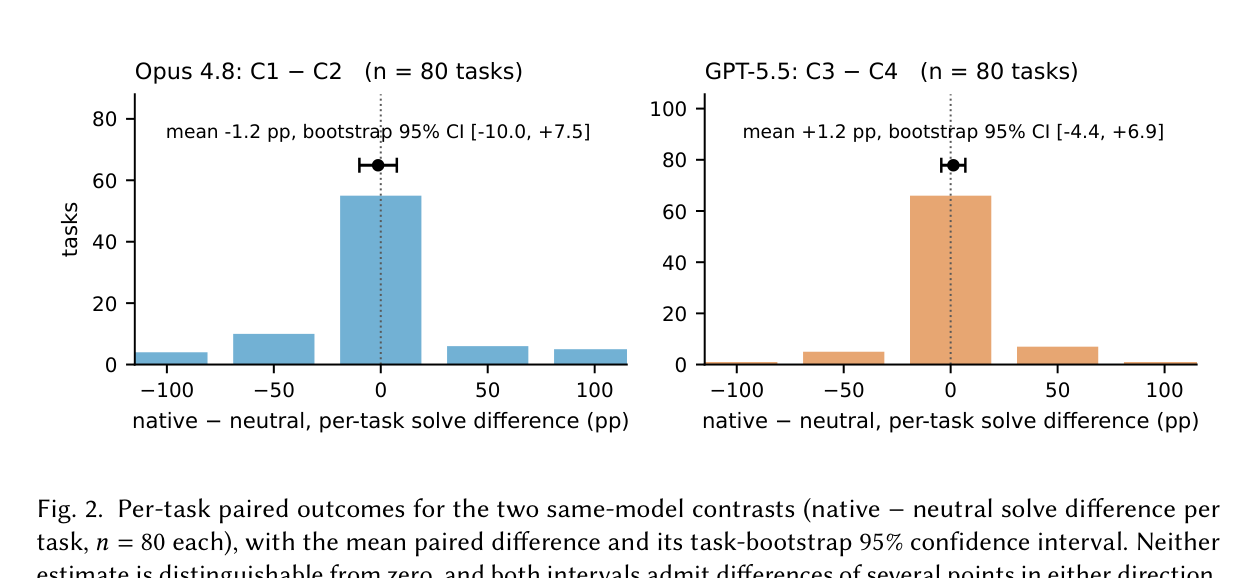
| Opus 4.8 (claude-agent-sdk vs deepagents) | 48.8% vs 50.0%, 차이 −1.25pp, 95% CI [−10.0, +7.5] |
| GPT-5.5 (openai-codex vs deepagents) | 55.6% vs 54.4%, 차이 +1.25pp, CI [−4.4, +6.9] |
| repository 태스크(61개)에서 Opus 네이티브 | −9.0pp |
| contest 태스크(19개)에서 Opus 네이티브 | +23.7pp (순열검정 p=0.003, post-hoc) |
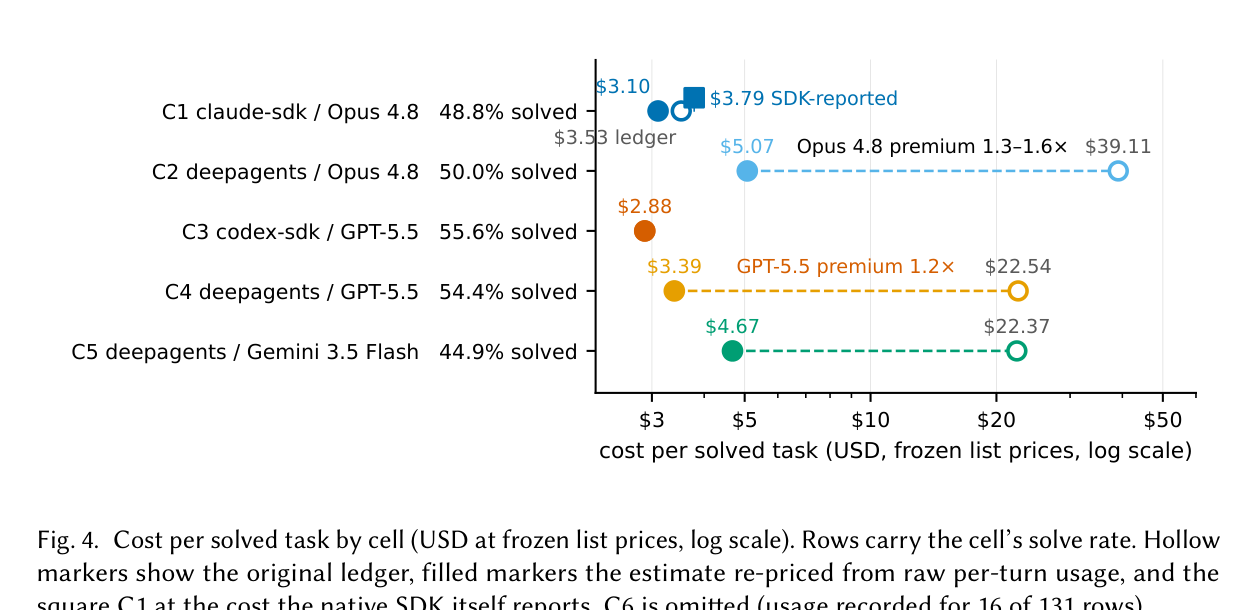
| 해결당 비용(중립/네이티브) | Opus 1.3–1.6배, GPT-5.5 1.2배 |
| 사이드 셀 | gemini-3.5-flash 44.9%, deepseek-v3.2 19.7% |
두 대조 모두 신뢰구간이 0을 포함해서, 본 설계에서는 평균 우위를 확인할 수 없었습니다. 기준일 2026-09-14, 원문은 arXiv:2609.11987 v1(2026-09-08 개정판) 기준입니다.
실험 설계
셀 구성은 6개입니다. C1(Opus 4.8 + claude-agent-sdk), C2(Opus 4.8 + deepagents/LangGraph), C3(GPT-5.5 + openai-codex SDK), C4(GPT-5.5 + deepagents), C5(gemini-3.5-flash + deepagents), C6(deepseek-v3.2 + deepagents). 각 런은 KVM 마이크로VM 1개에서 독립 실행됐고, append-only 이벤트 로그로 전 과정이 기록됐습니다. 벤더 하네스의 승인·샌드박스 계층은 꺼서 환경 조건을 동일하게 맞췄습니다.
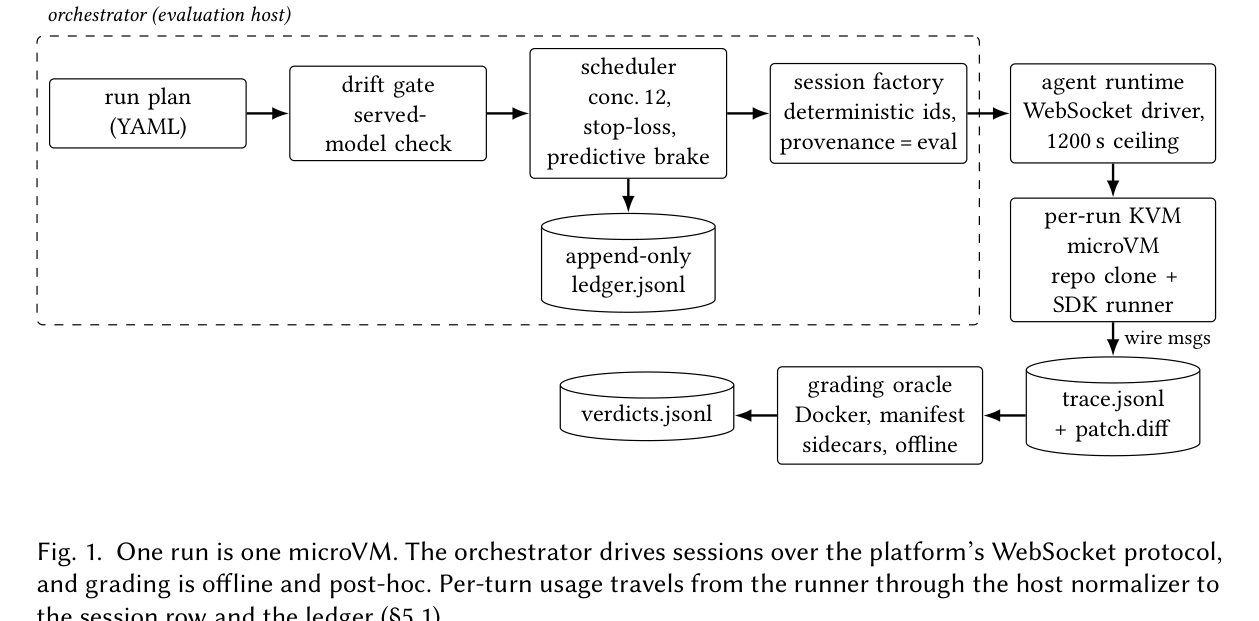
오염 통제가 이 논문의 뼈대
태스크는 두 트랙으로 구성됩니다. Track A는 사내 프로덕션 코드베이스 4곳에서 채굴한 repository 태스크 179개로, 히든 테스트와 골드 패치를 포함합니다. Track B는 자격일(2026-03-02) 이후 출제된 LeetCode/AtCoder 문제 77개입니다.
컷오프 레지스트리는 데이터 수집 전인 2026-06-24에 동결됐고, 매 페이즈마다 서빙 모델 identity를 검증하는 런타임 drift gate를 통과했습니다. 채점은 Docker 격리 오라클이 오프라인으로 수행합니다. 패치를 git diff로 추출해 히든 테스트 통과 여부만 봅니다.
결과: 페어 대조
Table 4와 Figure 2가 주 결과입니다.
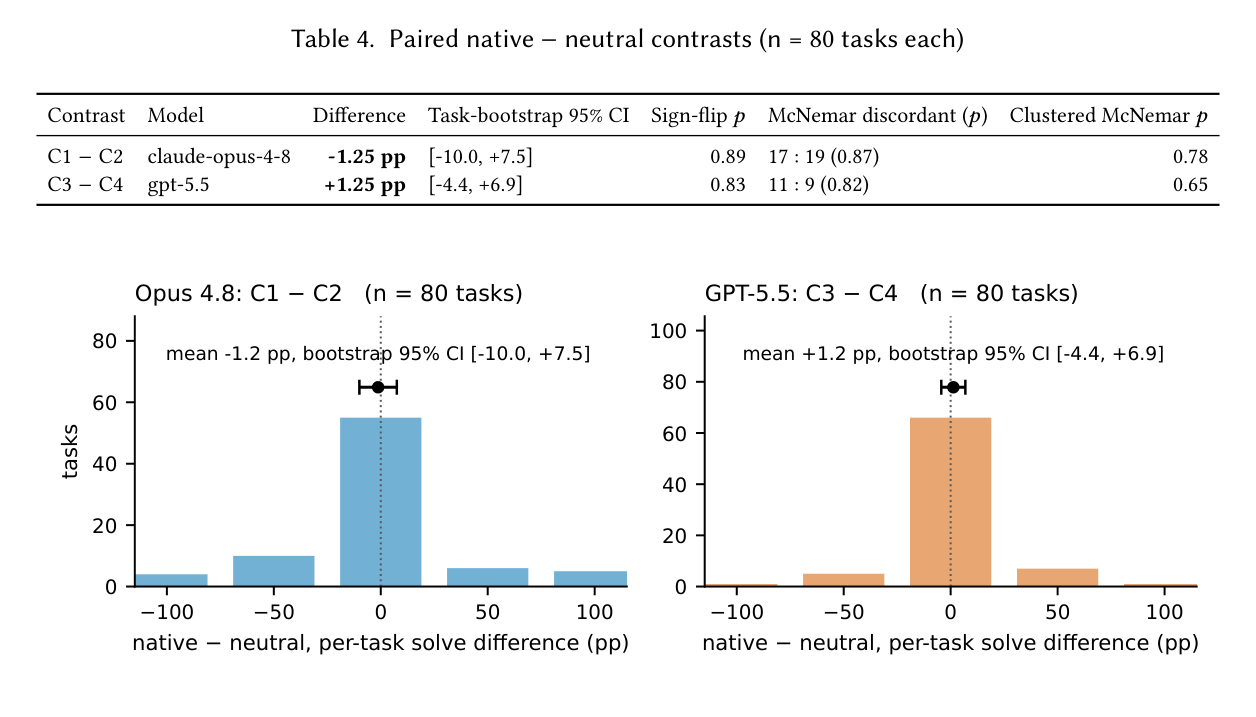
두 신뢰구간 모두 0을 포함하고, 몇 포인트의 양방향 차이를 배제하지 못합니다. 저자는 이 결과를 동등성 증명으로 제시하지 않고 불확실성 보고로 명시합니다.
작업 유형별 분할: 부호가 뒤집히는 패턴
Opus 4.8에서 하네스 효과의 부호가 작업 유형에 따라 반전됩니다. 61/80 × (−9.0) + 19/80 × (+23.7) = −1.25로 전체 추정치에 정확히 분해됩니다.
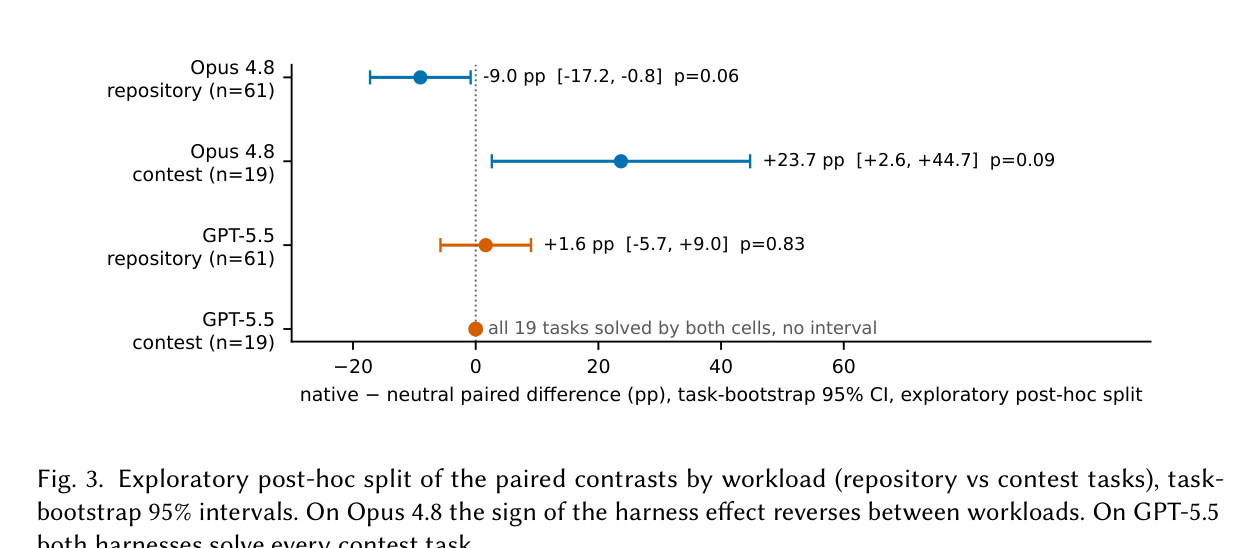
저자는 이 분할이 데이터 관찰 후 선택된 것이므로 설계된 복제가 필요한 post-hoc 패턴이라고 명시합니다. 실무 코드베이스에서는 중립 하네스가, 경합 문제에서는 네이티브가 앞서는 구조입니다.
정답륑과 자율 완료는 다른 엔드포인트
1,200초 상한에서 취소된 81개 런 중 22개가 통과 패치를 이미 생성한 상태였습니다.
중립 하네스의 상한 도달은 C2 32회 대 C1 1회로 훨씬 잦았고, 세션당 도구 호출 중앙값도 C1 44.5회 vs C2 90.5회였습니다. 성적 차이보다 지연·비용에서 설명되는 구간입니다.
비용: 중립 하네스가 해결당 1.3~1.6배
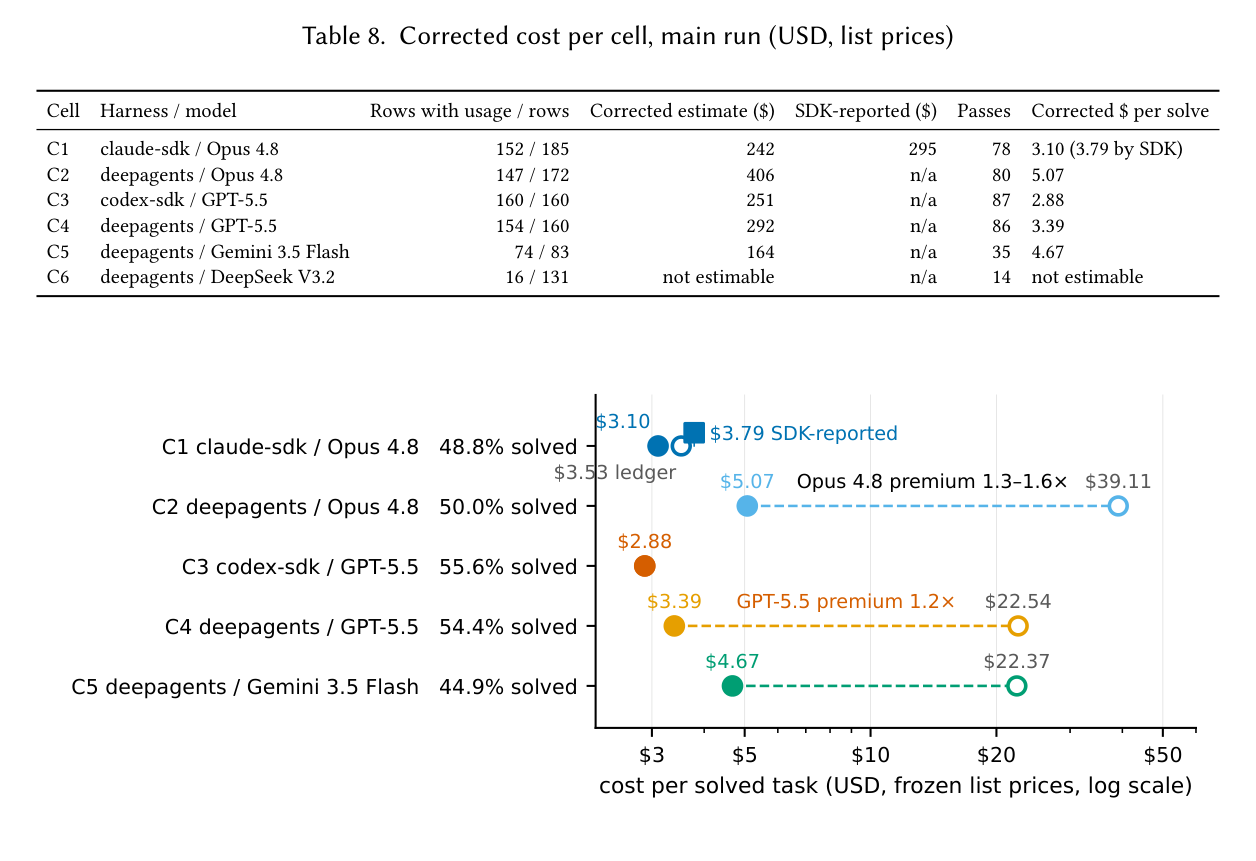
원시 per-turn 사용량을 고정 리스트가로 재계산한 해결당 비용은 중립 하네스가 Opus에서 1.3–1.6배(부트스트랩 CI [1.29, 2.09]), GPT-5.5에서 1.2배입니다. Opus 총 격차 164 중 <span style="background-color: #fff59d"><strong>124가 캐시 읽기에서 발생합니다. 중위 per-run 입력은 C1 1.04M토큰 대 C2 2.52M토큰이었습니다.
텔레메트리 결함 발견과 개정
8월 원고는 중립 하네스가 2.6배 비싸다고 보고했는데, 사후 검토에서 자체 파이프라인의 결함이 발견됐습니다. LangChain 계열 사용량 메타데이터는 캐시를 포함한 input_tokens를 주는데, 노멀라이저가 캐시 토큰을 한 번 더 더해 최대 2배 가깝게 부풀렸던 것입니다.
- 결함 수정 후 모든 셀의 캐시 비중은 87–98%로 동일한 레짐
- 2.6배 주장은 철회되고 1.3–1.6배로 정정
- 결함 내역과 재분석 코드가 전부 공개
SDK마다 캐시 토큰 포함 규약이 다르다는 점은 에이전트 비용 회계를 하는 팀이 바로 점검할 포인트입니다.
실무자에게 남는 것
원문 근거와 제 해석을 구분해 정리하면 이렇습니다.
- 모델을 이미 정했고 하네스를 고르는 중이라면, 평균 성적은 근거로 삼기 어렵습니다. 자기 워크로드에 가까운 태스크로 페어 테스트를 직접 짜는 게 맞습니다.
- 중립 하네스의 실제 페널티는 지연·토큰량·해결당 비용에서 나왔습니다. 성적 차이는 관측되지 않았습니다.
- 월클락 상한에서 취소된 런의 패치를 채점하는 설계는 에이전트 벤치마크에 바로 적용할 만한 디테일입니다.
- 프라이빗 태스크 + 컷오프 동결 + drift gate 조합은 공개 벤치마크 오염 문제의 가장 근사한 해법 중 하나입니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
중립 하네스가 성적에서 밀렸나요?
아니요. 두 대조 모두 신뢰구간이 0을 포함해 우위를 구분할 수 없었습니다. 비용은 관측 사용량 기준으로 중립 쪽이 1.2–1.6배 높았습니다.
네이티브 하네스는 언제 유리한가요?
Opus 4.8의 contest 태스크에서 23.7pp 앞섰습니다. 해당 분할은 post-hoc이므로 재현 확인이 필요합니다.
오염은 어떻게 통제했나요?
프라이빗 태스크, 데이터 수집 전 컷오프 레지스트리 동결, 런타임 모델 drift gate의 3중 방어입니다.
텔레메트리 결함은 어떻게 발견됐나요?
연구 후 검토에서 SDK별 캐시 토큰 규약 차이가 확인돼 노멀라이저의 이중 계산이 발견됐고, 전 수치가 재계산됐습니다.