결론 먼저
에이전트에 스킬이 수만 개 달리면 지금의 두 가지 라우팅 방식 모두 한계에 부딪힙니다. 컨텍스트에 스킬 메타데이터를 미리 밀어 넣는 방식(progressive disclosure)은 컨텍스트를 오염시키고, 임베더+리랭커 검색 파이프라인은 선택을 에이전트 바깥 모델에 넘겨버립니다.
칭화대 IIIS 연구팀의 Gavel은 제3의 길을 제시합니다. 얼린(frozen) 에이전트 LLM의 순전파 중간층에 이미 라우팅 신호가 들어 있고, 선형 사영 두 개만 있으면 그 신호를 읽어낼 수 있다는 관찰이 출발점입니다. 학습 파라미터는 7.9M이 전부입니다. Qwen3-32B 백본으로 1.2B~16B짜리 외부 파이프라인을 이겼고, 실제 bash 에이전트 하네스에서는 훨씬 큰 프론티어 모델보다 정확한 스킬을 더 자주 불러왔습니다.
핵심 요약 표
| 항목 | 값 |
|---|---|
| 논문 | The Router Within: Eliciting Native Skill Routing from a Frozen LLM (arXiv 2609.15982, 2026-09-14) |
| 소속 | 칭화대학교 IIIS (Ruishuo Chen 외) |
| 방법 | 얼린 LLM 중간층(64블록 중 45번째)에서 선형 사영 2개로 라우팅 신호 읽기 |
| 학습 파라미터 | 7.9M (백본은 동결) |
| 백본 | Qwen3-32B |
| 대외 비교 | 외부 1.2B~16B 파이프라인 상대 최대 +21.9pt |
| 실전 하네스 | Skill-Use 트리거율 .909 (GLM-5.1 in Codex .706, MiniMax-M3 .864보다 높음) |
| 기준일 | 2026-09-15 기준, v1 프리프린트 |
문제: 스킬 선택은 왜 어려워지는가
스킬은 SKILL.md 하나로 지식을 확장하는 표준 수단이 됐습니다. 근데 잘못 고른 스킬은 스킬이 없을 때보다 성능을 더 떨어뜨립니다. 그리고 공개 라이브러리는 이미 수만 규모라 선택 자체가 병목입니다.
현재 배포된 시스템은 두 갈래입니다.
- Progressive disclosure: Claude Code, Codex가 쓰는 방식. 설치된 스킬의 이름+설명을 시스템 프롬프트에 미리 싣고 에이전트가 골라서 읽습니다. 메타데이터가 컨텍스트를 커진 만큼 잡아먹고, Codex는 스킬 메타데이터를 컨텍스트의 2%로 제한할 정도로 비용이 큽니다. 스킬 수가 늘수록 정확도는 로그 스케일로 하락합니다.
- Retrieve-and-rerank: 임베더+리랭커가 스킬을 골라 주입합니다. 컨텍스트는 깨끗해지는데, 대신 롤아웃을 못 본 외부 모델이 판단합니다. 에이전트가 좋아져도 라우터는 그대로입니다.
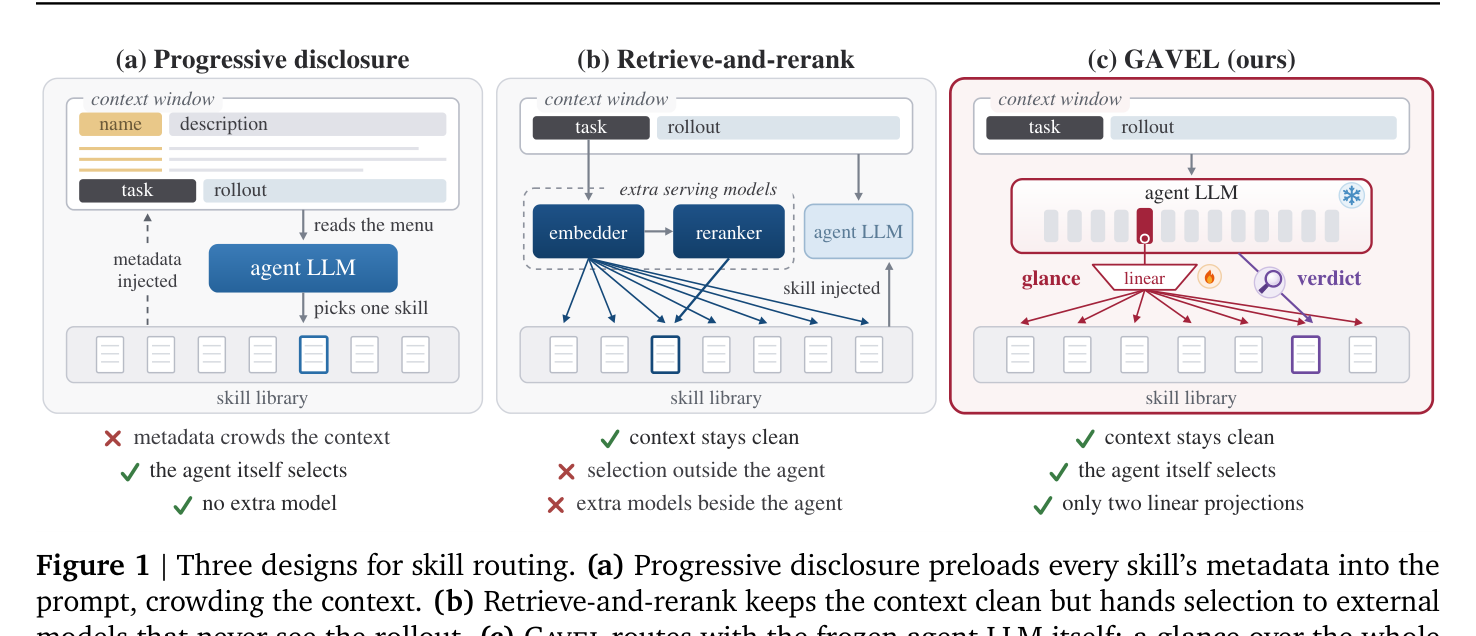
Figure 1이 세 설계를 잘 보여줍니다. (a)는 컨텍스트 오염, (b)는 에이전트 바깥 선택, (c) Gavel은 컨텍스트도 깨끗하고 에이전트 자신이 고릅니다.
방법: Glance와 Verdict, 두 단계
Gavel은 Glance And Verdict from a frozen LLM의 약자입니다. 두 단계로 돌아갑니다.
방법 1단계: Glance로 전체 라이브러리 훑기
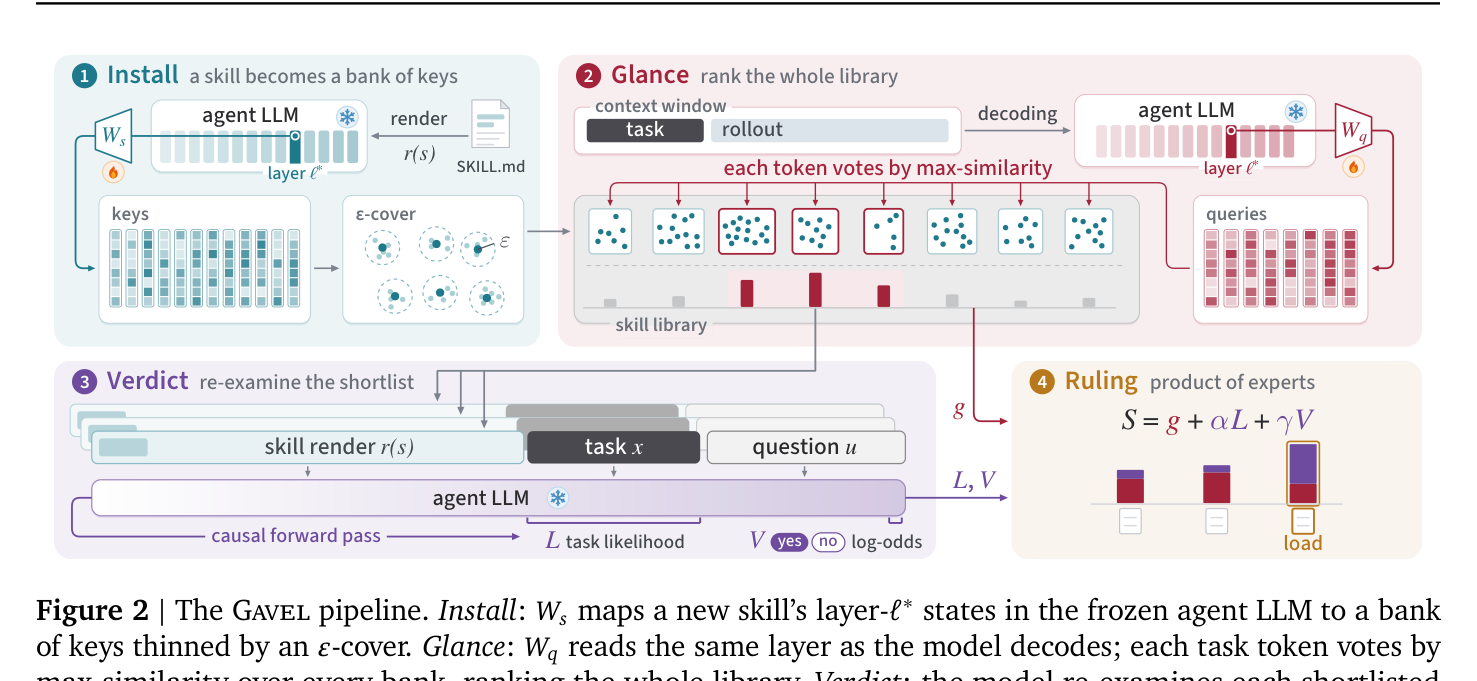
백본 중간층 하나(압축 밸리 지점, Qwen3-32B에서는 64블록 중 45번째, 깊이의 약 70%)에 선형 사영 두 개를 붙입니다. 쿼리 맵 W_q는 태스크 토큰 상태에서 “필요한 능력”을, 키 맵 W_s는 스킬 토큰 상태에서 “제공하는 능력”을 읽습니다.
스킬 설치 시에는 렌더링 한 번 + 순전파 한 번으로 키 뱅크를 만듭니다. 여기에 ε-cover 압축(ε=0.83)으로 뱅크를 약 8.5배 줄이면서 손실은 최대 1.6pt로 봉쇄합니다. 새 스킬 추가에 학습이 전혀 필요 없습니다. 수학적 보장도 있습니다. Proposition 1이 압축 후 최대 유사도가 원본보다 최대 ε만큼 낮아지고 커지지는 않음을 증명합니다.
태스크 토큰 각각이 자기 최상위 k개 스킬에 투표합니다. 소수의 결정적 토큰이 평균에 묻히지 않게 하는 장치입니다.
방법 2단계: Verdict로 후보 재검
글랜스로 좁힌 후보(평균 9개, 마진 Δ=0.133)에 대해서는 얼린 모델의 풀 어텐션을 씁니다. 스킬 렌더 뒤에 태스크를 붙여 forward를 이어가고 두 신호를 읽습니다.
- L: 태스크의 평균 로그 가능도 — 스킬이 태스크를 얼마나 잘 예측하게 만드나
- V: “이 스킬이 태스크에 필요한 걸 주는가”라는 질문에 대한 yes/no 로그 오즈
최종 스코어는 S = g + αL + γV (α=1.0, γ=0.025)로 product of experts 방식입니다. 세 신호가 같은 로그 사후확률의 서로 다른 독법이라서 곱으로 융합하며, 하나의 전문가가 다른 둘이 그저 tolerable한 후보에 거부권을 줄 수 있습니다.
결과: 7.9M이 16B를 이긴다
공개 벤치마크 3종
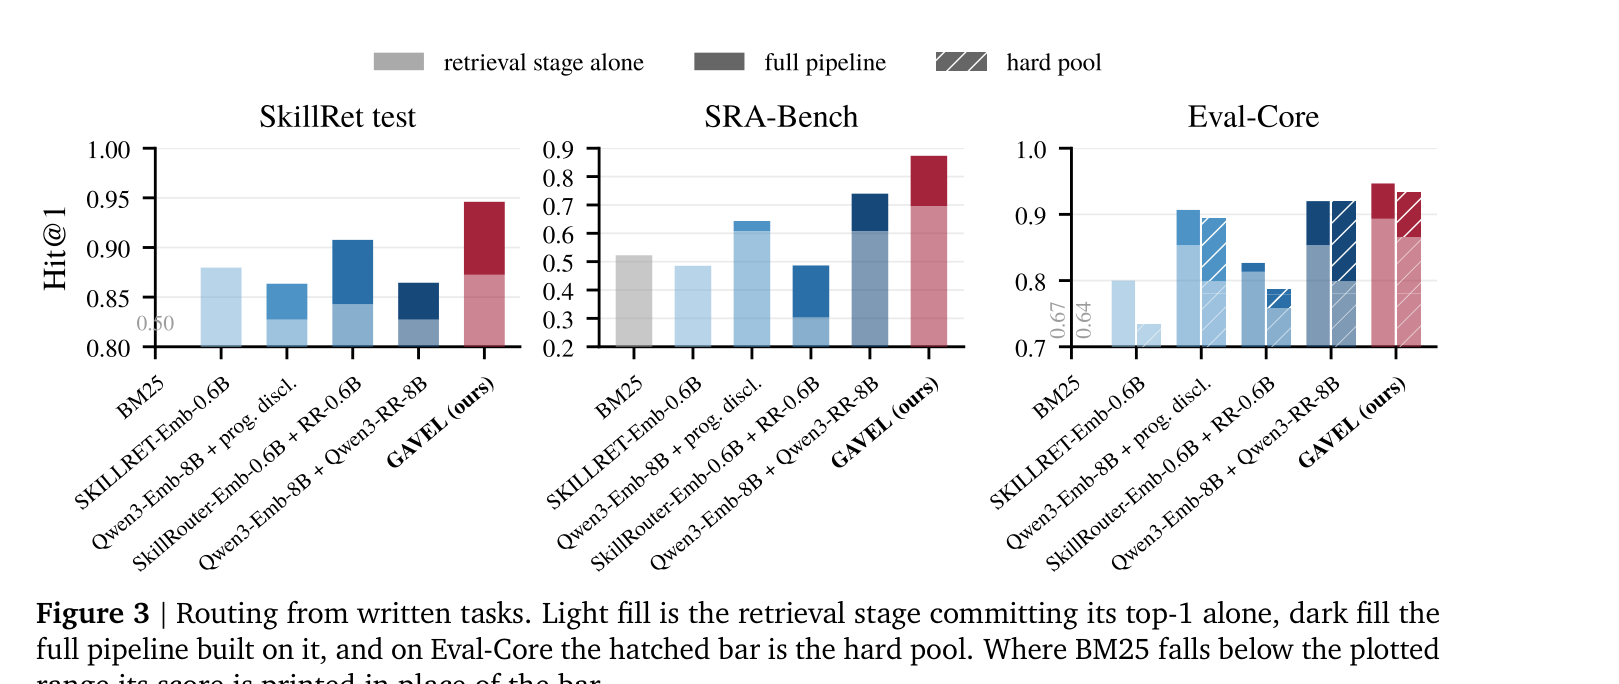
SkillRet 테스트(4,997 쿼리 / 6,660 스킬), SRA-Bench(26,262 스킬, 861 태스크 샘플), Eval-Core(78K 문서)에서 Hit@1을 측정했습니다. 골드 라벨이 부실해 GPT-5.6 Sol 재판정(adjudication)으로 스코어링했습니다.
- SkillRet: 최강 파이프라인 대비 +3.8pt
- SRA-Bench: +13.4pt — 장르가 바뀌자 학습된 임베더들은 BM25보다 아래로 떨어졌습니다(도메인 외 실패)
- Eval-Core: +1.3~2.7pt
롤아웃 중간에 필요가 생기는 경우
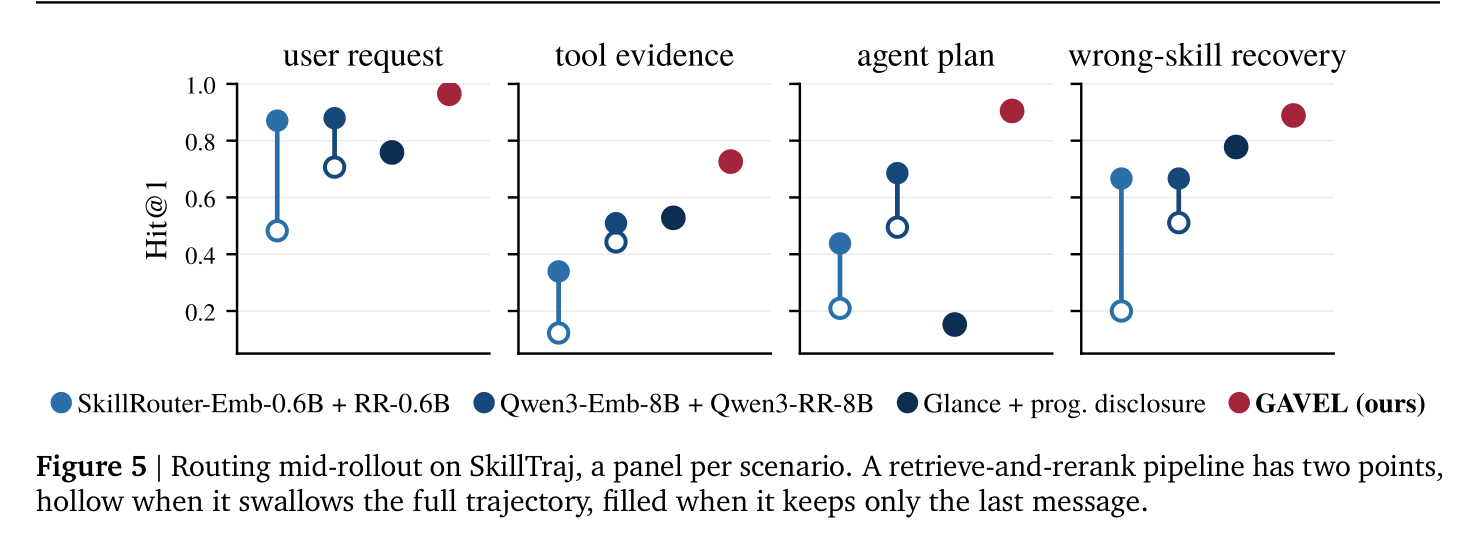
실전 에이전트는 보통 한 턴짜리 깨끗한 태스크를 받지 못하고, 긴 다중 턴 컨텍스트 중간에 스킬이 필요해집니다. 저자들이 새로 만든 SkillTraj 벤치마크(372개 시뮬레이션 트랙토리, 4개 시나리오: user request 116 / tool evidence 106 / agent plan 105 / wrong-skill recovery 45)에서는 Gavel이 모든 시나리오에서 8.6~21.9pt 차이로 1위를 기록했습니다.
검색 파이프라인은 여기서 딜레마에 빠집니다. 전체 트랙토리를 삼키면 임베딩이 모든 주제를 섞고, 마지막 메시지만 쓰면 근거가 사라집니다. Gavel은 컨텍스트가 이미 있는 곳, 즉 에이전트 자기 순전파 안에서 판단합니다.
실전 하네스 모델 실험: Skill-Use
mini-swe-agent(bash 에이전트)에 Gavel을 통합하고 Skill-Use(177개 실행 태스크, 79개 스킬)에서 측정한 정확 스킬 트리거율입니다.
| 시스템 | 트리거율 |
|---|---|
| GLM-5.1 (in Codex) | .706 |
| MiniMax-M3 (in Codex) | .864 |
| Qwen3.6-Max (in Codex) | .684 |
| DeepSeek-V4-Pro (in Codex) | .650 |
| Qwen3.Emb-8B + Qwen3.RR-8B | .897 |
| SkillRouter-Emb-0.6B + RR-0.6B | .800 |
| Qwen3-32B (progressive disclosure만) | .011 |
| Qwen3-32B + Gavel | .909 |
같은 32B 모델이 progressive disclosure 프롬프트에서는 스킬을 거의 안 읽는데(.011), Gavel을 붙이자 프론티어급 대형 모델을 넘어섭니다. 하네스가 주는 차이가 모델 크기 차이를 뛰어넘는 사례입니다.
내 해석: 왜 이 결과가 의미 있는가
이 논문의 진짜 기여는 숫자보다 관점 전환이라고 봅니다. 그동안 라우팅은 “컨텍스트 안의 문제” 아니면 “외부 검색의 문제”로 나뉘어 있었습니다. Gavel은 그 사이의 제3공간을 보여줍니다. 모델의 중간층 표현은 다음 토큰 예측만을 위한 게 아니라, 학습된 read-out이 있으면 검색 신호원으로 쓸 수 있다는 것.
하네스 설계 관점에서 정리하면 이렇습니다.
- 스킬 선택기를 얼린 백본 옆에 붙이면 백본이 좋아질 때 같이 좋아집니다(논문도 라우팅 정확도가 백본을 따라 상승함을 확인).
- 설치 비용은 순전파 1회. 수만 스킬 라이브러리에 필요한 조건입니다.
- 토큰 단위 late-interaction이 핵심인데, 어뷰레이션에서 글랜스를 Jina-ColBERT-v2로 바꾸면 전 벤치마크에서 크게 떨어집니다. 즉 이득은 비교 방식이 아니라 에이전트 LLM이라는 더 좋은 압축기에서 읽어낸다는 데서 옵니다.
관련 흐름은 기존 정리글과 이어집니다. 선택기에 크레딧을 배분하는 문제는 2026-08-23-skillgate-selector-credit에서, 하네스와 모델 중 어디에 투자할지 논쟁은 2026-09-14-harness-or-model에서, 스킬 자체의 개념 정리는 2026-08-19-demystifying-agent-skills에서 다뤘습니다. 실전 트리거 컴플라이언스 관점은 2026-08-24-skill-use-trigger-compliance-boundary와 연결됩니다.
한계와 남은 질문
- 저자들이 남긴 열린 질문: 같은 read-out이 도구, 메모리, MCP 서버 라우팅에도 통할지.
- 스킬이 정말 필요 없는 순간의 판단(gate)은 별도 학습이 필요했습니다. SkillTraj 결정점을 positive로 게이트를 훈련했고, verdict가 승자도 부적합이라 판단하면(V<0) 아무것도 로드하지 않습니다.
- 백본 forward 상태에 접근해야 하므로, API 전용 백본에는 적용이 어렵습니다. 오픈웨이트 모델 하네스를 전제한 방법입니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
Gavel의 학습 방법: 백본 파인튜닝 여부
아니요. 백본은 완전히 얼려 있고, 학습되는 것은 중간층 read-out 선형 사영 2개(총 7.9M 파라미터)뿐입니다. 그래서 백본이 교체·개선되면 라우팅 정확도도 같이 올라갑니다.
새 스킬을 추가하는 방법과 비용
아니요. 새 스킬은 고정 프롬프트로 렌더링해서 순전파 1회를 돌리고, 나온 중간층 상태를 선형 맵으로 키 뱅크로 저장하면 끝입니다. ε-cover 압축으로 뱅크 크기는 약 8.5배 줄어듭니다.
검색 파이프라인 대비 성능 차이와 이유
기준일 2026-09-15, v1 프리프린트 기준으로 외부 파라미터 1.2B~16B를 추가하는 retrieve-and-rerank 대비 SkillRet +3.8pt, SRA-Bench +13.4pt, 롤아웃 중간 상황(SkillTraj)에서는 최대 +21.9pt입니다. 실전 bash 하네스(Skill-Use)에서는 트리거율 .909로 모든 비교 대상을 앞섰습니다.
원문 확인 방법
arXiv 2609.15982 — https://arxiv.org/abs/2609.15982 (The Router Within: Eliciting Native Skill Routing from a Frozen LLM, Tsinghua IIIS, 2026-09-14 공개).