한눈에 보는 결론
에이전트를 돌리다 보면 검색이 계속 헛도는데도 멈추지 않고 예산을 다 태우는 경우가 있죠. 10월 3일부터 5일까지 사흘 동안 arXiv에 딱 이 문제를 다룬 논문이 몰려 올라왔습니다. “에이전트는 왜 멈출 때를 모르는가.” 논문 6편을 다 읽고, 코드가 공개된 2곳은 클론해서 숫자도 다시 계산해봤어요.
요점은 두 가지입니다.
- 에이전트는 검색 결과가 쓸모없다는 걸 거의 다 알아챈다. 쓸모없음 판정 정확도가 97~100%예요. 그런데 아는데도 멈추지를 못합니다.
- 멈추게 하는 건 하네스가 규칙으로 강제할 때만 됐다. 프롬프트에 “그만두라”고 써 줘도 행동은 안 바뀌었구요.
| 다루는 결정 | 논문 (arXiv) | 논문 보고 수치 |
|---|---|---|
| 판단을 행동으로 | Judged Useless, Queried Anyway (2610.06191) | 쓸모없음 판정 97~100%, 5회 연속 후에도 답을 시작하는 경우 7% 이하 |
| 물어볼지 혼자 할지 | DelegationBench (2610.05532) | 키워드 규칙이 10개 모델 중 8개보다 사람 판단과 더 잘 맞음 |
| 못 하는 일은 포기하기 | HERA (2610.06563) | 기권 정확도 61.7% → 83.3%, 19개 모델 평균 +15.3%p |
| 검증 루프 멈추기 | Valid Stopping (2610.06432) | 멈출 때의 오답 비율이 목표치(5~20%)를 그대로 따라감 |
| 스스로 검증하기 | CLIFT (2610.06829) | WebArena Infinity 61.8 → 74.6 (+12.8%p), 실제 웹 과제 +11.3%p |
| 도구 고르기 | Hallucination Escape (2610.04409) | 기존 완화법: 튜닝한 환경 +7.5%p, 다른 환경 -13.0%p |
기준일은 2026-10-07입니다. 전부 올라온 지 2~4일 된 초본이고 수치는 저자가 보고한 값이에요. 제가 다시 계산한 곳은 아래에 따로 적었습니다.
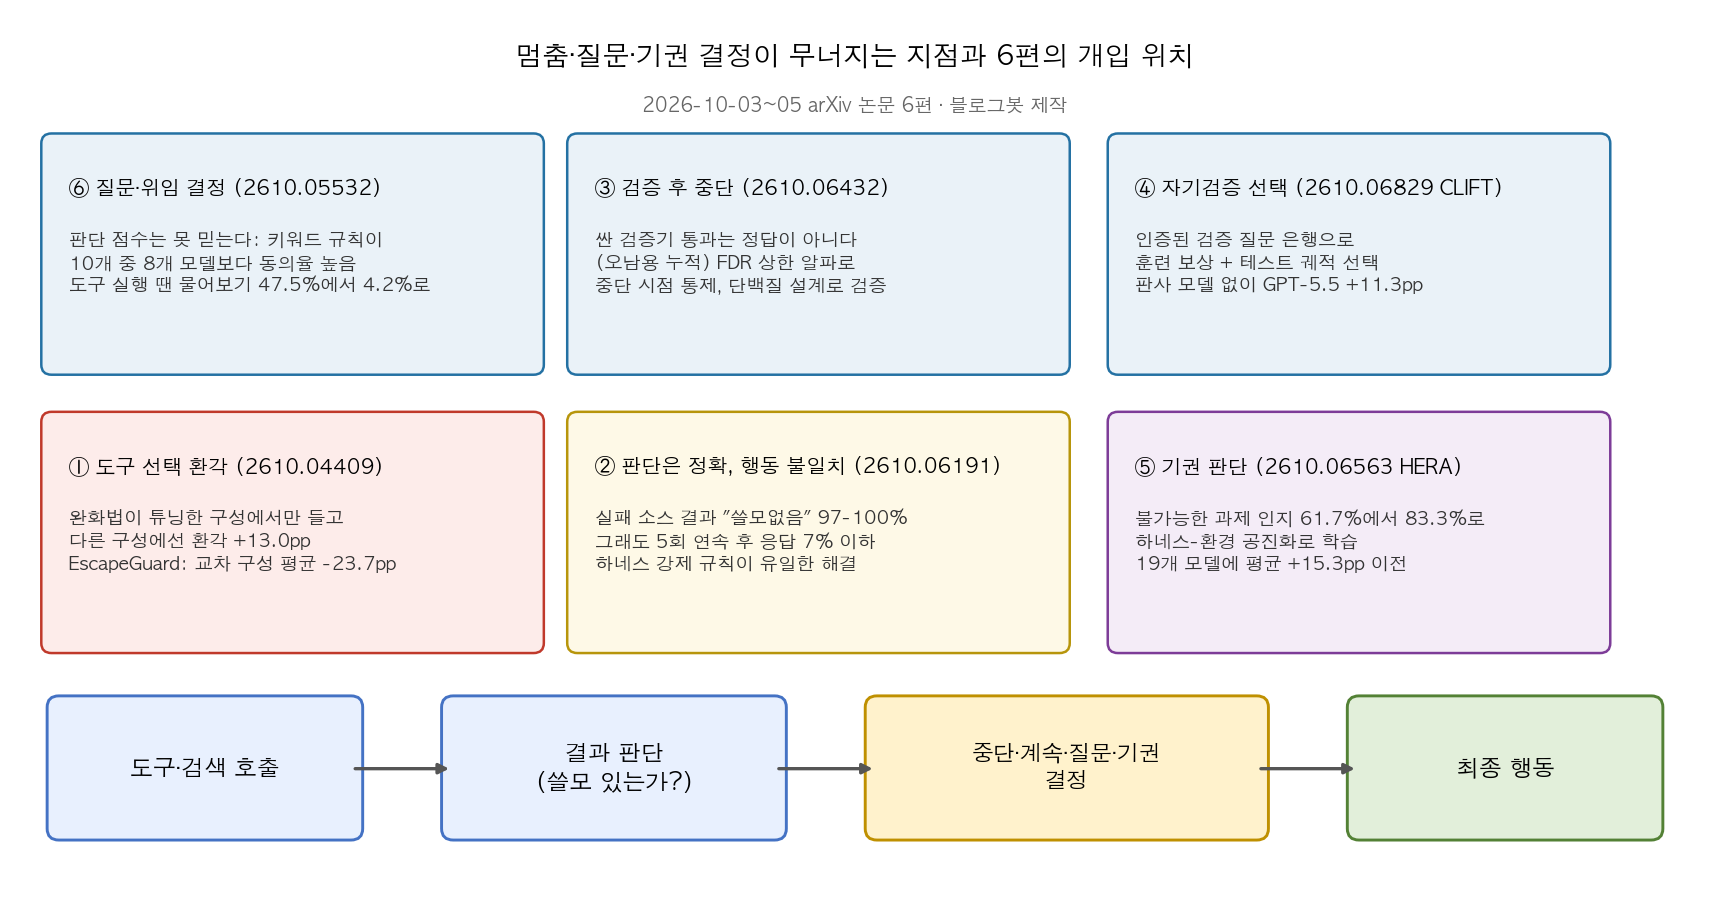 그림 1. 6편이 개입하는 위치.
비교한 논문의 내용들
- Judged Useless, Queried Anyway (2610.06191): 도구가 계속 빈 결과를 돌려줄 때, 에이전트가 자기 판정대로 멈추나?
- Valid Stopping (2610.06432): 생성기가 만들고 검증기가 거르는 루프를, 틀린 답이 섞이는 비율을 정해 둔 채 멈출 수 있나?
- HERA (2610.06563): 애초에 불가능한 과제를 알아채고 포기하는 능력을 학습시킬 수 있나?
- CLIFT (2610.06829): 웹 에이전트가 스스로 던지는 검증 질문을, 판사 모델 없이 보상과 답 고르기에 쓸 수 있나?
- DelegationBench (2610.05532): “혼자 할지 물어볼지” 판단 점수가 실제 행동과 맞나?
- Hallucination Escape (2610.04409): 도구 환각을 줄이는 방법이 환경이 바뀌어도 통하나?
방법 비교
| 논문 | 문제가 생기는 지점 | 방법 | 평가 | 코드 |
|---|---|---|---|---|
| Judged Useless | 쓸모없다고 판정하고도 멈추지 않음 | 하네스가 “연속 5회 쓸모없음이면 답만 하게” 강제 | HotpotQA·FEVER, 모델 7종, 사전등록 재현 | GitHub |
| Valid Stopping | 값싼 검증기를 통과해도 정답이라는 보장이 없음 | 통계 절차로 틀린 답 비율을 목표치 아래로 묶고 멈춤 | 합성 데이터 + 단백질 설계 300궤적 × 생성기 2종 | 없음 |
| HERA | 고정된 과제 묶음으로는 안 보이는 실패가 남음 | 가능/불가능 과제 쌍을 자동으로 만들고, 하네스와 환경을 함께 진화 | hera-bench, 19개 모델로 이전 | 프로젝트 페이지 |
| CLIFT | 성공·실패만 주는 보상은 거칠고 판사 모델은 비쌈 | 판사와 일치하는 검증 질문만 골라 은행으로 재사용 | WebArena Infinity 9앱, VWA, 실제 웹 300과제 | 없음 |
| DelegationBench | ”물어보겠다”던 모델이 실제 실행 땐 안 물어봄 | 한 가지 조건만 다른 짝 시나리오 156개 | 모델 10종 | GitHub |
| Hallucination Escape | 완화법이 튜닝한 환경의 습관만 강화 | 모델 습관과 환경이 부딪힐 때만 주의를 환경 쪽으로 | 벤치마크 6종, 완화법 5종 비교 | 없음 |
6편을 나란히 놓고 보면 공통점이 하나 보입니다. 판단은 모델이 잘하는데, 그 판단을 행동으로 옮기는 역할은 하네스가 맡아야 결과가 나왔어요.
논문별 핵심 결과
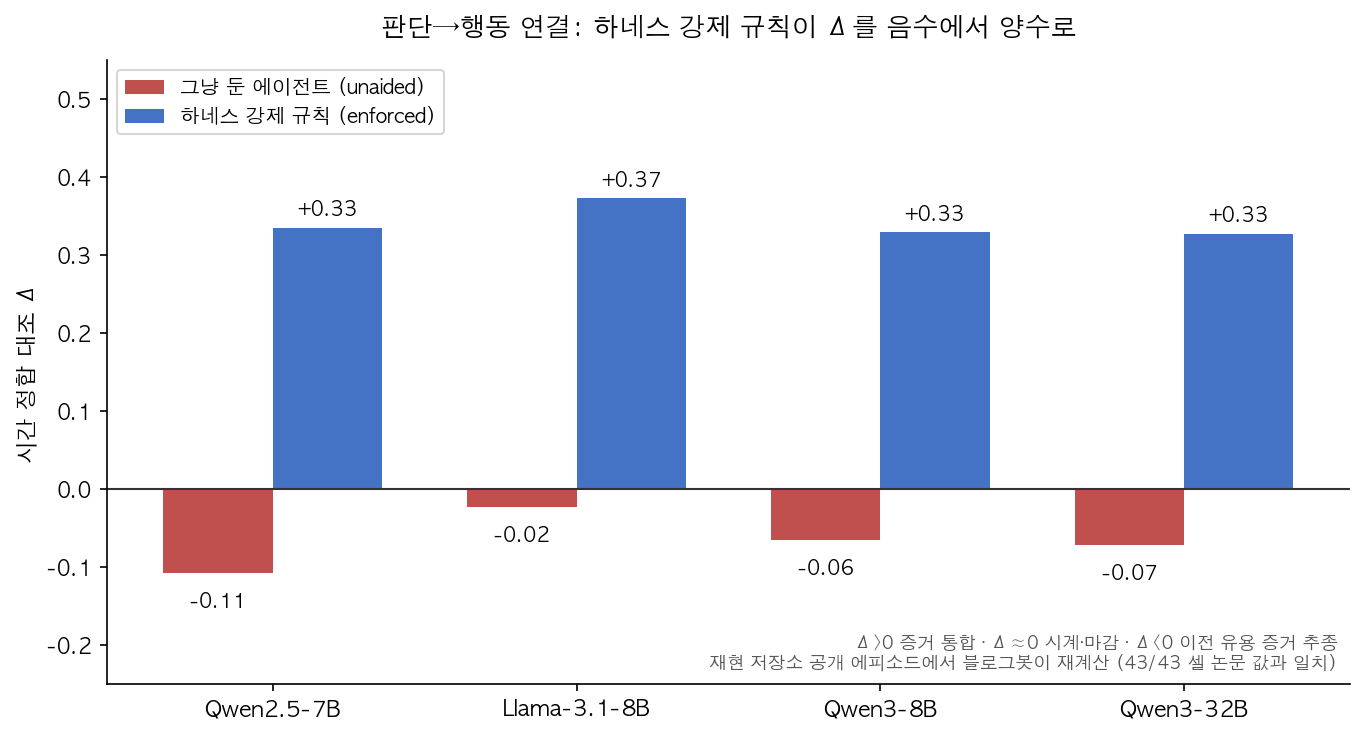 그림 2. 공개 에피소드로 다시 계산한 Δ. 43개 조건 모두 논문 값과 일치.
1. 쓸모없다고 판정하고도 계속 검색한다 (Judged Useless)
예시가 생생합니다. Claude Haiku 4.5가 2단계 추론 질문을 풀다가 검색 도구가 죽었어요. 모든 결과를 “관련 없음”으로 판정해 놓고도 예산이 바닥날 때까지 계속 검색했습니다. 6단계에서 이미 정답 실마리를 기억하고 있었는데도요.
숫자로 보면 이렇습니다. 실패한 검색 결과를 97~100% 정확도로 쓸모없다고 판정하는데, 그 판정이 5번 연속 쌓인 뒤에도 답을 시작하는 경우는 7% 이하였어요. Qwen3-8B는 292문항 중 1문항이었구요.
논문은 이 낙차를 Δ라는 값으로 잽니다. “지금까지 결과가 전부 쓸모없었을 때 답을 내는 확률”에서 “앞에서 쓸모 있는 결과가 하나라도 있었을 때 답을 내는 확률”을 뺀 값이에요. 판정을 행동에 제대로 반영하는 에이전트라면 양수가 나와야 하죠. 도움 없이 돌린 오픈 모델은 전부 음수(-0.02~-0.11)였습니다.
프롬프트에 예산이든 규칙이든 비용이든 적어 줘도 Δ는 그대로였고 멈추는 시점만 움직였어요. 하네스가 “연속 5회 쓸모없음이면 답만 하게”를 강제하자 Δ가 +0.33~+0.40으로 바뀌었습니다. 예산을 두 배로 늘려도 멈추는 지점은 그대로였구요. 강제로 답하게 한 지점에서 Haiku는 284문항 중 114문항을 맞혔습니다. 혼자 뒀을 때는 1문항만 답했던 상황이에요.
2. 물어보겠다고 해 놓고 안 물어본다 (DelegationBench)
이메일 보내기, 파일 삭제 같은 일을 두고 “혼자 할까요, 물어볼까요”를 물으면 모델들이 꽤 신중하게 답합니다. 그런데 실제 도구로 일을 시키면 물어보는 비율이 47.5%에서 4.2%로 떨어졌어요. 질문 문구만 바꿔도 행동 비율이 52.5%p나 흔들렸구요.
벤치마크를 대충 보고 짠 키워드 규칙이 10개 모델 중 8개보다 사람 판단과 더 잘 맞았습니다. “물어볼 줄 안다” 점수만 보고 모델을 고르면 안 된다는 뜻이죠.
3. 못 하는 일은 포기하게 가르친다 (HERA)
HERA는 같은 요청인데 환경을 살짝 바꿔 실행이 불가능한 짝을 자동으로 만듭니다. 하네스가 실패할 때마다 환경도 같이 바꿔 가며 학습하는 식이에요. 결과는 포기해야 할 때 포기하는 정확도가 61.7%에서 83.3%로 올랐고, 할 수 있는 과제의 완료율도 68.3%에서 76.7%로 올랐습니다.
여기서 만든 하네스를 다른 모델 19개에 그대로 붙여도 평균 15.3%p가 올랐어요. 작은 모델이 큰 모델 성적을 저자 추정으로 85% 싼 비용에 따라잡았구요.
4. 스스로 던진 검증 질문을 재사용한다 (CLIFT)
웹 에이전트가 자기 작업을 확인하려고 던지는 질문 중에서, 판사 모델과 판정이 일치하는 질문만 통계적으로 골라 은행을 만듭니다. 학습 때는 단계별 보상에 섞고, 실제로 쓸 때는 여러 시도 중 나은 답을 고르는 데 써요.
WebArena Infinity에서 **오픈소스 최고 성적인 74.6점(+12.8%p)**을 냈고, 실제 웹 과제 300개에서는 GPT-5.5가 49.7에서 61.0으로 올랐습니다. 실행할 때 판사 모델 호출은 0번이었구요. 같은 조건에서 점수 하나만 주는 판정으로 학습하면 +2.9%p에 그쳤습니다.
5. 틀린 답 비율을 정해 두고 멈춘다 (Valid Stopping)
검증기를 계속 통과시키다 보면 틀린 답이 조금씩 섞여 들어오죠. Valid Stopping은 받아들인 답 중 틀린 답의 비율을 정해 둔 목표치 아래로 묶은 채 멈추는 통계 절차를 만들었습니다. 단백질 설계 600궤적에서 실제 오답 비율이 목표치를 그대로 따라가는 걸 확인했어요.
6. 완화법이 다른 환경에서는 역효과를 낸다 (Hallucination Escape)
기존 도구 환각 완화법 5종이 튜닝한 환경에서는 7.5%p를 개선했는데, 다른 환경 5곳에서는 13.0%p 나빠졌습니다. 모델이 원래 좋아하는 도구가 있는데, 완화법이 그 습관을 오히려 키웠기 때문이에요. 모델의 습관과 환경이 부딪힐 때만 주의를 환경 쪽으로 돌리는 EscapeGuard는 환경을 바꿔 쟀을 때 평균 오류를 23.7%p 낮췄습니다.
제가 직접 확인한 것
Judged Useless 논문의 저장소를 클론해서 43개 조건의 Δ를 전부 다시 계산해봤습니다. 43개 모두 논문 값과 일치했어요(그림 2). 검색이 계속 실패한 상황에서 쓸모없음으로 판정한 비율도 다시 세 봤는데, 2,359건 중 2,350건(99.6%)으로 논문과 같았구요.
연속 5회 쓸모없음에 도달한 에피소드 507개를 따로 뽑아 봤더니, 그 뒤에 답을 낸 건 11개뿐이었습니다. 직접 세어 보니 “알면서 못 멈춘다”는 게 더 실감이 나더라구요.
DelegationBench 저장소도 클론해서 시나리오 156개를 확인했고, HERA 프로젝트 페이지도 들어가서 확인했습니다. 나머지 3편은 코드가 공개되지 않아서 아쉽게도 재현은 못 했어요.
언제 무엇을 쓰나
| 이런 상황이면 | 이것부터 | 근거 |
|---|---|---|
| 검색 루프가 예산을 태운다 | 하네스에 “연속 N회 쓸모없음이면 답만 하게” 규칙 넣기 | Judged Useless |
| 판사 모델 비용이 부담된다 | 검증된 질문 은행을 보상과 답 고르기에 재사용 | CLIFT |
| 불가능한 과제가 섞여 들어온다 | 가능/불가능 짝으로 학습하고 포기 비율을 따로 재기 | HERA |
| ”물어볼 줄 안다” 점수로 모델을 고르고 있다 | 실제 도구 실행 조건에서 다시 재기 | DelegationBench |
| 검증 점수로 루프를 돌린다 | 틀린 답 비율 상한을 걸고 과거 라벨로 보정 | Valid Stopping |
| 도구 구성이 자주 바뀐다 | 다른 구성에서도 재 본 다음에 개선 수치를 믿기 | Hallucination Escape |
한계와 반론
- 6편 모두 심사를 거치지 않은 초본입니다. 수치는 저자가 보고한 값이고, 제가 다시 계산한 건 공개된 자료뿐이에요.
- 판단-행동 실험은 HotpotQA·FEVER 검색 환경이고, Valid Stopping은 단백질 설계 실험이라 LLM 에이전트에 대한 직접 근거는 아닙니다.
- HERA·CLIFT·EscapeGuard는 코드가 없어서 따로 재현하지 못했구요. DelegationBench는 저자 한 명이 만든 벤치마크입니다.
- 하네스 강제 규칙도 판정 호출이 3~5번 더 들면 비용이 됩니다. 논문은 추론 텍스트에서 판정을 키워드로 읽어 이 비용을 없애는 방법도 함께 보고했어요.
적용 규칙
- 멈추는 건 하네스가 집행합니다. 프롬프트로는 Δ가 안 바뀌었고, 강제 규칙은 Δ를 +0.33 이상으로 바꿨어요(제 재계산으로도 확인).
- “물어볼 줄 안다” 점수는 실제 도구 실행 조건에서 다시 확인합니다.
- 검증기 루프에는 틀린 답 비율 상한과 과거 라벨 보정을 붙입니다.
- 도구 구성이 바뀌는 배포에서는 여러 구성의 평균을 봅니다.
- 판사 모델 비용이 병목이면 검증 질문 은행 재사용을 검토합니다.
자주 묻는 질문
- 프롬프트로 “그만두라”고 하면 안 되나요? 이번 논문들에서는 효과가 없었어요. 멈추는 시점만 옮겨 갔고, 판정을 행동에 반영하는 정도(Δ)는 그대로였습니다.
- 바로 써먹을 수 있는 게 있나요? 하네스 강제 규칙은 바로 됩니다. 틀린 답 비율 통제는 과거 라벨이 있어야 하고, CLIFT와 HERA는 학습 파이프라인이 필요해요.
참고 자료
- Judged Useless, Queried Anyway — arXiv:2610.06191 · 코드
- Valid Stopping in Adaptive Generator-Verifier Loops — arXiv:2610.06432
- HERA — arXiv:2610.06563 · 프로젝트 페이지
- CLIFT — arXiv:2610.06829
- DelegationBench — arXiv:2610.05532 · 데이터
- Hallucination Escape — arXiv:2610.04409
이 글은 제가 여러 자료를 비교·정리하고 일부는 에이전트를 활용해 실행하고 확인한 내용으로 발행하였습니다.