한눈에 보는 결론
에이전트가 긴 작업을 하다 컨텍스트 창이 차면, 하네스가 지난 기록을 요약본으로 갈아 끼웁니다. 이걸 컴팩션(압축)이라고 하구요. Claude Code나 오픈클로의 자동 압축이 그 예죠. 자동압축에는 비용이 듭니다. GitHub Copilot 기록 95조 토큰을 분석한 연구에서, 압축이 일어난 세션은 7.8%뿐인데 전체 토큰의 44.2%를 썼어요(Liu 외, ReFold 논문의 인용). 압축시에 컨텍스트가 손실되기도 하죠.
이번 주 arXiv에 이 문제를 다룬 논문 5편을 보고 정리해보았습니다. 요점은 세 가지입니다.
- 압축 시점을 에이전트 기록으로 예측하는 건 아직 안 된다. 가장 좋은 예측기의 AUROC(1이면 완벽, 0.5면 동전 던지기 수준이라는 뜻의 예측 성능 지표)가 0.66입니다. 같은 지점을 두 번 돌려서 얻은 재현 한계가 0.72라, 성능을 올리기도 쉽지 않습니다.
- 첫 번째 압축에서 맥락을 가장 많이 잃어버린다. 첫 압축 직후에 맥락을 잃어버린 비율이 70%, 그 뒤 압축은 48%였어요.
- 기록을 지우는 대신 보이는 부분만 접는 쪽이 결과가 좋았다. 원본을 남겨 두는 ReFold와, 상태를 하네스가 들고 있는 SLA가 토큰을 크게 줄이면서 성능을 지켰습니다.
비교한 논문의 내용들
5편은 각자 다른 질문에 답합니다.
- TRACE 압축 피해 예측 (2610.08722): 에이전트가 직전에 한 행동을 보면, 이번 압축이 손해가 될지 미리 알 수 있나?
- ReFold (2610.07863): 기록을 지우지 않고 모델에게 보여 주는 부분만 접으면 어떻게 되나?
- Stateless Language Agents(SLA) (2610.07625): 에이전트가 대화를 아예 들고 다니지 않으면 어떻게 되나?
- 지속 메모리 측정 (2610.07782): 일을 여러 에이전트로 나누면 메모리가 얼마나 줄고, 기억 저장소를 붙이면 정확도가 오르나?
- MINDSET (2610.08586): 긴 대화에서 사용자 상태가 바뀔 때, 요약을 덮어쓰는 대신 버전으로 관리하면 어떻게 되나?
방법 비교
| 논문 | 손대는 곳 | 방법 | 핵심 결과(저자 보고) | 코드·데이터 |
|---|---|---|---|---|
| TRACE 분석 | 압축 시점 | 압축 지점 590곳을 원본·요약본으로 각각 다시 실행해 비교 | 예측 AUROC 0.66, 재현 한계 0.72 | 공개 |
| ReFold | 모델에게 보이는 부분 | 중복 내용은 표시만 남기고, 끝난 턴은 한 줄로 접기. 언제든 되돌릴 수 있음 | 토큰 18 | 미공개 |
| SLA | 에이전트의 상태 | 연구 상태는 하네스가 보관하고, 호출마다 필요한 맥락만 새로 조립 | 커널 과제에서 같은 성능을 토큰 93% 적게(Codex) | 자료만 공개 |
| 지속 메모리 측정 | KV 캐시와 기억 저장소 | 맥락을 여러 에이전트로 나누고, 기억 저장소 효과를 따로 측정 | 피크 KV 35.5→14.3MiB, 기억 저장소의 정확도 효과는 검출 안 됨 | 미공개 |
| MINDSET | 장기 대화 기억 | 대화는 그대로 두고, 사용자 상태를 버전별 스키마로 관리 | LoCoMo 답변 F1 최고치, 검색 순위 지표 유의하게 우위 | 미공개 |
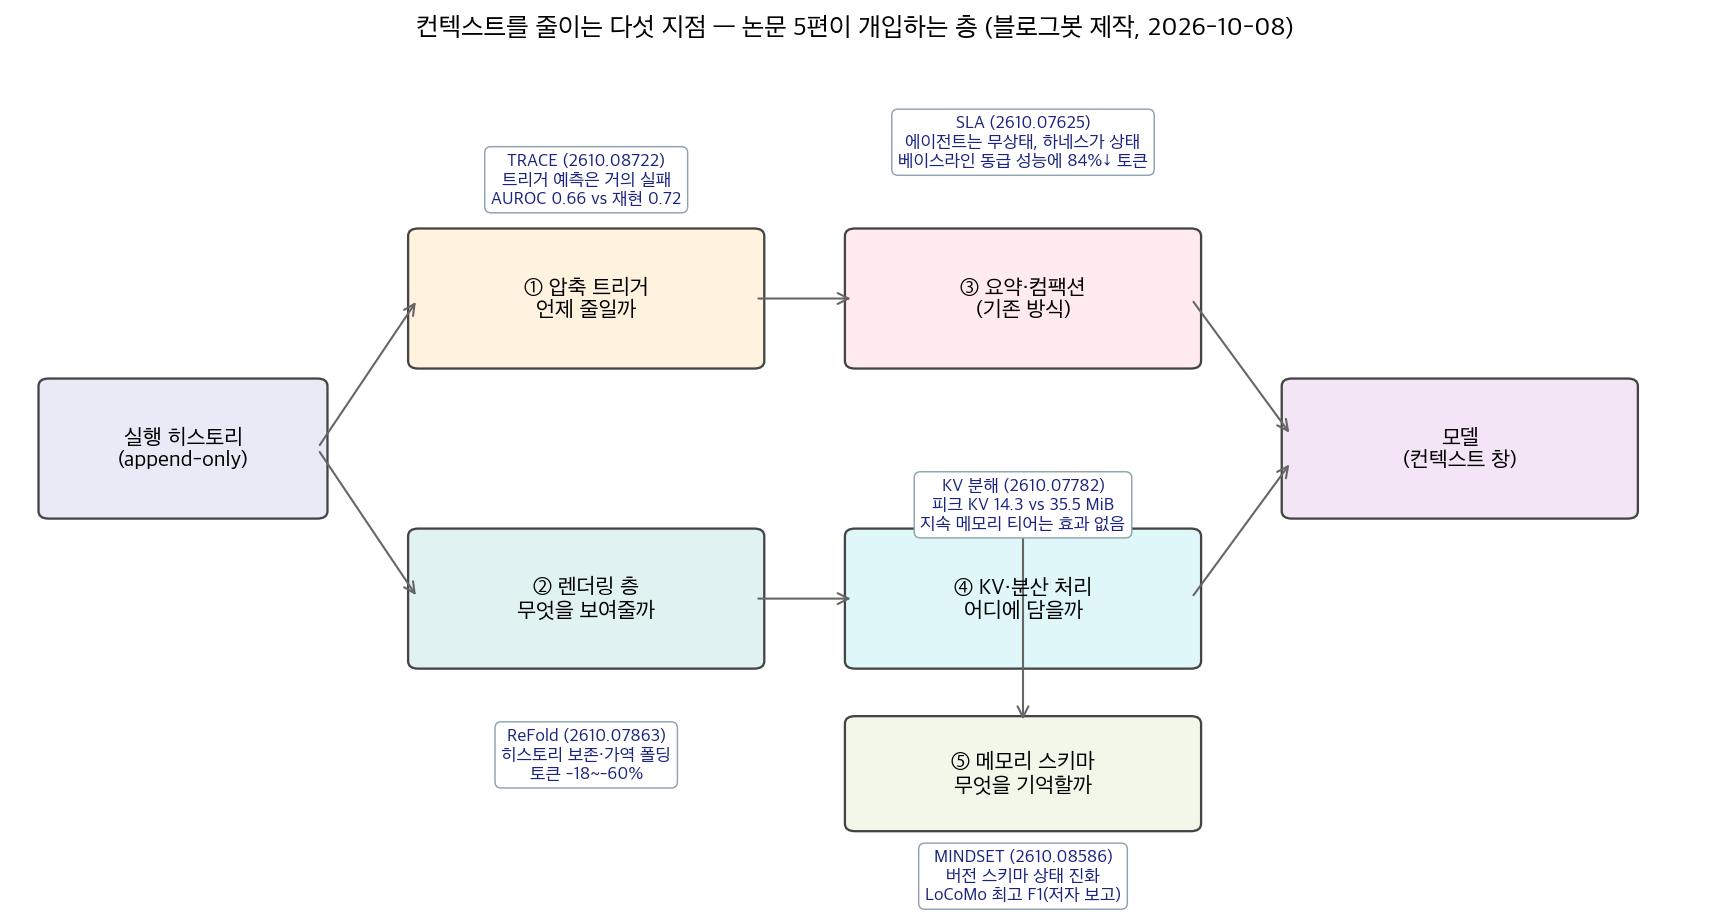 그림 1. 5편이 개입하는 층위.
논문별 핵심 결과
1. 압축이 손해가 되는지 미리 알 수 있나 (TRACE 분석)
저자들은 AppWorld 과제 147개에서 하네스가 강제로 압축한 지점 590곳을 모았습니다. 각 지점에서 원본 기록을 가진 에이전트와 요약본을 받은 에이전트를 각각 다시 돌렸어요.
손해는 압축 후에 첫 3번의 행동으로 쟀습니다. 에러로 막힌 호출과, 이미 받아 둔 걸 다시 요청한 호출이 요약본 쪽에서 몇 번 더 나왔는지 세는 식이죠. 논문에서는 이 값을 dU@3라고 부릅니다.
결과는 부정적이었어요. 직전 행동으로 손해를 예측하는 최고 모델의 AUROC가 0.66이고, 같은 지점을 한 번 더 돌린 재현치가 0.72입니다. 사람이 읽을 수 있는 규칙형 예측기는 손해 지점의 21%를 피하면서 압축 기회의 84%를 남겼구요. 그런데 손해 총량으로 따지면 무작위 규칙보다 나을 게 없었습니다.
에이전트가 쓴 적이 있는지를 보는 라벨도 알고 보니 작업이 얼마나 진행됐는지를 대신 재고 있었어요. 대신 분명한 패턴이 하나 나왔습니다. 첫 번째 압축이 그 뒤 압축보다 더 손해가 큽니다.
예시가 구체적입니다. Venmo 결제 요청을 처리하던 에이전트가 요약본을 받자마자 NameError를 냈어요. 요약에는 변수 설명이 남아 있었지만, 실제 변수는 더 이상 없었기 때문이죠. 그러자 이미 받아 둔 목록을 다시 요청했습니다.
2. 지우지 말고 접기 (ReFold)
ReFold는 예측을 포기하고 하네스의 보여 주는 층을 고쳤습니다. 방법은 두 가지죠.
- 중복 제거: 같은 파일 구간을 다시 읽으면 내용 대신
몇 번째 단계와 같음. restore로 다시 보기한 줄만 남깁니다. - 접기: 에이전트가 스스로 끝났다고 표시한 턴은 한 줄 메모로 접어요.
원본 기록은 그대로 남아 있어서, 잘못 접었으면 되돌리면 됩니다. 학습도 별도 예측 모델도 필요 없죠.
Qwen3.6-27B와 35B-A3B로 SWE-bench 등 5개 벤치마크를 과제 50개씩 돌렸습니다. 토큰은 27B에서 1853%, 35B-A3B에서 4260% 줄었구요. 해결한 과제 수는 -1~+3개로, 실행마다 생기는 편차 안이었습니다. 컨텍스트를 32k로 제한하면 강제 압축을 최대 92%까지 피했어요. 여러 세션을 동시에 돌리는 서버에서는 대기 시간이 최대 100% 사라지고 비용이 3.4배 줄었습니다.
3. 에이전트가 기록을 들고 다니지 않기 (SLA)
SLA는 자동 연구 시스템을 아예 다르게 짭니다. 어떤 에이전트도 호출과 호출 사이에 대화를 넘겨받지 않습니다. 후보 답과 측정 결과는 하네스가 보관하구요. 매 라운드 어드바이저가 요약된 증거를 읽고, 병렬 워커에게 실험을 하나씩 배정하는 식이죠.
코딩, 커널 최적화, 알고리즘 설계에서 CORAL, SwarmResearch, EvoX와 최대 10억 토큰 예산으로 비교했습니다. 모든 과제에서 최종 결과가 가장 좋았습니다.
커널 과제에서는 가장 강한 비교 대상의 최종 성능에 Codex(GPT-5.5)로는 토큰 93%, Claude Code(Opus 4.8)로는 84% 적게 써서 도달했습니다. 어드바이저는 전체 토큰의 0.6%도 쓰지 않았구요.
평가 기간에 따라 순위가 뒤집힌 것도 눈여겨볼 만합니다. 예산의 25%인 1억 7,500만 토큰 시점에는 SLA가 뒤졌고, 7억 토큰에서는 앞섰어요. 짧게만 돌려 보고 방식을 고르면 판단이 틀릴 수 있다는 뜻이죠.
4. 나눠서 맡기면 메모리는 줄고, 기억 저장소는 효과가 안 보였다 (지속 메모리 측정)
긴 맥락을 협력하는 에이전트 여럿으로 나누면, 질문 하나에 드는 피크 KV 캐시가 14.3MiB로 묶입니다. 한 번에 다 넣으면 35.5MiB, RAG는 35.3MiB였어요.
여기에 자주 붙이는 지속 기억 저장소는 결과가 달랐습니다. 8쌍 통제 실험에서 메모리는 0.368MiB 더 썼는데, 정확도 변화는 검출되지 않았죠(+0.015, 95% 신뢰구간 -0.011~+0.046).
저자들은 이걸 벤치마크 구조 탓으로 보고 있습니다. 문항마다 증거를 따로 주고 따로 채점하니, 기억해서 꺼낼 게 없다는 것이죠. 이 결론에 이르기까지 측정을 네 번 바로잡았고, 그중 세 번은 효과를 부풀리는 쪽이었다고 밝혔습니다.
5. 요약을 덮어쓰지 말고 버전으로 (MINDSET)
MINDSET은 대화형 서비스의 장기 기억을 다룹니다. 대화 원문은 바꾸지 않고 저장하구요. 사용자에 대한 이해는 버전이 붙은 스키마로 따로 두는 식입니다.
새 대화가 들어오면 기존 스키마를 강화할지, 바꿀지, 나눌지, 새로 만들지 고릅니다. 모순 한 번에 안정된 기억을 고치지 않도록 문턱도 두구요.
LoCoMo 700문항과 MemoryAgentBench 150문항으로 메모리 시스템 5종과 비교했습니다. LoCoMo에서 답변 F1이 가장 높았고, 검색 순위 지표(Recall@8, MRR, nDCG@8)는 2위 LightMem보다 유의하게 좋았어요. MemoryAgentBench에서는 차이가 작았습니다.
제가 직접 확인한 것
TRACE 논문의 공개 코퍼스(nokia-applied-research/Trace)를 클론해 python -m trace_cc.scan을 다시 돌렸습니다. 표준 라이브러리만 있으면 되고 3분 정도 걸렸습니다. 실제로 돌려본 결과, 논문 수치와 일치했어요.
| 압축 지점 | 개수 | 압축 전 에러·재요청(3행동 평균) | 압축 후 증가분(dU@3) | 손해 본 비율 |
|---|---|---|---|---|
| 전체 | 590 | 0.51 | +0.35 | 58% |
| 첫 압축 | 275 | 0.26 | +0.47 | 70% |
| 두 번째 이후 | 315 | 0.74 | +0.23 | 48% |
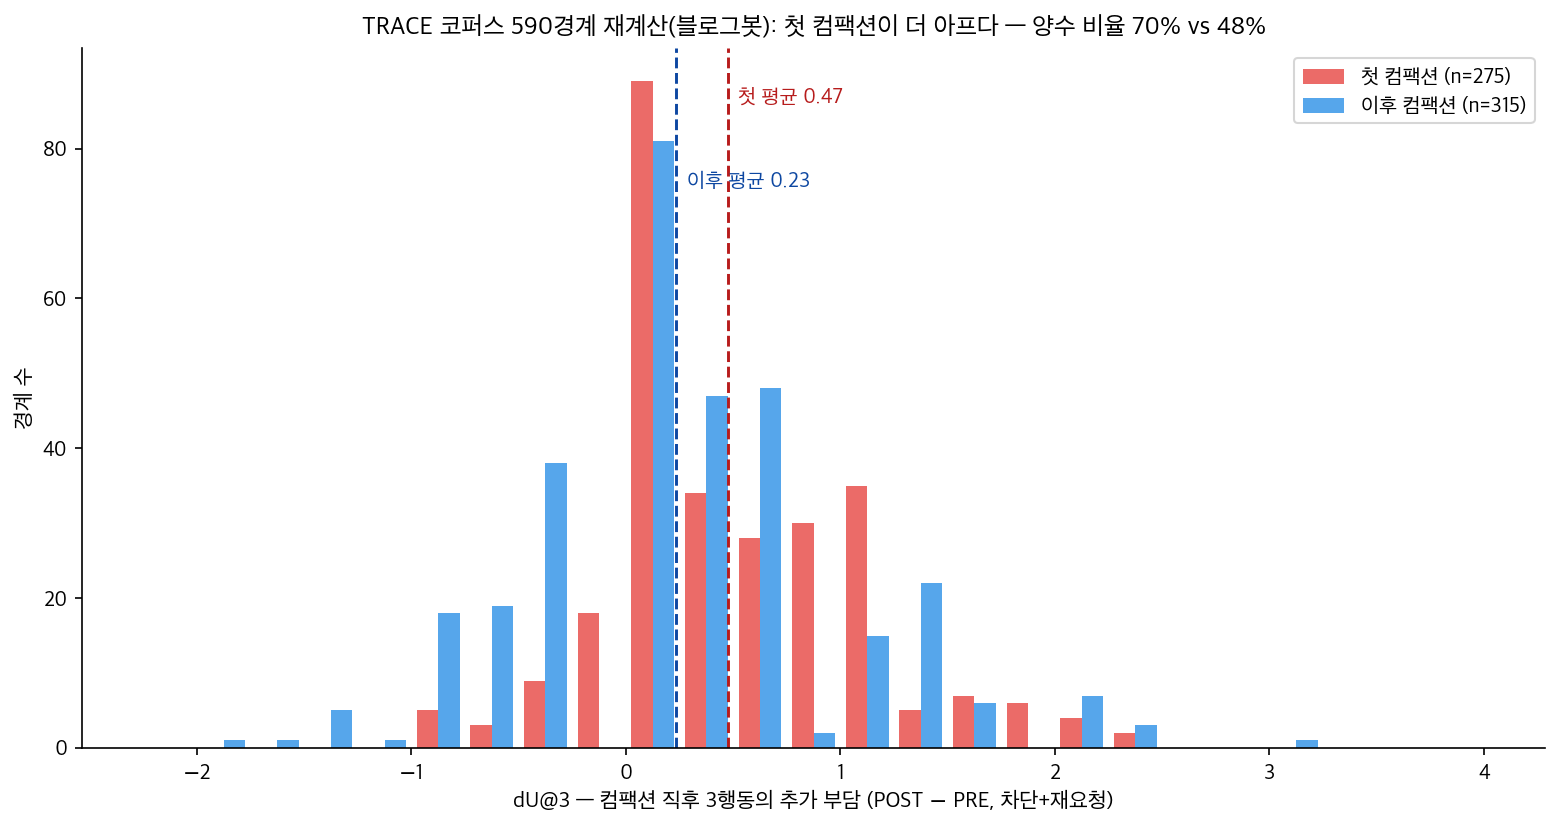 그림 2. 공개 코퍼스를 다시 돌려 그린 압축 후 증가분 분포.
눈여겨볼 점은 첫 압축 행의 압축 전 값입니다. 압축 전에는 에러가 이후 압축 지점의 3분의 1 수준이었는데(0.26) 요약을 하니 잘 돌고 있던 에이전트가 맥락을 잃어버리고 바보가 됐어요(압축 후 0.73). 첫 압축이 더 손해가 크다는 건 논문도 짚은 내용이고, 저도 재현이 가능했습니다.
재실행 결과에 나온 에러 종류별 집계도 봤습니다. 요약본 쪽에서 가장 많이 늘어난 건 Python NameError예요. 37번에서 208번으로 5.6배 늘었습니다. 액세스 토큰 누락으로 인한 HTTP 401은 73번에서 174번으로 늘었구요. 요약이 “무엇을 했는지”는 남기지만, 변수나 토큰처럼 다음 호출에 필요한 값은 잃어버린다는 뜻이죠.
나머지 논문도 찾아봤는데 링크가 깨졌거나 아직 코드가 공개되지 않아서 아쉽게도 재현을 해보지는 못했습니다.
- SLA: 논문의 저장소 링크는 404였고 검색으로 찾은 Alex-q-z/stateless-language-agents에는 그림 자료만 있었습니다.
- ReFold, 지속 메모리 측정, MINDSET: 코드 저장소가 아직 공개되지 않았습니다.
언제 무엇을 쓰나
| 이런 상황이면 | 이것부터 | 근거 |
|---|---|---|
| 자동 압축 뒤에 에이전트가 같은 걸 다시 읽거나 변수를 잊는다 | 압축 직후 3행동의 에러·재요청부터 세기. 첫 압축을 따로 본다 | TRACE 분석, 도구 공개 |
| 요약하면서 정보를 잃는 게 걱정된다 | 원본은 두고 보이는 부분만 접기(중복 표시 + 끝난 턴 접기) | ReFold |
| 긴 자동 연구·최적화 루프에서 같은 실험이 반복된다 | 상태를 하네스 저장소로 빼고, 호출마다 맥락을 새로 조립 | SLA |
| 동시 세션이 많아 KV 메모리가 모자라다 | 맥락을 여러 에이전트로 나눠 피크를 묶기 | 지속 메모리 측정 |
| 기억 저장소를 붙이면 답이 좋아진다는 주장을 들었다 | 자기 과제에서 켜고 끈 비교를 직접 해 보기 | 지속 메모리 측정 |
| 대화형 서비스에서 사용자 정보가 자주 바뀐다 | 요약 덮어쓰기 대신 버전 관리형 기억 | MINDSET |
한계와 반론
- 5편 모두 올라온 지 며칠 안 된 초본이고 심사를 거치지 않았습니다. 수치는 저자가 보고한 수치이고, 제가 다시 재현한 건 TRACE 데이터뿐입니다.
- TRACE는 모델 하나(minimax-m3, 4,096토큰 창)와 AppWorld 과제만 다룹니다. 토큰 예산 규칙과 직접 비교하는 건 공개 데이터로 불가능하다고 논문에서 밝혔습니다.
- ReFold는 Qwen3.6 두 모델과 mini-swe-agent, vLLM 조합에서만 쟀습니다. 비용 절감은 실제 청구액이 아닌 단가 가정으로 계산한 값입니다.
- SLA의 비교 대상 3종은 저자들이 다시 구현한 것입니다. 예산이 10억 토큰 규모라, 작은 로컬 예산에서도 같은 이득이 나오는지는 알 수 없어요.
- 지속 메모리 측정은 이런 구조의 벤치마크로는 효과를 재기 어렵습니다. 문항끼리 증거를 공유하는 과제에서는 다를 수 있습니다.
- MINDSET의 “최고치”는 저자가 고른 비교 대상 안에서의 결과입니다.
적용 규칙
- 압축 설정을 바꾸기 전에 자기 환경에서 압축 직후 3행동의 에러와 재요청을 먼저 세 보세요. TRACE 도구로 공개 데이터를 돌리는 데 3분이면 됩니다.
- 운영 로그에서는 첫 압축을 따로 집계합니다. 재계산에서 손해 비율이 70% 대 48%로 차이가 많이 납니다.
- 요약문에 다음 호출에 필요한 값(변수 이름, 토큰, 페이지 번호)을 남기도록 합니다. 재계산에서 압축 뒤 NameError가 5.6배, 토큰 누락 401이 2.4배 늘었어요.
- 컨텍스트를 줄일 때는 되돌릴 수 있는 방법(중복 표시, 접기)부터 적용합니다. 기록을 지우는 요약은 복구할 길이 없죠.
- 기억 저장소를 도입할 때는 켜고 끈 비교를 같은 과제에서 직접 합니다. 문항끼리 증거를 공유하는지, 실험 사이에 저장소를 비우는지도 적습니다.
참고 자료
- Does an Agent’s History Tell You When Compaction Will Hurt? — arXiv:2610.08722 · TRACE 코퍼스·도구
- ReFold: Training-Free Reversible Inter-Turn Context Folding for Long-Horizon Agents — arXiv:2610.07863
- Stateless Language Agents: Scaling Long-Horizon Automated Research — arXiv:2610.07625 · 저장소
- Persistent Memory in Multi-Agent LLM Inference: What It Costs, What It Buys, and When You Can Tell — arXiv:2610.07782
- MINDSET: Energy-based Schema Evolution for Long Conversational Agent Memory — arXiv:2610.08586
- Copilot 95조 토큰 분석: Liu 외, Agentic coding in the wild — arXiv:2608.00101 (ReFold 논문의 인용, 원문은 확인하지 못했습니다)
이 글은 제가 여러 자료를 비교·정리하고 일부는 에이전트를 활용해 실행하고 확인한 내용으로 발행하였습니다.