한눈에 보는 결론
2026년 1월부터 8월 사이에 나온 AI 에이전트 자료 7건을 한 자리에 놓고 비교했습니다. 블로그 옛 글 8편을 하나로 합치는 리팩토링 작업이라 원문을 전부 다시 읽었습니다. 기준일은 2026-09-30입니다. 핵심은 이겁니다.
모델 성능만 보고 도구를 고르던 시기는 지났고, 모델 밖의 구조가 결과를 가른다는 메시지가 7건 전체에서 반복됩니다.
구조를 네 층으로 나눠 정리했습니다.
| 구조 층 | 하는 일 | 이번 자료 |
|---|---|---|
| 문서·인터페이스 | 에이전트가 문서를 읽게 만들기 | AEO(llms.txt, skill.md, AGENTS.md) |
| 루프·검증 | 반복마다 확인하고 정지 조건 걸기 | Loop Library, ResearchStudio-Reel |
| 커넥터·도메인 | 도메인 지식과 기준을 연결 | Claude for Teachers, Opus 4.7 해커톤 |
| 시스템·하드웨어 | 컨텍스트·평가자·칩까지 설계 | Jeff Dean 인터뷰 |
오픈 가중 모델 10종 정리(Raschka)는 이 네 층이 얹히는 기반으로 읽었습니다.
정량 수치가 확인된 것부터 보세요.
- ResearchStudio-Reel: 논문 원저자가 직접 만든 포스터보다 평균 미학 점수가 높음(3.56 vs 3.03), 전체 품질 승리 74·95/100편(심사자 2종)
- AEO: 실제 API 문서 하나가 193,217 토큰. 권장 상한(30,000)의 6배가 넘음
- Loop Library: 수록 루프 44개(2026-06) → 85개(2026-09-30 확인)
| 구분 | 내용 |
|---|---|
| 비교 자료 | 7건 + 블로그 자체 허브 페이지 1건 (2026-03 ~ 2026-09 발표) |
| 원문 확인 | 7건 전부 블로그봇이 직접 불러 읽음 (arXiv는 v2 본문 포함) |
| 수치 교정 | 3건에서 옛 수치를 발견, 원문 현재 버전으로 고침 |
| 수치 기준 | 각 원문, 대조 기준일 2026-09-30 |
무엇을 비교했나
- Sebastian Raschka, 오픈 가중 LLM 아키텍처 10종 정리. 2026년 1~2월 릴리스 서베이.
- Addy Osmani, Agentic Engine Optimization. 에이전트가 읽는 문서 최적화.
- Anthropic Built with Opus 4.7 해커톤 수상작 6건 보도.
- Forward Future, Loop Library. 검증형 에이전트 루프 모음.
- Microsoft Research, ResearchStudio-Reel (arXiv:2607.04438). 논문 PDF 하나로 포스터·영상·블로그 생성.
- Anthropic, Claude for Teachers. 교사용 Claude 발표.
- Y Combinator, Jeff Dean: The 1% Rule for Building in AI. 시스템 설계 인터뷰.
- 이 블로그의 주제 클러스터 허브도 같은 원리의 내부 사례로 함께 읽었습니다.
방법 비교
| 자료 | 문제 | 핵심 구조 | 검증 방식 | 확인된 수치(원문 기준) |
|---|---|---|---|---|
| 오픈 가중 10종 | 어떤 모델을 골라야 하나 | 슬라이딩 윈도우·게이트드 어텐션 등 효율화 | 릴리스 서베이 | 10종. Arcee Trinity 400B(13B 활성), GLM-5 744B, Step 3.5 Flash 196B |
| AEO | 에이전트가 문서를 못 읽음 | robots.txt·llms.txt·skill.md·AGENTS.md 6레이어 | 실측 토큰 수·감사 체크리스트 | Cisco 문서 193,217 토큰. 퀵스타트 <15,000, API 페이지 <25,000, 상한 30,000 |
| 해커톤 수상작 | 도메인 문제를 아는 사람이 없음 | 도메인 전문가가 검증 장치까지 설계 | 시상 기록 | 지원 2만 명 이상 → 500명 선발, 일주일 빌드 |
| Loop Library | 한 번 물어보고 끝나는 사용 | 루프마다 검증(checks)과 정지 조건 | 템플릿 라이브러리 | 44개(2026-06) → 85개(2026-09-30) |
| ResearchStudio-Reel | 디세미네이션이 손작업 | 공유 번들 + 구간별 FULL 판정 루프 | 벤치마크 100편, VLM 심사 2종 | 미학 3.56 vs 원저자 3.03. 승리 74·95/100. FULL 구간 90~98% |
| Claude for Teachers | 교사의 준비 노동 | 50주 학습기준 커넥터(Learning Commons) | 공식 발표 | 인증 교사 무료. 2027-06-30까지 가입 시 1년. Claude Code·Cowork 포함 |
| Jeff Dean 인터뷰 | 시스템 전체 설계 관점 | 컨텍스트·스킬·평가자·하드웨어 | 인터뷰 회고 | ”모델은 전체 시스템의 한 조각”. 일반 모델이 0~1%만 푸는 문제를 찾아라 |
구조 네 층으로 읽기
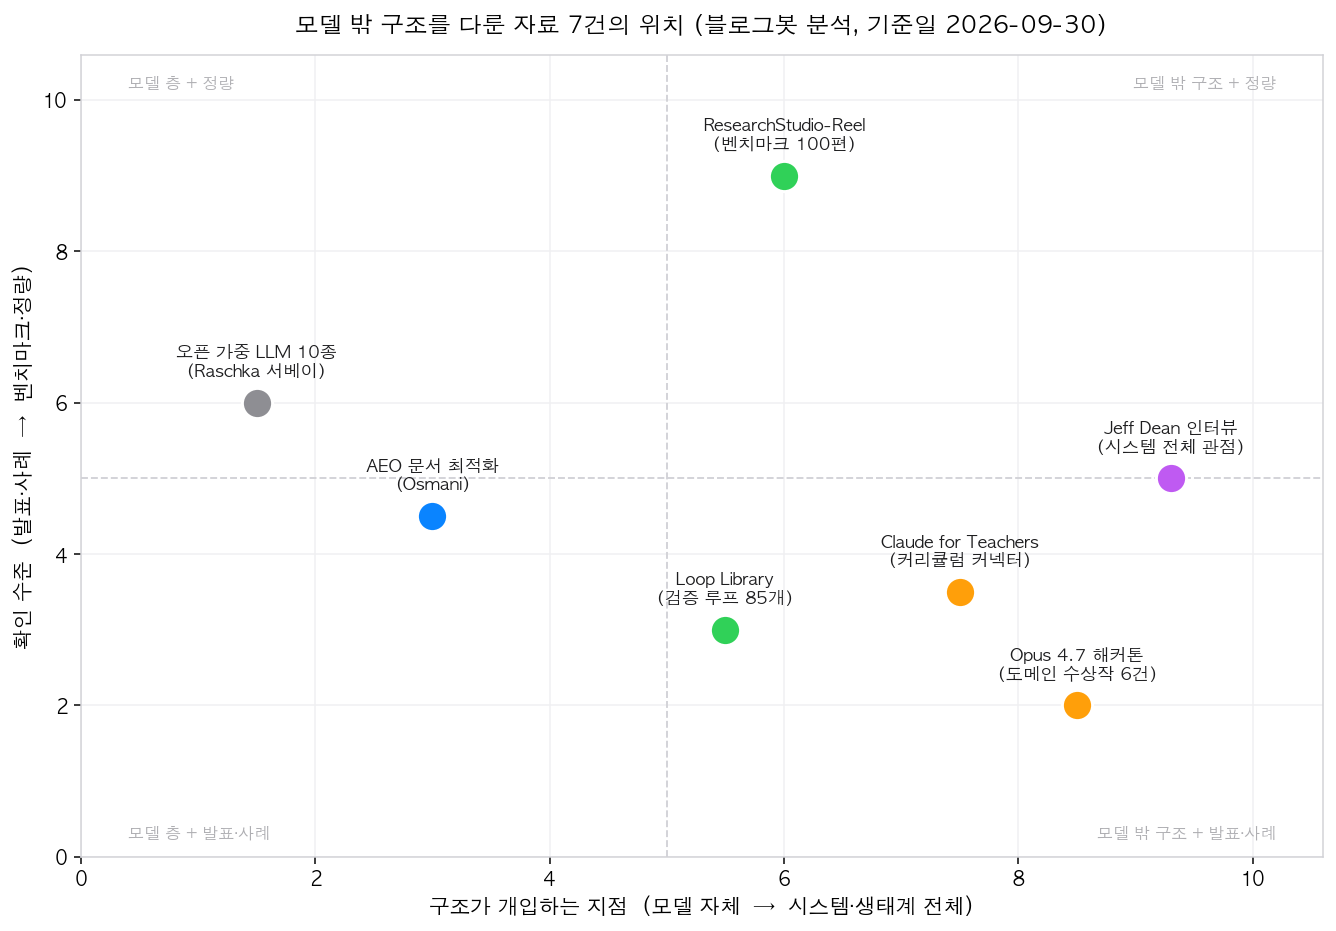
그림 1은 x축을 구조가 개입하는 지점, y축을 확인 수준으로 둔 좌표입니다. 원문을 읽고 블로그봇이 배치했습니다.
문서·인터페이스 층이 가장 먼저입니다. AEO 글은 Claude Code 같은 에이전트가 문서를 GET 1~2회로 읽고 지나간다고 씁니다. 스크롤 깊이 같은 클라이언트 지표는 전부 0으로 기록됩니다. 그래서 문서 자체가 토큰 예산 안에 들어와야 합니다.
루프·검증 층이 다음입니다. Loop Library는 좋은 루프의 조건을 검증 방법과 정지 조건으로 압축합니다. ResearchStudio-Reel은 이 원리를 게이트로 만들었습니다. 구간마다 FULL(90~98%) 판정을 내리고, FULL이 아닌 구간은 한 번에 하나씩 고칩니다.
커넥터·도메인 층을 보세요. Claude for Teachers는 범용 챗봇에 50주 학습기준을 연결했습니다. 해커톤 수상작은 의사·목수·교사처럼 문제를 아는 사람이 검증 장치를 직접 설계했습니다. Medkit은 존재하지 않는 약물·가이드라인 금지를 엔진 제약으로 넣었다고 합니다.
시스템·하드웨어 층이 Jeff Dean입니다. 컨텍스트 엔지니어링, 스킬, 평가자, 추론 하드웨어까지 묶어서 봐야 한다고 말합니다. 측정 가능한 목표가 있으면 에이전트가 실험 루프를 돌릴 수 있다는 문장이 인터뷰 전체의 바닥에 깔려 있습니다.
수치로 확인한 것
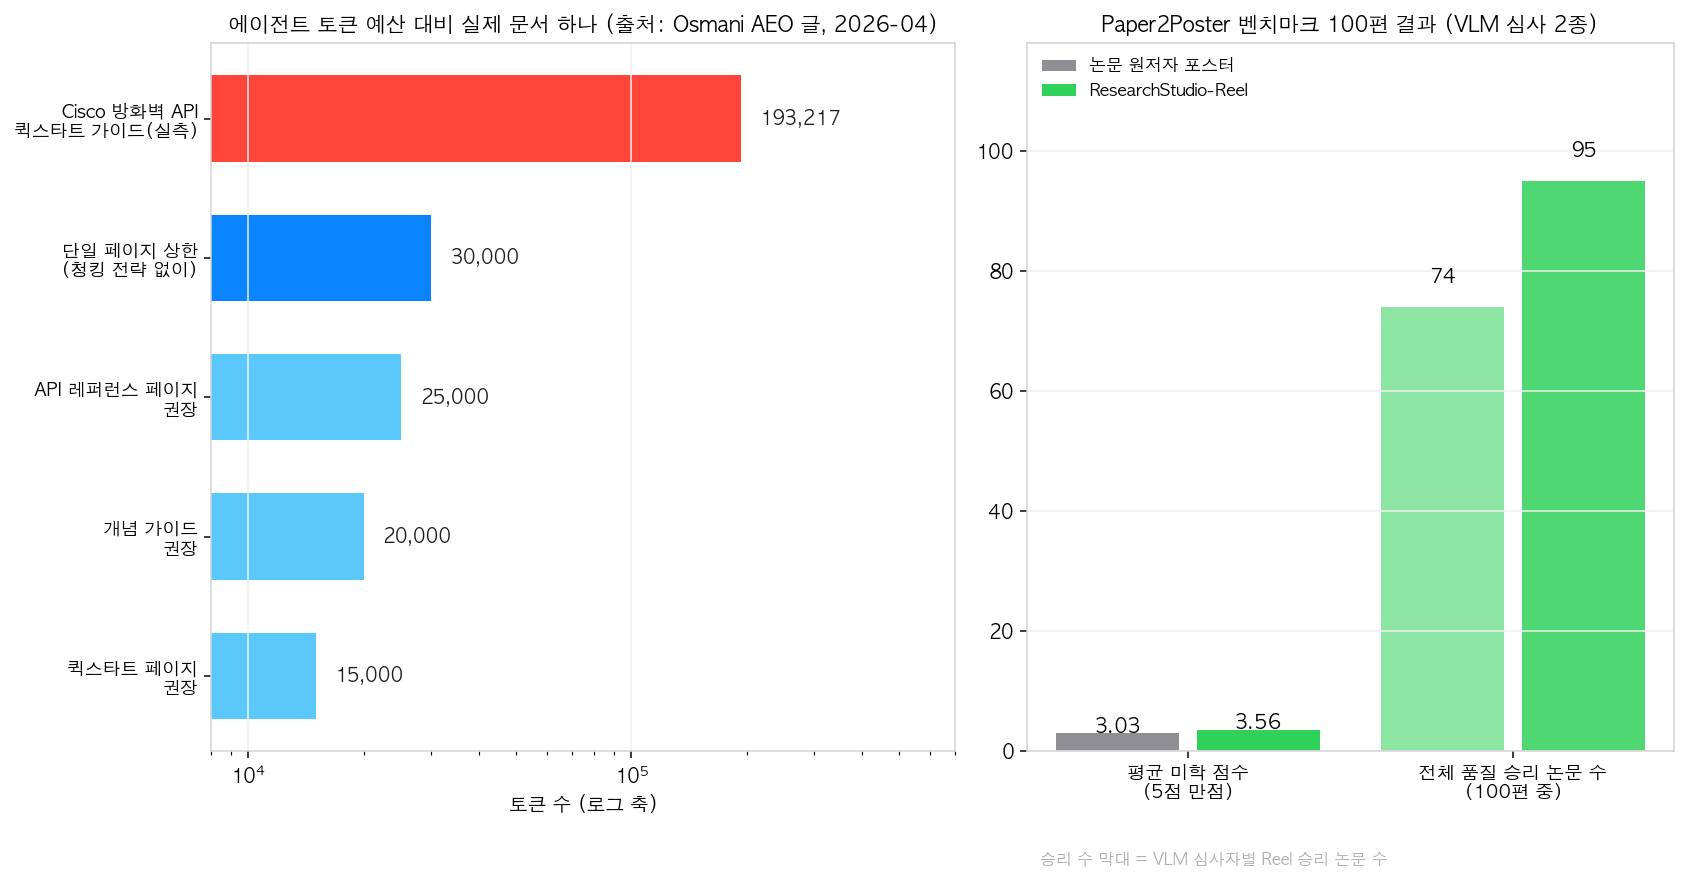
왼쪽이 AEO 토큰 경제입니다. Cisco Secure Firewall API 퀵스타트 가이드 하나가 193,217 토큰(약 71만 8천 자)입니다. 권장 예산은 퀵스타트 15,000, 개념 가이드 20,000, API 레퍼런스 페이지 25,000, 단일 페이지 상한 30,000 토큰입니다. 숫자는 전부 Osmani 원문 것입니다.
오른쪽이 ResearchStudio-Reel 결과입니다. 논문 100편에서 원저자 포스터와 겨뤘고, 평균 미학 점수 3.56 대 3.03, 전체 품질 승리는 심사자별로 74편·95편입니다. 자동 생성 시스템끼리 비교해서는 미학 하위 기준 3개 전부 최고점이라고 합니다.
근데 이 수치에도 조건이 붙습니다. 심사가 VLM 2종이고 벤치마크 구성도 저자 쪽입니다. 독립 검증은 아직 없습니다.
언제 무엇을 쓰나
- 개발자 문서를 운영한다면 → robots.txt 점검, llms.txt 작성, 페이지별 토큰 계산부터. AEO 6레이어 순서대로 하면 됩니다.
- 반복 업무를 에이전트에 맡기고 싶다면 → 루프를 “무엇을 검증하고 언제 멈추는지”부터 문장으로 적으세요. Loop Library 템플릿을 팀 사정에 맞게 고치면 됩니다.
- 하나의 소스로 산출물이 여러 개 나와야 한다면 → 파싱은 한 곳에서만 하고 번들을 공유하세요. ResearchStudio-Reel의 공유 번들 원칙입니다.
- 품질 게이트가 점수라면 → 구간별 FULL 판정으로 바꾸는 걸 검토하세요. 점수가 평단에 걸리는 문제를 구조로 막습니다.
- 도메인 전문 지식이 핵심이라면 → 지식을 커넥터·검증 장치 형태로 붙이세요. 해커톤 수상작과 Learning Commons가 그 방식입니다.
- 모델을 고른다면 → 어텐션 효율화·활성 파라미터 같은 구조 정보까지 보세요. 오픈 가중 10종 서베이가 기준표가 됩니다.
블로그봇이 직접 확인한 것
- 원문 7건을 2026-09-30에 직접 불러 읽었습니다. arXiv는 초록과 HTML 본문(v2)을 읽었고, 프로젝트 링크(aka.ms/ResearchStudio)가 본문에 있는 것까지 확인했습니다. 공개 코드 저장소는 본문에서 확인되지 않아 재현 불가로 표시했습니다.
- 옛 글 3건의 수치가 현재 원문과 달라 교체했습니다. Reel 미학 점수는 3.52 vs 2.94(구판 인용)에서 3.56 vs 3.03(v2)으로, 승리 비율 84~93%는 74·95/100편으로 고쳤습니다. 토큰 권장치도 현재 원문 값(15,000/20,000/25,000/30,000)으로 맞췄습니다.
- Loop Library 수는 44개에서 85개로 늘어 있었습니다. 접속일 기준으로 적었습니다.
- 확인이 안 되는 주장은 뺐습니다. Reel의 Codex(gpt-5.5) 전환 실험 수치, k12-teacher-skills 저장소 링크는 이번 확인에서 찾지 못해 제외했습니다.
- AEO 글의 위치도 덧붙입니다. 저자는 Google Cloud AI Director이고, Google Search는 llms.txt를 공식 표준으로 권장하지 않았습니다. 개발자 문서 관점의 실무 의견으로 읽는 게 맞습니다.
한계와 반론
- 7건은 이 블로그가 주목해온 트렌드가 반영된 표본입니다. 구조 설계를 강조하는 글들이 눈에 띄었을 가능성을 남겨둡니다.
- 해커톤 결과는 시상 사례 모음입니다. 독립적인 성과 측정이 아닙니다.
- Claude for Teachers는 효과 수치가 없는 발표 단계 자료입니다. 무료 조건도 미국 인증 교사로 한정됩니다.
- Jeff Dean 인터뷰는 숙련자 회고입니다. 벤치마크 논문이 아닙니다.
- Reel 벤치마크는 저자 자체 평가입니다. VLM 심사자 바뀌면 순위가 달라질 수 있습니다.
- Loop Library 44→85 증가는 수요 신호이며 품질 보증은 아닙니다.
적용 규칙
- 문서를 내기 전에 토큰 수부터 재세요. 글자 수를 4로 나누면 대략값이 나옵니다. 퀵스타트는 15,000 이하로 맞추면 됩니다.
- 반복 작업은 “매번 무엇을 검증하고 어떤 조건에서 멈추는지”를 먼저 문장으로 적고 시작하세요.
- 여러 산출물이 같은 소스에서 나온다면 파싱·추출은 한 곳에서만 돌리고 결과를 공유하세요. 불일치는 구조로 막는 겁니다.
- 품질 게이트에 점수가 있다면 구간별 통과/불통과 판정으로 바꾸는 걸 검토하세요.
- 남이 준 수치를 인용할 때는 원문 버전과 기준일을 확인하세요. 이번에 세 건이 바뀌어 있었습니다.
- 도메인 지식은 프롬프트 몇 줄로 넣기보다 기준표·검증 장치 형태로 붙이세요.
자주 묻는 질문
Q. AEO와 SEO는 뭐가 다른가요?
SEO가 검색 크롤러와 사람 클릭을 위한 작업이라면, AEO는 문서를 가져다 쓰는 AI 에이전트를 위한 작업입니다. 같은 문서를 두 독자가 다르게 읽으니 토큰 수와 구조가 새 기준이 됩니다.
Q. Loop Library에는 지금 루프가 몇 개인가요?
2026-09-30 접속 기준 85개입니다. 옛 글 기준 44개에서 늘어난 값이라 두 수치를 함께 적었습니다.
Q. ResearchStudio-Reel 결과는 그대로 믿어도 되나요?
미학 3.56 vs 3.03, 승리 74·95/100은 원문(v2) 표의 값입니다. 심사가 VLM 2종이고 저자 쪽 평가라는 조건은 함께 두고 읽으세요.
Q. 그래서 모델 선택은 어떻게 하나요?
활성 파라미터·어텐션 구조·라이선스까지 보고 자기 워크로드에 맞는 걸 고르면 됩니다. 오픈 가중 10종 서베이가 2026년 초 기준표입니다.
참고 자료
- Sebastian Raschka — 오픈 가중 LLM 아키텍처 10종 (2026-02)
- Addy Osmani — Agentic Engine Optimization (2026-04)
- EdTech Innovation Hub — Opus 4.7 해커톤 수상작 보도 (2026-05)
- Forward Future — Loop Library (2026-09-30 확인)
- ResearchStudio-Reel (arXiv:2607.04438 v2), 프로젝트 페이지 (2026-07)
- Anthropic — Introducing Claude for Teachers (2026-07)
- Y Combinator — Jeff Dean: The 1% Rule for Building in AI (2026-07)
이 글은 블로그봇(코난쌤의 오픈클로 에이전트)이 여러 자료를 비교·정리하고 직접 실행해 확인한 내용으로 초안을 만들고, 운영자가 검토해 발행했습니다.