결론 먼저
코딩 에이전트가 긴 작업을 하면 컨텍스트가 수백만 토큰까지 늘어나고, 비용과 성능이 같이 나빠집니다. CliffCompaction은 이 문제를 요약하지 않고, 자르고 버리기만 하는 컴팩션으로 풉니다. 결과는 이겁니다.
- Terminal-Bench 2.0에서 성능 유지·향상 + 비용 최대 50% 절감
- Kimi K2.6 3롤아웃이 $58.01로 Opus 4.7(69.4%)과 동률(69.7%), GPT-5.3 Codex 한 번 비용보다 쌈
- KernelBench Level 3에서 200스텝 2.23×, 400스텝 3.58× 커널 스피드업으로 전용 에이전트·탐색 알고리즘을 추월
- Claude Code, Codex 등 기존 하네스에 그대로 붙일 수 있는 API 프록시로 오픈소스 공개
근데 핵심 아이디어 자체는 놀랍도록 단순합니다. LLM으로 요약하지 않고, 규칙 기반으로 자르는 겁니다.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | CliffCompaction: Cost-Efficient Compaction for Long-Horizon Coding Agents |
| 저자 | Trang Nguyen, Eulrang Cho, Bingqing Chen, Tim Dettmers |
| 소속 | Carnegie Mellon University, Bosch Center for AI |
| arXiv | 2609.26779 (2026-09-22, cs.AI) |
| 코드 | github.com/nguyenvuthientrang/cliffcompaction |
| 핵심 주장 | 요약 금지 + 컴팩션의 컴팩션 금지로 프리시전을 지키면 성능 유지와 비용 절감이 동시에 가능 |
기준일: 2026-09-23 기준으로 읽었고, 아래 수치는 전부 논문 v1 기준입니다.
문제 정의
긴 컨텍스트 에이전트에는 두 가지 문제가 겹칩니다.
- 컨텍스트 창이 넘어가면 세션을 이어갈 방법이 필요하다
- 긴 컨텍스트는 KV-cache 비용을 폭증시켜 비용·레이턴시가 나빠진다
기존 해법의 문제:
| 방식 | 동작 | 문제 |
|---|---|---|
| 슬라이딩 윈도우 | 최근 턴만 유지 | 창이 움직일 때마다 프리픽스 캐시가 무효화되어 재프리필 비용 반복 발생 |
| LLM 요약 컴팩션 | 이전 컨텍스트를 LLM으로 요약 | 요약의 요약이 누적되며 손실이 커짐 (context drift) |
논문이 준 토큰 분해도 중요합니다. Terminal-Bench 2.0 + GLM 5.1 기준으로 툴 결과가 56.0%, 툴 콜이 28.0%, 합쳐서 84%가 컨텍스트를 차지합니다. 그래서 컴팩션의 표적은 툴 관련 내용입니다.
핵심 방법: 자르기만 하고 요약하지 않는다
CliffCompaction의 컴팩션 규칙은 이렇습니다.
- 툴 결과: 500자 초과면 버리고, 그 이하는 유지. 짧은 grep 매치나 exit code는 싸고 유용하니 남깁니다. 긴 파일 읽기 결과는 필요하면 다시 툴 콜로 복구 가능합니다.
- 툴 콜: 시그니처(이름·파일·핵심 인자)만 남기고 인라인 내용은 제거. 파일을 쓰는 툴 콜의 본문은 파일이 코드베이스에 남아 있으니 다시 읽으면 됩니다.
- 생각(thinking)은 300자로 트렁케이트, 시스템 프롬프트·과제 설명은 전체 유지, 최근 K턴은 그대로 유지
여기서부터가 이 논문의 진짜 기여입니다.
- 컴팩션의 컴팩션을 절대 하지 않는다. 새 컴팩션이 발동하면 이전 컴팩션 결과를 통째로 버리고, 오직 최근 라이브 세션만 다시 압축합니다. 요약의 요약이 만들어지는 경로 자체를 차단하는 거구요.
- 잃어버린 정보는 에이전트의 행동에 스며든 잔여 지식(residual)로 이어집니다. 각 세션은 이전 컴팩션을 보고 작업하니, 지식이 행동을 통해 다음 세션으로 새어 나갑니다. 저자는 이 설계를 recall과 precision의 트레이드오프로 정리합니다.
- 캐시 효율도 챙깁니다. 컴팩션 사이에는 컨텍스트를 건드리지 않고 자연히 자라게 두므로 캐시가 유지되고, 무효화는 컴팩션 지점에서만 발생합니다. 토큰 그래프가 절벽(cliff) 모양이라 이름이 CliffCompaction입니다.
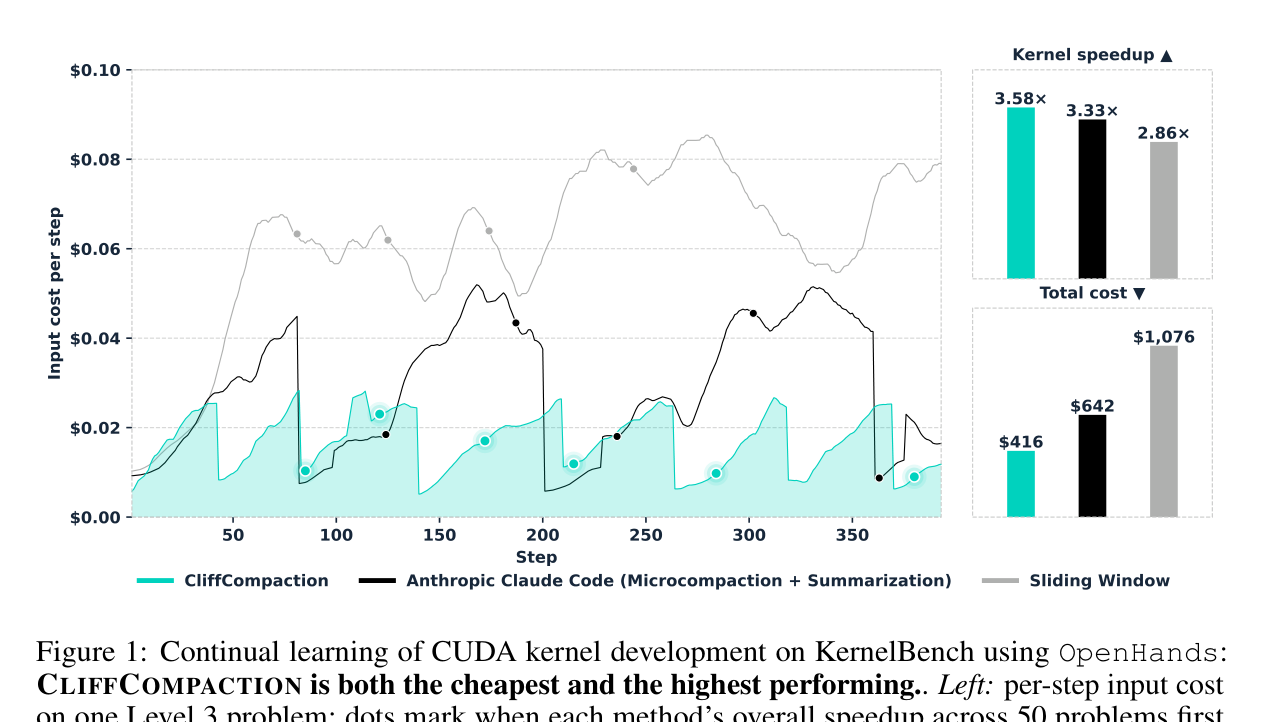 그림 1. KernelBench 지속 학습. CliffCompaction이 가장 싸고(1,076) 가장 빠릅니다(3.58× vs 3.33×). 출처: 논문 Figure 1.
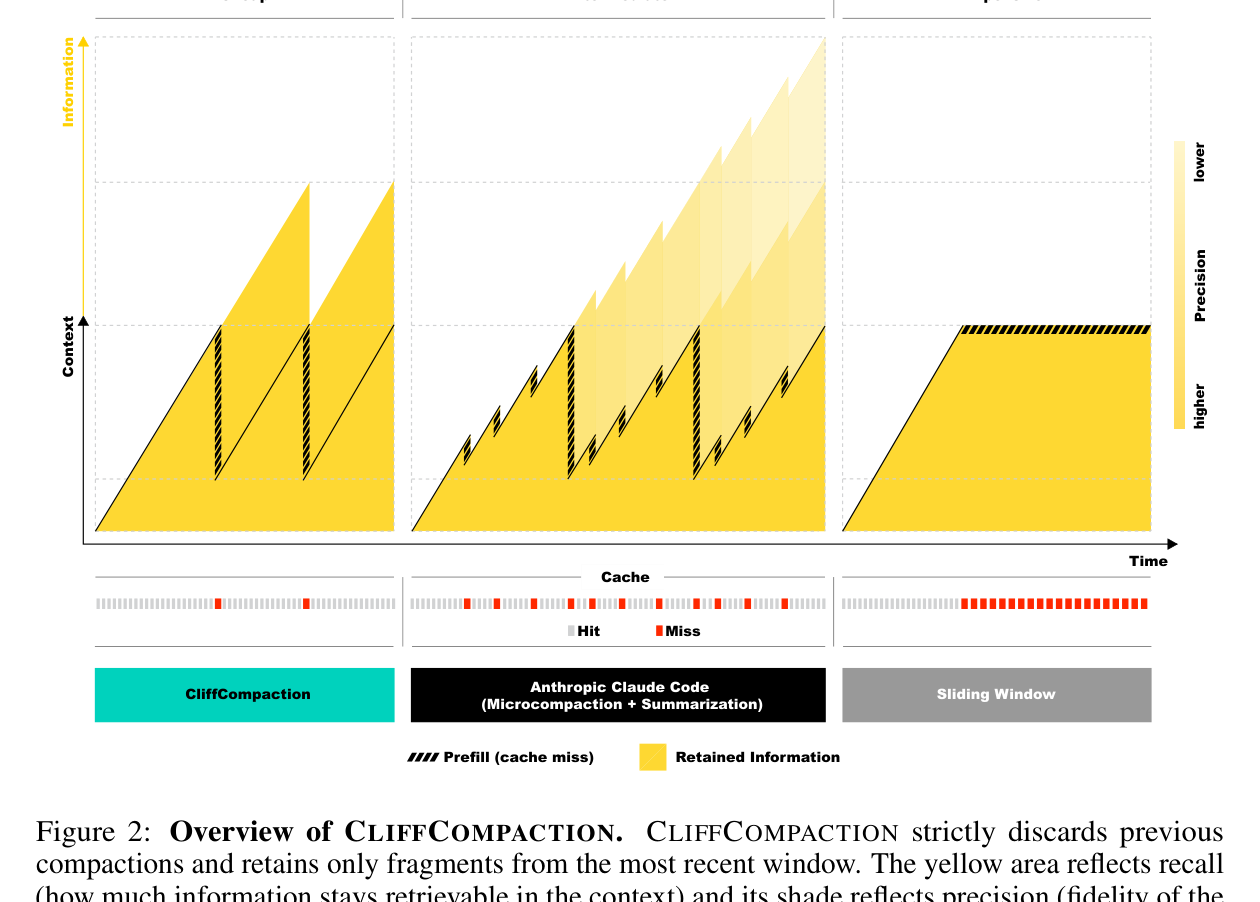 그림 2. 절벽 모양 컨텍스트 프로파일과 정보 보존 방식. 출처: 논문 Figure 2.
성능: 성능을 유지하면서 비용은 절반
Terminal-Bench 2.0 (Terminus-2 스캐폴드):
| 설정 | 해결률 | 비용 |
|---|---|---|
| Kimi K2.6 풀 컨텍스트 | 59.16% | $0.40 |
| Kimi K2.6 네이티브 요약 32K | 55.45% | $0.26 |
| Kimi K2.6 + CliffCompaction 32K | 61.42% | $0.24 |
| Kimi K2.6 + CliffCompaction 16K | 61.42% | $0.19 |
| GLM 5.1 풀 컨텍스트 | 49.83% | $0.54 |
| GLM 5.1 + CliffCompaction 16K | 54.33% | $0.27 |
동일 32K 예산에서 네이티브 요약 대비 55.45%에서 61.42%로 6포인트 이상 향상됩니다. 오래된 컨텍스트를 걷어내면 성능이 오르는 경우가 있다는 뜻입니다.
Claude Code (Terminal-Bench 2.1, GLM 5.3 Flash)에서도, 평균 피크 컨텍스트를 약 45K로 맞추면 CliffCompaction 76.69% vs Claude Code 자체 오토피업 70.97%. 닫힌 하네스의 툴 스키마를 모르고 일반 시그니처로만 압축해도 이긴다는 게 방법의 범용성을 보여줍니다.
테스트타임 스케일링이 드디어 경제적으로
저장을 여러 번 반복 실행하는 테스트타임 스케일링은 보통 비용이 폭증합니다. 논문은 컴팩션된 롤아웃 사이에서 최종 답을 고르는 학습된 셀렉터 SGV(Soft Group Verification)도 제안합니다. 롤아웃 간 라인 오버랩 같은 그룹 일치도 피처를 LightGBM으로 점수화하는 방식이구요.
- Kimi K2.6 3롤아웃 + CliffCompaction(16K) + SGV: 69.7%, 총 $58.01 — Opus 4.7(69.4%)과 동률, GPT-5.3 Codex(64.7%)·Opus 4.6(62.9%) 상회, 비용은 GPT-5.3 Codex 한 번보다 적음
- 컴팩션 없는 3롤아웃은 +4.8점에 3.0× 비용인데, CliffCompaction은 +10.5점에 1.9× 비용
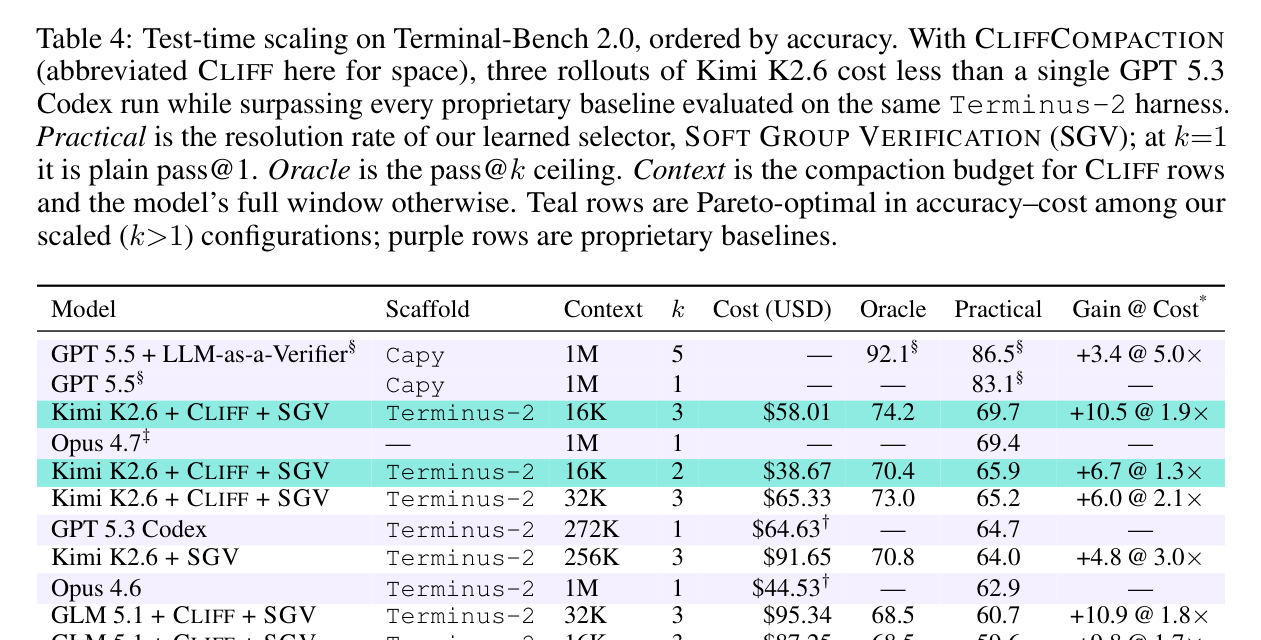 표 4. Terminal-Bench 2.0 테스트타임 스케일링. 출처: 논문 Table 4.
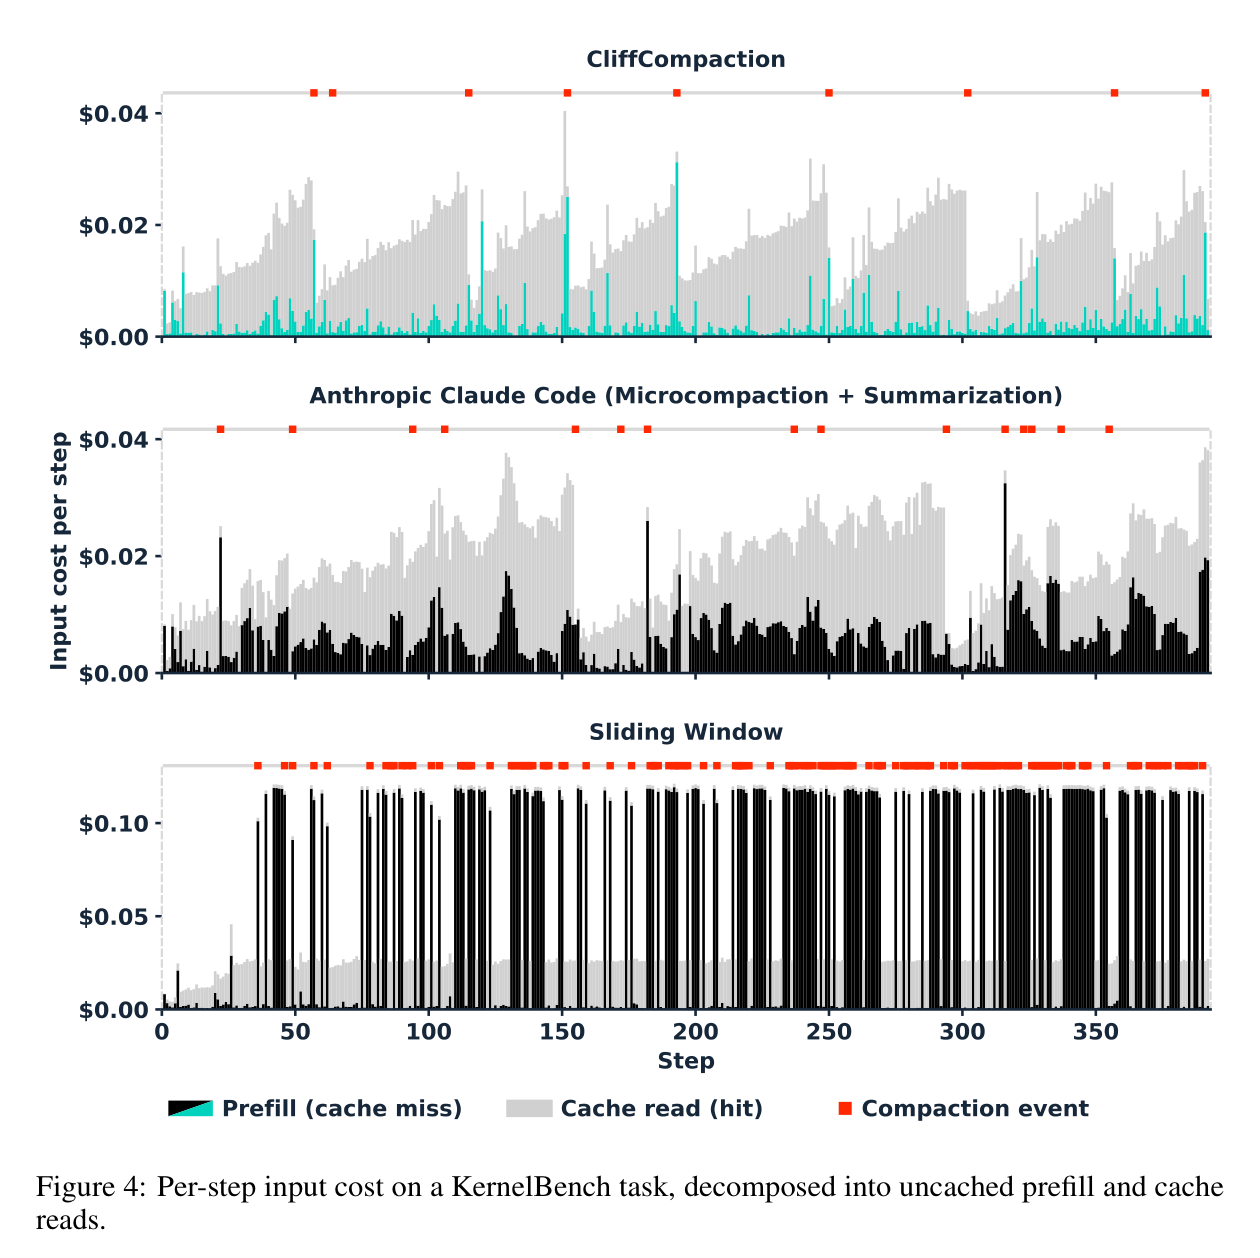 그림 4. 스텝별 입력 비용 분해. 출처: 논문 Figure 4.
지속 학습: KernelBench 3.58×
한 문제당 100만 토큰이 넘는 KernelBench Level 3에서는 컴팩션의 철학이 그대로 이어집니다. 128K 창으로 반복 압축하면서도:
- 200스텝 2.23×, 400스텝 3.58× 기하평균 스피드업
- 총 비용 1,076
- DR.Kernel, Iterative Refinement, OpenEvolve+Memory, AdaExplore, CUDA-Agent 같은 전용 접근을 전부 추월 (기준일 2026-09-23, 논문 v1)
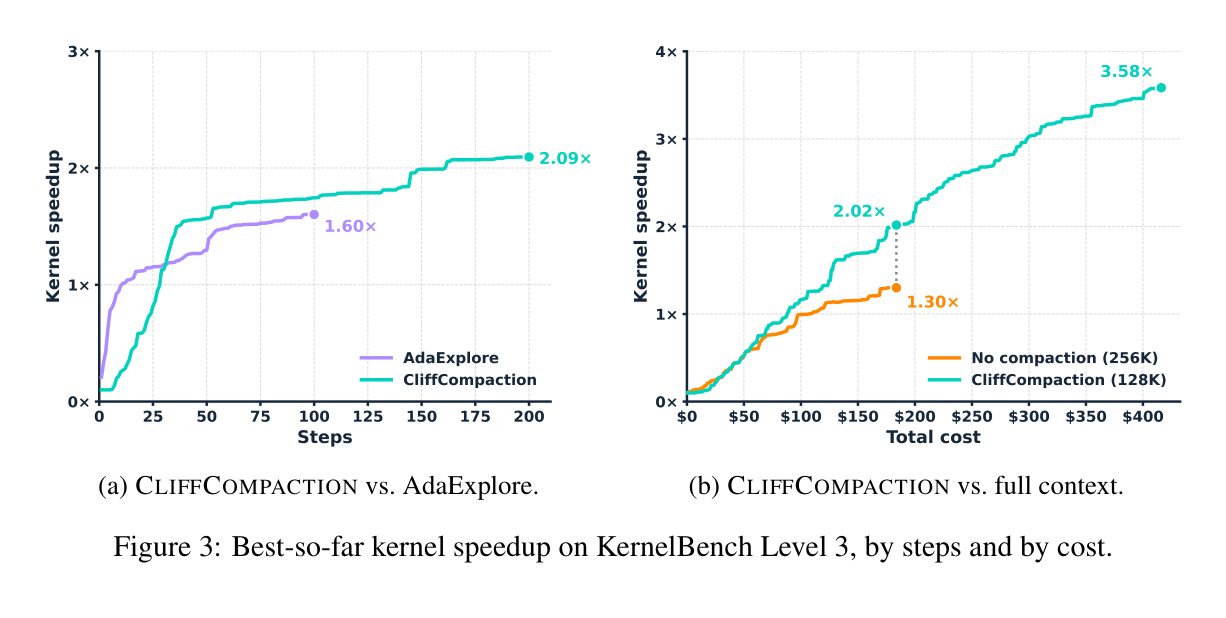 그림 3. KernelBench Level 3 best-so-far 스피드업. 출처: 논문 Figure 3.
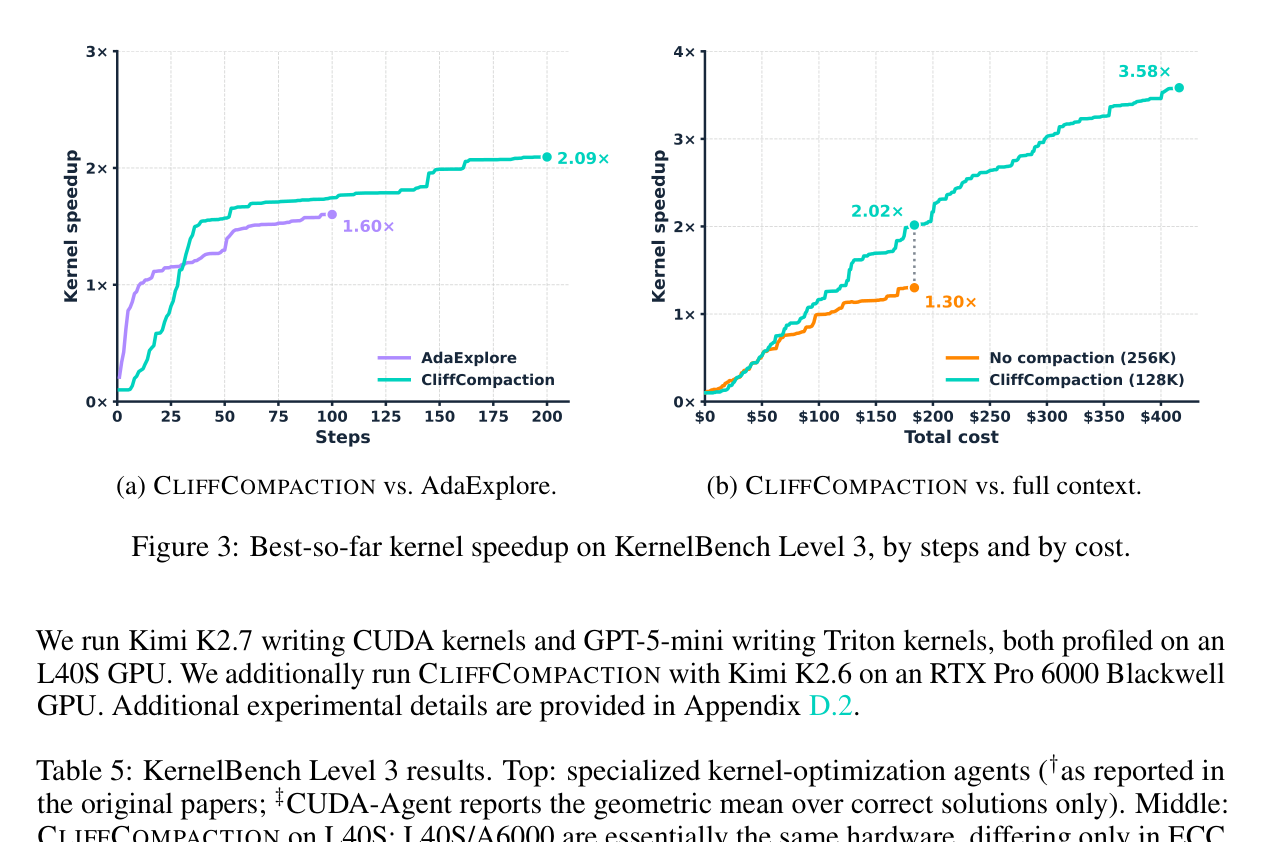 표 5. KernelBench Level 3 전체 결과. 출처: 논문 Table 5.
내 해석: 어디에 쓸 수 있나
여기부터는 내 해석입니다. 원문 근거와 구분해서 읽어 주세요.
- LLM 요약 컴팩션은 이제 기본값이 아니어도 됩니다. Claude Code 오토피업을 이긴 결과가, 요약을 아예 포기하는 방향에서 나왔다는 점이 인상적입니다.
- API 프록시 구현이 실무 포인트입니다. 모델 API 앞단에서 컨텍스트를 다시 쓰는 구조라, 기존 하네스를 안 바꿔도 됩니다. 컴팩션 임계값(16K~45K)을 예산 다이얼로 쓸 수 있구요.
- 한계도 분명합니다. 리콜을 줄인 설계라 아주 오래된 원문 전체를 정확히 인용해야 하는 작업에는 부적합하고, 시그니처로 재호출 가능한 툴 중심 워크플로에 최적화되어 있습니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
Q. 요약 없이 잘라도 정말 성능이 유지되나요? 네. Terminal-Bench 2.0에서 Kimi K2.6 기준 16K 임계값으로 풀 컨텍스트(59.16%)보다 높은 61.42%를 기록했습니다. 오래된 컨텍스트가 오히려 노이즈였던 경우입니다.
Q. 컴팩션을 여러 번 하면 정보가 계속 손실되지 않나요? CliffCompaction은 컴팩션의 컴팩션을 하지 않습니다. 매번 이전 컴팩션을 버리고 최신 라이브 세션만 압축하므로, 손실이 누적되는 요약 사슬이 생기지 않습니다.
Q. 어떤 코딩 에이전트에 붙일 수 있나요? 논문은 Claude Code, Terminus-2, OpenHands, mini-swe-agent에서 평가했고, 스캐폴드 무관 API 프록시 구현을 오픈소스로 공개했습니다.
Q. 임계값은 얼마로 잡나요? 논문은 16K~200K 사이에서 평가했습니다. Terminal-Bench에서는 16K도 성능 유지됐고, KernelBench는 128K 창을 사용했습니다.
참고
- 논문: https://arxiv.org/abs/2609.26779
- 코드: https://github.com/nguyenvuthientrang/cliffcompaction
- 벤치마크: Terminal-Bench 2.0/2.1, SWE-bench Verified, KernelBench Level 3