핵심 요약
에이전트를 오래 돌리면 대화 히스토리가 쌓이고, 결국 메모리 시스템이 필요해집니다. 그런데 이 메모리 시스템이 또 다른 병목이 됩니다. 뭘 저장할지, 어떻게 연결할지, 언제 검색을 멈출지 — 이 모든 결정을 LLM에게 시키니까 비용이 폭증하는 거죠.
이 지점을 공략한 논문이 나왔습니다. Jev-Mem(arXiv 2609.23986)입니다. 결과부터 요약하면 LoCoMo 전체 0.777로 최강 baseline 대비 +11.0%, 메모리 빌드는 6.6배 빠른 158초, 쿼리 지연은 0.93초를 정확도 손실 없이 동시에 잡았습니다.
| 항목 | 값 |
|---|---|
| 논문 | Jev-Mem: System-One-Controlled Agentic Memory (arXiv 2609.23986) |
| 소속 | UT Dallas (Dongming Jiang, Yi Li, Bingzhe Li) |
| 제출일 | 2026-09-21 (v1 기준, 기준일 2026-09-23) |
| 벤치마크 | LoCoMo, LLM-as-a-Judge, gpt-4o-mini |
| 전체 점수 | 0.777 (최강 baseline 0.700) |
| 메모리 빌드 | 158초 (경쟁 최저 1,044초 대비 6.6배 빠름) |
| 쿼리 지연 | 0.93초 (baseline 최저 1.47초 대비 36.7% 감소) |
| 코드 | github.com/libingzheren/Jev-Mem |
원문: arXiv abstract / GitHub
왜 에이전트 메모리는 느려질까
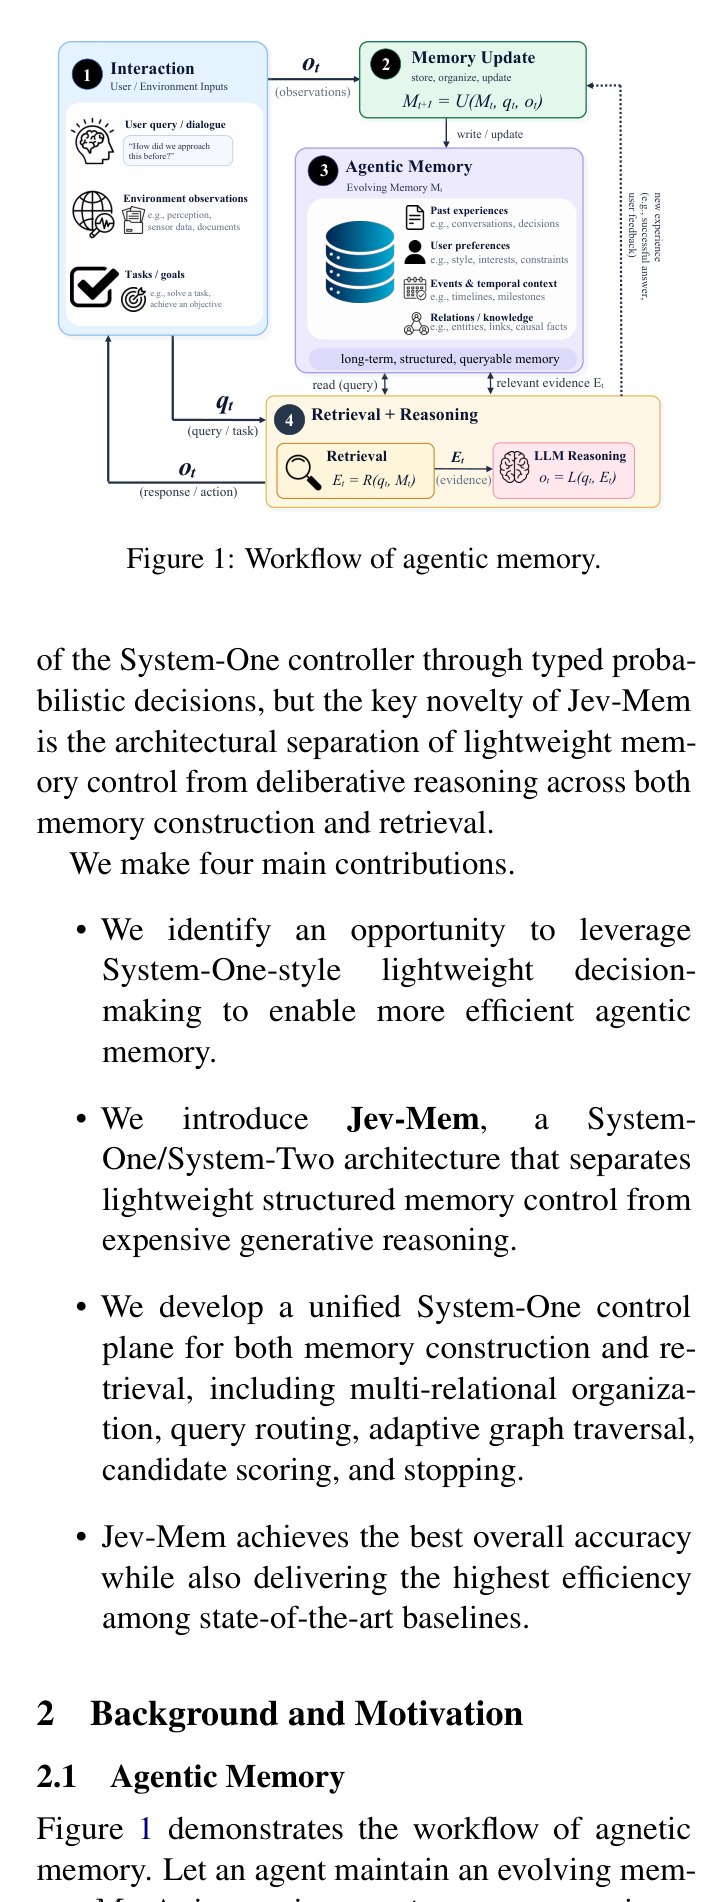
장기 실행 에이전트의 메모리 시스템(A-MEM, MemoryOS, Nemori, MAGMA 등)은 무엇을 저장하고, 어떻게 연결하고, 무엇을 검색해서 언제 멈출지를 계속 결정해야 합니다. 기존 방식은 이 결정들을 autoregressive LLM으로 처리합니다. 라벨 하나 뽑을 일에도 토큰을 생성하고 파싱하죠. 메모리 구축과 검색 경로에 이런 호출이 반복되니 메모리 관리 자체가 지연과 비용의 주범이 됩니다.
논문의 진단은 이렇습니다. 메모리 제어 결정은 semantic이긴 한데 generative는 아닙니다. 출력이 라벨, 확률, 점수처럼 bounded하니까, 굳이 자유 텍스트 생성을 쓸 필요가 없다는 거죠.
핵심 아이디어: 빠른 결정은 빠르게
Jev-Mem은 인지심리학의 System 1 / System 2 개념을 메모리 아키텍처에 그대로 이식했습니다.
- System-One 컨트롤러: 메모리 타이핑, 쿼리 라우팅, 검색 예산 배분, 후보 스코어링, 적응적 중단을 구조화 예측으로 처리. bounded 출력만 냅니다.
- 메모리 플레인: canonical 관찰 노드 + 4종 관계 뷰(semantic, temporal, causal, entity) + vector/lexical 인덱스.
- System-Two LLM: 복잡한 추론과 최종 답변 합성만 담당. 그래프 탐색이나 중단 판정에는 안 들어갑니다.
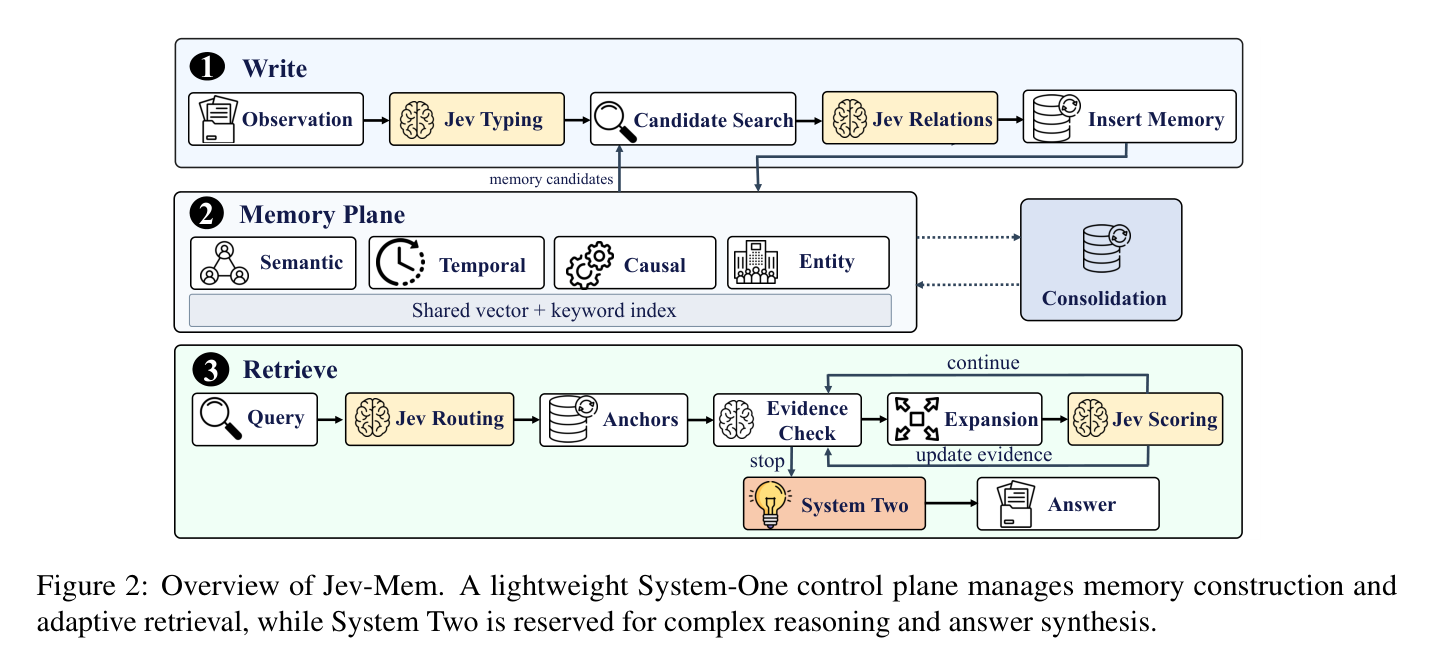
검색은 route → retrieve → assess → expand → reassess 루프로 돕니다. 각 라운드마다 증거 충분성, 추가 탐색 효용, 미해결 모순을 평가해서 탐색을 계속하거나 멈춥니다. 고정 top-k 검색과 다르게 탐색 깊이와 중단 시점이 전부 쿼리와 이미 모은 증거에 따라 달라지고, 컨트롤러 호출 수와 경과 시간에 명시적 상한도 걸어둡니다.
숫자로 보는 성과
LoCoMo(초장문 멀티세션 대화 벤치마크), LLM-as-a-Judge, gpt-4o-mini 기준입니다.
| 방법 | Multi-Hop | Temporal | Open-Domain | Single-Hop | Adversarial | 전체 |
|---|---|---|---|---|---|---|
| Full Context | 0.468 | 0.562 | 0.486 | 0.630 | 0.205 | 0.481 |
| A-MEM | 0.495 | 0.474 | 0.385 | 0.653 | 0.616 | 0.580 |
| MemoryOS | 0.552 | 0.422 | 0.504 | 0.674 | 0.428 | 0.553 |
| Nemori | 0.569 | 0.649 | 0.485 | 0.764 | 0.325 | 0.590 |
| MAGMA | 0.528 | 0.650 | 0.517 | 0.776 | 0.742 | 0.700 |
| Jev-Mem | 0.623 | 0.637 | 0.618 | 0.802 | 0.962 | 0.777 |
빌드 6.6배 빠름, 지연 36.7% 감소, 정확도 +11.0% — 전부 동시에입니다.
| 방법 | 빌드 시간(초) | 쿼리 지연(초) |
|---|---|---|
| Full Context | N/A | 1.74 |
| A-MEM | 3,636 | 2.26 |
| MemoryOS | 3,276 | 32.68 |
| Nemori | 1,044 | 2.59 |
| MAGMA | 1,404 | 1.47 |
| Jev-Mem | 158 | 0.93 |
특히 Adversarial 유형에서 0.742 → 0.962라는 가장 큰 격차가 나왔습니다. 그럴듯한 distractor를 걸러내는 능력, 즉 검색된 증거의 품질이 좋아진 효과죠. Open-Domain도 0.517 → 0.618로 올랐습니다. 참고로 MemoryOS는 쿼리당 32.68초입니다. 복잡한 처리가 검색 경로 위에 남아 있으면 이런 일이 벌어집니다.
내 해석과 남는 질문
정확도 향상의 출처가 포인트입니다. 전 카테고리에서 고르게 오른 게 아니라 증거를 여러 조각으로 조합하거나 distractor를 걸러내야 하는 유형에서 크게 올랐습니다. 모델이 똑똑해진 게 아니라 System Two에 더 적고 더 관련성 높은 입력이 들어간 결과로 읽힙니다.
남는 질문도 적어둡니다.
- 벤치마크가 LoCoMo 하나라 일반화 검증은 아직 부족합니다.
- 컨트롤러 학습 데이터와 재학습 비용이 v1에서는 명확하지 않습니다.
- 평가가 gpt-4o-mini judge에 의존합니다.
근데 방향 자체는 실무와 바로 맞닿아 있습니다. bounded 결정은 경량 예측으로, 자유 생성은 진짜 필요할 때만 — 이 원칙은 메모리를 넘어 에이전트 제어 설계 전반에 적용할 수 있습니다. 코드는 공개되어 있으니 직접 확인해보시길.
자주 묻는 질문
Jev-Mem의 핵심 기여가 뭔가요? 메모리 구축과 검색의 고빈도 결정을 autoregressive LLM 생성에서 System 1 구조화 예측으로 옮긴 것입니다. LoCoMo 전체 0.777, 빌드 158초, 쿼리 지연 0.93초를 동시에 달성했습니다.
기존 에이전트 메모리와 어디가 다른가요? A-MEM, MemoryOS 등은 메모리 조직과 검색에 LLM 생성을 씁니다. Jev-Mem은 쓰기와 읽기 전 과정을 같은 System-One 제어 인터페이스로 통일하고 System Two는 답변 합성에만 예약합니다.
Adversarial 점수가 왜 이렇게 높나요? 매 검색 라운드에서 증거 충분성과 추가 탐색 가치를 평가해서 그럴듯한 distractor가 증거로 들어오는 걸 줄였기 때문으로 논문은 설명합니다. 해당 유형 0.962는 최강 baseline 0.742 대비 최대 격차입니다.
바로 써볼 수 있나요? 코드가 공개되어 있습니다(github.com/libingzheren/Jev-Mem). LoCoMo 외 환경 검증과 컨트롤러 운영 비용은 직접 확인해보시면 됩니다.
더 실습해보고 싶은 분들께
에이전트 하네스와 메모리 루프를 직접 다뤄보고 싶다면 두 자료를 추천합니다.