핵심 요약
에이전트 메모리 시스템은 대부분 1:1 대화를 가정하고 만들어졌습니다. 근데 실제 환경은 단체 채팅이에요. 여러 명이 동시에 얘기하고, 서로를 언급하고, 지난 결정을 뒤집습니다.
여기서 일반 메모리 시스템(Mem0, A-MEM, HippoRAG 등)이 흔히 실패합니다. 누가 그 말을 했는지, 그 말이 누구에 관한 것인지를 저장 단계에서 이미 잃어버리기 때문입니다.
이 문제를 정면으로 다룬 논문이 SpeakerMem-R1(arXiv 2609.26780)입니다. 결과부터 요약하면 EverMemBench 전체 62.33%로 공개 리더보드에서 최고 기록이고, GroupMemBench 47.9%, SocialMemBench 69.2%, LoCoMo 70.85%입니다. 핵심 설계는 두 가지입니다.
- 화자 라벨이 붙은 원문 그대로의 트랙(System 1) + 사람/그룹 단위 상태 트랙(System 2)의 이중 구조
- 메모리 작성자(Writer)를 SpeakerLevenshtein 보상 + 화자 조건 GRPO로 직접 강화학습
| 항목 | 값 |
|---|---|
| 논문 | SpeakerMem-R1: Speaker-Centered Dual-Track Memory for Multi-Party Dialogue (arXiv 2609.26780) |
| 소속 | Zhejiang University (Haobo Zheng, Tan Tang, Yan Chen, Weijie Wang, Yingcai Wu) |
| 제출일 | 2026-09-22 (v1 기준, 기준일 2026-09-23) |
| 핵심 과제 | 다자간 대화에서 메시지 귀속(attribution)과 상태 재구성 |
| 주 결과 | EverMemBench 62.33%(공개 최고), GroupMem 47.9%, SocialMem 69.2%, LoCoMo 70.85% |
| 학습 방법 | SpeakerLevenshtein + Speaker-Conditioned LoGo-GRPO, Qwen2.5-3B Writer |
| 원문 | arxiv.org/abs/2609.26780 |
문제: 일반 메모리가 단체 대화에서 실패하는 지점
논문은 기존 메모리 시스템의 실패를 두 가지 병목으로 정리합니다.
하나는 메시지 귀속 실패입니다. “내 무릎이 아직 아파”라는 말이 엄마가 한 말인지, 그게 엄마에 대한 이야기인지, 카라가 전해들은 것인지가 다릅니다. 일반 요약 메모리는 이걸 한 줄 사실로 합쳐버립니다.
나머지 하나는 상태 재구성 실패입니다. 산책 코스를 정하다가 의견이 갈렸다가, 다시 취소되고, 최종 결정이 나는 흐름이 여러 세션에 걸쳐 있으면 마지막 상태를 복원하지 못합니다.
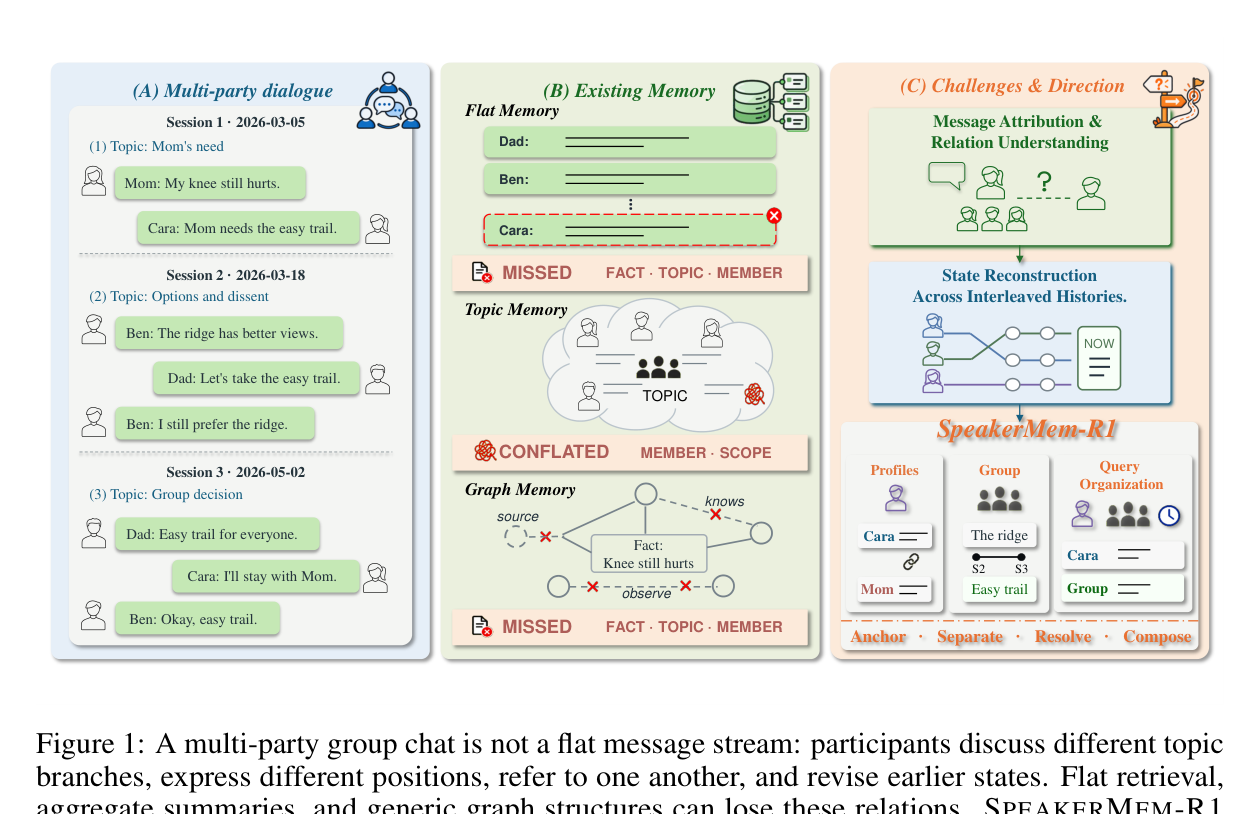
Figure 1이 이 상황을 잘 보여줍니다. 같은 대화라도 평면 메모리, 그래프 메모리, 토픽 메모리 각각이 서로 다른 사실을 놓칩니다. 저자들의 진단은 단순합니다. “관련성 검색”만 최적화해서는 안 되고, 참여자·귀속·범위·시간이 서로 맞는 증거를 모아야 한다는 거죠.
구조: 원문과 상태를 나눠 담는 이중 트랙
SpeakerMem-R1의 메모리는 두 트랙으로 나뉩니다.
| 트랙 | 내용 | 구성 |
|---|---|---|
| System 1 (원문) | 화자·시간·턴이 붙은 verbatim 메시지 | Episodic, append-only |
| System 2 (파생) | 사람/그룹 단위 구조화 상태 | Person Core, Person Profile, Group Interaction, Group Insight |
핵심 구분은 source와 owner를 분리하는 겁니다. “앨리스는 밥이 동의했다고 믿는다”라는 기록에서 source는 앨리스, owner는 밥입니다. 누가 말했는지와 누구에 관한 말인지를 다른 필드로 저장하는 것만으로 귀속 오류의 상당 부분이 막힙니다.
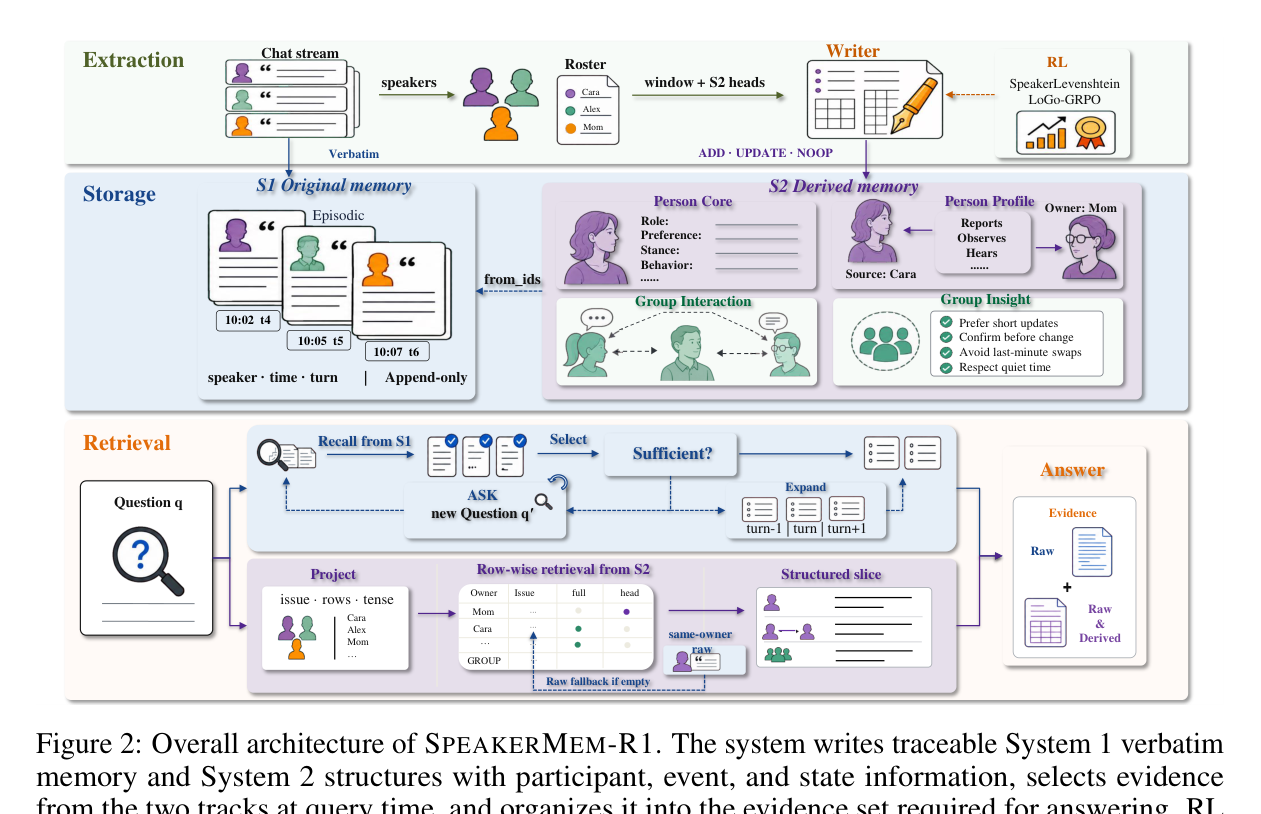
쿼리 시점에는 Anchor–Separate–Resolve–Compose 절차로 두 트랙에서 증거를 모읍니다. 질문에서 화자·이슈·시제를 뽑고(Anchor), System 1과 System 2를 나눠 조회하고(Separate), 충돌하는 증거를 정리합니다(Resolve).
이렇게 정리한 증거로 답변용 증거 집합을 만드는 게 마지막 단계(Compose)입니다. System 2 결과가 비면 System 1 원문으로 폴백하기 때문에 파생 레코드가 없어도 답이 완전히 무너지지 않습니다.
학습: 메모리 작성자를 GRPO로 직접 튜닝
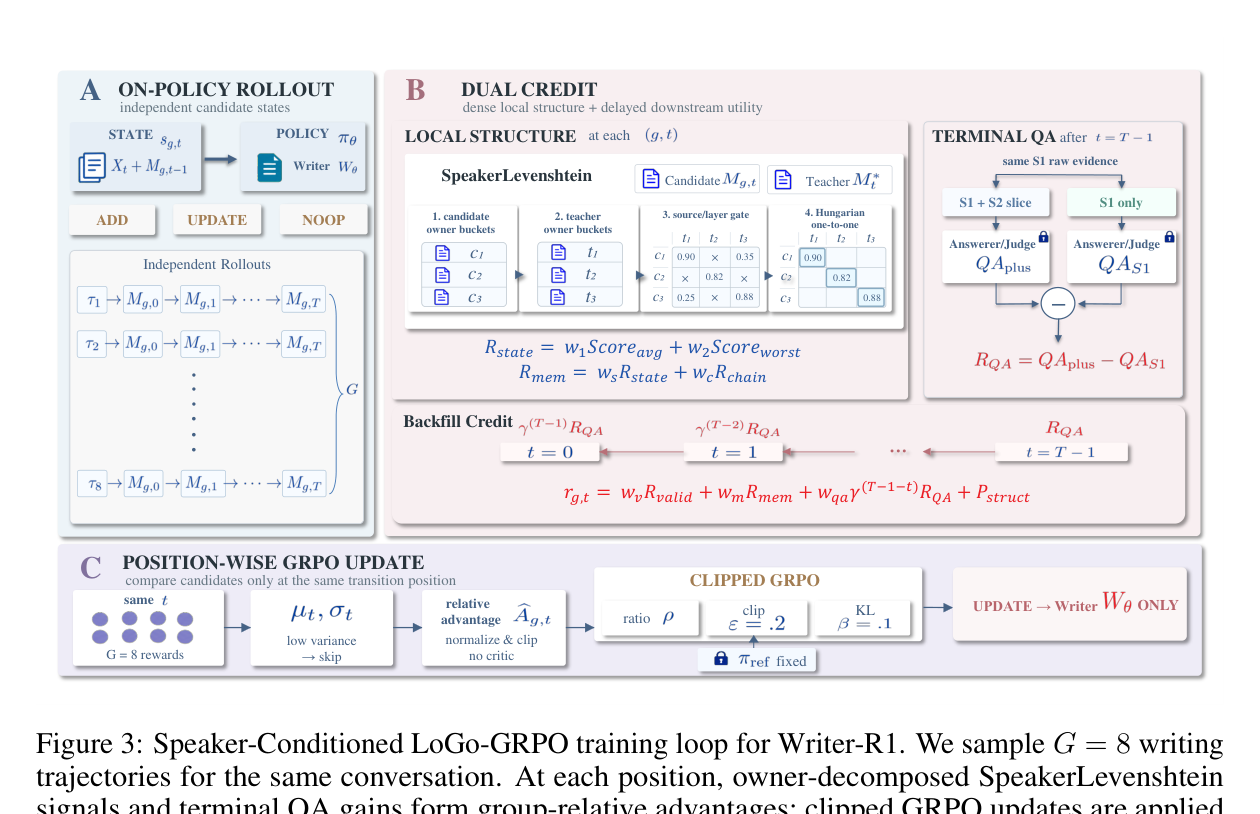
여기까지는 설계 얘기고, 재미있는 부분은 학습입니다. 저자들은 메모리 작성자(Writer)를 3B 소형 모델(Qwen2.5-3B)로 쓰면서 귀속·업데이트 오류를 줄이도록 RL로 직접 학습했습니다. 보상은 두 개입니다.
- SpeakerLevenshtein: 정답 기록과의 텍스트 유사도에 화자 정확도를 반영
- Speaker-Conditioned LoGo-GRPO: 그룹별로 샘플을 묶어 정책을 최적화
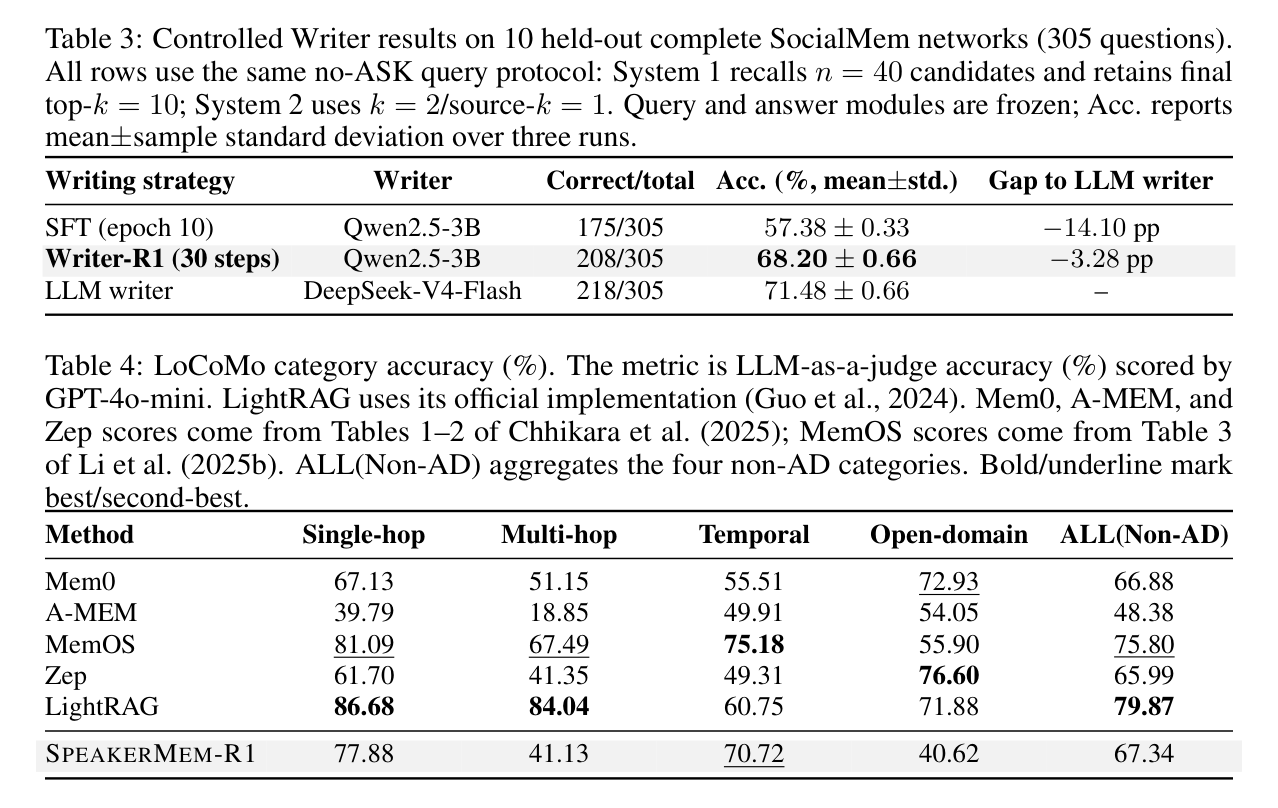
통제 실험(305문항, 쿼리·답변 모듈 고정)에서 결과가 명확합니다.
SFT Writer 57.38% → RL Writer 68.20%, +10.82%p. LLM writer(DeepSeek-V4-Flash, 71.48%) 대비 95.4% 수준까지 따라갑니다. 즉 로컬 배포가 가능한 3B 모델로 대형 LLM writer를 거의 대체할 수 있다는 얘기죠.
결과: 숫자로 보는 성능
주 비교는 DeepSeek-V4-Flash와 GPT-5.6-luna 두 설정에서 진행했습니다. 베이스라인은 BM25, 임베딩 검색, Mem0, A-MEM, HippoRAG, Full context입니다.
| 벤치마크 | SpeakerMem-R1 | 최강 베이스라인 | 차이 |
|---|---|---|---|
| GroupMemBench (745문항) | 47.9 | BM25 44.6 | +3.3 |
| SocialMemBench (1,031문항) | 69.2 | A-MEM 56.8 | +12.4 |
| EverMemBench 전체 (2,400문항) | 61.9 | HippoRAG 48.0 | +13.9 |
| EverMemBench 공개 리더보드 | 62.33 | EverOS 60.08 | +2.25 |
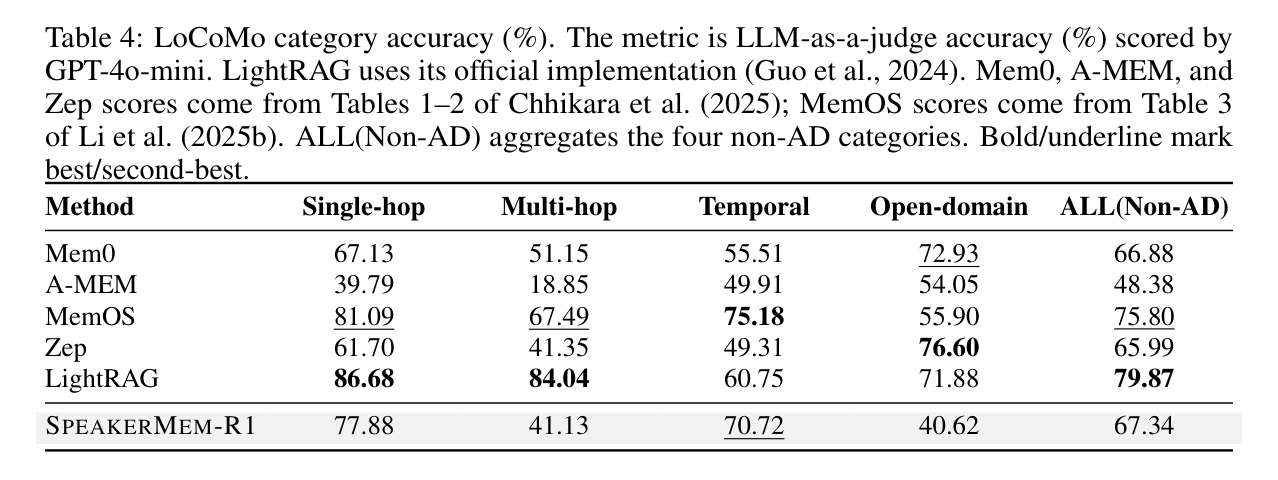
| LoCoMo (1,986문항) | 70.85 | LightRAG 79.87 | −9.02 |
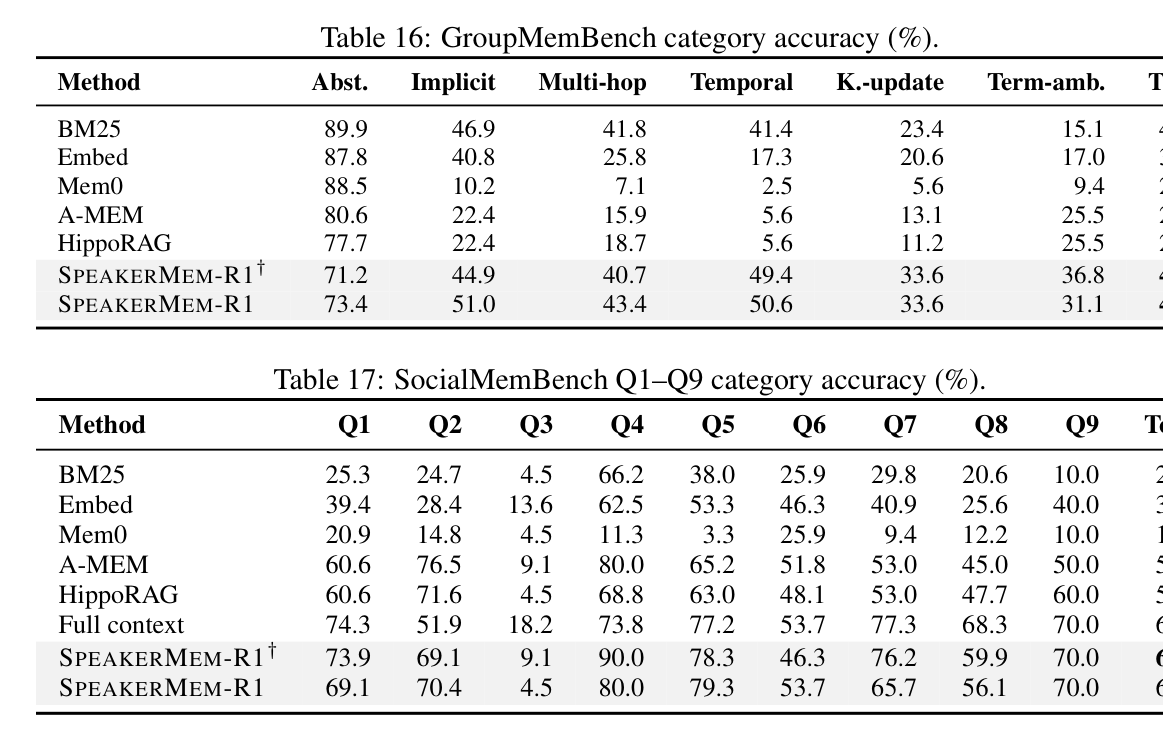
몇 가지 눈에 띄는 지점이 있습니다.
-
GroupMemBench에서 BM25가 이미 44.6%로 꽤 강합니다. 이 벤치마크의 절대 난이도는 높게 봐야 합니다.
-
EverMemBench 공개 리더보드에서는 RippleMem 54.75%, EverOS 60.08%를 제치고 62.33%로 1위를 기록했습니다.
-
LoCoMo(1:1 장기 대화)에서는 LightRAG보다 9점 뒤집니다. 다자간 특화 설계가 1:1에서는 이득이 아니라는 경계 결과로, 저자들도 이 테스트를 “boundary test”라고 부릅니다.
Ablation(Figure 4)에서는 두 트랙 중 하나를 빼면 세 벤치마크 모두에서 정확도가 떨어집니다.
Person 레이어만 또는 Group 레이어만 남겨도 하락합니다. 예컨대 SocialMem에서 S2 전체를 빼면 −14.4%p, verbatim 트랙을 빼면 −26.6%p입니다. 원문 트랙과 구조화 트랙이 서로 보완적이라는 설계 주장이 숫자로 뒷받침됩니다.
한계와 판단
논문 스스로 밝히는 약점도 있습니다. EverMemBench 세부 항목에서 Multi(24.10%), Skill(40.83%), Role(43.88%)은 상대적으로 약합니다. 여러 증거를 묶는 교차 근거, 선호, 역할 귀속은 여전히 열린 문제라는 거죠. RL Writer 실험도 “광범위 도메인 일반화의 증거가 아니다”라고 명시적으로 못박습니다.
내 판단을 정리하면 이렇습니다.
-
다자간 대화 메모리가 필요한 서비스(그룹 챗봇, 회의 에이전트, 커뮤니티 비서)에서는 source/owner 분리 + 이중 트랙이 지금 검증된 가장 실용적인 설계로 보입니다.
-
1:1 위주 워크로드라면 굳이 화자 중심 구조를 가져올 이유가 없습니다. LightRAG 같은 대안이 더 낫습니다.
-
Writer를 소형 모델 RL로 대체하는 레시피는 메모리 시스템 비용 문제에 대한 직접적인 절감 방안이라 다른 에이전트 파이프라인에도 옮겨올 만합니다.
더 실습해보고 싶은 분들께
에이전트 메모리와 하네스 설계를 더 깊게 다루는 자료 두 가지를 추천합니다.
자주 묻는 질문
SpeakerMem-R1은 어떤 문제를 푸나요? 다자간 대화에서 누가 무슨 말을 했고, 그 말이 누구에 관한 것이며, 그룹 상태가 시간에 따라 어떻게 바뀌었는지를 메모리에 보존하는 문제를 풉니다. 일반 요약/검색 메모리가 이 귀속 정보를 잃어버리는 지점이 출발점입니다.
기존 Mem0나 HippoRAG보다 얼마나 나은가요? SocialMemBench에서 A-MEM(56.8%) 대비 +12.4%p, EverMemBench 전체에서 HippoRAG(48.0%) 대비 +13.9%p입니다. 단 GroupMemBench에서는 BM25(44.6%) 대비 +3.3%p로 격차가 작습니다.
메모리 작성에 대형 LLM이 꼭 필요한가요? 아니요. 통제 실험에서 3B Qwen2.5 Writer를 GRPO로 학습해 68.20%로 SFT(57.38%) 대비 +10.82%p 올렸고, DeepSeek-V4-Flash LLM writer(71.48%)의 95.4%에 도달했습니다.
1:1 대화에도 좋은가요? 그렇지 않습니다. LoCoMo에서 70.85%로 LightRAG(79.87%)보다 낮습니다. 다자간 특화 구조가 1:1 장기 대화에서는 이득이 아니라는 경계 결과입니다.