결론 먼저
MemoHarness의 핵심은 이겁니다. 하네스를 6개 제어 차원으로 쪼개서 실행 경험을 쌓고, 테스트 케이스마다 그 경험으로 하네스를 적응시킨다는 것입니다.
같은 베이스 모델(GPT-5.3-Codex), 같은 도구로 Terminal-Bench에서 0.722 → 0.806을 달성했습니다. 테스트 시점에는 라벨도 피드백도 추가 탐색도 없습니다. 캐싱을 활용하면 총 비용은 10.28)보다 낮습니다.
핵심 요약 표
| 항목 | 내용 |
|---|---|
| 논문 | MemoHarness: Agent Harnesses That Learn from Experience (arXiv 2607.14159) |
| 저자 | Yue Huang, Wenjie Wang, Han Bao 외 (Notre Dame, LMU, USC) |
| 핵심 주장 | 하네스 최적화는 점수 검색이 아니라 진단 가능한 경험 축적이어야 한다 |
| 구조 | 6개 제어 차원 + 이중 경험 은행 + 테스트 시간 케이스 적응 |
| 주요 결과 | Terminal-Bench 0.722 → 0.806, LiveCodeBench 0.900 → 0.967, FinanceAgent 0.600 → 0.767 |
| 비용 | 입력 14.18M 토큰 중 13.32M 캐시, 총 $6.89 (기준일 2026-07, 공개 가격 기준) |
| 코드 | https://github.com/HowieHwong/MemoHarness |
문제 정리: 하네스는 하나짜리 전역 설정으로 돌아간다
에이전트 하네스는 베이스 LLM을 실행 가능한 에이전트로 만드는 외부 제어층입니다. 컨텍스트 조립, 도구 인터페이스, 디코딩 파라미터, 오케스트레이션, 메모리, 출력 후처리까지 다 여기에 속합니다.
문제는 이 하네스가 대부분 벤치마크 단위의 단일 전역 설정으로 배포된다는 겁니다. 프롬프트 템플릿 하나, 디코딩 정책 하나를 모든 케이스에 재사용합니다. 평균적으로 강한 하네스도 특정 케이스 유형에는 계속 어긋납니다.
기존 자동 개선 방법은 프롬프트나 파이프라인 같은 더 좁은 대상만 최적화했습니다. Meta-Harness(2026)가 하네스 코드 자체를 탐색 대상으로 다루긴 했는데, 결과물은 훈련 시점에 고정되는 재사용 산출물입니다. 배포 후 케이스별 적응이 없습니다.
구조 1: 6개 제어 차원으로 분해
MemoHarness는 추론의 시간 흐름을 따라 하네스를 여섯 개로 쪼갭니다.
| 차원 | 단계 | 예시 편집 |
|---|---|---|
| D1 Context assembly | 호출 전 입력 구성 | 프롬프트 구조화, 데모 추가, 컨텍스트 압축 |
| D2 Tool interaction | 도구·검색 사용 | 검색 활성화, top-k 설정, 증거 리랭킹 |
| D3 Generation control | 디코딩 설정 | max tokens 증가, 온도 하향, 후보 샘플링 |
| D4 Orchestration topology | 워크플로우 | 단일 호출 → 계획/실행/정제 |
| D5 Memory management | 호출 간 상태 | 상태 유지, 트레이스 요약, 오래된 컨텍스트 제거 |
| D6 Output processing | 호출 후 출력 | 답 추출, 스키마 검증, 폴백 선택 |
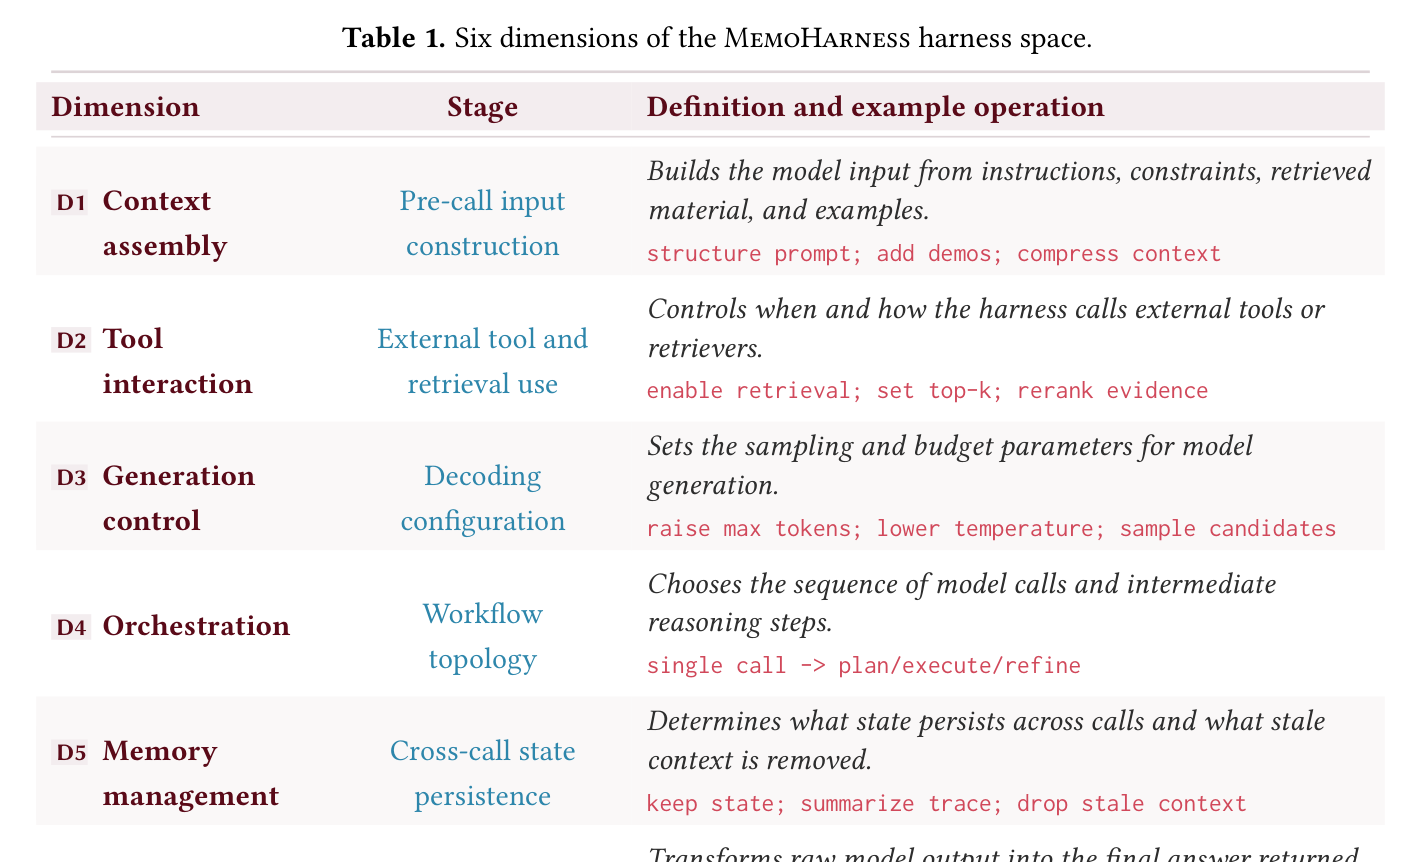
이렇게 나누면 하네스 탐색이 차원별로 구분된 구조화된 편집이 됩니다. 검색 하나를 바꾸면 프롬프트 형식과 디코딩 예산도 함께 바뀌어야 하는 결합 문제를 차원 간 상호작용으로 명시적으로 다룹니다.
구조 2: 이중 경험 은행
탐색 중에 쌓이는 경험은 두 층으로 저장됩니다.
- 케이스 단위 항목: 각 실행의 예측, 도구 트레이스, 토큰 사용량, 지연 시간, 성공 여부, 주 실패 차원(D1~D6 중 하나), 자연어 진단
- 전역 패턴: N번의 탐색 반복마다 실패 클러스터에서 추출된 증류 지식. 무엇이 되고 무엇이 안 되는지, 차원들이 어떻게 맞물리는지 요약
진단 연산자가 실패를 ‘어느 차원 때문인지’로 기록하는 게 핵심입니다. 벤치마크 점수만으론 어떤 하네스 차원이 실패를 만들었는지 알 수 없으니까요.
컨트롤러는 은행 전체를 읽지 않습니다. 케이스 특성, 실패 통계, 차원별 진단에 대한 구조화된 쿼리로 필요한 슬라이스만 검색해 씁니다. 은행이 커져도 컨트롤러 컨텍스트는 제한된 채로 유지됩니다.
구조 3: 테스트 시간 케이스 적응
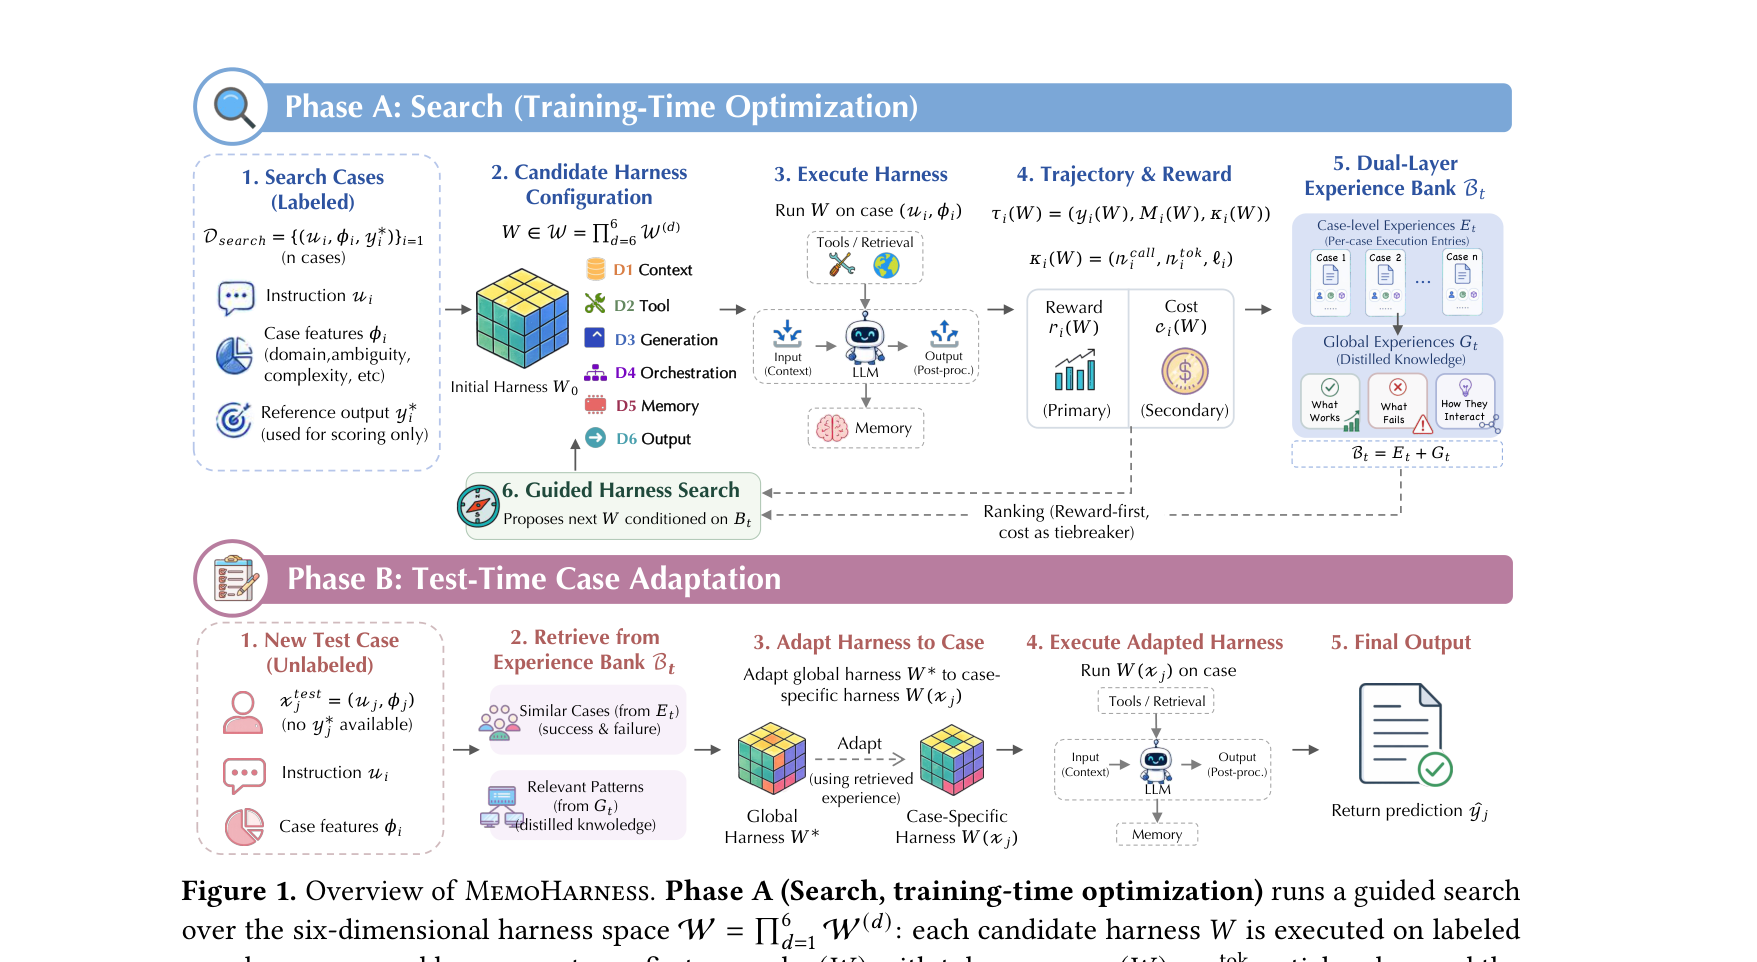
테스트 케이스가 들어오면, 학습된 전역 하네스 W*를 그 케이스용 하네스 W(x)로 한 번 적응시킵니다. 근거는 세 가지 검색에서 옵니다.
- 지시문 표현의 코사인 유사도로 뽑은 유사한 성공 이웃
- 같은 방식으로 뽑은 유사한 실패 이웃
- 특성 조건 검색으로 얻은 전역 패턴 슬라이스
적응에는 테스트 라벨, 피드백, 추가 탐색, 그래디언트 업데이트가 전부 없습니다. 쉬운 케이스는 가볍게 두고, 검색이 필요하거나 다단계인 케이스만 retrieved 경험에 근거해 더 무거운 오케스트레이션을 켭니다.
탐색의 후보 선택은 correctness-first입니다. 평균 태스크 보상을 먼저 최대화하고, 토큰 사용량은 동점일 때의 타이브레이커일 뿐입니다. 싸고 틀린 설정으로 표류하는 걸 막는 장치입니다.
RQ1 베이스라인 비교 결과
| 프레임워크 | 성공률 |
|---|---|
| MemoHarness (GPT-5.3-Codex) | 0.806 |
| Codex | 0.722 |
| Claude Code | 0.556 |
| Terminus | 0.556 |
| OpenCode | 0.361 |
터미널 벤치(Terminal-Bench) 기준입니다. Codex는 이미 터미널 특화 하네스라서 약한 프롬프트 베이스라인이 아닙니다. 그 베이스라인 대비 +0.084를 더 올렸습니다.
RQ2 탐색 반복에 따른 결과 변화
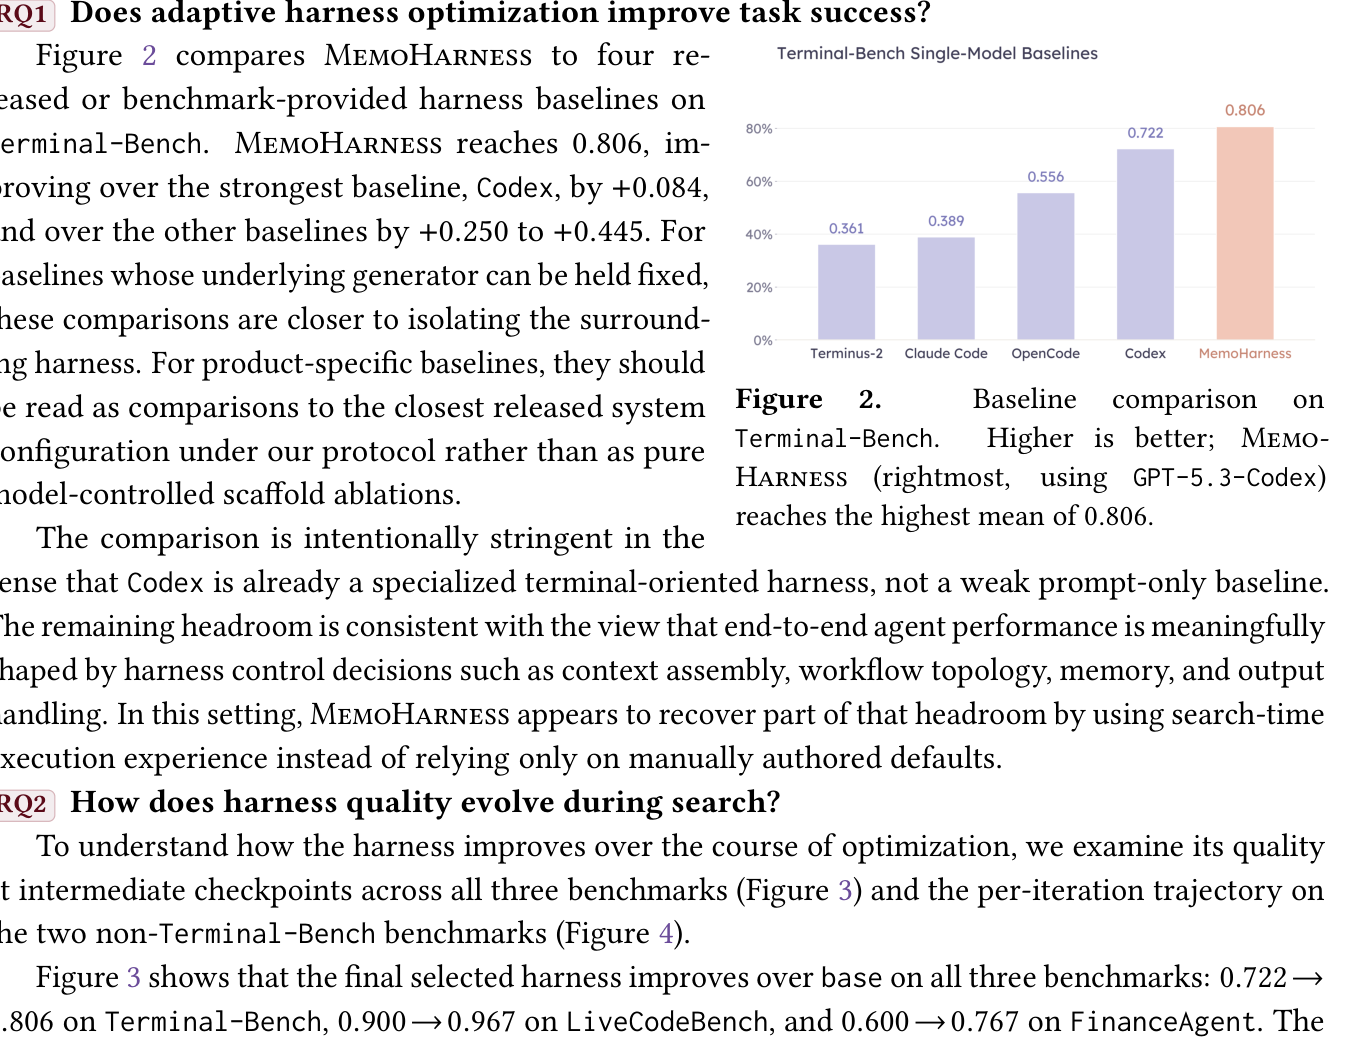
- Terminal-Bench: 0.722 → 0.806
- LiveCodeBench: 0.900 → 0.967
- FinanceAgent: 0.600 → 0.767
FinanceAgent는 10번의 탐색 라운드 동안 42.5%에서 65.0% 피크까지 계속 올랐습니다. LiveCodeBench는 이미 포화 상태라 91.2%–95.0% 밴드에서만 움직였습니다. 하네스 탐색의 수확은 롱호라이즌 에이전트 워크로드에서 가장 큽니다.
최종 체크포인트가 훈련 중 피크보다 낮을 때가 있는데, 검증 기반 선택을 썼기 때문입니다. 테스트 피크를 들여다보지 않는 원칙의 결과입니다.
RQ3 안 본 데이터셋 전이 결과
Terminal-Bench에서 학습한 하네스를 6개 외부 스위트에 적용하면 SWE-Bench Pro +0.059, MMMLU +0.030, StrongReject +0.030입니다. 포화 스위트(HumanEvalFix, Reasoning-Gym-Easy)는 움직임이 없었습니다.
전이는 선택적입니다. 전면적으로 이식되지는 않습니다. 롱호라이즌·도구 중심 탐색 소스에서 가장 강한 전이가 나왔습니다.
RQ4 모델 간 전이 결과
| 모델 | Base | MemoHarness |
|---|---|---|
| GPT-5.3-Codex | 0.722 | 0.806 |
| GLM-5 | 0.500 | 0.733 |
| Gemini-3.1-Pro | 0.611 | 0.694 |
| Qwen3.5-397B-A17B | 0.444 | 0.528 |
| Claude-Sonnet-4.6 | 0.530 | 0.583 |
| GPT-4.1 | 0.500 | 0.538 |
| DeepSeek-V3.2 | 0.333 | 0.444 |
GPT-5.3-Codex로 탐색한 하네스를 재탐색 없이 6개 모델에 그대로 적용해도 전 모델이 개선됐고 평균 +0.098이었습니다. GLM-5에서 +0.233이 최대입니다.
습득된 변경이 모델별 프롬프트 잔존물일 가능성을 낮추는 결과입니다. 이식 가능한 실행 정책일 가능성을 보여줍니다. GPT-4.1의 이득이 +0.038로 작은 건 이미 잘 보정된 모델에 남은 개선 여지가 적어서일 수 있습니다.
RQ5 비용 분석 결과
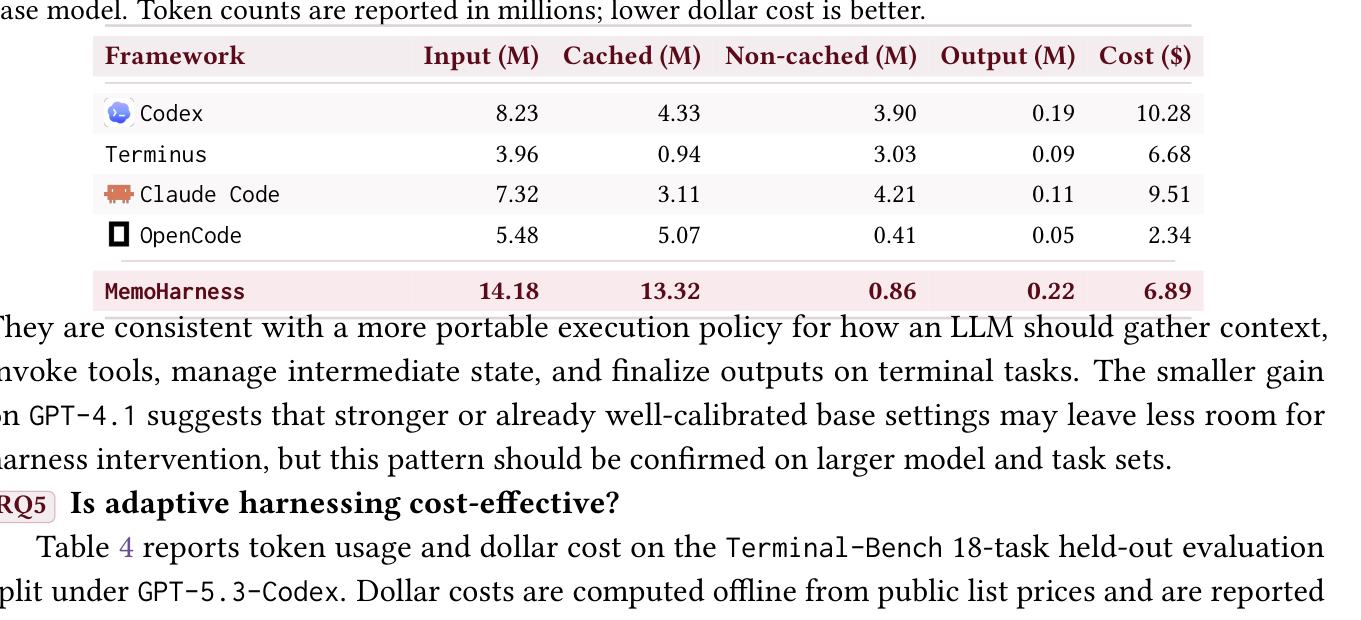
입력 토큰 14.18M 중 13.32M이 캐시 히트입니다. 총 비용 10.28), Claude Code($9.51)보다 낮고 정확도는 더 높습니다.
Terminus(2.34)는 더 싸지만 정확도가 훨씬 낮습니다. 캐싱 가정이 깨지는 배포에서는 비용 프로필이 달라질 수 있다는 게 저자들의 단서입니다.
내 해석
원문 근거와 제 해석을 나눠서 적습니다.
원문이 보여주는 것은 명확합니다. 동결된 베이스 모델 옆에서 제어층만 경험 기반으로 적응시켜도 두 자릿수 퍼센트 포인트급 성공률 변화가 납니다. 모델 스케일링과 수동 하네스 엔지니어링 외에 실용적인 세 번째 축이라는 주장에 숫자가 따라옵니다.
제가 주목하는 지점은 두 곳입니다.
- 진단 연산자의 설계가 실제 배포에서 제일 흔들리는 부분일 겁니다. 어느 차원이 실패를 유발했는지 판별하는 g 연산자가 실용적 휴리스틱으로 구현됐다고 논문이 직접 밝힙니다. 진단이 틀리면 경험 은행에 오염이 쌓입니다.
- 컴포넌트 어트리뷰션이 아직 부족합니다. 경험 은행, 전역 패턴, 케이스 적응을 개별 어블레이션하지 않았다고 한계로 명시돼 있습니다. 어떤 부분이 성능을 내는지 아직 모릅니다.
이전에 정리했던 RRSI(하네스 자기진화의 과적합)나 AutoDesign(메타 하네스 최적화)과 겹치는 지형입니다. 차이는 MemoHarness가 훈련 시점 산출물로 끝내지 않고 테스트 시간 적응을 경험 검색으로 처리했다는 점입니다. 관련 정리: RRSI 논문 정리, AutoDesign 정리
자주 묻는 질문
MemoHarness는 모델 가중치를 바꾸나요?
아니요. 베이스 모델은 동결된 채로 두고 하네스(외부 제어층)만 편집합니다. 그래디언트 업데이트, 파인튜닝이 없습니다.
테스트 시간에 라벨이나 피드백이 필요한가요?
필요 없습니다. 보이는 입력과 탐색 때 쌓은 경험 은행만으로 케이스별 하네스를 한 번 만들어 실행합니다.
기존 프롬프트 최적화와 무엇이 다른가요?
프롬프트(D1)만 다루지 않고 도구, 디코딩, 오케스트레이션, 메모리, 출력 처리까지 여섯 차원을 같이 편집합니다. 점수만 쌓는 게 아니라 어느 차원이 실패를 만들었는지 진단까지 저장합니다.