결론 먼저
에이전트 하네스를 자동으로 진화시키면 진화에 쓴 벤치마크 점수는 오르는데, 처음 보는 벤치마크에서는 그 이득이 사라지거나 시작 하네스보다 못해지는 경우가 생깁니다.
구글 리서치 팀의 RRSI는 이 문제를 하네스 진화의 과적합으로 정의하고, 진화 후보를 만드는 제안 쪽과 채택을 결정하는 선택 쪽에 정규화를 넣어 해결합니다.
결과는 8개 벤치마크에서 진화 스플릿 최대 +14.1점, 처음 보는 OOD 벤치마크 5곳에서 +4.7점이에요.
정규화 없는 진화보다 정책 토큰을 30% 덜 쓰는 하네스가 나왔습니다.
핵심 요약 표
| 항목 | 내용 |
|---|---|
| 논문 | RRSI: Regularized Recursive Self-Improvement of Agent Harnesses (arXiv 2609.24972) |
| 소속 | Google Cloud AI Research, Stanford, UNC, WashU |
| 문제 | 하네스 자동 진화가 유한한 evolve 셋에 적응적으로 과적합 |
| 제안 | 제안부(어닐링 에디트 예산·증거 기반 크레딧·구조화 탐색) + 선택부(누출 스크리닝·안정성 허용·비용 인정·구조 프루닝) |
| 정규화 비유 | L0(에디트 수 제한) / L1(구조 프루닝) / L2(비용 상한) |
| 벤치마크 | 코딩(Terminal-Bench 2.1, SWE-bench Verified), 워크스페이스(Harvey LAB 등), 엔지니어링 설계 |
| 핵심 수치 | evolve 셋 최대 +14.1점, OOD 최대 +4.7점, 토큰 30% 절감 |
| 코드 | github.com/google-research/rrsi |
| 기준일 | 2026-09-23 arXiv v1 기준 |
원문: https://arxiv.org/abs/2609.24972 프로젝트 페이지: https://regularized-rsi.com/
하네스 진화가 재귀적 자기개선인 이유
최근 LLM 에이전트의 성능 향상은 모델 가중치보다 하네스에서 나오는 경우가 많습니다.
하네스는 프롬프트, 제어 흐름, 도구 인터페이스, 메모리, 컨텍스트 관리처럼 고정된 백본 모델을 감싸는 모든 것을 말합니다.
여기에 LLM 제안자를 붙여서 실패 trajectory를 읽고 하네스를 수정하고, 점수가 오르면 채택하는 루프를 돌리면 하네스 수준의 재귀적 자기개선(RSI)이 됩니다.
문제는 이 루프가 같은 유한한 evolve 셋을 반복 적응적으로 재사용한다는 점이에요. 이건 머신러닝의 적응적 데이터 분석에서 경고하는 바로 그 과적합 조건입니다.
논문이 짚은 과적합 경로는 세 가지입니다.
| 과적합 경로 | 내용 |
|---|---|
| 벤치마크 특화 적합 | 태스크 이름·정답 값을 하네스에 직접 인코딩 |
| 노이즈 추격 | 확률적 평가 변동이 만든 행운의 후보를 영구 채택 |
| 복잡도 누적 | 점수만 보느라 비싼 컨텍스트·컴포넌트가 계속 쌓임 |
기존 4개 진화 방법(Meta-Harness, AHE, TTHE, HarnessX)은 evolve 스플릿에서는 잘 나오지만, OOD 평균에서는 시작 하네스 H0보다 낮아지는 사례도 있었습니다. AHE와 TTHE가 그랬고, TTHE는 H0 대비 -1.7점으로 마감했습니다.
RRSI의 설계: 제안과 선택 양쪽에 정규화
RRSI는 하네스의 어떤 컴포넌트든 수정 가능한 열린 에디트 공간은 유지하되, 검색이 그 공간을 통과하는 궤적을 정규화합니다.
제안부 정규화
| 기법 | 정규화 비유 | 동작 |
|---|---|---|
| 어닐링 에디트 예산 | L0 카디널리티 | 후보당 에디트 수를 코사인 스케줄로 b_max→b_min 축소 |
| 증거 기반 크레딧 할당 | 적응적 분석 보정 | 거부된 메커니즘은 음의 증거로 남기고 재시도 억제 |
| 구조화 탐색 | 엔트로피 정규화 | 정체 구간엔 미사용 컴포넌트에 예산 일부 할당 |
초반에는 여러 변경을 묶어 새 메커니즘을 찾고, 후반에는 한 번에 바꾸는 에디트 수를 줄여서 원인 귀속을 쉽게 만드는 구조예요.
선택부 정규화
| 기법 | 정규화 비유 | 동작 |
|---|---|---|
| 누출 스크리닝 | — | critic이 태스크명·정답 인코딩 diff를 평가 전에 거부 |
| 안정성 기반 채택 | — | 베이스 하네스로 잰 노이즈 밴드 δ 이상 요구 |
| 비용 인식 채택 | L2 Ridge | ΔC ≤ β0 + β1·ΔS, 비용 증가는 성과로 정당화 |
| 구조 프루닝 | L1 Lasso | 최근 기여가 없는 컴포넌트를 삭제 후보로 통보 |
누출 후보는 평가 전에 거릅니다. 누출 후보가 높은 evolve 점수를 받으면 이후 라운드가 그 점수에 끌려가니까, 점수 인플레이션이 발생하기 전에 차단하는 겁니다.
실험 결과: 일반화와 효율을 동시에
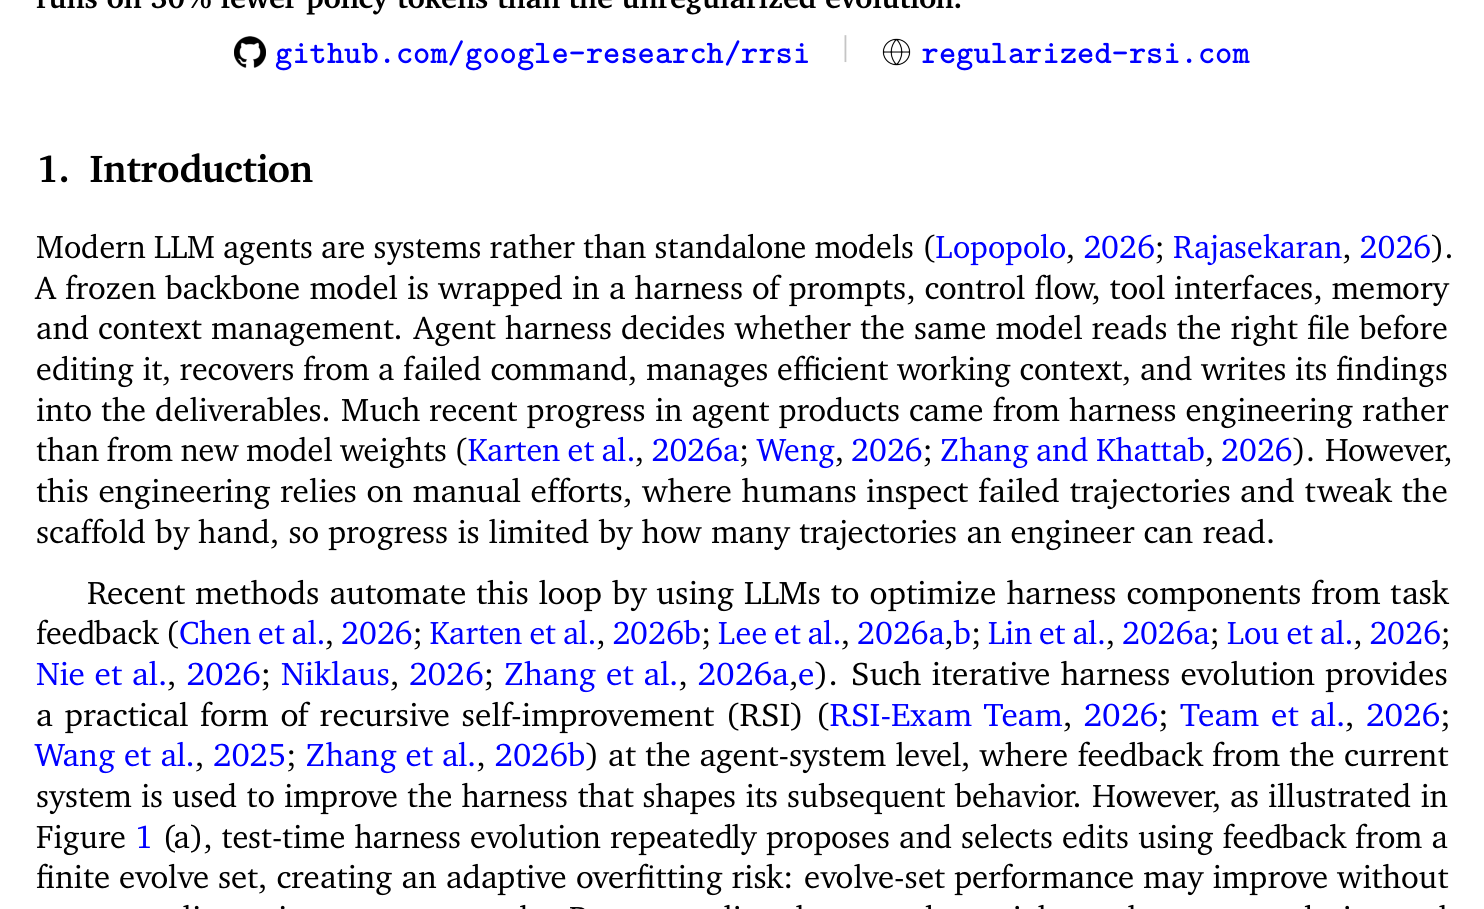
Figure 1이 문제와 결과를 한 장으로 보여줍니다. 기존 방법들은 evolve 스플릿 게인을 OOD로 거의 못 가져가고 일부는 H0 아래로 떨어집니다.
RRSI는 세 도메인 모두에서 모든 헬드아웃 스플릿에서 회귀 없이 상승했습니다.
| 스플릿 | H0 대비 변화 |
|---|---|
| Terminal-Bench 2.1 (evolve) | +6.0 |
| SWE-bench Verified (OOD) | +1.8 |
| Harvey LAB evolve / held-out | +1.1 / +2.3 |
| OOD 워크스페이스 3종 (JobBench·GDPval·APEX-Agents) | +3.5 ~ +4.7 (7.2~13.1%) |
| Frontier-Eng (OOD) | +4.3 Medal (상대 +24.3%) |
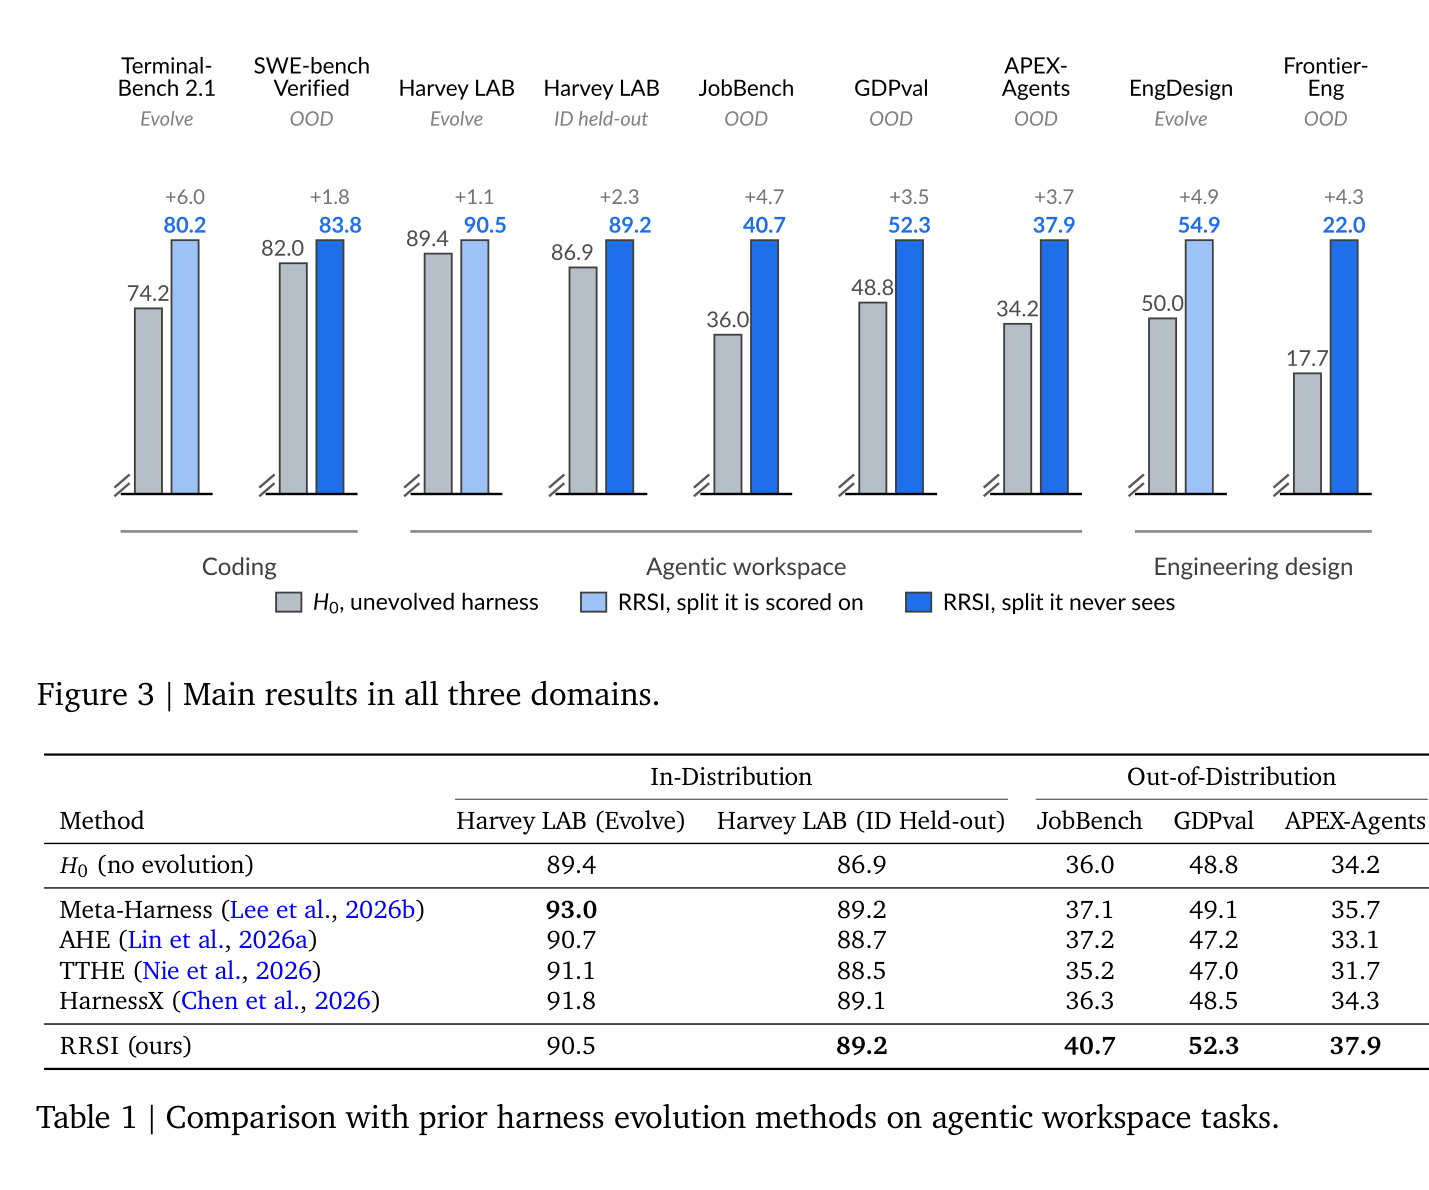
Table 1에서 주목할 부분은 트레이드오프입니다. RRSI는 evolve 셋 게인이 진화된 하네스 중 가장 작은데, OOD 평균만 유일하게 H0보다 1점 이상 오름(43.6 vs 39.7)니다.
진화 스플릿 점수를 낮춰서 얻는 일반화라는 뜻이에요.
어블레이션
제안 제약 제거: evolve -0.2점, OOD -1.7점.
선택 제약 제거: evolve +1.0점, OOD -2.6점, 토큰 비용 1.5배.
둘 다 제거하면 evolve 92.8로 최고점인데 OOD 40.3, 토큰 380만 vs 242만으로 사실상 H0 수준에 머뭅니다. 정규화가 없으면 점수는 진화 셋에만 흡수된다는 직접 증거입니다.
백본 독립성
Gemini 3.5 Flash로 진화한 코딩 하네스를 Claude Opus 4.8에도 동일하게 적용해도 패턴이 유지됐어요.
검색에 쓰지 않은 약한 모델 Gemini 3.1 Flash Lite에 얹으면 Terminal-Bench가 11.2→14.6으로 상대 +30.4% 올랐습니다. 배운 메커니즘이 특정 정책에만 묶인 우연이 아니라고 볼 근거예요.
비용
RRSI 하네스는 242만 토큰/시행, 26.3 스텝으로 진화된 하네스 중 가장 가볍습니다.
가장 비싼 AHE는 382만 토큰(58% 더)을 쓰고도 OOD 4.4점이 낮습니다.
대신 H0(156만 토큰)보다는 비싸니, 진화가 이득의 일부를 테스트 타임 컴퓨트로 산다는 점은 숨기지 않습니다.
기존 글과의 연결
하네스 진화 루프 자체는 이 블로그에서 여러 번 다뤘습니다. 재귀적 하네스 자기개선의 기본 구조는 재귀적 하네스 자기개선 정리에서, 진화 평가 방법의 문제는 하네스 진화 평가 재정의에서 정리한 바 있어요.
RRSI는 이 루프에 일반화 항을 추가한 후속 연구로 읽으면 됩니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
RRSI는 모델 가중치도 수정하나요?
아니요. 백본 정책은 완전히 고정이고, 수정 대상은 하네스(프롬프트·제어 흐름·도구·메모리·컨텍스트 관리)만입니다. 가중치를 함께 바꾸는 설정은 논문 범위 밖입니다.
하네스 진화가 과적합된 건 어떻게 확인하나요?
evolve 셋에서 오른 점수와 별개로, 진화에 쓰지 않은 OOD 벤치마크에 하네스를 그대로 옮겨 실행해서 비교합니다. 기존 4개 방법 중 2개는 OOD에서 H0보다 낮았고, RRSI는 전 스플릿에서 회귀가 없었습니다.
정규화가 진화 성능을 깎지 않나요?
evolve 셋 게인은 오히려 진화된 하네스 중 가장 작습니다. 대신 OOD 평균은 유일하게 H0 +3.9점이고 토큰 비용도 가장 낮습니다. 목표를 재사용 가능한 메커니즘에 두면 이 트레이드가 이득입니다.
도입에 바로 쓸 수 있는 구체적 규칙이 있나요?
네. 누출 critic을 평가 전에 돌리기, 베이스 하네스로 노이즈 밴드 δ 사전 측정, 후보당 에디트 수를 라운드마다 축소, 최근 기여 없는 컴포넌트 삭제 통보. 이 네 가지는 프레임워크 없이도 기존 진화 파이프라인에 붙일 수 있습니다.