결론 먼저
Research팀(신시내티대·펜스테이트·애리조나대)이 OpenClaw 사용자의 Reddit 게시물 73,093건을 21개 인간 가치 × 18개 에이전트 측면 × 9개 결과로 코딩해서, 사용자가 무엇에 만족하고 무엇에 불만을 말하는지 세었습니다. 결론은 이겁니다.
- 사용자 불만은 모델 출력이 아니라 비용, 접근 범위, 기록, 승인 시점, 설치 같은 ‘위임의 조건’에 몰려 있었습니다.
- 결과물을 서술한 게시물에서는 가치 충족이 67.7%였는데, 위험 노출을 서술한 게시물에서는 10.7%에 그쳤습니다.
- 전체 가치 충족률은 54.6%. 감독(supervision) 이야기를 하는 게시물은 여섯 가치 그룹 전부에서 미충족이 다수였습니다.
이 패턴을 저자들은 value-sensitive delegation(가치 민감 위임)이라고 부릅니다. 가치는 에이전트의 산출물보다 위임할 때 사용자가 걸어두는 조건에 실린다는 개념입니다.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | Value-Sensitive Delegation in Everyday AI Agent Use: Evidence from OpenClaw |
| 저자 | Renkai Ma, Ruyuan Wan, Xuan Lu, Fan Yang, Chen Chen, Lingyao Li |
| 소속 | 신시내티대, 펜스테이트, 애리조나대, 사우스캐롤라이나대, FIU |
| 데이터 | Reddit OpenClaw 게시물 73,093건 (RQ1), 결과 코딩 44,767건 (RQ2) |
| 공개 | arXiv 2609.22067, 2026-09 (v1) |
원문: https://arxiv.org/abs/2609.22067
어떤 연구인가
OpenClaw는 2025년 11월 공개된 오픈소스 자율 에이전트로, 2026년 8월 기준 GitHub 스타 37만 개를 넘겼습니다. 사용자 컴퓨터에서 돌며 WhatsApp 같은 채팅 앱으로 작업을 수행하죠. 대화형 어시스턴트와 다른 점은 실행 위치와 검토 시점입니다. 어시스턴트는 패치를 돌려주지만, 에이전트는 사용자가 자리에 없는 동안 대신 행동합니다.
연구진은 Reddit 게시물에서 1인칭 사용 후기만 걸러내고(정밀도 .900, 재현율 .783, F1 .837), GPT-5 mini로 코드북을 적용했습니다. 400게시물 표본에서 사람 코더와 비교해 타당성을 확인했고요. 21개 가치는 6개 그룹으로 묶었습니다.
| 가치 그룹 | 정의 | 대표 가치 |
|---|---|---|
| Dependable Operation | 서비스 유지·복구 | dependability, trust, repairability |
| Autonomous Operation | 사용자 목표와 상태 | autonomy, human welfare, calmness |
| Affordable Operation | 실행이 소모하는 자원 | affordability, resource stewardship |
| Bounded Reach | 접근 허용 범위 | security, privacy, 데이터 주권 |
| Reviewability | 확인·승인·책임 | transparency, 인간 통제, accountability |
| Equitable Access | 누가 쓸 수 있는가 | universal usability, freedom from bias |
상위 가치 5개가 70.8%
자주 언급된 가치는 뚜렷하게 몰려 있었습니다.
| 가치 | 비중 |
|---|---|
| autonomy | 19.9% |
| dependability | 19.8% |
| affordability | 14.0% |
| resource stewardship | 8.9% |
| universal usability | 8.3% |
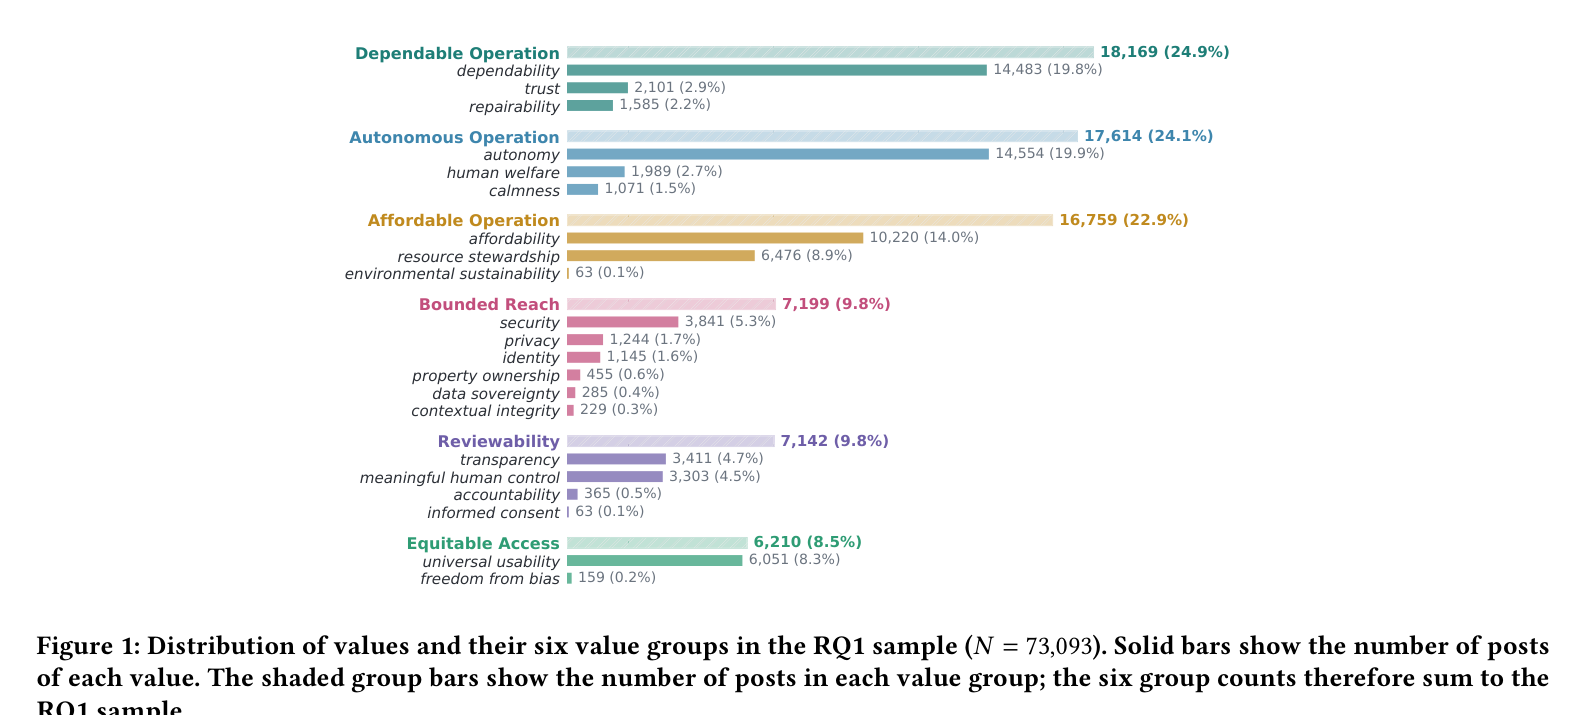 Figure 1. 21개 가치와 6개 그룹의 분포. 출처: 논문 Figure 1.
가치는 ‘실행 조건’ 측면에 몰린다
가치 그룹과 에이전트 측면의 연관은 강했습니다(χ²(85)=94,536.8, Cramér’s V=.509). 어디에 몰리느냐가 핵심인데요.
- Affordable Operation 게시물의 54.4%가 resource accounting에 붙었고, resource accounting 게시물의 96.1%가 Affordable Operation이었습니다. 비용은 거의 오직 비용 문맥에서만 언급됩니다.
- Bounded Reach는 environment access에서 기대치의 5.7배, Reviewability는 observability 8.6배·human oversight 9.2배 과대 대표.
- 반면 모델 코어는 코퍼스에서 가장 흔한 측면(26.4%)이지만, 어떤 그룹에서도 과대 대표되지 않았습니다(O/E 1.5 이하).
즉 사용자 이야기의 무게중심은 얼마가 들고, 어디까지 닿고, 언제 물어보는지 쪽으로 쏠려 있었습니다. 모델이 똑똑한지 자체는 상대적으로 덜 언급됐구요.
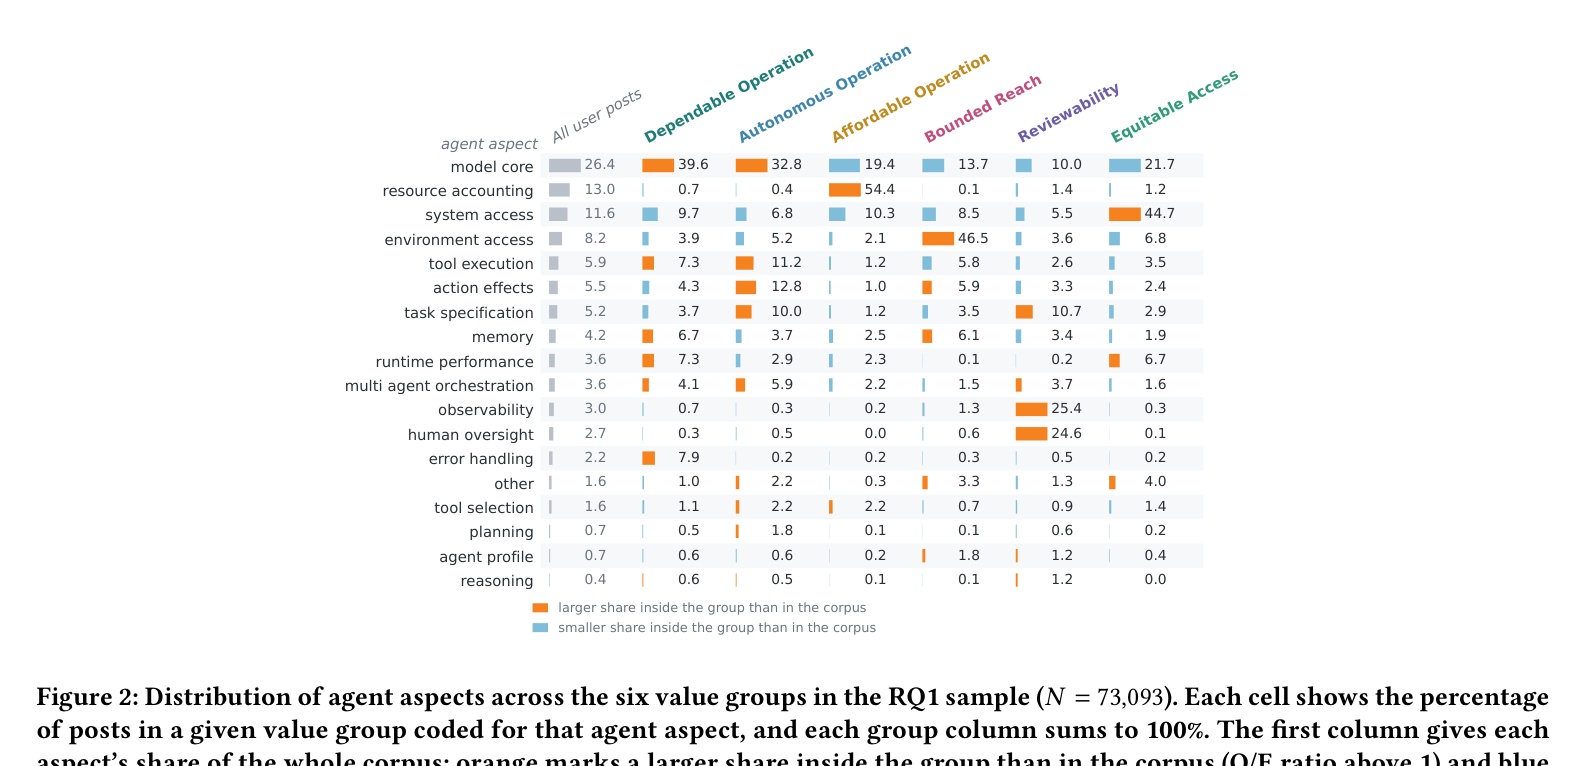 Figure 2. 가치 그룹별 에이전트 측면 분포. 주황색은 코퍼스 전체보다 비중이 큰 칸. 출처: 논문 Figure 2.
충족률: 그룹 간 최대 34.5pp 격차
전체 가치 충족률은 54.6%(미충족 45.4%)였습니다.
| 가치 그룹 | 충족률 |
|---|---|
| Autonomous Operation | 77.3% |
| Reviewability | 53.9% |
| Affordable Operation | 47.9% |
| Dependable Operation | 46.9% |
| Bounded Reach | 44.4% |
| Equitable Access | 42.8% |
에이전트 측면으로 보면 극단이 분명합니다. action effects 72.4%, tool execution 69.0% 충족인데 resource accounting는 35.3%로 18개 측면 중 최저였습니다.
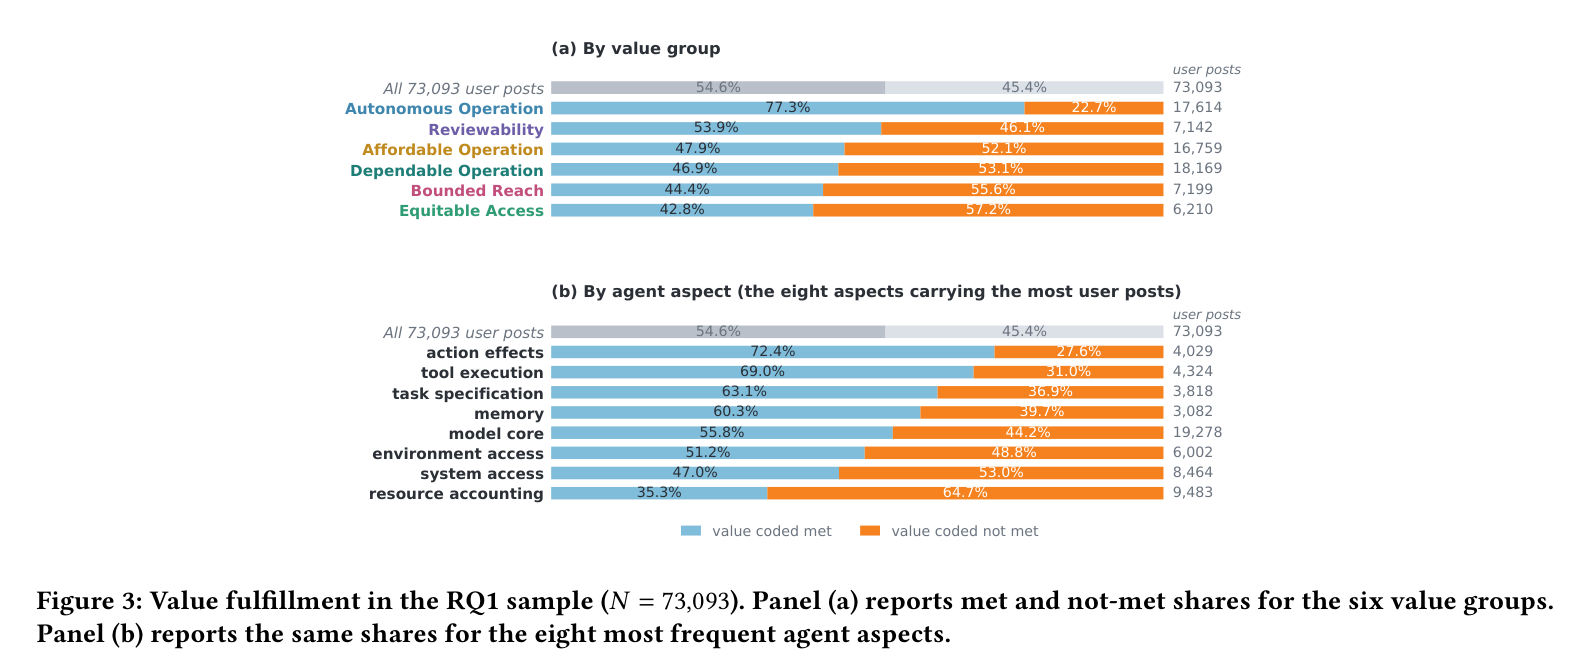 Figure 3. 가치 충족률. (a) 그룹별, (b) 에이전트 측면별. 출처: 논문 Figure 3.
RQ2(44,767건)에서 방향이 갈립니다. task effectiveness 게시물의 가치 충족은 67.7%인데, resource burden 게시물은 34.7%, risk exposure 게시물은 10.7%였습니다. ‘에이전트가 해냈다’는 이야기와 ‘감시 비용’ 이야기는 별개의 축이라는 뜻입니다.
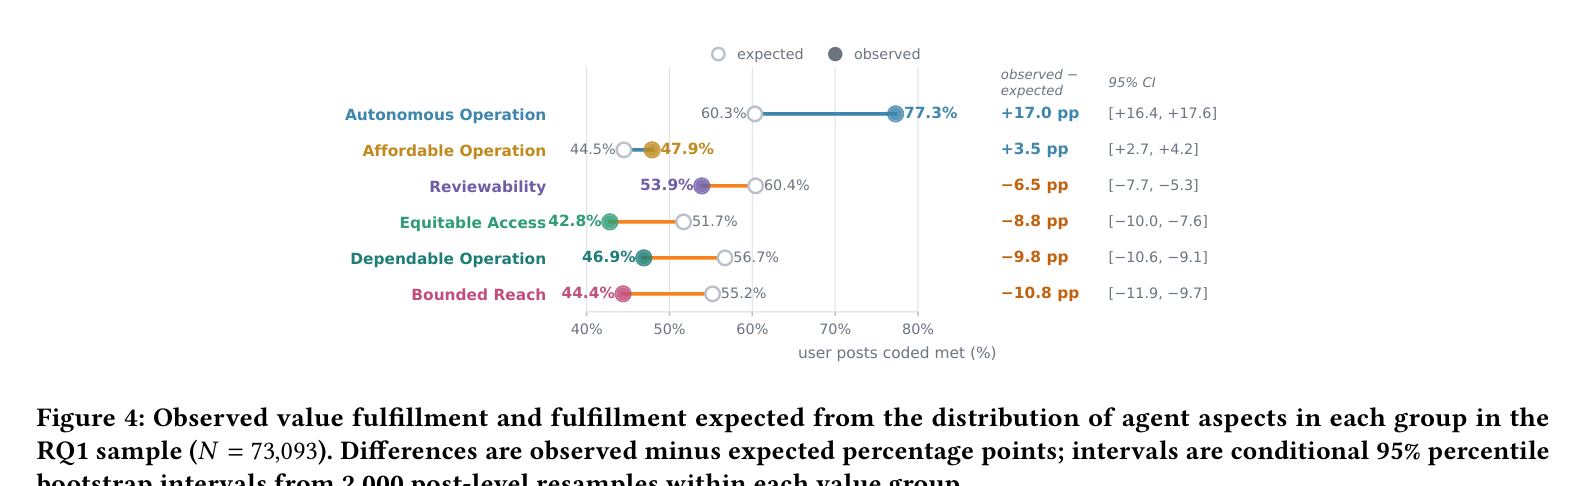 Figure 4. 관측 충족률과 기대 충족률 비교. Autonomous Operation은 +17.0pp, Bounded Reach는 −10.8pp. 출처: 논문 Figure 4.
사용자 인용에서 나오는 패턴
논문이 인용한 게시물 원문 중 핵심만 옮깁니다.
- 비용: 하루 48회 heartbeat로 일정을 조용히 확인하는 에이전트가 Sonnet 요금으로 과금된 사례. 작업을 시킨 적 없는데 ‘준비 상태’ 자체가 과금이었습니다. 다른 사용자는 ‘hello’ 한 줄에도 전체 시스템 프롬프트가 주입된다며 토큰 구조를 지적했습니다.
- 신뢰: 무료 모델은 “실패를 크게 알리지 않고 ‘조용히 stub을 배송‘“한다는 관찰. 완료된 실행과 빈 실행이 똑같이 보여서 검증을 사용자가 다시 가져가게 됩니다.
- 감독: “내가 시킨 일인데 왜 계속 권한을 요청하냐”는 불만, 헤드리스 노드에서 승인 다이얼로그가 아예 안 뜨는 문제. 게이트가 있긴 한데 닿을 수 없는 위치에 있는 셈입니다.
- 생존하는 세팅: “살아남는 세팅은 그 사람이 에이전트가 하는 일을 한 문장으로 설명할 수 있는 세팅”이라는 정리.
감독 관련 불만의 공통점은 ‘볼 수 있느냐’보다 ‘실행 중에 대답을 요구당하느냐’였습니다. 실행 전후의 검사는 부담이 없고, 실행 중의 승인 요구는 중단으로 느껴집니다.
에이전트 평가에 대한 시사점
- 벤치마크 태스크 성공률은 이 데이터의 불만 지점 대부분을 커버하지 못합니다. 비용 가시성, 접근 경계, 감독 지점 설계가 사용자 경험을 갈랐습니다.
- ‘신뢰’와 ‘의존’을 분리 측정해야 한다는 기존 HCI 논의를 에이전트 평가로 가져와야 합니다.
- 평가 단위를 ‘위임 조건(조건 설정 + 결과 회수)‘까지 확장하는 게 이 논문의 제안입니다. 실행 조건은 결국 하네스가 다루는 영역이라, 하네스·루프 설계와 직결된다고 봅니다.
더 실습해보고 싶은 분들께
에이전트 위임 조건(비용 상한, 접근 범위, 감독 지점)을 직접 설계해보고 싶다면:
자주 묻는 질문
Q: 어떤 데이터를 분석했나요? Reddit의 OpenClaw 1인칭 사용 게시물 73,093건입니다. 이 중 결과 귀속이 가능한 44,767건을 결과 분석(RQ2)에 사용했습니다.
Q: 가장 불만이 많았던 지점은 어디인가요? 가치 충족률이 가장 낮은 에이전트 측면은 resource accounting(35.3% 충족)이었습니다. 결과 유형으로는 위험 노출 게시물의 충족률이 10.7%로 최저였습니다.
Q: 모델 성능이 가장 큰 문제였나요? 아니요. 모델 코어는 가장 흔한 언급 대상(26.4%)이지만 어떤 가치 그룹에서도 과대 대표되지 않았습니다. 비용, 접근, 감독 같은 실행 조건 쪽에 가치가 몰렸습니다.
Q: value-sensitive delegation이 무엇인가요? 사람의 가치는 에이전트의 출력보다 사용자가 위임할 때 걸어두는 조건(비용, 접근, 기록, 승인 시점)에 실려 나타난다는 개념입니다.
Q: 사용자 만족도는 어느 정도인가요? 전체 가치 충족률은 54.6%였고, 그룹별로는 77.3%(Autonomous Operation)부터 42.8%(Equitable Access)까지 분포했습니다. 기준일은 2026-09-21, arXiv v1 기준입니다.