결론 먼저
멀티 에이전트 LLM 워크플로우의 토큰 비용에는 숨은 항목이 하나 있습니다. 각 노드가 메모리에서 컨텍스트를 꺼내 프롬프트에 넣을 때, 그 토큰이 시스템 프롬프트와 같은 입력 토큰 단가로 청구된다는 겁니다. LangSmith나 Phoenix 같은 관측 도구는 입력 토큰을 하나의 숫자로만 보여주기 때문에 이 비용이 분리되어 보이지 않습니다.
TCA(Total Cost of Agency) 논문(arXiv 2609.23790)은 이 비용을 정확히 분리해서 측정하는 방법을 제안합니다. 200개 엔터프라이즈 태스크 벤치마크에서 메모리 주입은 최적화 가능한 변동 비용의 13.6%, 전체 청구액의 약 12%를 차지했고, 워크플로우 깊이가 깊어지면 비중이 27.6%까지 올라갑니다. 그리고 검색 창 크기를 32에서 2로 줄이면 주입 토큰이 28.7% 줄어듭니다.
핵심 요약 표
| 항목 | 내용 |
|---|---|
| 논문 | Total Cost of Agency: Exact Attribution of Memory Injection Cost in Multi-Agent LLM Workflows (arXiv 2609.23790) |
| 핵심 문제 | 메모리 주입 토큰이 입력 토큰으로 청구되는데 관측 도구가 이를 분리해 보여주지 않음 |
| 제안 | TCA 5분해 + 2패스 정확 토큰 계측법 |
| 주요 수치 1 | 메모리 주입 = 변동 비용의 13.6%, 전체 청구액의 약 12% |
| 주요 수치 2 | 주입 비중이 깊이 1에서 0%(구조적 0) → 깊이 6에서 27.6%로 상승 |
| 주요 수치 3 | 검색 창 32→2 엔트리로 주입 토큰 28.7% 감소 |
| 계측 비용 | 노드당 약 10ms 추가, 청구 없음(토크나이저 카운트만) |
| 벤치마크 | 200 엔터프라이즈 태스크, 5카테고리 x 깊이 2~6, 실제 API 호출 |
| 기준일 | 2026-09-20 (v1) |
문제의 정체
4노드짜리 청구 정합 워크플로우를 생각해보면 됩니다. 플래너가 쿼리를 분해하고, 추출·쿼리 생성·정합·정책 확인 노드가 각각 모델을 호출합니다.
팀들이 비용 최적화라고 하면 모델 티어 선택만 봅니다. 싼 모델을 쓰다가 필요할 때 비싼 모델로 올리는 식이죠. 이건 옳은 접근이고, 동시에 절반만 본 겁니다. 모든 노드는 추론 전에 메모리에서 컨텍스트를 꺼내 프롬프트에 넣습니다. 그 토큰이 전부 입력 단가로 청구됩니다. 앞 노드의 출력을 전부 carrying하는 워크플로우라면 마지막 노드는 자기 출력을 하나 만들기 전에 체인 전체의 누적 컨텍스트를 주입받습니다.
측정 장벽은 이겁니다. 관측 도구가 콜의 입력 토큰을 하나의 숫자로 보고합니다. 노드가 생성한 토큰과 노드가 넘겨받은 토큰의 구분이 존재하지 않는 거죠. 표준 스택 어디에도 그 숫자를 계산하는 도구가 없습니다.
TCA: 비용을 5개로 쪼개기
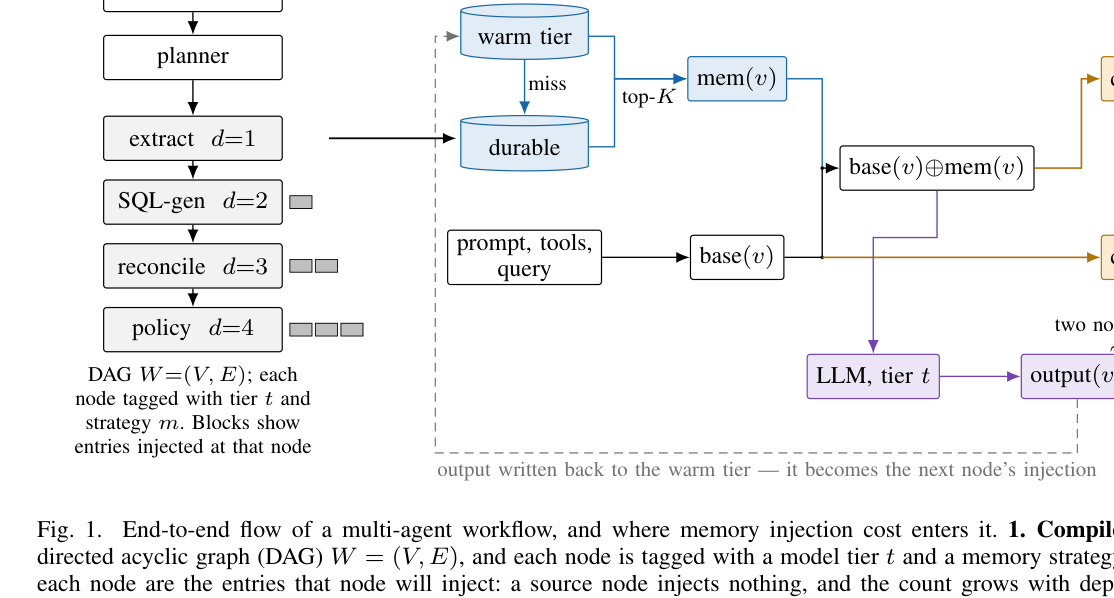
그림 1. 컴파일-실행-회계 3단계에서 주입 토큰이 어디서 발생하는지(원문 Fig. 1, arXiv 2609.23790)
논문은 워크플로우 비용을 노드별로 다섯 항으로 분해합니다.
| 항목 | 내용 | 과금 |
|---|---|---|
| C_base | 시스템 프롬프트, 툴 정의, 사용자 쿼리 | 모든 노드에서 과금 |
| C_inf | 노드가 생성하는 출력 토큰 | 모든 노드에서 과금 |
| C_inject | 메모리에서 꺼내 주입한 토큰 | 모든 노드에서 과금 |
| C_miss | warm-tier 미스 시 durable 스토어 폴백 페널티 | 원격 과금 스토어를 쓸 때만 |
| C_accum | 업스트림 컨텍스트를 carrying하는 비용 | C_inject와 함께 측정됨 |
핵심은 C_inject입니다. 주입 토큰은 노드가 실행되는 티어의 입력 단가에 비례하기 때문에, 같은 주입 컨텍스트도 비싼 티어에서는 더 비쌉니다. 그래서 주입 비용은 항상 어떤 티어에서 나왔는지와 함께 읽어야 합니다.
이 벤치마크에서는 C_miss와 C_accum이 구조상 0입니다. durable 스토어가 로컬라 미스가 지연만 만들고 토큰 비용이 없거든요. 논문은 이렇게 어떤 항이 왜 0인지 명시적으로 밝히는 방식을 씁니다.
2패스 계측: 정확하고 공짜인 방법
기존 연구들은 carried context를 단어 수나 글자 수로 추정했습니다. 서브워드 토크나이저는 단어 경계와 다르게 자르기 때문에 이런 근사는 내용에 따라 오차가 계속 변합니다. 식별자, 숫자 리터럴, 구조화 출력은 산문과 완전히 다르게 토큰화되는데 엔터프라이즈 에이전트 출력은 대부분 그런 겁니다.
논문의 방법은 단순합니다. 각 노드에서 프롬프트를 두 번 조립합니다.
- base 컴포넌트만으로 한 번
- 메모리 포함해서 한 번
둘 다 프로바이더의 토크나이저로 세고 차이를 주입 토큰으로 귀속합니다. 카운트는 인퍼런스가 없는 논-빌링 API 호출이라 돈이 안 들고, 노드당 약 10ms밖에 안 걸립니다. 추론 지연이 80~3000ms인 걸 생각하면 측정 오버헤드가 거의 없는 수준입니다.
프롬프트 조립 단계를 데코레이터로 감싸면 되니까 워크플로우 구조 변경도 필요 없습니다. 첫 번째 카운트에서 C_base도 같이 나오니까 하나의 계측점으로 주입량과 분모를 둘 다 얻습니다.
수치로 보는 주입 비용
200 태스크, 미드 티어, 미최적화 베이스라인에서 태스크당 분해는 이렇습니다.
| 항목 | 태스크당 비용 |
|---|---|
| 추론 (C_inf) | $0.020408 |
| 메모리 주입 (C_inject) | $0.003220 (변동 비용의 13.6%) |
| 베이스 프롬프트 (C_base, 도출값) | $0.003699 |
전체 청구액 기준으로는 주입이 약 11.8~12%입니다. 베이스 프롬프트가 1,233 토큰, 주입이 1,073 토큰으로 크기가 비슷하구요.
깊이에 따른 변화가 더 흥미롭습니다.
| 깊이 | 주입 토큰/태스크 | 비용 비중 |
|---|---|---|
| 1 | 0 (구조적 0) | 0% |
| 2 | 143 | 8.4% |
| 3 | 324 | 상승 |
| 4 | 466 | 상승 |
| 5 | 602 | 상승 |
| 6 | 754 | 27.6% |
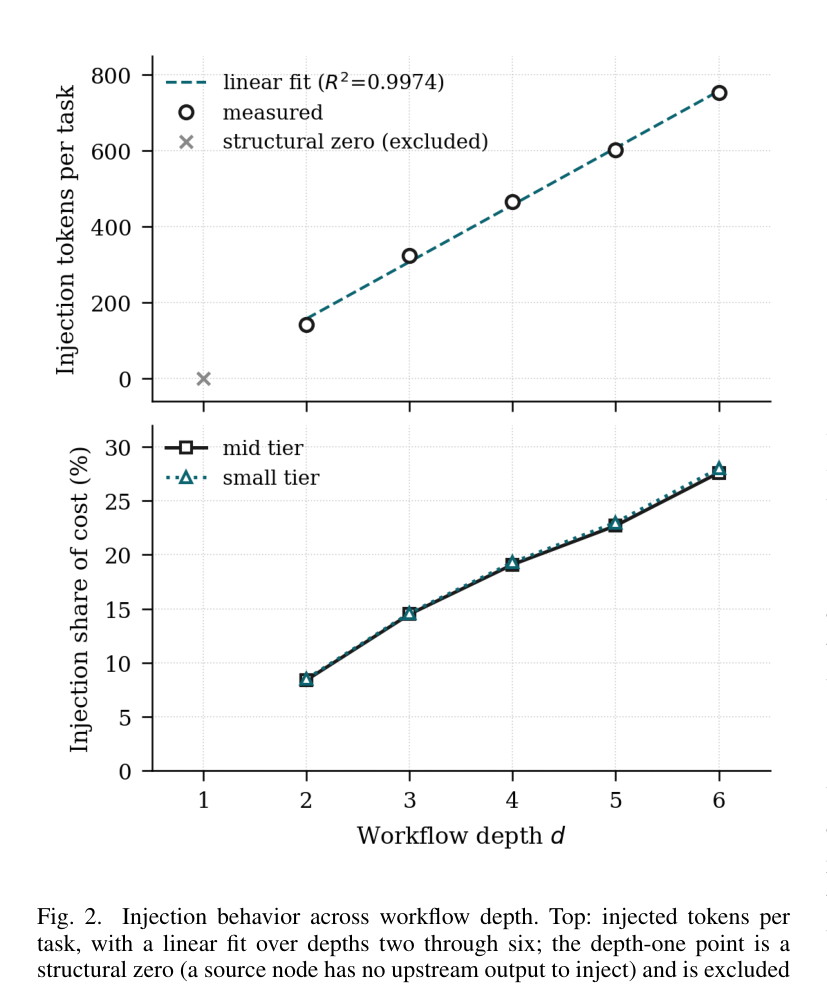
그림 2. 깊이 2~6에서 주입 토큰의 선형 증가와 비용 비중 상승(원문 Fig. 2, arXiv 2609.23790)
깊이 2~6에서 선형 피팅이 R²=0.9974, 기울기는 깊이 1당 약 150 토큰입니다. 이차 피팅의 선행 계수는 오히려 음수라서 이 범위에서는 볼록 증가도 아닙니다. 검색 창(K)이 노드당 주입을 제한하기 때문에 카운트는 선형으로 자라는 겁니다.
검색 창이 진짜 레버
이 논문에서 유일하게 “메모리 메커니즘 효과”로 읽을 수 있는 비교가 검색 창 실험입니다. 티어 배정을 고정하고 K를 32에서 2로 줄이면:
- 평균 주입 토큰: 1,074 → 766 (28.7% 감소)
- 태스크당 비용: 0.006939 (6.7% 감소)
티어가 같으니 주입 토큰의 단가도 같습니다. 그래서 28.7% 감소는 순수하게 메모리 메커니즘 덕분이라고 귀속할 수 있습니다. 논문의 다른 실험들에는 이 성질이 없습니다.
정확도는 0.600에서 0.570로 떨어졌는데, 단일 시드 조건 간 변동 폭(0.575~0.645) 안에 있어서 논문도 이걸 측정된 정확도 비용으로 읽지 않습니다. 다만 창을 조이면 결국 나중 노드가 필요한 엔트리를 밀어낸다는 긴장의 방향과 크기는 보여줍니다. 트레이드오프의 무릎이 어디인지는 안 재졌고요.
안 통한 것들
논문이 좋은 건 안 된 걸 그대로 보고하기 때문입니다.
- 그래프 재작성 변환(노드 융합, 재정렬, 공유 네임스페이스 승격)은 개별적으로 비용 중립적이었습니다. 스몰 티어에서 8개 조건이 1% 안에 몰려 있어요. 컨텍스트가 어디로 가는지만 바꿀 뿐 총량은 안 줄입니다.
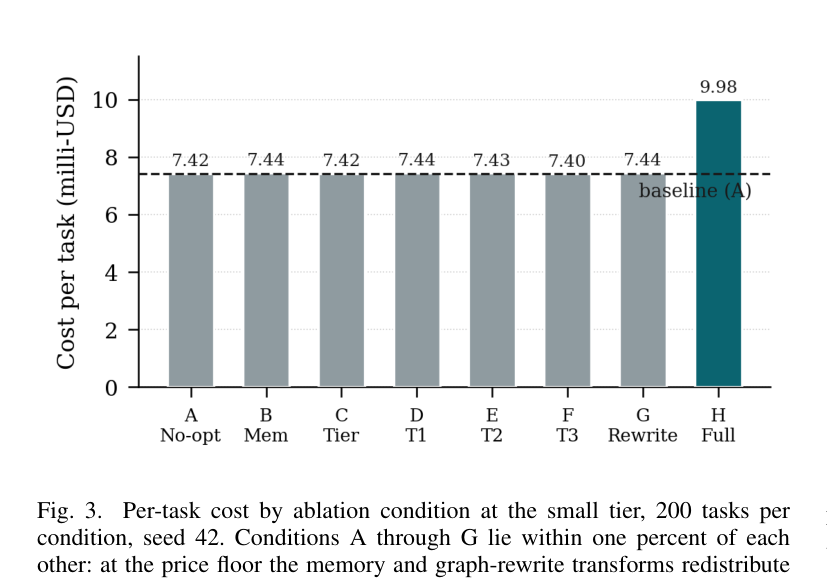
그림 3. 스몰 티어 8개 조건의 태스크당 비용. A~G는 1% 안에 몰림(원문 Fig. 3, arXiv 2609.23790)
- 전체 시스템(Condition H)은 최저 티어에서 오히려 베이스라인보다 비쌌습니다. 아래로 갈 티어가 없으니 티어 어사이너가 위로만 올릴 수 있기 때문입니다.
- 총 비용을 움직이는 가장 큰 레버는 어느 모델을 쓰느냐, 즉 티어 배정이었습니다. 이건 라우팅 선행 연구(FrugalGPT, RouteLLM, MasRouter)의 영역이고 논문은 이를 고정해두고 벗어나지 않습니다.
프롬프트 캐싱은 왜 못 피하는가
캐시된 입력 토큰은 약 0.1배로 할인되니 “캐시하면 되는 거 아니냐”가 자연스러운 반론입니다. 논문은 안 측정했다고 명시하면서도 구조적으로 주입 메모리가 캐싱에 불리한 이유 4가지를 듭니다.
- 캐시 히트는 바이트 동일한 프리픽스가 필요한데, 주입되는 메모리는 현재 태스크 안에서 만들어진 업스트림 출력이라 첫 주입은 항상 write입니다.
- 시스템 레벨 변경이 그 아래 메시지 레벨을 무효화합니다. 노드마다 다른 전문 시스템 프롬프트를 쓰면 한 노드의 메모리가 다른 노드에서 캐시 히트가 안 됩니다.
- 캐시 가능한 최소 프리픽스 길이가 스몰 티어의 태스크당 주입 컨텍스트보다 클 수 있습니다.
- 캐시에 쓰고 0번 읽으면 안 쓰는 것보다 비쌉니다. 팬아웃 그래프에서 나이브 캐싱은 비용을 올립니다.
이건 논증이지 측정이 아니고, 모든 수치는 uncached 기준입니다.
내 해석
정리하면 이렇습니다.
- 이 논문은 “메모리 주입이 최대 비용 항목”이라고 주장하지 않습니다. 추론이 모든 깊이에서 지배적이고 베이스 프롬프트도 비슷한 크기입니다. 주목할 이유는 비용이 워크플로우 구조(깊이)에 비례해서 자라는 유일한 항이라는 점입니다.
- 2패스 계측은 바로 베껴 쓸 수 있습니다. 프롬프트를 명시적으로 조립한 뒤 디스패치하는 어떤 프레임워크에도, 토크나이저를 공개한 어떤 프로바이더에도 적용됩니다. 노드당 10ms, 0원입니다.
- 멀티 에이전트 비용 리포트에 “주입 토큰” 컬럼을 추가하는 것만으로 최적화 대상이 하나 생깁니다. 그리고 그 레버(검색 창 크기)는 이미 존재하는 파라미터입니다.
한계도 분명합니다. 단일 프로바이더, 단일 프레임워크, 고정 토폴로지 DAG만 측정했습니다. ReAct 같은 루프는 잴 수 없는데, 루프는 반복 수만큼 깊이가 커지므로 실제로는 주입 비중이 더 클 거라고 논문 자체가 예상합니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
메모리 주입 비용이란 정확히 무엇인가요?
멀티 에이전트 워크플로우에서 각 노드가 추론 전에 메모리에서 꺼내 프롬프트에 넣는 토큰입니다. 이 토큰은 시스템 프롬프트와 같은 입력 단가로 청구되지만, 일반 관측 도구는 생성한 토큰과 넘겨받은 토큰을 구분해 보여주지 않아 비용이 안 보입니다.
2패스 계측은 비용이 얼마나 드나요?
프롬프트를 메모리 포함/미포함으로 두 번 조립해 토크나이저로 세는 방식입니다. 카운트 호출은 인퍼런스가 없어 과금되지 않고, 노드당 약 10ms가 추가됩니다. 추론 지연 80~3000ms 대비 무시 가능한 수준입니다.
주입 비용은 워크플로우가 깊어지면 어떻게 되나요?
깊이 2에서 143토큰/비용 비중 8.4%에서 시작해 깊이 6에서 754토큰/27.6%까지 단조 상승합니다. 깊이 2~6에서는 선형 증가(R²=0.9974, 깊이당 약 150토큰)이고 검색 창이 노드당 주입을 제한하기 때문입니다.
검색 창을 줄이면 정확도가 떨어지나요?
32에서 2로 줄이면 주입 토큰은 28.7% 줄고 정확도는 0.600에서 0.570로 움직였습니다. 이 차이는 단일 시드 변동 폭 안에 있어 확정적이지 않습니다. 다만 창을 너무 조이면 필요한 엔트리가 밀려나는 트레이드오프 자체는 존재합니다.