핵심 요약
메모리를 가진 LLM 에이전트를 강화학습으로 학습하면 문제가 하나 생깁니다. 롤아웃마다 메모리에 다른 걸 쓰기 때문에, 나중에 같은 그룹으로 보상을 비교하면 서로 다른 환경에서 나온 trajectory를 같은 환경처럼 비교하게 됩니다. GRPO의 전제가 깨지는 거죠.
Memory-R2 논문(arXiv 2605.21768)은 이 문제를 로컬 리롤아웃으로 풉니다. 같은 중간 메모리 상태에서 다시 굴려서 세션 단위로 공정하게 비교하는 방식입니다. LoCoMo 벤치마크에서 전체 F1을 43.14(Memory-R1)에서 50.60으로 올렸고, 학습 대화 2개만 써서 이 성능을 냈습니다.
핵심 요약 표
| 항목 | 내용 |
|---|---|
| 논문 | Memory-R2: Fair Credit Assignment for Long-Horizon Memory-Augmented LLM Agents (arXiv 2605.21768) |
| 핵심 문제 | 메모리 RL에서 롤아웃마다 메모리 상태가 달라 trajectory 비교가 불공평 |
| 제안 | LoGo-GRPO: 전역(trajectory) + 지역(리롤아웃) 그룹 상대 최적화 |
| 구조 | fact extractor + memory manager가 같은 LLM 백본 공유 (Qwen2.5-7B-Instruct) |
| 커리큘럼 | 세션 8 → 16 → 32로 점진 확장 |
| 주요 수치 | LoCoMo 전체 F1 50.60 (Memory-R1 43.14 대비) |
| 학습 데이터 | LoCoMo 대화 2개만 사용 |
| 저자 | LM 뮌헨, MCML, 화웨이 하이젠베르크 연구소, TU 뮌헨 (2026-05-20) |
GRPO가 메모리 에이전트에서 깨지는 이유
GRPO는 한 그룹 안에서 여러 trajectory를 만들고 상대 보상을 비교합니다. 이때 조용한 전제가 하나 있습니다. 모든 롤아웃이 같은 환경에서 시작했다는 거죠.
메모리 에이전트는 이 전제를 스스로 무너뜨립니다.
- 세션 1에서 롤아웃 A는 어떤 사실을 저장하고, 롤아웃 B는 다른 사실을 저장합니다.
- 세션 2부터 A와 B는 서로 다른 메모리 상태를 환경의 일부로 상속합니다.
- 그런데 GRPO는 여전히 두 trajectory를 같은 그룹으로 묶어 보상을 정규화합니다.
결국 두 가지 문제가 생깁니다.
- 불공평한 비교: 다른 환경에서 시작한 trajectory끼리 경쟁.
- 모호한 크레딧: 최종 실패가 지금 세션의 메모리 조작 때문인지, 이전 세션에서 물려받은 오염된 메모리 때문인지 알 수 없음.
논문은 이걸 두고 “메모리가 환경을 비정상적으로 만든다(non-stationary)“고 표현합니다.
LoGo-GRPO: 전역 최적화 + 지역 리롤아웃 비교
Memory-R2의 해법은 GRPO를 버리는 게 아니라 계층을 나누는 겁니다.
| 구성 | 역할 |
|---|---|
| 전역 최적화 | trajectory 전체 보상으로 엔드투엔드 학습 유지 |
| 지역 리롤아웃 | 같은 중간 메모리 상태에서 세션을 다시 굴려 메모리 조작 결과만 공정하게 비교 |
지역 리롤아웃이 핵심 아이디어입니다. 세션 k의 시작 메모리 상태를 고정하고 거기서 여러 갈래로 다시 실행하면, 그룹 내 비교가 다시 공평해집니다. 메모리 조작 자체의 우열이 드러나니 크레딧도 세션 단위로 깨끗해집니다.
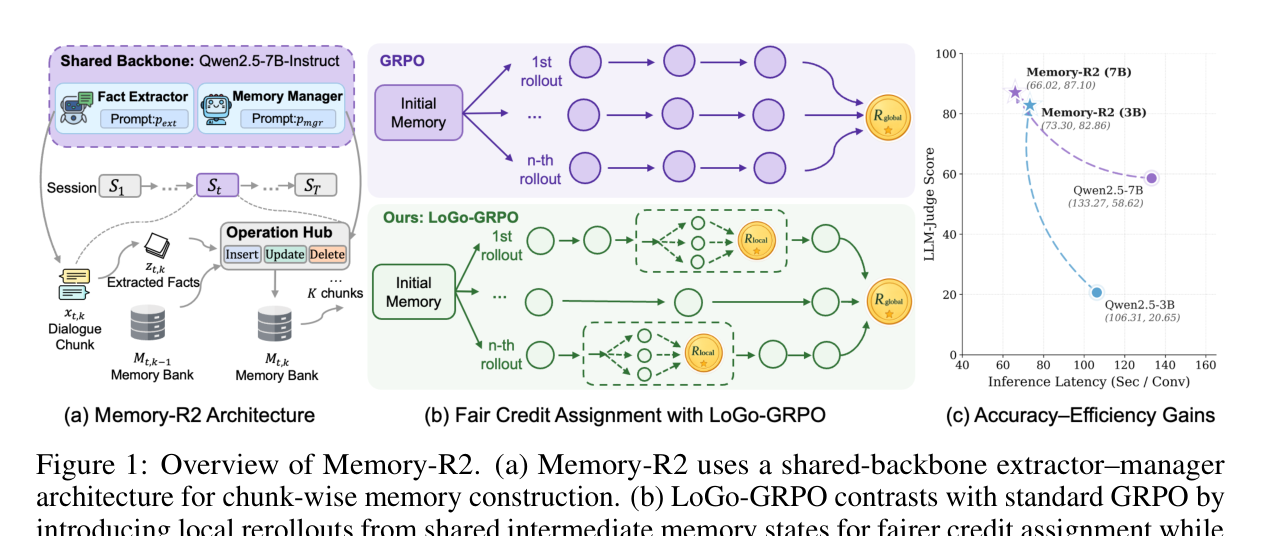 그림 1. Memory-R2 개요. (a) 공유 백본 extractor–manager 구조, (b) GRPO 대비 LoGo-GRPO의 로컬 리롤아웃, (c) 백본별 정확도·지연시간 개선. 출처: 논문 Figure 1.
메모리 구성을 다단계 의사결정 과정으로
크레딧 문제 외에 구조 설계가 하나 더 있습니다. 예전 RL 메모리 연구는 메모리 갱신·검색에 집중했는데, 이 논문은 메모리 형성과 진화를 함께 최적화합니다.
- fact extractor: 상호작용 맥락에서 저장할 사실을 뽑는 역할.
- memory manager: insert / update / delete를 결정하는 역할.
- 둘 다 같은 Qwen2.5-7B-Instruct 백본에서 역할 프롬프트만 바꿔 인스턴스합니다. 파라미터를 공유하니 학습도 같이 되고, extractor와 manager의 조율도 타이트해집니다.
세션도 하나의 거대한 전이로 취급하지 않습니다. 세션을 청크로 나눠서 extractor와 manager가 청크 위를 번갈아 움직이게 만듭니다. 메모리 구성을 다단계 의사결정 과정으로 보는 셈이죠. 증거가 쌓일수록 다듬을 수 있습니다.
세션 커리큘럼: 8 → 16 → 32
긴 세션 수로 바로 학습하면 무너집니다. 그래서 세션 수를 점진적으로 늘립니다.
| 단계 | 세션 수 |
|---|---|
| 1 | 8 |
| 2 | 16 |
| 3 | 32 |
각 단계 체크포인트가 다음 단계 초기화에 쓰입니다. 짧은 구간에서 안정적인 메모리 행동을 먼저 익히고 긴 구간으로 확장하는 겁니다.
그 효과가 생각보다 큽니다. 커리큘럼 없이 32세션으로 바로 학습하면 검증 F1이 0.47에서 0.27로 붕괴하고 M-Fail이 72.1%까지 치솟습니다. 커리큘럼 하나로 이 붕괴가 막힙니다.
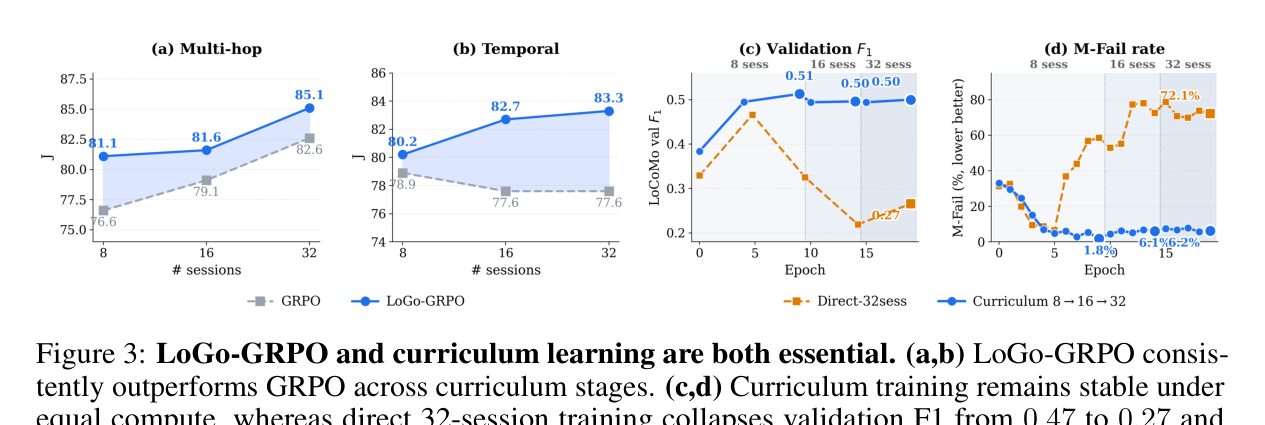 그림 3. LoGo-GRPO와 커리큘럼이 둘 다 필요하다는 증거. 출처: 논문 Figure 3.
성능: LoCoMo 전체 F1 비교
기준일: 2026-05-20 논문 v1 기준입니다.
| 모델 | 전체 F1 | 전체 B1 | 전체 J |
|---|---|---|---|
| RAG | 8.97 | 7.27 | 12.17 |
| Mem0 | 30.61 | 23.55 | 53.30 |
| MemoryOS | 34.64 | 29.36 | 51.26 |
| MemAgent | 40.72 | 33.36 | 71.52 |
| Memory-R1 | 43.14 | 36.44 | 61.51 |
| Memory-R2 (GPT-OSS) | 49.67 | 43.77 | 87.10 |
| Memory-R2 (7B) | 50.60 | 44.01 | 80.99 |
전체 백본을 Qwen2.5-7B로 통제한 비교입니다. RL로 학습된 7B 메모리 모듈이 GPT-OSS-120B 답변 에이전트를 단 검증 변형보다 F1/B1에서 앞섭니다. 모델 크기보다 학습이 더 중요할 수 있다는 신호입니다.
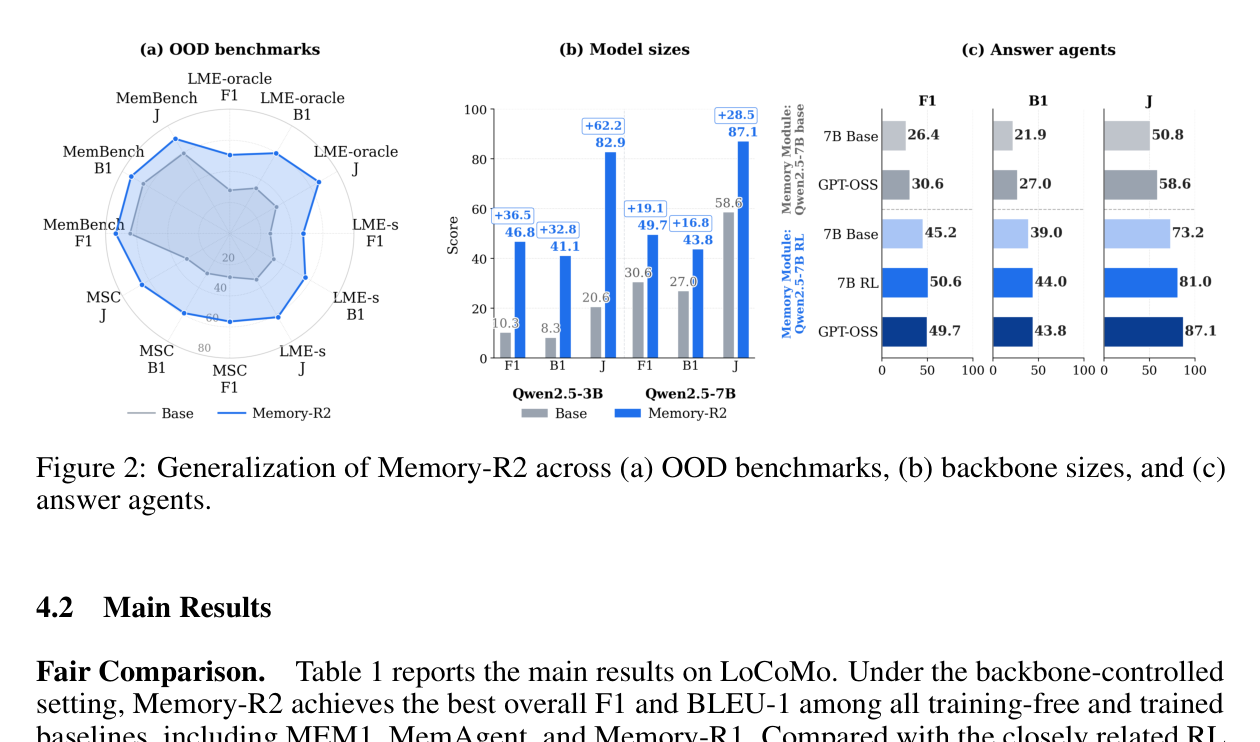 표 1. LoCoMo 주요 결과. 전체 백본 Qwen2.5-7B 통제 비교. 출처: 논문 Table 1.
학습 데이터 효율: 대화 2개
가장 눈에 띄는 대목은 학습 데이터 규모입니다. LoCoMo 대화 2개만으로 학습해서 OOD 벤치마크까지 이기는 성능을 냈습니다.
- LongMemEval-oracle에서 F1 27.88 → 50.60.
- Qwen2.5-3B처럼 작은 모델에서는 F1 10.3 → 46.8로 개선 폭이 더 큽니다. 작은 모델일수록 이 학습 방식의 이득이 커요.
- 답변 에이전트를 GPT-OSS로 바꿔도 성능이 유지됩니다. 학습된 건 메모리 구성 정책이라는 뜻입니다.
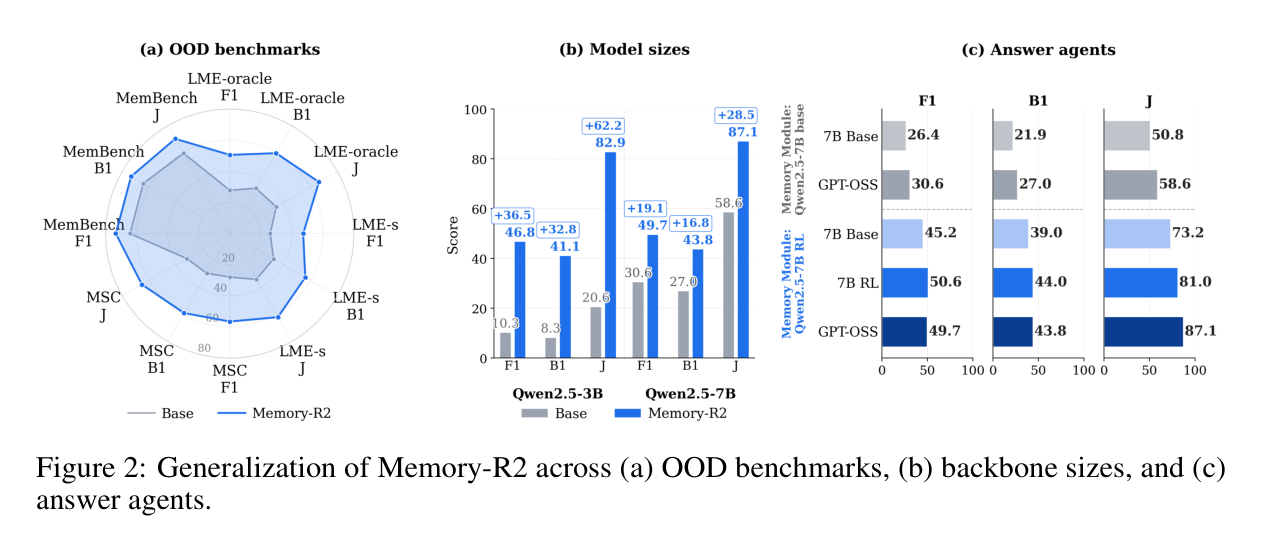 그림 2. (a) OOD 벤치마크, (b) 백본 크기, (c) 답변 에이전트별 일반화. 출처: 논문 Figure 2.
요소별 기여도 비교
절 ablation 결과입니다.
| 변형 | F1 | 변화 |
|---|---|---|
| LoGo-GRPO (full) | 49.67 | - |
| 표준 GRPO로 교체 | 46.62 | -3.05 |
| 커리큘럼 제거 | 24.12 | -25.55 |
| extractor만 학습 | 28.30 | -21.37 |
| manager만 학습 | 45.34 | -4.33 |
| 단일 에이전트로 통합 | 39.14 | -10.53 |
커리큘럼과 extractor 학습이 성능에 가장 큰 영향을 줍니다. 메모리에 뭘 넣을지 뽑는 단계가 관리 단계보다 훨씬 중요하다는 해석이 가능합니다.
해석과 주의점
- 이 논문의 기여는 학습 문제의 정의 쪽에 가깝습니다 비교 공정성이라는 학습 문제를 정확히 짚은 것입니다. RL 메모리 에이전트를 학습해본 팀이라면 공감할 지점이죠.
- 로컬 리롤아웃은 그룹 비교 전제를 복원하는 기법이라, 메모리 외에도 환경을 에이전트가 바꾸는 설정(도구 생성, 셀프 수정)에 적용해볼 만합니다.
- 학습 대화 2개라는 숫자는 인상적이지만 LoCoMo 대화 하나가 매우 길고 세션이 많아 데이터 총량 자체가 작지는 않습니다. 그냥 두고 “2개로 됐다”고 읽으면 과대 해석이에요.
더 실습해보고 싶은 분들께
자주 묻는 질문
Memory-R2와 Memory-R1의 차이는 무엇인가요?
Memory-R1은 메모리 갱신·검색에 RL을 적용한 선행 연구입니다. Memory-R2는 메모리 형성까지 학습 범위에 넣고, 롤아웃 간 메모리 상태가 달라지는 비공정 비교 문제를 LoGo-GRPO의 로컬 리롤아웃으로 해결합니다. LoCoMo 전체 F1 기준 43.14에서 50.60으로 올랐습니다.
GRPO가 메모리 에이전트에서 실패하는 이유
롤아웃마다 메모리에 다른 내용이 쓰이면서 이후 세션이 서로 다른 메모리 상태를 상속합니다. 그런데 GRPO는 그룹 내 보상 정규화에서 같은 환경이라는 전제를 쓰기 때문에 비교가 불공평해지고 크레딧이 왜곡됩니다.
학습 데이터가 정말 대화 2개인가요?
네, LoCoMo 학습 대화 2개로 학습했습니다. 다만 각 대화가 긴 멀티세션이므로 데이터 총량이 아주 작은 건 아니고, LongMemEval 같은 OOD 벤치마크에서도 개선이 유지됐다는 게 논문의 주장입니다(기준일 2026-05-20, v1).
커리큘럼을 빼면 어떻게 되나요?
세션 8→16→32 점진 학습 없이 32세션으로 바로 학습하면 검증 F1이 0.47에서 0.27로 떨어지고 M-Fail이 72.1%까지 올라갑니다. ablation에서 F1 -25.55로 가장 큰 성능 하락 요인이었습니다.