결론 먼저
메모리 시스템을 붙여도 LLM이 그 메모리를 제대로 쓰는 건 별개 문제입니다.
프론티어 모델들조차 주어진 메모리를 과하게 반영하거나(over-use) 필요한 걸 무시하는(under-use) 오류를 반복하고, GPT-5.6-SOL조차 원자 단위 정확 보정률(Exact)이 28.40%에 그칩니다. 게다가 GRPO 같은 기존 포스트트레이닝은 한쪽 오류를 줄이면 다른 쪽이 늘어나는 calibration seesaw 현상을 보입니다.
이 논문은 두 가지를 제안합니다. 원자 단위 메모리 사용을 측정하는 벤치마크 MemCalib, 그리고 양방향 반사실적 크레딧 할당으로 두 오류를 동시에 줄이는 MemCalib-RL이에요.
핵심 요약 표
| 항목 | 내용 |
|---|---|
| 논문 | MemCalib: Benchmarking and Optimizing Memory Use in LLM Agents (arXiv 2609.24259) |
| 소속 | USTC, Alibaba Qwen Applications Business Group, Fudan University |
| 벤치마크 규모 | 15,000 예시 (학습 13,500 / 테스트 1,500), 건강·일반 어시스턴트·코딩 3개 도메인 |
| 원자 레이블 | Ignore / Bound / Control 3단계 이상 사용 수준 |
| 최고 모델 성능 | GPT-5.6-SOL — SCS 46.25, Exact 28.40 (테스트셋 기준) |
| 제안 알고리즘 | MemCalib-RL (순서 기반 양방향 반사실적 크레딧 할당) |
| 검증 모델 | Qwen3-8B, Ministral-3-8B-Instruct, Qwen3.5-35B-A3B |
| 기준일 | 2026-09-22 arXiv v1 기준 |
원문: https://arxiv.org/abs/2609.24259
문제 정의: 원자 단위 사용 수준
에이전트 메모리 파이프라인은 검색 후 필터링을 해도 노이즈가 남습니다. 요약·프로필·궤적 형태로 들어오는 메모리 블록 하나에 여러 원자 명제(atom)가 섞여 있고, 그중 어떤 건 무시해야 하고 어떤 건 결론을 좌우해야 해요.
그래서 모델이 내려야 할 판단은 원자별로 영향력 수준을 정하는 세밀한 결정입니다. 블록 단위 쓰기/버리기로는 부족해요.
논문은 각 원자의 이상적 사용 수준을 3단계로 정의합니다.
- Ignore: 응답에 흔적을 남기면 안 됨
- Bound: 국소 근거로만 제한적으로 참고
- Control: 결론·제약·권고를 실제로 좌우함
채식주의자인데 “친구가 스테이크를 좋아한다”는 메모리가 들어왔을 때, 스테이크를 추천하면 over-use고 채식 제약을 무시하면 under-use입니다. 이걸 원자별로 채점하는 게 벤치마크의 핵심이에요.
벤치마크 구성과 평가 방식
MemCalib는 공개 QA 데이터셋 8종에서 쿼리와 메모리 원자를 분리하고, 원자별 이상 사용 수준과 채점 루브릭을 붙였습니다. 무시해야 할 distract 원자도 통제해서 섞었고, 6단계 구축 파이프라인 + 결정적 검사 + 독립 LLM 리뷰 2회로 품질을 관리했습니다.
평가는 루브릭 기반 LLM-as-a-Judge입니다. 실제 사용 수준을 Ignore/Bound/Control로 판정하고, 이상 수준과 비교해 over-use 총량 O와 under-use 총량 U를 계산합니다. 여기서 파생 지표 6개가 나옵니다.
| 지표 | 의미 | 방향 |
|---|---|---|
| SCS | over+under 합산 보정 점수 | 높을수록 좋음 |
| Exact | 모든 원자를 완전히 맞춘 비율 | 높을수록 좋음 |
| sMOS | over-use 심각도 | 낮을수록 좋음 |
| sMUS | under-use 심각도 | 낮을수록 좋음 |
| AOR | over-use 비율 | 낮을수록 좋음 |
| AUR | under-use 비율 | 낮을수록 좋음 |
판정 신뢰성도 확인했습니다. 사람 주석과 DeepSeek-V4-Pro 판정의 일치율이 96.7% (Cohen’s κ = 0.872), 불일치는 Bound/Control 경계에 몰려 있습니다.
결과 1: 프론티어 모델도 메모리를 잘 못 쓴다
테스트셋 1,500예시, 시드 3회 평가 결과입니다.
| 모델 | SCS↑ | Exact↑ | sMOS↓ | sMUS↓ |
|---|---|---|---|---|
| GPT-5.6-SOL | 46.25 | 28.40 | 38.45 | 22.92 |
| Claude Sonnet 4.6 | 36.44 | 19.09 | 48.89 | 24.77 |
| Kimi-K2.6 | 35.54 | 20.00 | 53.83 | 19.94 |
| Gemini 3.5 Flash | 34.96 | 17.96 | 51.65 | 24.73 |
| GLM-5.2 | 34.40 | 18.20 | 52.13 | 23.42 |
| Qwen3.8-Max | 34.22 | 17.80 | 50.11 | 27.46 |
| DeepSeek-V4-Flash | 33.72 | 16.96 | 55.64 | 20.86 |
| Qwen3-8B | 31.17 | 15.29 | 37.19 | 45.66 |
| Qwen3.5-35B-A3B | 26.54 | 12.24 | 64.76 | 19.93 |
읽을 포인트 세 가지입니다.
- 최고 모델조차 Exact 28.40%입니다. 절반 이상의 응답에서 원자 하나 이상을 잘못 씁니다.
- Qwen3-8B가 Qwen3.5-35B-A3B보다 SCS/Exact 모두 높습니다. 모델이 커진다고 메모리 보정이 좋아지지 않습니다.
- Qwen3-8B만 under-use 쪽으로 치우쳤고 나머지는 전부 over-use 쪽으로 치우쳤습니다. 모델들이 “메모리를 얼마나 믿을지”라는 전역 사전 하나로 대충 결정하는 흔적이에요. 개별 명제 단위의 판단은 안 보입니다.
그림 1이 over-use/under-use 예시와 최적화 방향 비교를 잘 보여줍니다.
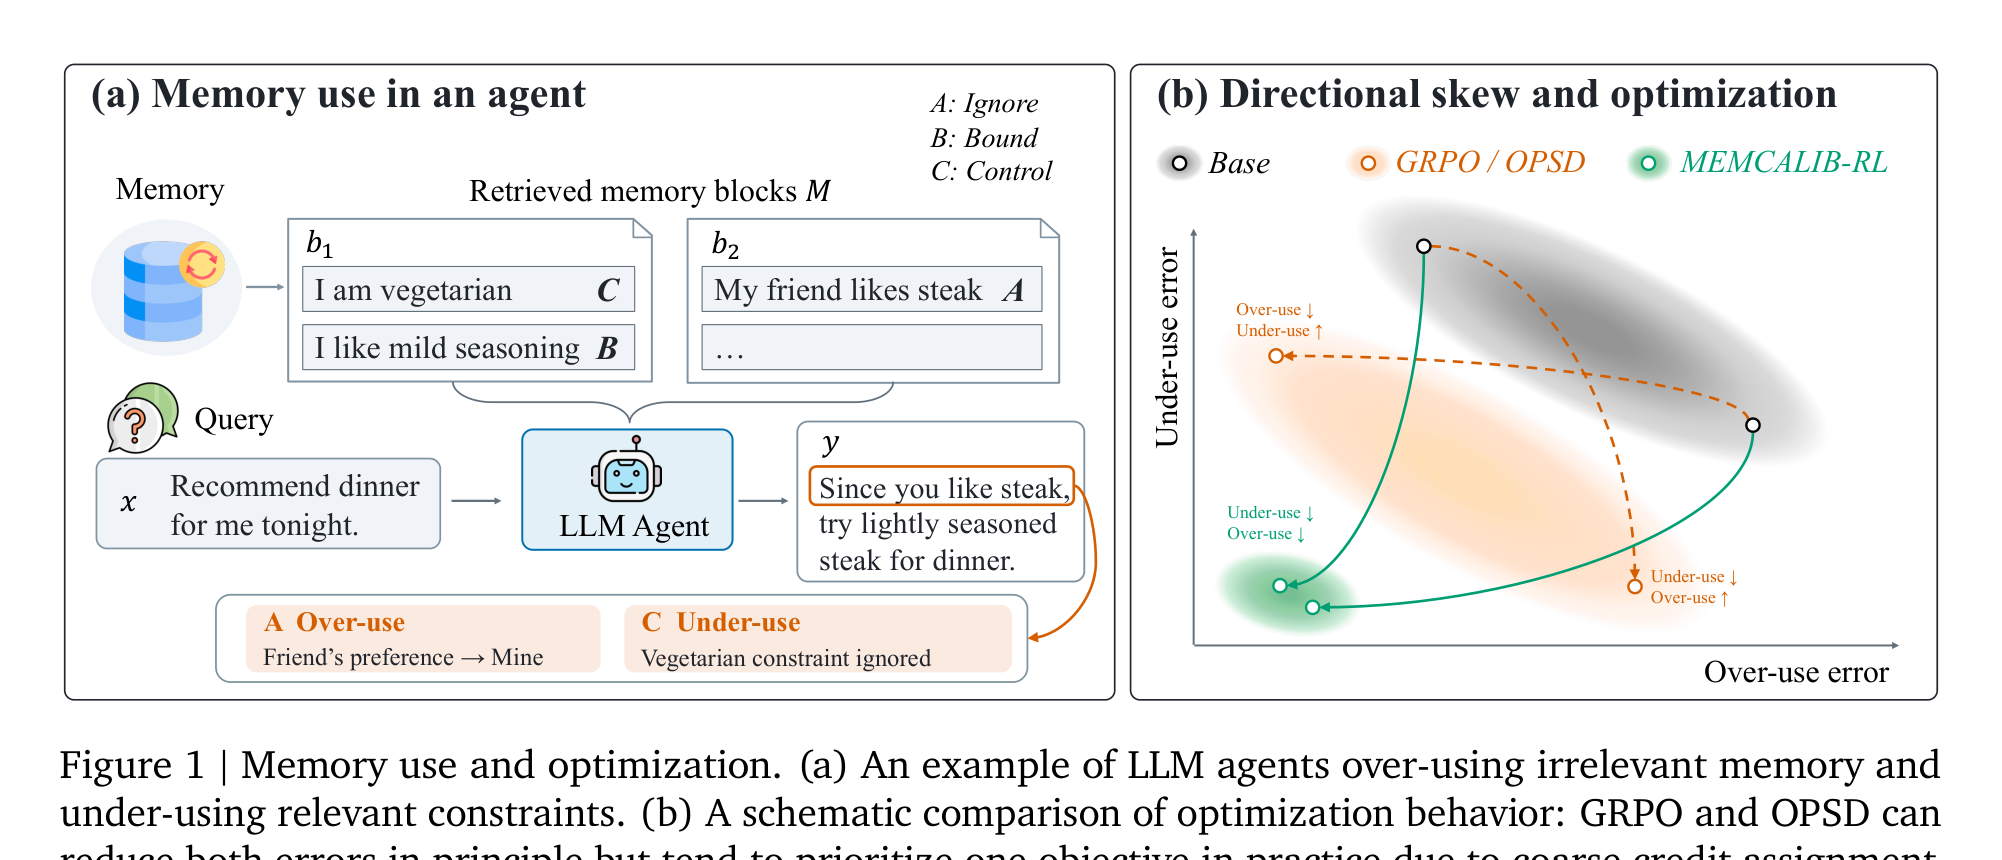 그림 1. 메모리 over-use/under-use 예시와 GRPO/OPSD/MemCalib-RL의 최적화 방향 비교 (논문 Figure 1)
결과 2: 기존 포스트트레이닝은 시소를 탄다
GRPO는 응답 하나에 장점(advantage) 하나를 균일하게 뿌립니다. 같은 응답 안에서 어떤 원자는 잘 쓰고 어떤 원자는 못 쓰는 경우를 구분 못 해요.
그 결과 GRPO와 OPSD 계열은 한 방향 오류를 줄이면서 반대 방향 오류를 키우는 calibration seesaw를 보입니다. 논문은 이 원인을 “coarse credit assignment”로 지목합니다.
MemCalib-RL: 양방향 반사실적 크레딧 할당
알고리즘은 3단계로 정리할 수 있습니다.
-
9개 보상 채널 분해: 이상 수준 × 실제 수준 조합(예: 이상 Control인데 실제 Bound → CA−)으로 원자를 채널에 배분하고 채널별 보상을 계산
-
반사실적 국소화: 해당 채널 원자만 문맥에서 제거하고 같은 응답을 teacher-forcing으로 재평가합니다.
토큰별 로그우도 차이로 그 원자가 실제로 어떤 토큰을 뒷받침했는지(+) 억눌렀는지(−)를 국소화합니다.
-
채널별 우세분포 재분배: 국소화 신호 비율로 토큰별 크레딧을 재분배하되 응답 평균은 보존. 방향이 뒤집히는 걸 막는 게이트도 있음
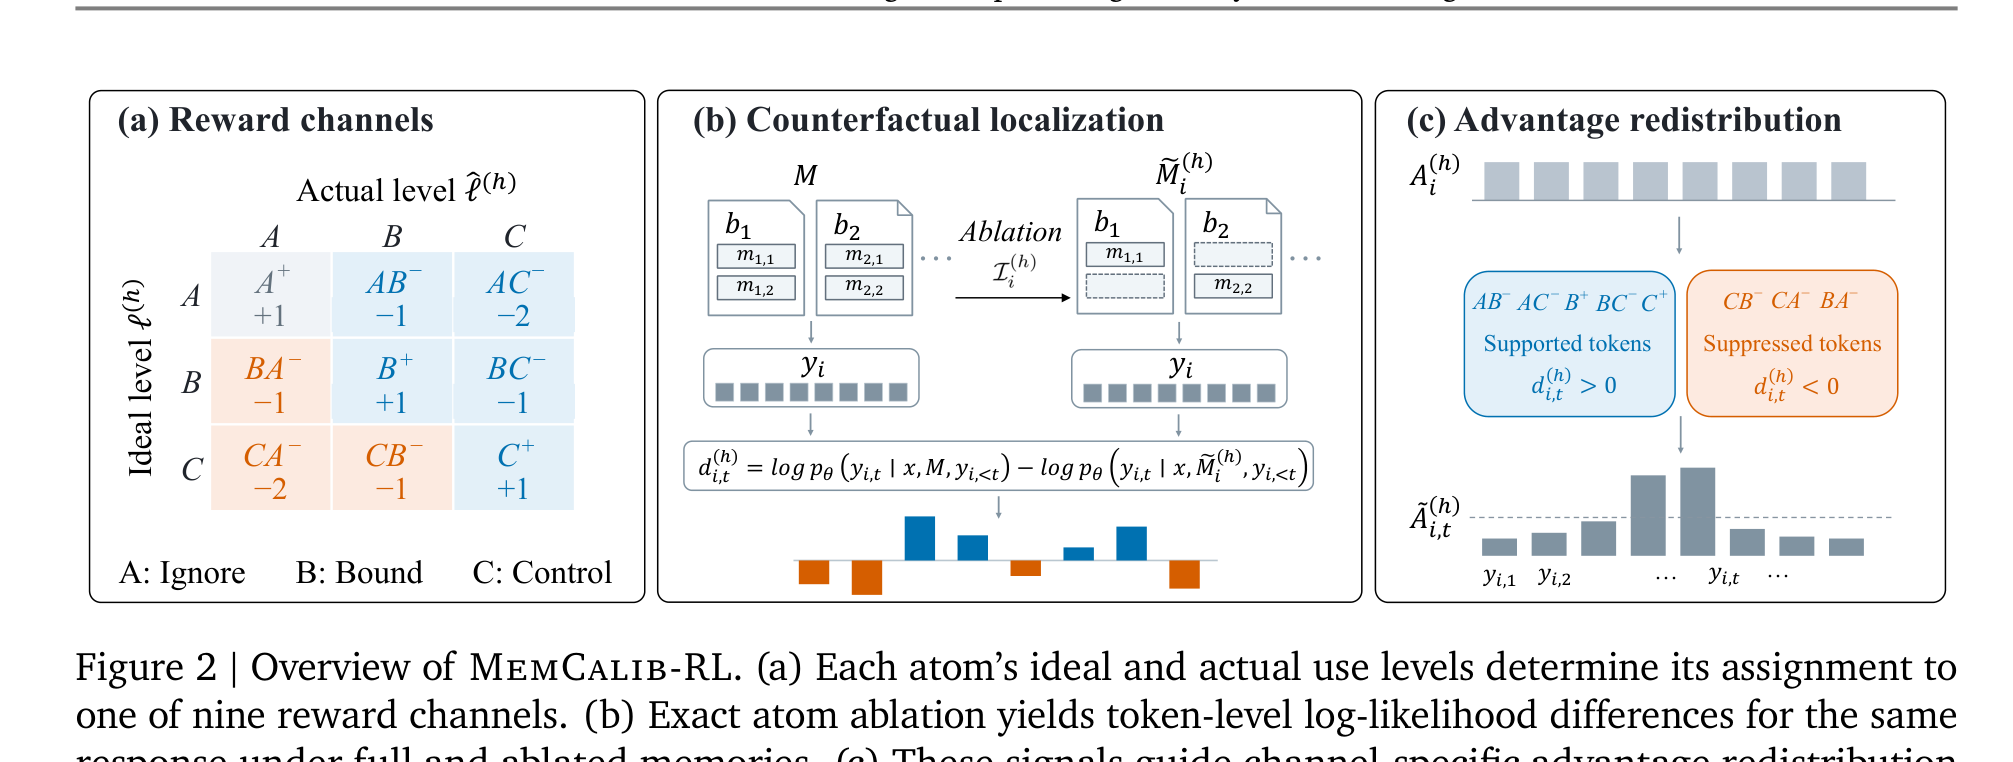 그림 2. MemCalib-RL의 보상 채널 분해, 반사실적 국소화, 우세분포 재분배 (논문 Figure 2)
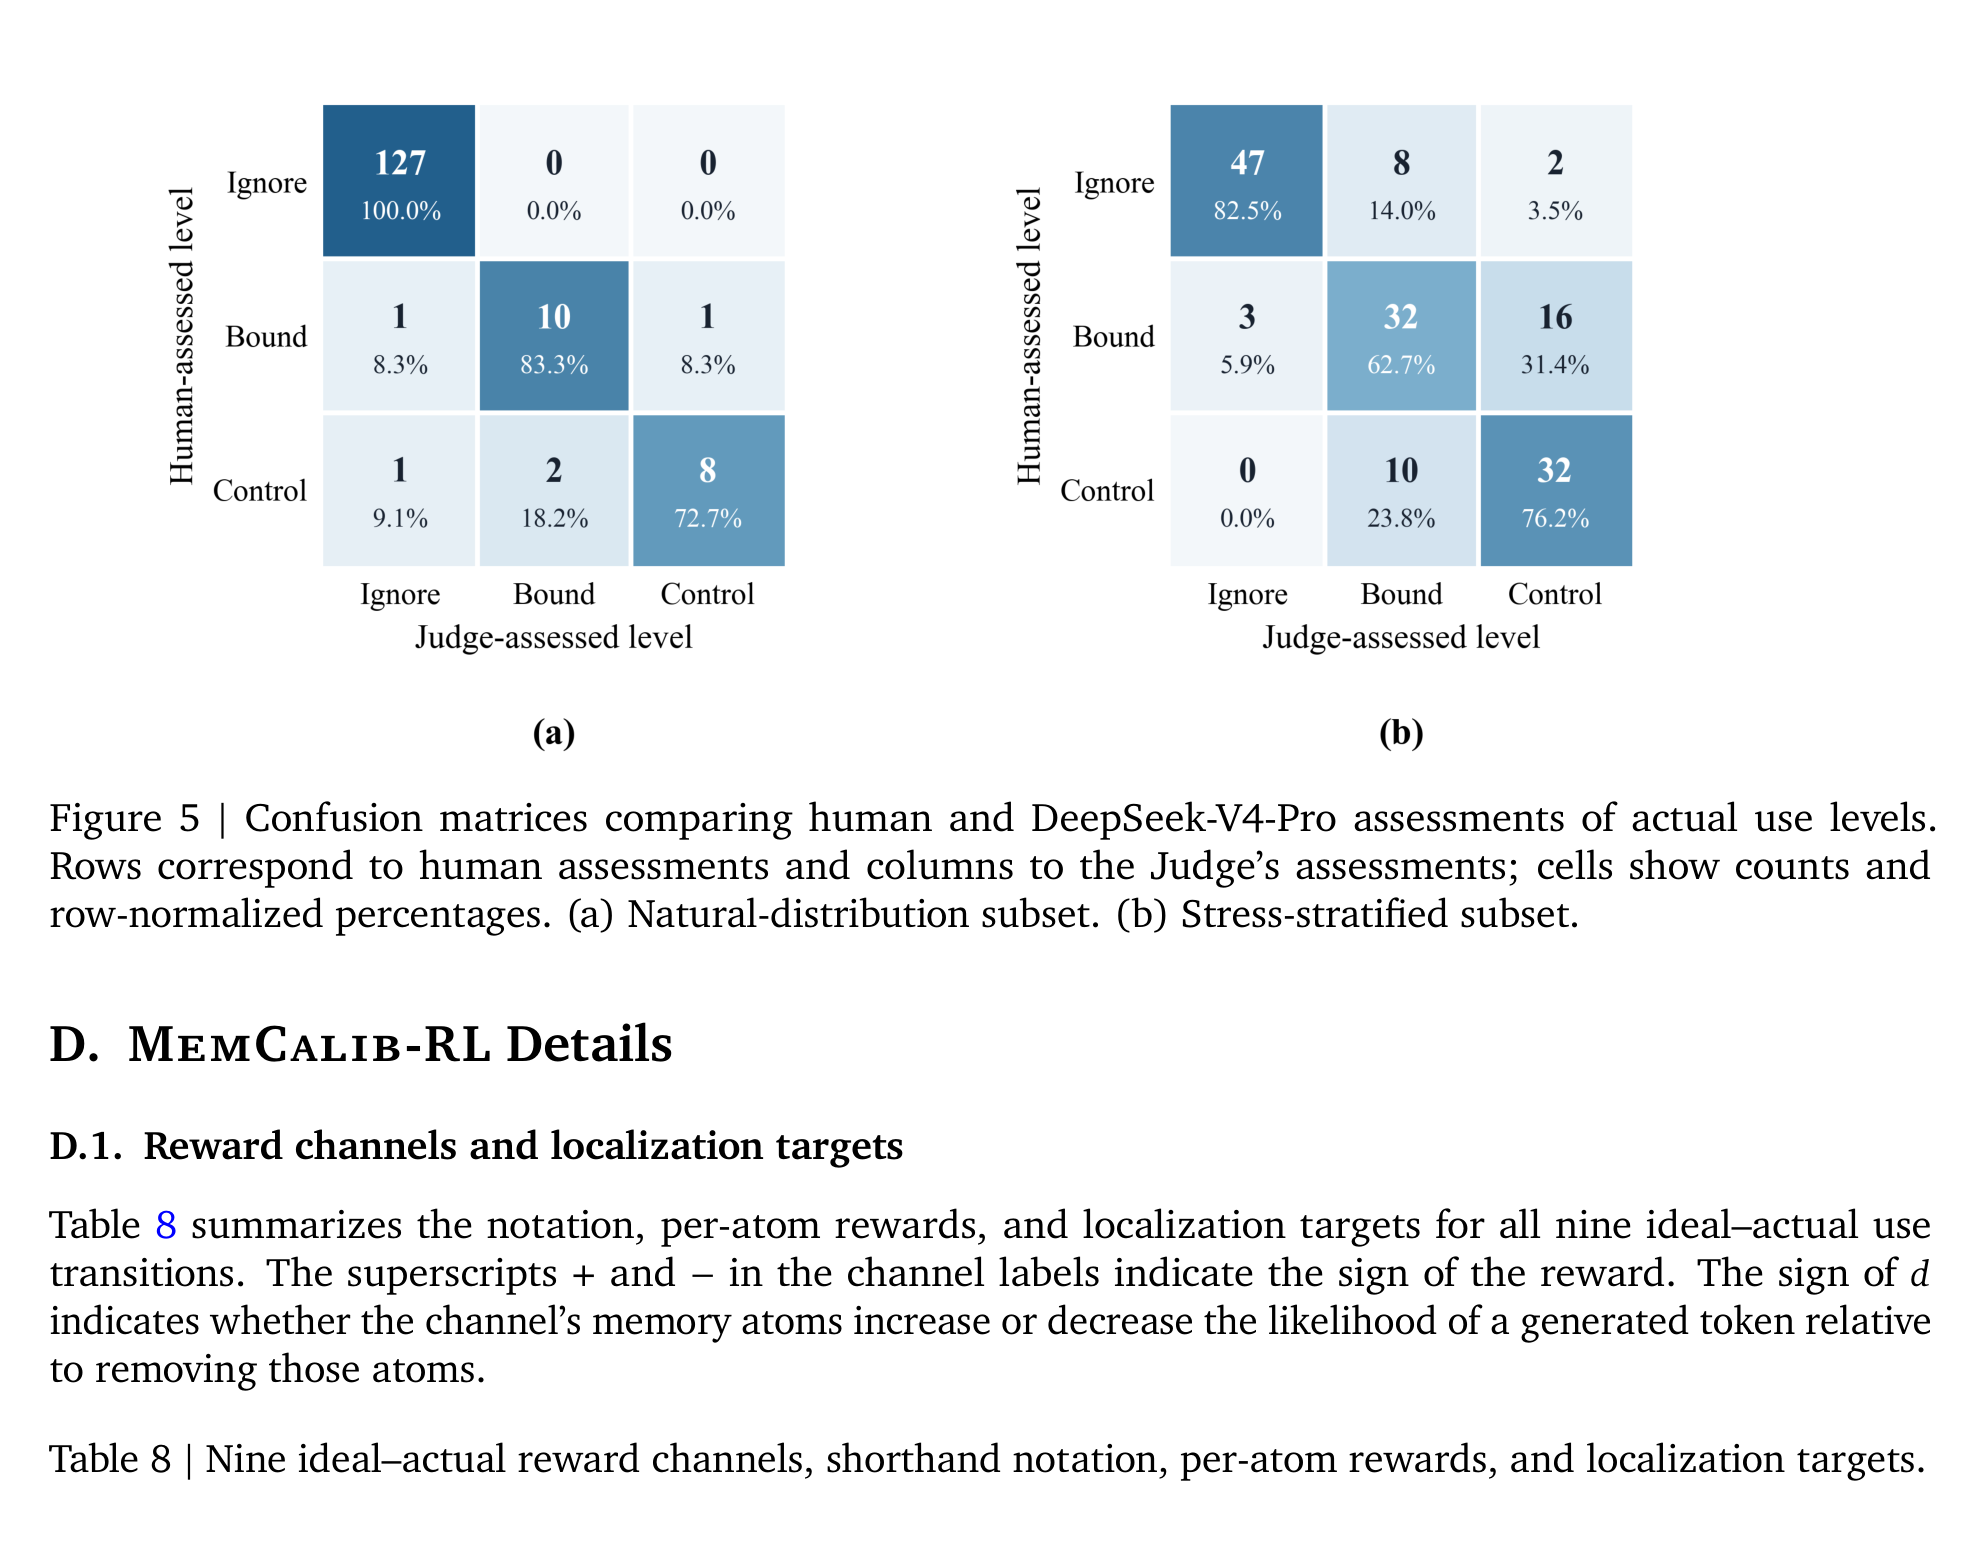 표. 9개 이상-실제 보상 채널 정의 (논문 Table 8)
언뜻 비슷한 GDPO도 채널별 정규화까지만 하고 토큰 국소화는 안 합니다. MemCalib-RL은 국소화까지 가는 게 차이점이에요.
결과 3: 세 모델에서 최고 성능, 외부 벤치마크로도 전이
3개 모델에서 MemCalib-RL이 SCS/Exact 전부 1위입니다. 최강 베이스라인 대비 SCS +1.73~+7.29, Exact +0.87~+9.98. 그리고 세 모델 모두에서 over-use와 under-use를 동시에 줄인 유일한 방법입니다. 추가 학습 없이 외부 메모리 벤치마크 RPEval에서도 최고 성능이라 일반화도 됩니다.
| 방법 | Qwen3-8B SCS↑ | Qwen3-8B Exact↑ | Qwen3.5-35B-A3B SCS↑ |
|---|---|---|---|
| Base | 31.17 | 15.29 | 26.54 |
| SFT | 65.72 | 49.49 | 75.68 |
| GRPO | 67.61 | 52.18 | 78.25 |
| GDPO | 72.25 | 57.91 | 79.39 |
| MemCalib-RL | 79.54 | 67.89 | 81.12 |
절제 실험도 설계를 지지합니다. 토큰 단위 + ordered 양방향 신호 조합이 최고(SCS 79.54)였고, 문장 단위로 coarse해지거나 방향 정보를 빼면 성능이 떨어집니다.
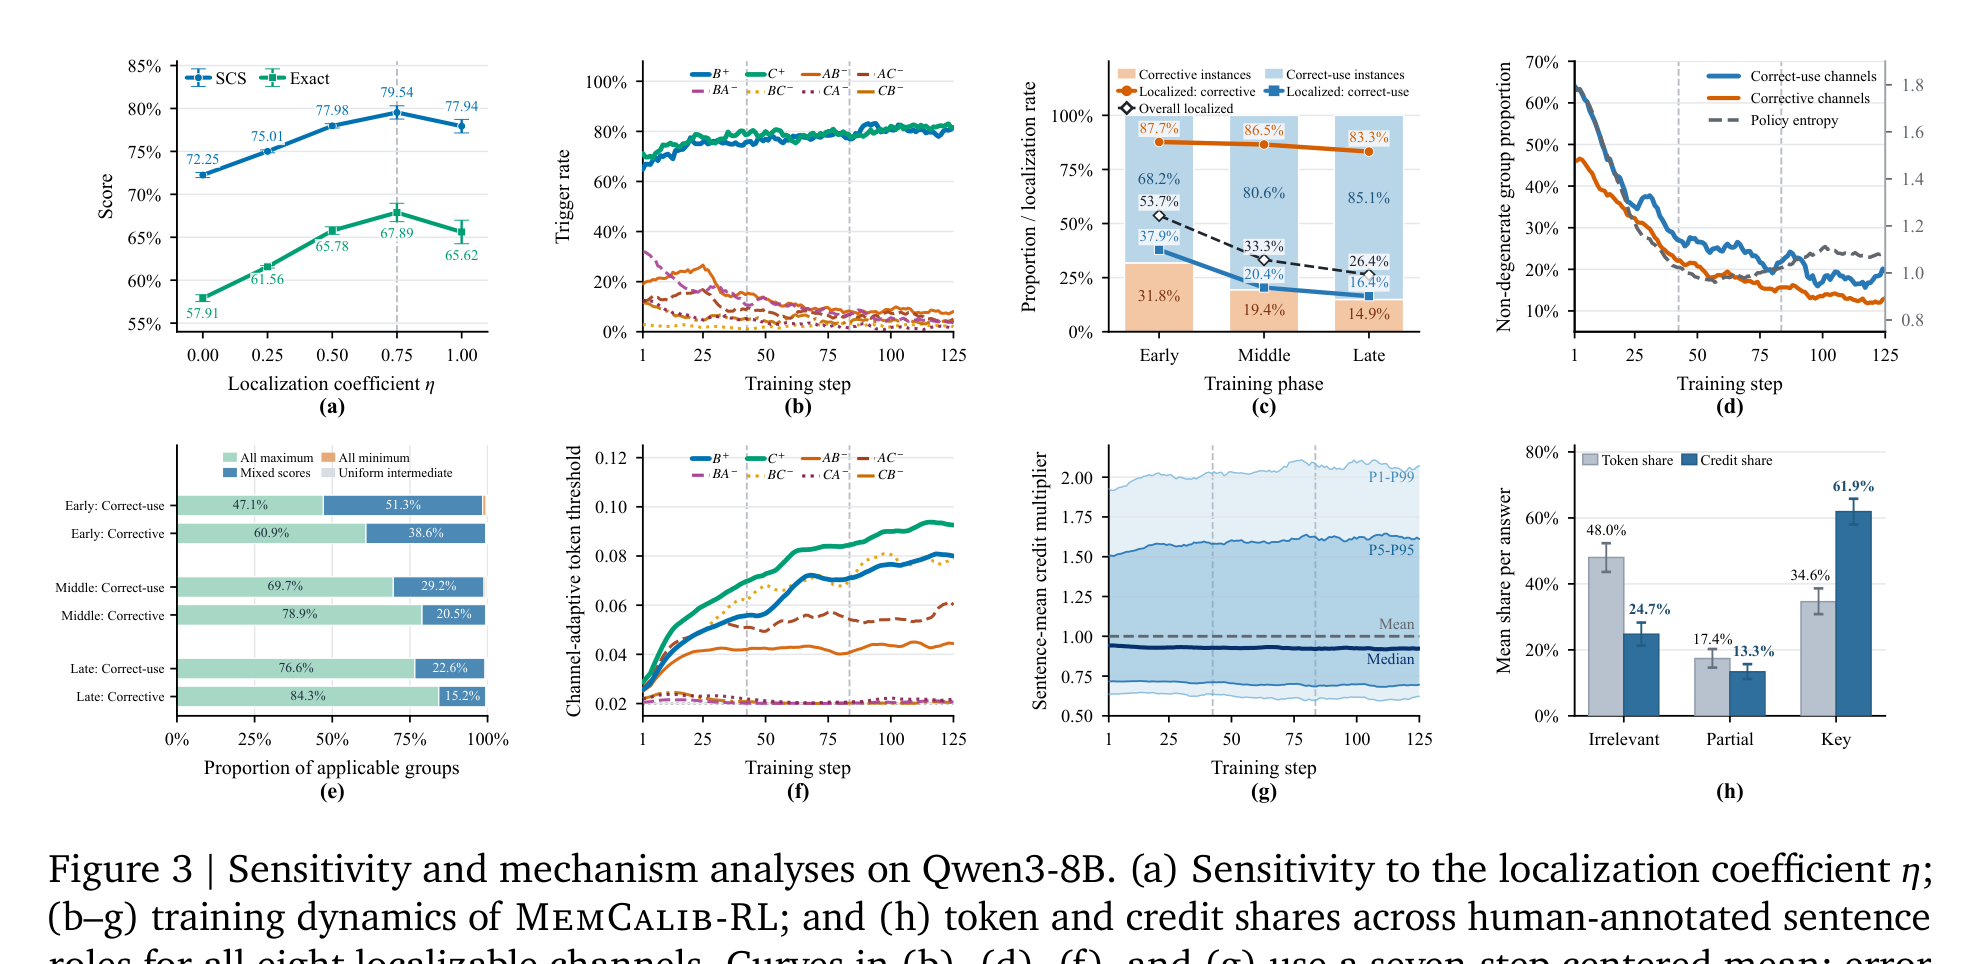 그림 3. 국소화 계수 민감도와 학습 역학 분석 (논문 Figure 3)
국소화가 실제로 크레딧을 잘 보내는지도 사람 주석으로 확인했습니다. 응답 문장을 Irrelevant/Partial/Key로 표시했더니, Key 문장은 토큰 점유율 34.6%인데 크레딧의 61.9%를 받았고 Top-3 적중률은 96.7~99.0%입니다. 메모리 영향이 실제 있는 문장에 크레딧이 몰리는 게 맞아요.
내 해석: 메모리 시스템 설계에 주는 시사점
여기부터는 논문 요약을 벗어난 내 해석입니다.
-
“메모리를 많이 넣는다”는 전략은 이 벤치마크 관점에서 over-use 리스크를 키우는 방향입니다. 검색기 정밀도와 함께 모델의 사용 보정 능력이 병목이에요.
-
평가 스킴 자체가 재활용 가치가 있습니다.
원자별 루브릭 + LLM judge + over/under 분리 지표는 개인화 어시스턴트 QA 품질 평가에 바로 쓸 수 있는 구조예요.
-
크레딧 시소는 메모리뿐 아니라 도구 사용·지시 준수처럼 “과하게/부족하게” 양방향 오류가 있는 과제 전반에 적용 가능한 프레임으로 보입니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
MemCalib의 측정 대상
쿼리와 복합 메모리 블록이 주어졌을 때, 각 원자 명제의 실제 사용 수준(Ignore/Bound/Control)이 이상 수준과 일치하는지입니다. 측정 대상은 블록 검색 품질이 아니라 모델의 사용 보정 능력이에요.
모델이 커져도 성능이 안 오르는 이유
Qwen3.5-35B-A3B가 Qwen3-8B보다 SCS/Exact가 낮았습니다. 메모리 사용 보정은 스케일링으로 자동으로 좋아지는 능력이 아니라는 게 논문의 관측이고, 큰 모델일수록 over-use로 치우치는 경향을 보였습니다.
GRPO를 그대로 쓰면 안 되는 이유
돌려도 되지만 calibration seesaw 리스크가 있습니다. 이 논문 실험에서 GRPO는 한 방향 오류를 줄이는 대신 반대 방향을 키웠고, 세 모델에서 두 오류를 동시에 줄인 건 MemCalib-RL뿐이었습니다.
MemCalib-RL 학습 방법
13,500 학습 예시 중 4,000으로 SFT 콜드스타트를 만들고, 나머지 8,000으로 9채널 보상 + 원자 제거 반사실 국소화 기반 RL을 돌리는 구조입니다. 원자별 이상 레이블과 루브릭이 있는 데이터가 필요합니다.
반사실적 국소화의 한계
토큰 귀속이 항상 정확하지는 않습니다. 논문도 이 한계를 인정하고, 시퀀스 레벨 폴백과 채널별 국소화 강도 계수 η로 완화한다고 밝힙니다.