결론 먼저
기존 LLM 에이전트 메모리 벤치마크는 대부분 대화에서 사용자 취향을 기억하는지를 테스트했어요. Rutgers 등이 만든 MemGym(arXiv 2605.20833)은 방향을 바꿉니다. 코딩, 웹 조작, 도구 대화, 딥리서치 5개 트랙에서 “실행 중 만들어지는 메모리”를 이유 능력과 분리해서 측정하는 게 핵심입니다.
결과부터 요약하면:
- 코딩(SWE-Gym)에서는 메모리 추가가 성공률에 거의 중립 (Sonnet 4.5 기준 Δ 0.0pp)
- 도구 대화(τ²-bench)에서는 +8.7pp, 웹 조작(WebArena-Infinity)에서는 +4.3pp
- 토큰 예산·검색 홉 수를 극한으로 올리면 A-Mem이 최강, 무메모리는 사실상 붕괴 (5/6-hop에서 0.009)
- 1.7B QLoRA 보상모델 MemRM이 Docker 롤아웃을 서브초 판정으로 대체, AUROC 0.985
핵심 정보 표
| 항목 | 내용 |
|---|---|
| 논문 | MemGym: a Long-Horizon Memory Environment for LLM Agents (arXiv 2605.20833, 2026-05-20 v1) |
| 소속 | Rutgers, Capital One, Princeton, Microsoft Research |
| 트랙 | τ²-bench, SWE-Gym, WebArena-Infinity, MemGym-DR, MemGym-CODE QA |
| 측정 방식 | 같은 추론 모델로 with/without 메모리 짝 실행 → 점수 차(메모리 게인)만 분리 |
| 최고 전략 | 압박 최고점에서 A-Mem (CODE QA 500k에서 0.75, DR 5/6-hop에서 0.518) |
| 가격 문제 | 에피소드당 2.10, 100에피소드 스윕에 $420 |
MemGym이 푸는 세 가지 문제
기존 평가에는 장애가 세 겹으로 겹쳐 있었다고 논문은 지적해요.
- 지표가 뒤엉킴: SWE-Gym이나 τ²-bench는 최종 성공률만 알려줍니다. 메모리 실패인지, 추론 실패인지, 도구 호출 실패인지 구분이 안 돼요.
- 착각하는 메모리 압박: 겉보기에 메모리가 중요해 보이는 과제도, 사실은 저장소를 다시 읽거나 사전학습 지식으로 풀 수 있는 경우가 많아요. MemGym은 이걸 막으려고 사실을 “메모리로만 접근 가능(memory-only)“과 “재조회 가능(discoverable)“으로 분류하고, 인스턴스마다 memory-only 사실 2개 이상을 요구합니다.
- 평가 비용: SWE-Gym 롤아웃 하나에 Docker 인프라와 수십 스텝이 필요해요. 논문 측정 기준으로 Sonnet 4.5 에피소드 하나가 6,300이라 학術 예산으론 불가능합니다.
MemGym은 여기에 두 가지 대응을 붙입니다. 먼저 길이 조절이 가능한 합성 파이프라인(CODE QA는 SWE-smith, DR은 arXiv/Semantic Scholar 검색 기반). 그리고 Docker 롤아웃을 대체하는 1.7B 경량 보상모델 MemRM(Qwen3-1.7B + QLoRA)입니다.
구조: 메모리 경계를 인터페이스로
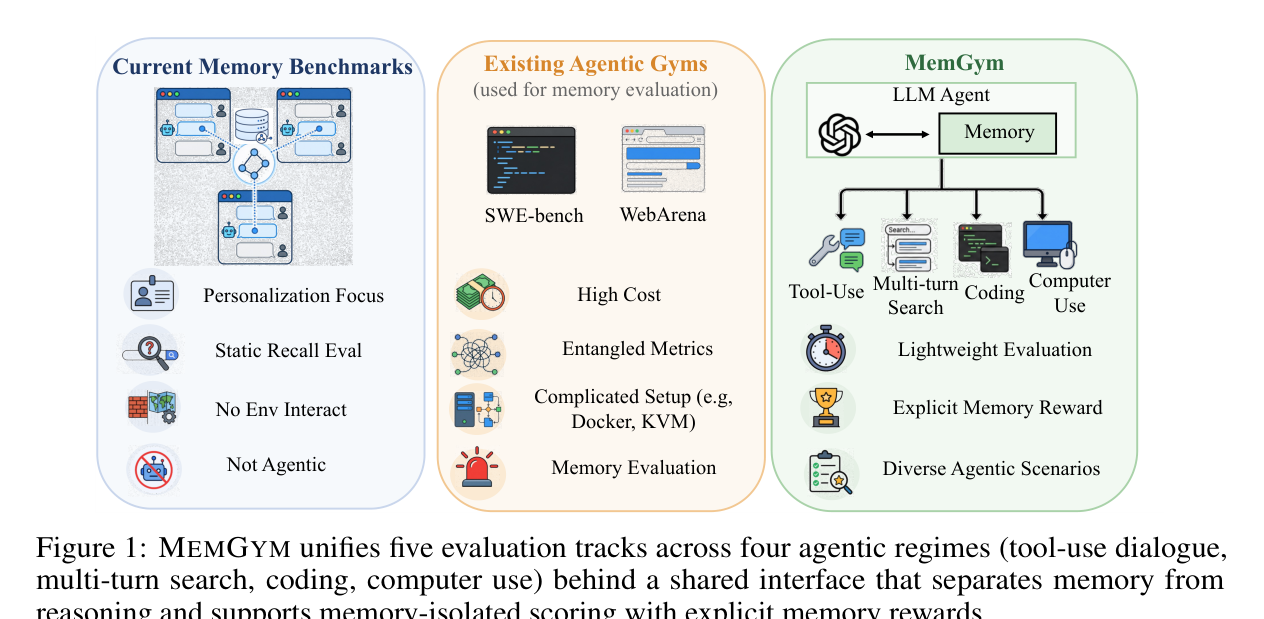
Figure 1. 다섯 트랙이 하나의 메모리–추론 인터페이스 뒤에 붙는 구조. 출처: 논문 Figure 1.
핵심 설계는 단순해요. 메모리 매니저가 정책 LLM에 들어가는 프롬프트를 감싸고, 매 스텝 manage_context → agent.act → env.step 주기를 돌립니다. 모든 압축 이벤트가 기록되니, 어떤 전략이든 어느 환경이든 같은 계약으로 비교됩니다. 새 환경 추가는 파일 하나 변경으로 끝나요.
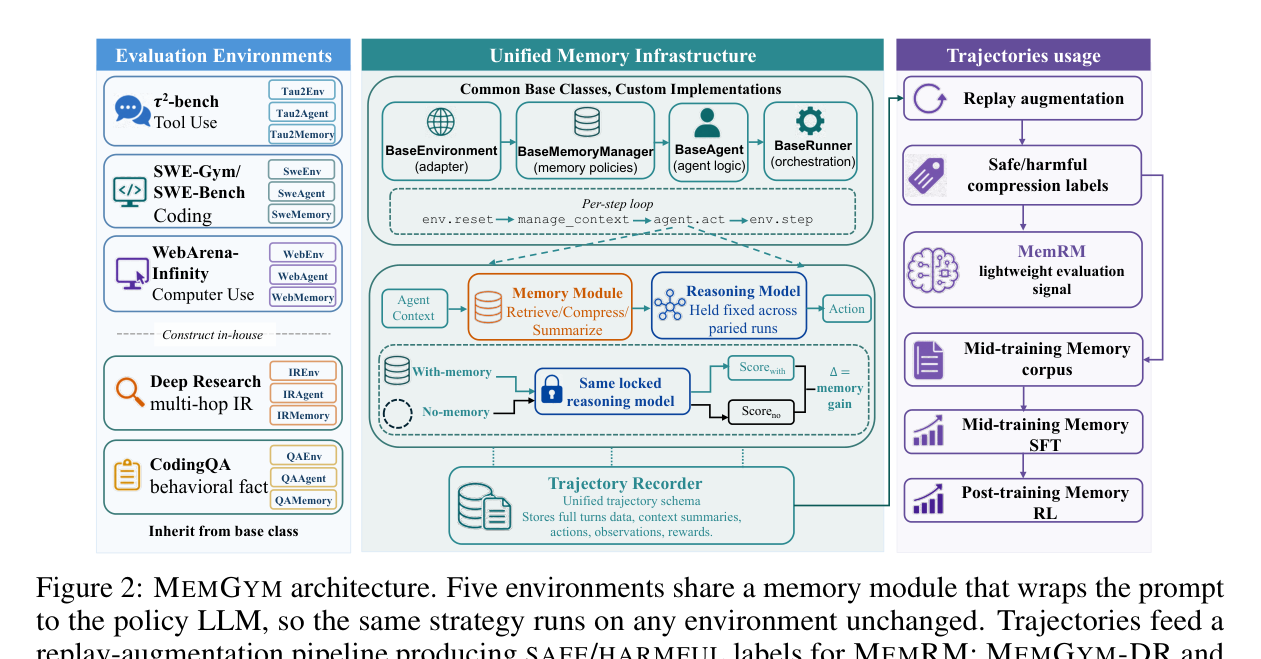
Figure 2. 메모리 모듈이 프롬프트를 감싸고 트라젝토리가 MemRM 학습 데이터로 순환하는 구조. 출처: 논문 Figure 2.
트라젝토리는 그대로 학습 데이터로 순환합니다. 재현-포크(replay-and-fork) 하네스가 기록된 도구 호출로 저장소 상태를 복원하고, 압축 시점만 정책 LLM을 다시 호출해 정책 호출을 10배 절약합니다.
결과 1: 메모리 효과는 영역에 따라 갈린다
| 환경 | 모델 | 메모리 | 베이스라인 | +메모리 | Δ |
|---|---|---|---|---|---|
| SWE-Gym | Sonnet 4.5 | Summary | 42.8 | 42.8 | 0.0 |
| SWE-Gym | GPT-OSS-120B | Summary | 22.3 | 19.1 | −3.2 |
| τ²-bench | Haiku 4.5 | Summary | 50.0 | 58.7 | +8.7 |
| WebArena-Infinity | Haiku 4.5 | Structured | 34.3 | 38.6 | +4.3 |
왜 코딩에서는 메모리가 무색무취일까요. 논문의 설명은 이겁니다. 코딩의 진행 상태는 파일 시스템에 살아서, 요약으로 날아간 것도 다시 읽으면 된다는 거예요. 반면 대화와 웹은 과거 턴에 숨은 상태(사용자 제약, 이미 처리한 항목)를 다시 만드는 비용이 커서 메모리의 효과가 커집니다. 약한 모델(GPT-OSS-120B)은 압축 이해력이 낮아 오히려 성공률이 떨어지는 것도 포인트예요. 메모리는 공짜가 아닙니다.
결과 2: 압박을 극한으로 올리면 A-Mem이 이긴다
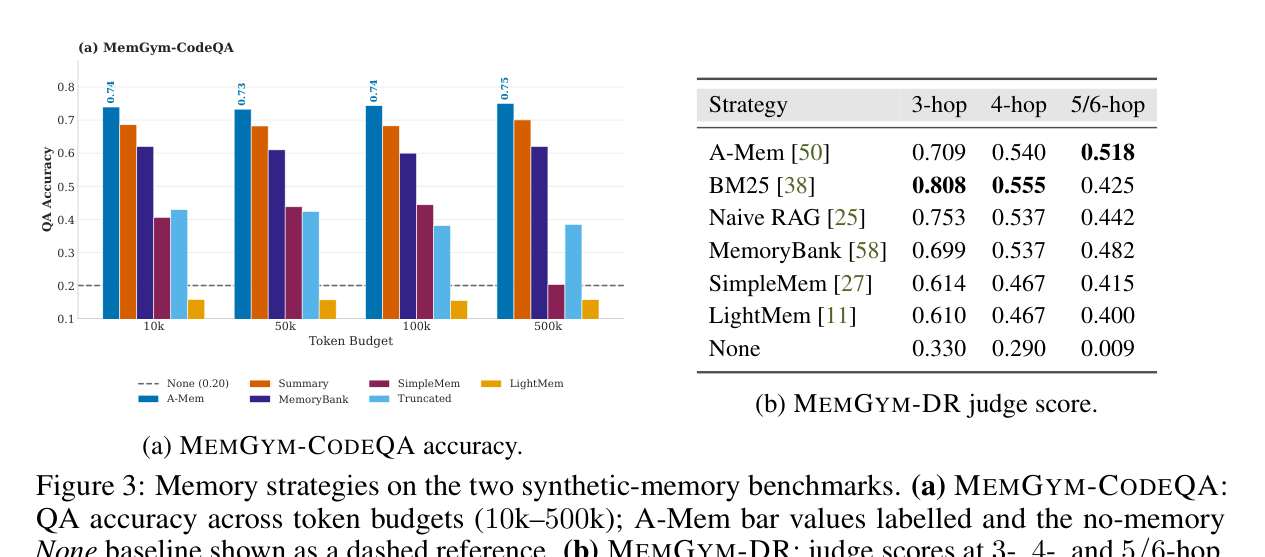
Figure 3. CODE QA 토큰 예산별 정확도와 DR 홉별 판정 점수. 출처: 논문 Figure 3.
두 합성 벤치마크는 압박 축을 하나씩 고립시킵니다.
- CODE QA: 토큰 예산 10k→500k. A-Mem은 500k에서 0.75, 무메모리는 0.20.
- DR: 검색 깊이 3→5/6홉. A-Mem은 5/6홉에서 0.518, 무메모리는 0.009.
재미있는 건 BM25가 3홉에서는 0.808으로 가장 강한데 5/6홉에서 0.425로 떨어진다는 점이에요. 저자의 해석은, 홉이 깊어지면 개별 쿼리와 관련성 낮은 “다리 사실(bridge fact)“을 노트 진화로 연결해둔 A-Mem 구조가 이긴다는 겁니다. 평범한 리트리버의 실패 모드가 5/6홉에서 드러나는 셈이죠.
또 하나: DR 트랙은 실체를 전부 가공(fictionalization)합니다. 가공 없으면 프런티어 모델이 사전학습만으로 0.700.85를 받아버려요. 가공 후 무메모리는 0에 수렴하고 메모리 격차는 0.850.95까지 벌어집니다. 메모리 벤치마크가 사전학습 지식 유출을 막았는지가 진짜 시험인 경우가 많다는 경고로 읽힙니다.
결과 3: 1.7B 모델이 Docker를 대체한다
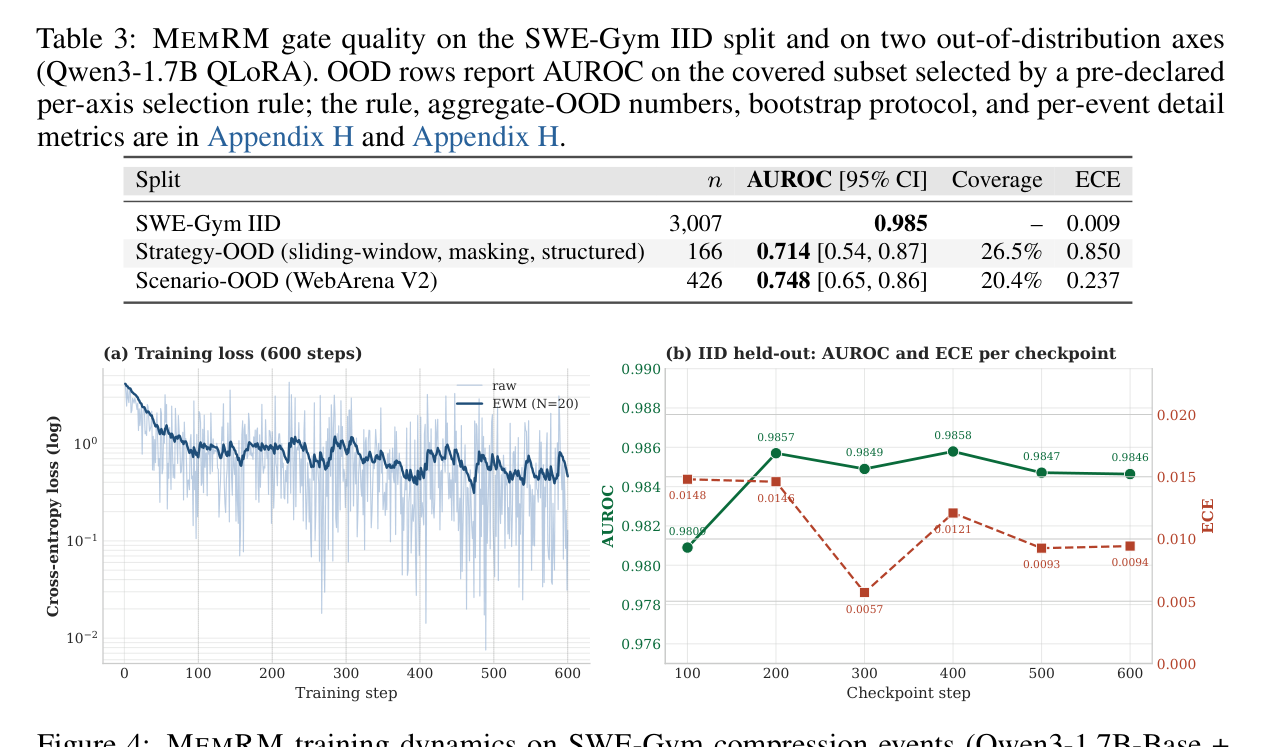
Table 3. SWE-Gym IID 분할과 OOD 축에서의 MemRM 게이트 품질. 출처: 논문 Table 3.
MemRM은 압축 후보가 안전(SAFE)한지 해로운(HARMFUL)지 판정하는 분류기예요. 학습 데이터는 18.6K 압축 이벤트(중위 컨텍스트 22K 토큰), 저장소 단위로 분할해 같은 저장소 유출을 막았습니다. 결과는 IID AUROC 0.985, 사실상 완벽한 캘리브레이션. 10분짜리 코딩 롤아웃이 서브초 스칼라 판정으로 바뀝니다.
내 해석: 실무자에게 남는 것
원문 근거와 제 해석을 나눠서 정리하면:
- 원문 주장: 메모리 효과는 영역 의존적이며, 측정은 이유 능력과 분리해야 한다.
- 내 해석: “메모리 넣으면 좋아진다”는 통념을 그대로 믿으면 안 됩니다. 코딩 에이전트라면 메모리보다 컨텍스트 압축(1.32~1.47배) 목적으로만 쓰고, 성공률 개선은 기대하지 않는 게 정직한 출발점이에요.
- 내 해석: A-Mem의 승리 조건은 “압박이 클 때”예요. 토큰 예산이 넉넉하거나 홉이 얕으면 롤링 서머리나 Naive RAG로 충분합니다. 자기 환경의 압박 축을 먼저 파악하는 게 전략 선택보다 먼저예요.
- 원문 주장: 평가 비용이 메모리 연구의 병목이다. → MemRM 같은 학습된 평가기가 반복 실험 루프를 학術적으로 가능하게 만든다.
더 실습해보고 싶은 분들께
자주 묻는 질문
MemGym은 기존 메모리 벤치마크와 뭐가 다른가요?
LoCoMo·LongMemEval 계열은 다자간 대화에서 개인화 정보 보존을 테스트합니다. MemGym은 도구 사용·코딩·웹 조작·딥리서치 같은 실제 에이전트 실행 중 형성되는 메모리를, 이유 능력과 분리된 점수(memory-isolated score)로 측정합니다.
코딩 에이전트에 메모리를 넣는 게 의미 없나요?
성공률 관점에서 세 측정 모두 중립소폭 하락(Δ 0.0−3.2pp)이었습니다. 대신 에피소드당 1.32~1.47배 컨텍스트 압축 효과는 있습니다. 파일 시스템이 진행 상태를 보관하기 때문으로 논문은 설명합니다.
MemRM은 일반 보상모델과 어떻게 다른가요?
세계모델이 아니라 “이 압축을 적용해도 행동이 유지될 확률”을 판정하는 RLHF 의미의 보상모델입니다. Docker 스냅샷·반사실 재현·LLM 판정 3원으로 라벨을 만들어 Qwen3-1.7B를 QLoRA로 파인튜닝했습니다.
데이터와 코드는 공개되어 있나요?
논문에 프로젝트 페이지·코드·데이터셋 링크가 명시되어 있습니다. CODE QA 670인스턴스(2,131 QA쌍), DR 1,194인스턴스(3~6홉)가 검증된 형태로 공개 대상입니다.
기준일: 2026-09-22 기준, arXiv 2605.20833 v1 (2026-05-20) 내용을 기반으로 정리했습니다.
원문: MemGym: a Long-Horizon Memory Environment for LLM Agents (arXiv 2605.20833)