결론 먼저
모델 파라미터를 하나도 건드리지 않고, 사용자 트래픽에서 뽑은 경험을 SKILL.md 형태의 외부 절차 메모리로 쌓기만 해도 프로급 디자인 에이전트 성능이 크게 올라갔다는 결과입니다. Adobe 연구팀이 공개한 이 프레임워크에서 frozen Claude 모델은 Photoshop·Illustrator·InDesign에 해당하는 230개 이상의 도구를 다루는데, 스킬 뱅크가 76개에서 139개로 자라는 동안 GenEval2 실행 성공률이 72.7%에서 99.3%까지 올라갔어요. 사람 라벨도, 파인튜닝도 없이 5라운드 반복만으로요.
핵심은 이겁니다. 배우는 대상이 모델이 아니라 모델 밖의 절차 라이브러리라는 점이에요. 각 스킬은 자연어로 쓰인 재사용 가능한 작업 가이드라서, 에이전트가 상황에 맞게 고쳐 쓰거나 일부만 적용할 수 있습니다.
| 항목 | 값 |
|---|---|
| 논문 | Evolving Procedural Memory from User Traffic for Agentic Graphic Design (arXiv 2609.22086) |
| 소속 | Adobe Research, Brown University |
| 대상 에이전트 | frozen LLM + 디자인 도구 230개 이상 |
| 학습 방식 | 스킬 뱅크 진화 (widening + deepening), 파라미터 업데이트 없음 |
| 스킬 수 변화 | 76개 → 139개 (5라운드, briefs 1,406개) |
| 핵심 성과 | GenEval2 실행 성공 72.7% → 99.3% (Claude-Sonnet-4) |
| 사람 라벨 | 0개 |
기준일: 2026-09-21 기준, arXiv v1(2026-09-18 공개) 내용입니다.
배경: 디자인 에이전트는 왜 학습이 어려운가
코드 에이전트는 테스트를 돌려보면 성공/실패를 기계적으로 판정할 수 있는데, 디자인에는 이런 오라클이 없어요. 하나의 디자인이 수십 개의 서로 얽힌 조작을 필요로 하니까 최종 결과물만으로 어떤 결정이 성패를 갈랐는지 알기 어렵고, 브리프에는 구체 요구사항과 “계층이 잘 보이는가” 같은 주관적 기준이 섞여 있습니다.
그래서 지도학습은 비싼 데모가 필요하고, 아웃컴 기반 최적화는 긴 호라이즌 크레딧 어사인먼트와 불완전한 프록시 리워드 문제를 안게 됩니다. 프론티어 모델이 외부 호스팅이라 파인튜닝 자체가 안 되는 상황이라면 더더욱요.
연구팀의 선택은 이렇습니다. 학습 대상을 모델에서 모델을 둘러싼 절차적 메모리로 옮기는 것. 스프레드시트 매크로나 포토샵 액션처럼 창작 소프트웨어는 원래 반복 워크플로를 재생 가능한 루틴으로 포장해왔는데, 여기서 고정된 시퀀스라는 제약을 풀어 각 절차를 적응 가능한 자연어 가이드로 만든 거예요. 예컨대 “더블 익스포저: 피사체 추출 → 마스크 생성 → 다른 에셋 블렌드 → 다듬기” 같은 식입니다.
시스템 구조
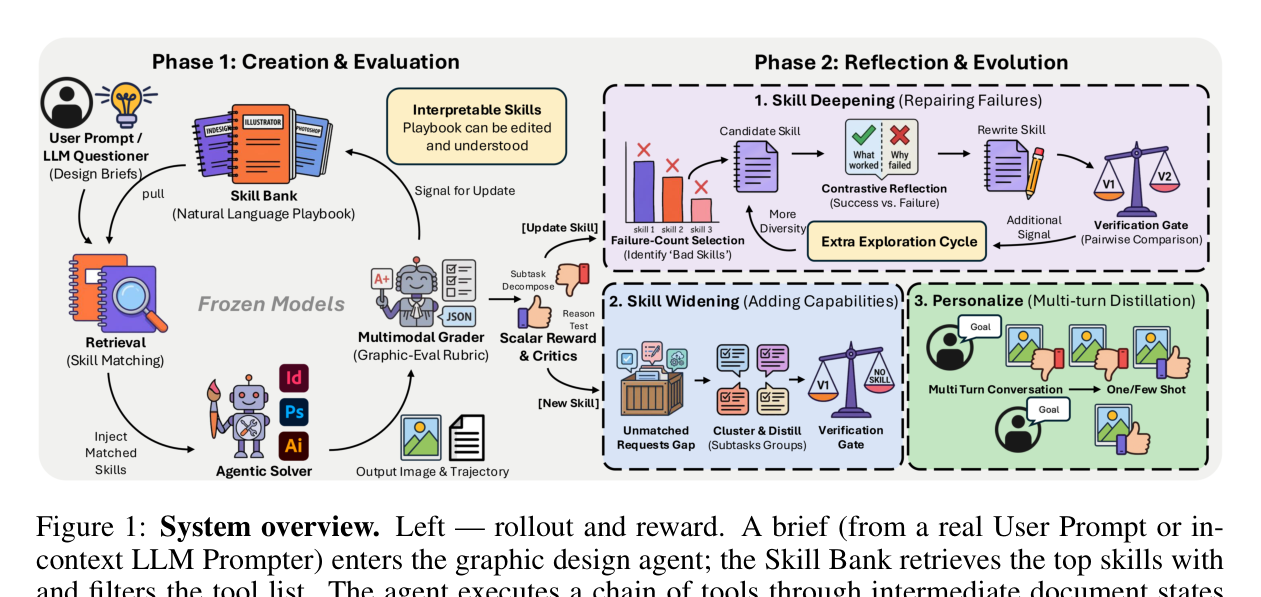
오프라인 진화 루프는 네 역할로 돌아갑니다.
| 역할 | 하는 일 |
|---|---|
| Prompter | 사용자 데이터와 LLM으로 디자인 브리프 생성 |
| Solver | 에이전트 본체: 스킬 뱅크 + 도구 → 렌더링된 이미지 |
| Grader | 멀티모달 판정: 이미지 점수 + 미달 요구사항 이유 |
| Reflector | 실패를 SKILL.md의 국소 수정으로 변환 |
바뀌는 건 SKILL.md 파일뿐입니다. 모델, 도구, 렌더러, 평가자는 고정이에요. 실행 전에 스킬 검색이 상위 플레이북과 축소된 도구 목록을 컨텍스트에 주입하는 구조라서, 검색을 끄면 원래 에이전트가 복원됩니다. 자연스러운 대조군이 되는 거죠.
widening: 커버되지 않는 하위 작업에서 새 스킬 발행
절차가 없는 궤적에서 실제 수행된 하위 작업을 추출·정규화하고, 검색된 스킬이 커버하지 못하는 것을 uncovered로 분류합니다. 커버리지 풀에 쌓인 라벨이 k_min=3회 재발하면 LLM이 사례들을 후보 스킬로 증류하고, 리플레이 게이트를 통과해야 뱅크에 들어갑니다. 거절되면 폐기하되 발생 기록은 남겨서 다음 라운드에서 증거가 계속 쌓이게 해요.
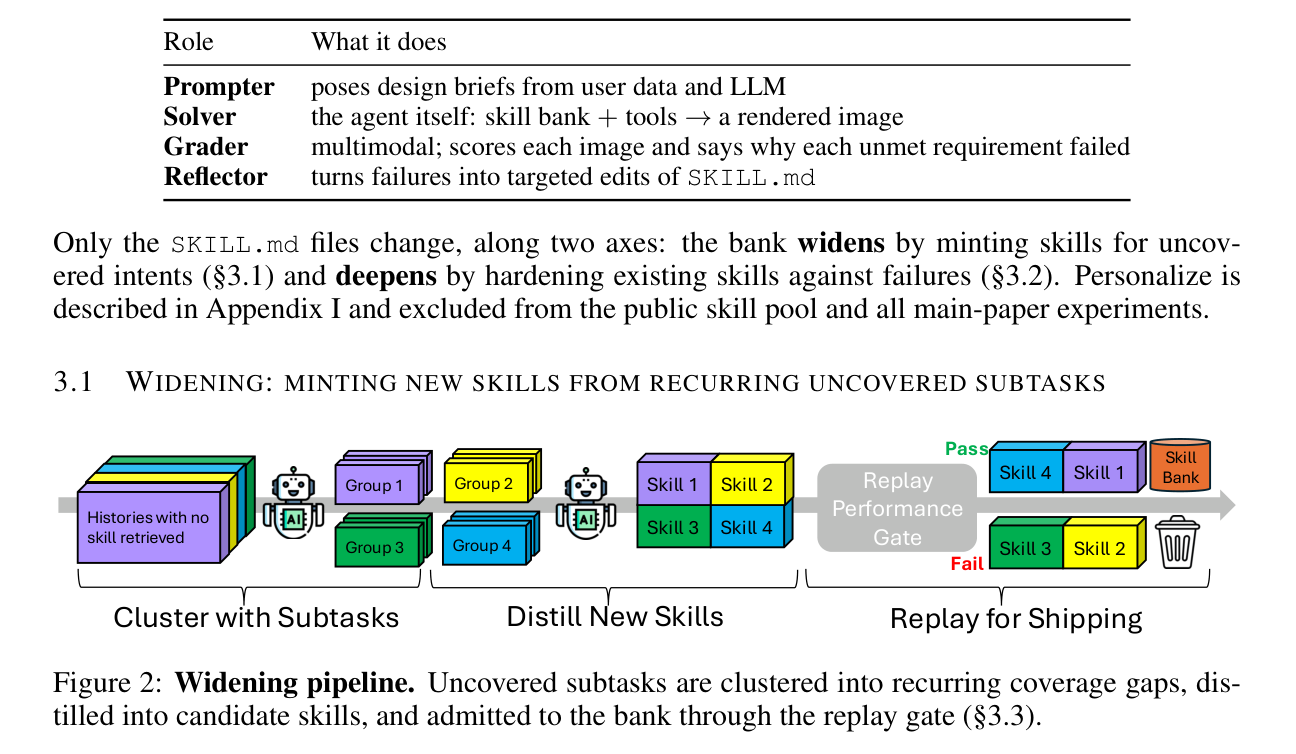
deepening: 기존 스킬을 실패 이력으로 단단하게
실패 역치(τ=0.6) 미달 궤적은 회수된 모든 스킬에 실패로 기록되고, 실패 횟수가 m(기본 2) 이상인 스킬부터 수정 대상이 됩니다. Reflector는 브리프, 요구사항별 결과와 why-bad 근거, 현재 SKILL.md, 그리고 같은 스킬의 성공 호출 대비 세트를 받아요. 성공 이력은 되돌아가면 안 되는 기준선이고, 실패 근거가 뭘 고칠지 알려줍니다.
국소 수정이 반복해서 게이트에 막히면 스킬 전체 재작성으로 에스컬레이션하고, 재작성도 거절되면 탐색 사이클을 돌려 스킬의 운명을 갱신·삭제·유지 중 하나로 판정합니다. 여기서도 고칠 수 없는 기록은 widening의 커버리지 풀로 돌아갑니다.
리플레이 게이트: 노이즈 낀 피드백에서 회귀를 막는 법
VLM 그레이더의 절대 점수는 같은 이미지여도 실행마다 흔들리니까, 게이트는 절대 점수를 아예 안 씁니다. 대신 스킬을 사용하는 프롬프트를 샘플링하고 프롬프트마다 서로 다른 에셋·업스트림 상태의 컨텍스트를 여러 개 만들어 얼립니다. 각 컨텍스트를 두 팔(후보 vs 현행, 또는 후보 vs 무스킬)에서 같은 배치로 리플레이해서 페어와이즈 판정을 하되 순서는 무작위로 섞어요.
승리 조건은 엄격합니다. 프롬프트 하나라도 지면 반려예요. 프롬프트 다수결로 하나라도 이기면 통과. 요컨대 ∃prompt won ∧ ∄prompt lost. 회귀 비용이 큰 프로덕션 환경을 반영한 비대칭 설계입니다.
결과: 숫자로 보는 5라운드
1,406개 브리프, 1,869개 자동 채점 궤적을 소비한 5라운드 동안 게이트는 재작성 231건 중 100건, 신규 발행 136건 중 67건을 거절했습니다. 통과한 것만 뱅크에 들어가요.
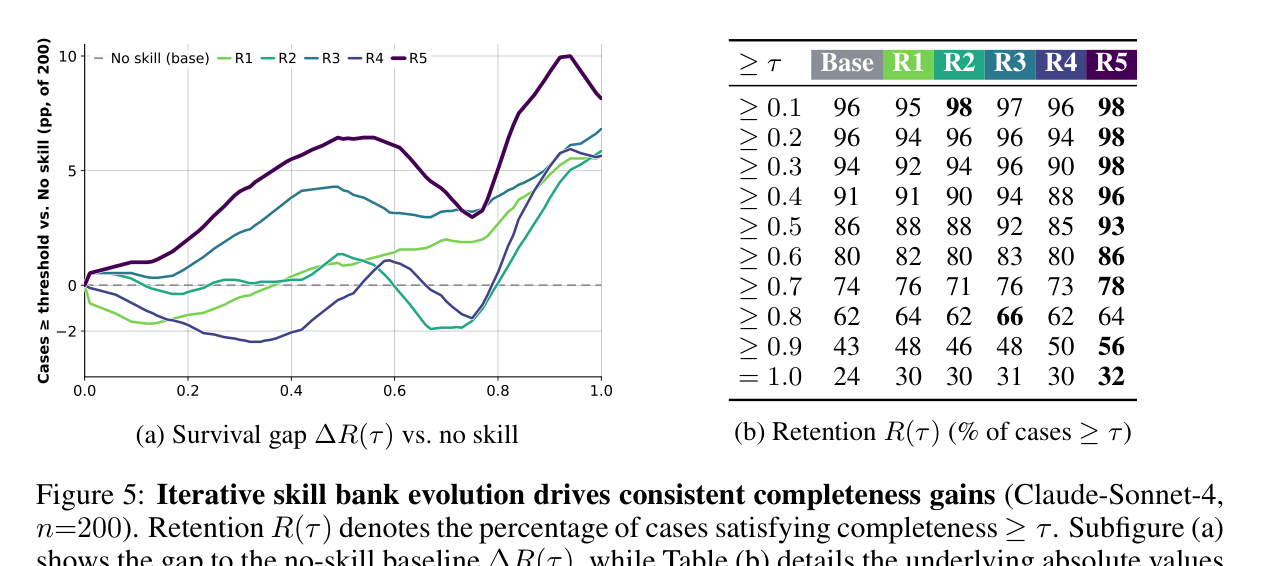
200개 인간 작성 홀드아웃 브리프(Claude-Sonnet-4)에서 R5는 완성도 ≥0.5 비중을 86%→93%, ≥0.9를 43%→56%, =1.0을 24%→32%로 올렸습니다. 가장 큰 생존 격차(+13pp)는 τ≥0.9에서 나왔어요.
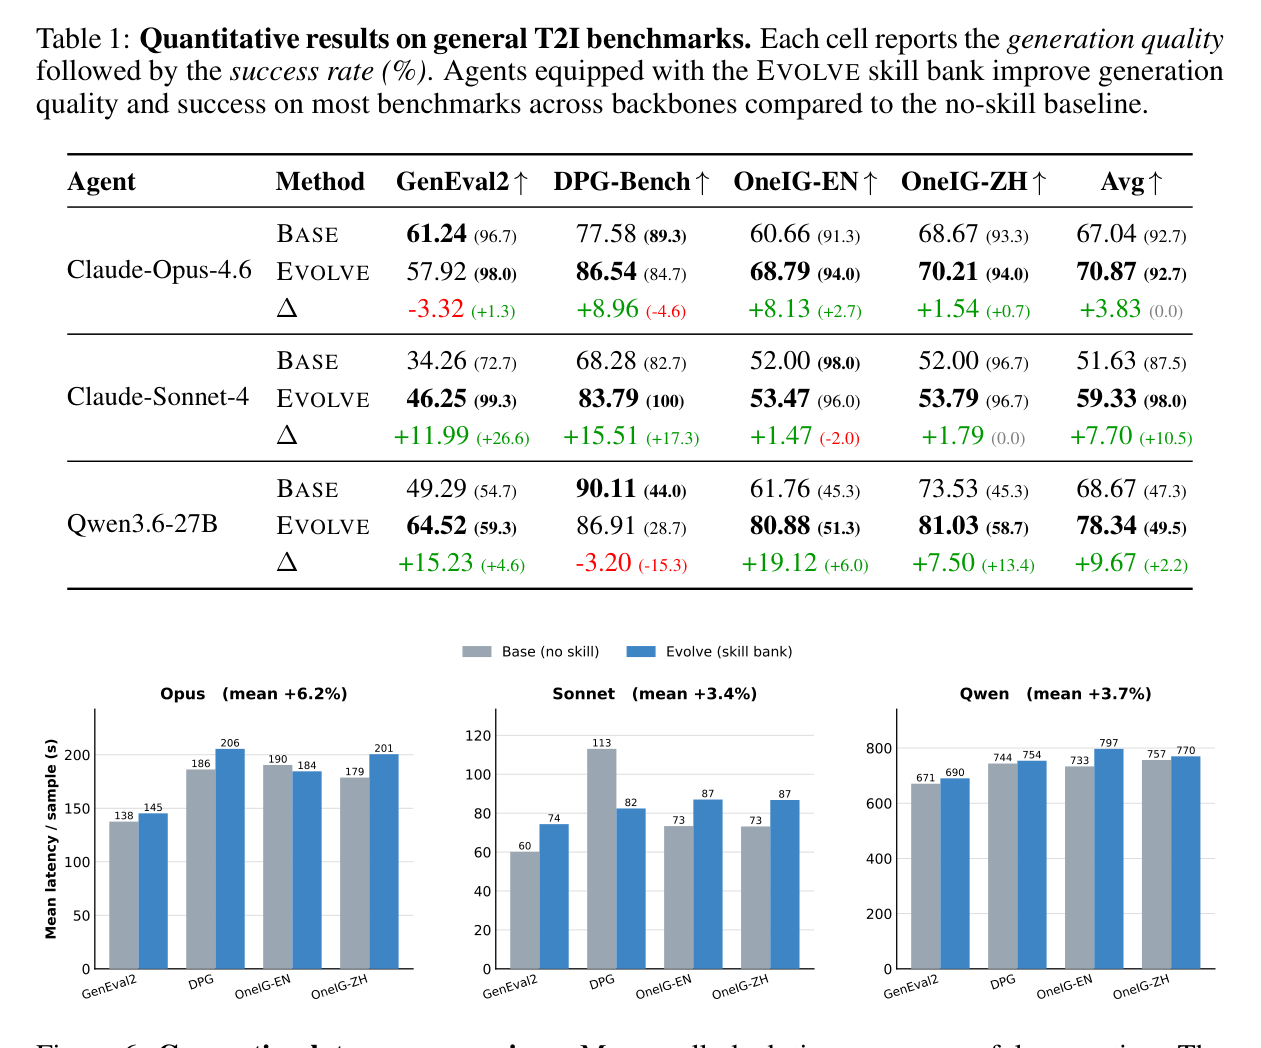
전문 디자인 벤치마크(OpenCOLE, GraphicBench, CreatiDesign, BannerRequest400) 페어와이즈에서는 Claude-Opus-4.6 전체 승률 67.6%, Claude-Sonnet-4 61.8%였고, CreatiDesign에서는 71.7%까지 나왔습니다. 지연시간 오버헤드는 평균 3.4~6.2%에 불과했어요.
두 메커니즘은 같이 써야 한다
절제 실험에서 재작성만 하면 48.6%, 신규 발행만 하면 49.4% 승률인데 둘을 합치면 58.5%(p=0.025)입니다. 완성도도 초동 스킬 68.62에서 74.04로 상승했고, 초동 문서 유래 스킬만 있는 뱅크는 BASE보다 오히려 살짝 못했습니다(46.4% 승률). 문서에서 뽑은 스킬을 그냥 얹는다고 되는 게 아니라는 얘기예요.
궤적도 단조롭지 않습니다. R4는 신규 발행이 몰리며 하단부가 일시 회귀했다가(≥0.3에서 90% vs Base 94%), 재작성 중심의 R5가 하단을 복구하며 모든 역치에서 최강이 됐어요. 발행은 커버리지를 확장하고 재작성은 그 커버리지를 신뢰성으로 바꾸는, 보완 관계로 읽힙니다.
어떻게 쓸 수 있나
- 오라클 없는 롱호라이즌 에이전트(디자인, 문서 작업 등)에 사용자 트래픽 기반 경험 축적을 그대로 옮길 수 있습니다.
- 프론티어 모델이 API로만 쓸 수 있어 파인튜닝이 불가능한 팀에게 실용적인 대안이에요.
- VLM 그레이더 점수 드리프트를 감안해 절대 점수 대신 매칭 리플레이 + 페어와이즈로 판정하는 게이트 설계는 평가 노이즈가 있는 어디에나 적용할 수 있는 패턴입니다.
- 제한점도 분명해요. 결과가 완성도 중심이고 미적 품질·비평 지표는 거의 그대로였으며, 스킬 검색으로 프롬프트 토큰이 약 28% 늘어나는 대가는 있습니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
파인튜닝 없이 에이전트가 일을 배울 수 있나요?
이 논문의 결과로는 가능합니다. 모델 파라미터 대신 외부 SKILL.md 라이브러리를 사용자 트래픽에서 자동 진화시키는 방식으로, 사람 라벨 없이도 실행 성공률을 72.7%에서 99.3%까지 올렸어요. 다만 학습되는 것은 절차 지식이지 모델 자체의 능력이 아닙니다.
절차적 메모리가 일반 RAG와 다른 점은 뭔가요?
문서를 검색해 근거를 가져오는 게 아니라, 실행 이력에서 추출한 재사용 가능한 작업 순서를 검색해 컨텍스트에 주입하고 도구 목록까지 축소해준다는 점이 다릅니다. 스킬마다 성공/실패 통계가 쌓이고 그 이력이 다시 스킬 수정에 쓰여요.
리플레이 게이트는 왜 절대 점수를 쓰지 않나요?
VLM 그레이더의 절대 점수는 같은 이미지에 대해서도 실행마다 흔들리기 때문입니다. 그래서 컨텍스트를 얼려 같은 조건에서 후보/현행을 리플레이하고 페어와이즈로만 판정해서, 그레이더 드리프트와 업스트림 상태 차이를 통제합니다.
논문의 한계는 뭔가요?
오라클이 없는 주관적 평가가 필요한 도메인에 한정된 검증이고, 게인이 완성도 지표에 집중된 점, 스킬 검색으로 프롬프트 토큰이 약 28% 증가한다는 점이 대표적입니다. 또 디자인 전문 도구 환경(230개 이상)에서의 실험이라 다른 도메인 일반화는 별도 확인이 필요해요.
출처
- 원문: arXiv:2609.22086 - Evolving Procedural Memory from User Traffic for Agentic Graphic Design
- 본문 Figure 1(시스템 개요), Figure 2(widening 파이프라인), Figure 5(생존율 곡선), Table 1(T2I 결과)을 이미지로 포함했습니다. 수치는 모두 논문 v1 기준입니다.