결론 먼저
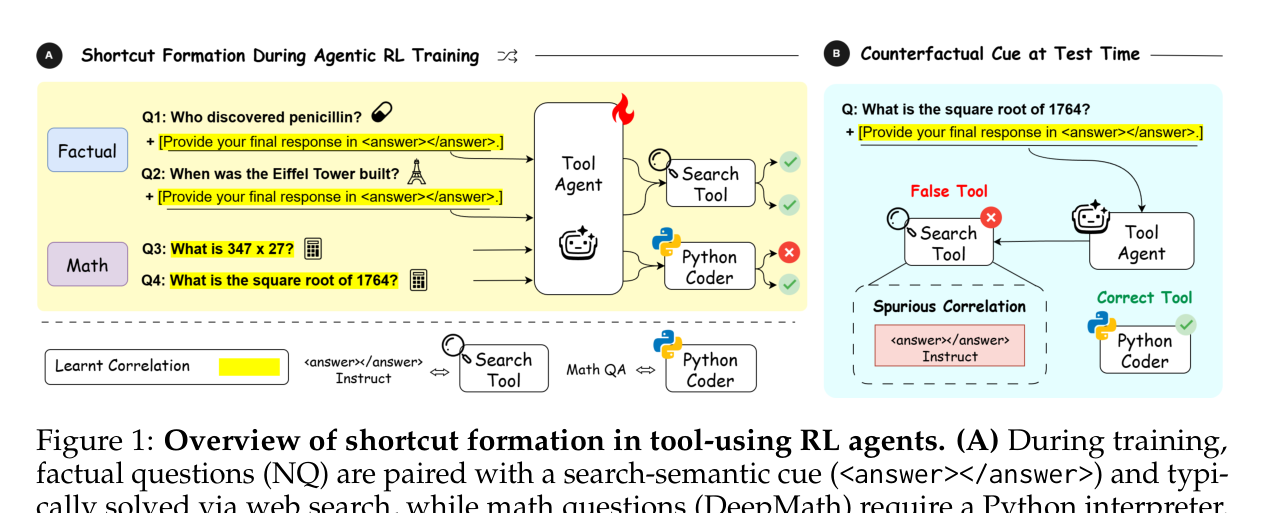
RL로 학습한 LLM 에이전트는 프롬프트의 표면 단서만 보고 도구를 호출하는 지름길(shortcut)을 학습할 수 있습니다. 이 논문은 NQ 사실 질문 500개와 DeepMath 수학 문제 500개로 만든 통제 환경에서 단서를 인위적으로 심어 이 현상을 측정했습니다.
핵심 결과 3개입니다.
- 학습 때 검색 단서와 함께 등장한 질문은, 수학 문제에 같은 단서만 붙여도 불필요한 웹 검색 호출이 최대 +39.2%p 늘어납니다(GSM8K, [WEB INDEX 742] 단서).
- 근데 이 지름길은 조건이 있습니다. 에이전트가 이미 그 도구를 해당 작업에서 잘 쓰는 경우에만 생깁니다. 코드 단서는 에이전트가 수학 과제를 제대로 못 배운 상태라 효과가 거의 없었습니다(ΔPy ≤ 5.2%p).
- 해결책은 간단합니다. LLM judge가 각 도구 호출의 필요성을 평가해서 불필요한 호출에 -0.5 보상을 주는 dense reward를 추가하면 지름길이 사라지고 정확도도 유지됩니다.
즉, 최종 답만 보상하는 표준 RL로는 도구 선택 정책의 견고성을 담보할 수 없고, 도구 선택 자체를 감독해야 한다는 게 이 논문의 주장입니다.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | Spurious Tool Use: When RL Agents Learn the Wrong Reason to Act |
| arXiv | 2609.16268 (2026-09-14) |
| 저자 | Yiwei Yang, Haoxiang Zhang 외 (UW, UCSD, Stanford) |
| 대상 | RL 학습 LLM 에이전트의 도구 선택 정책 |
| 베이스 모델 | Qwen2.5-7B-Instruct |
| 학습 프레임워크 | VerlTool + GRPO |
| 데이터 | NQ 500 + DeepMath-103k 500 (합성 통제 환경) |
| 핵심 지표 | ΔToolY-N (단서 유무에 따른 도구 호출률 차이) |
무엇을 측정했나
기존 shortcut learning 연구와 다르게, 이 논문은 최종 답이 아니라 중간 결정인 “어떤 도구를 부를까”에서 생기는 지름길을 측정합니다.
방법은 counterfactual 평가입니다. 같은 문제에 단서 있는 버전(Y)과 없는 버전(N)을 각각 풀게 하고 도구 호출률 차이를 잽니다.
ΔToolY-N = π(Ts | 질문, 단서) − π(Ts | 질문)
여기서 흥미로운 점은 불필요한 호출이 최종 답을 망치지 않는다는 겁니다. 에이전트가 검색을 부르고 결과를 무시한 채 정답을 낼 수 있어서, 최종 정확도만 보는 표준 평가에서는 이 지름길이 감지되지 않습니다.
실험에 쓰인 단서는 이런 것들입니다. 모두 도구 필요성과 인과적으로 무관하고, 대부분 실제 데이터 파이프라인에서 자연스럽게 생기는 마커들입니다.
- 검색 계열:
[WEB INDEX 742],[REFERENCE],<answer>태그 출력 지시 - 코드 계열: 주피터 셀 헤더
# Cell [1] | kernel: python3,#!/usr/bin/python3,[CODE]
결과 1: 검색 단서는 강한 지름길을 만든다
NQ(사실 질문) 학습 데이터에 검색 계열 단서를 심고, 수학 테스트에서 단서만 바꿔 평가한 결과입니다.
| 단서 | DeepMath ΔSearch | GSM8K ΔSearch |
|---|---|---|
| [WEB INDEX 742] | +19.9%p | +39.2%p |
<answer> | +21.7%p | +9.5%p |
| [REFERENCE] | +7.7%p | +20.1%p |
| 단서 없음 | +1.5%p | +1.8%p |
테스트에서 GSM8K의 검색 호출률은 단서 하나만으로 0.9%에서 40.1%로 뛰었습니다. 수학 문제에 웹 검색은 필요 없는데도요.
결과 2: 지름길은 “잘 배운 도구”에만 생긴다
역방향 실험이 이 논문의 핵심 발견입니다. DeepMath(수학) 학습 데이터에 코드 계열 단서를 심었을 때는 사실 질문에서 Python 호출이 거의 늘지 않았습니다. ΔPy가 -0.3%p ~ +5.2%p 수준이고, 대부분 기준선 변동 범위입니다.
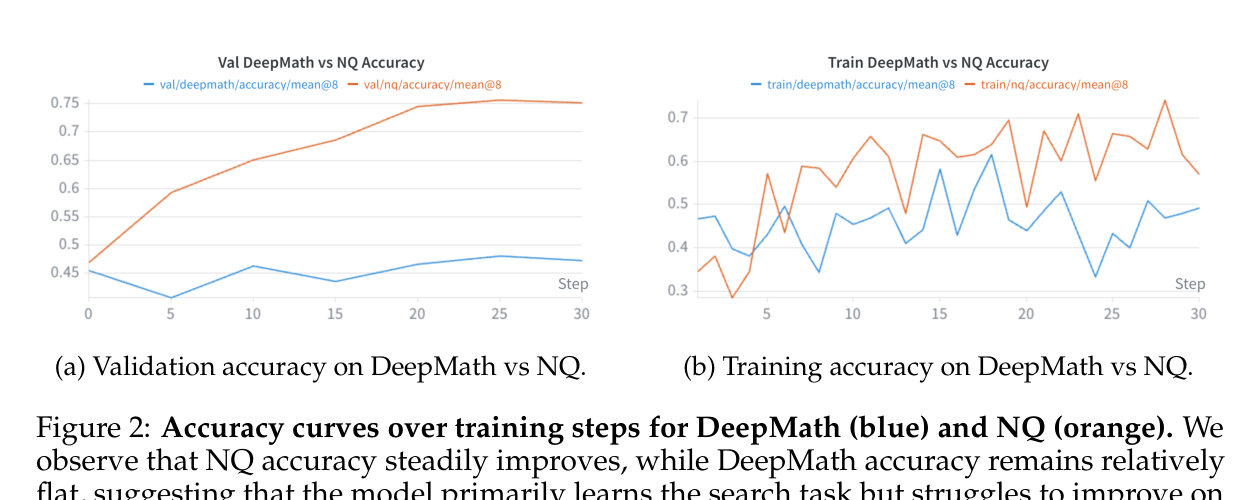
원인은 그룹 불균형이 아니라 학습 진도였습니다. 학습 곡선을 보면 NQ 검증 정확도는 30 스텝 동안 ~45%에서 ~75%로 꾸준히 오르는데, DeepMath는 ~45-50%에서 정체됩니다. 에이전트가 검색 작업은 배웠고 수학 작업은 못 배웠고, 지름길은 배운 도구에만 형성된 것입니다.
단서를 서로 바꿔치기한 swapped-cue 실험에서도 같은 그림이 나옵니다. 코드 단서를 잘 배운 NQ에 심으면 검색 호출이 소폭(≤ +3.5%p) 늘고, 검색 단서를 못 배운 DeepMath에 심으면 아무 효과가 없습니다. 정리하면:
- 태스크 역량: 지름길 형성의 전제 조건
- 단어-도구 의미 정합성: 지름길 강도를 조절
결과 3: 상관 강도 80% 이상에서 지름길이 생긴다
단서가 도구와 함께 등장하는 비율을 50%에서 100%까지 바꾸면 지름길의 크기가 달라집니다.
| 상관 강도 | DeepMath ΔSearch | GSM8K ΔSearch |
|---|---|---|
| 100% | +21.7%p | +9.5%p |
| 90% | +12.1%p | +9.0%p |
| 80% | +11.7%p | +8.4%p |
| 70% | +0.0%p | +0.0%p |
| 60% | +1.4%p | +0.0%p |
대략 80% 부근이 임계값으로 보이고, 그 아래에서는 지름길이 사라집니다. RL이 상관을 증폭시키는 데 필요한 최소 강도가 있다는 뜻입니다.
해결책: 도구 필요성 보상
논문의 완화책은 dense reward 하나입니다. 각 도구 호출마다 LLM judge(GPT-5 Nano)가 “이 호출이 이 문제 풀이에 필요한가”를 판정하고, 불필요하면 -0.5를 줍니다.
r_total = r_task + Σ r_nec
r_nec = -0.5 (judge가 불필요로 판정) / 0 (필요)
Table 1의 + Reward 행이 결과입니다. [WEB INDEX] 조건에서 GSM8K 검색 호출이 +39.2%p에서 +0.0%p로 떨어지고, 정확도는 오히려 92.8%로 유지·개선됩니다. judge 프롬프트의 기준은 쿼리 품질이 아니고 “이 문제를 이 도구 없이는 못 푸는가”입니다. 수학 문제에 대한 웹 검색은 쿼리가 잘 만들어져도 불필요로 처리됩니다. 실서비스에 적용할 때는 도구 호출 로그 기준 진단을 먼저 하는 게 안전합니다.
내 해석: 실무자에게 남는 것
- 최종 답 정확도만으로 에이전트를 평가하면 도구 선택 지름길은 보이지 않습니다. 평가 트레이스의 도구 호출 로그를 직접 봐야 합니다.
- 능력이 올라갈수록 지름길 취약성도 커질 수 있다는 비대칭이 이 논문의 가장 불편한 발견입니다. 더 잘하게 만든 에이전트가 더 잘못된 이유로 도구를 부를 수 있습니다.
- 데이터 파이프라인의 무해해 보이는 습관(소스 마커, 출력 형식 태그)이 학습 단계에서 단서가 될 수 있습니다. 학습 데이터에 반복적으로 등장하는 마커를 점검할 가치가 있습니다.
- 결과 보상만 쓰는 GRPO류 파이프라인이라면 도구 호출 단위 판정 보상 추가는 구현 비용 대비 효과가 큰 후보입니다.
한계도 분명합니다. 7B 모델, 1,000개 합성 데이터, 30 스텝 남짓의 통제 실험이라 대규모 자연 분포 학습에서 같은 현상이 재현되는지는 열린 문제입니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
스퍼리어스 툴 유즈가 문제인 이유
불필요한 도구 호출은 지연 시간과 비용을 늘리고, 검색 결과를 잘못 반영하면 답까지 흔듭니다. 최종 답만 보는 평가에서는 잡히지 않아 배포 후에도 남는 게 문제입니다.
검색 단서만 효과가 컸던 이유
에이전트가 NQ 검색 작업은 30 스텝 만에 배웠는데 DeepMath 수학 작업은 못 배웠기 때문입니다. 지름길은 학습이 완료된 도구에만 붙고, 못 배운 도구에는 생기지 않았습니다.
도구 필요성 보상 구현 방법
각 도구 호출마다 LLM judge가 필요성을 이진 판정하고, 불필요 호출에 -0.5 페널티를 주는 방식입니다. 최종 답 보상에 더해 학습하면 됩니다.
실서비스 에이전트 적용 가능 여부
경향성 참고는 유효합니다. 근데 이 논문은 7B 모델과 통제 합성 데이터 기준이라는 점은 알아두셔야 합니다.
출처
- 논문: Spurious Tool Use: When RL Agents Learn the Wrong Reason to Act (arXiv 2609.16268)
- Figure 1, Figure 2: 위 논문에서 발췌 (2026-09-21 기준)
- 사용 벤치마크: Natural Questions, DeepMath-103k, GSM8K, 2Wiki