결론 먼저
여러분의 에이전트가 방금 검색한 메모리, 믿어도 될까요? 대부분의 RAG 시스템은 이 질문을 하지 않는다. 검색하면 주입한다. Tianjin University of Technology의 새 논문(arXiv 2609.22043, 2026-09-18 v1)이 이 낙관이 얼마나 비싼지 보여준다.
제안은 Memory Decision Layer(MDL), 검색과 생성 사이에 앉히는 학습 파라미터 0개의 판단 컨트롤러다. 관련성·신뢰성·리스크 세 신호를 기하 연산만으로 융합해, 메모리를 주입할지 말지 4단계로 결정한다.
충격적인 출발점 하나. 메모리 저장소에 정답과 오답이 섞여 있으면 표준 RAG의 할루시네이션율은 53.0%. 메모리를 아예 안 쓰는 베이스라인 23.0%보다 두 배 넘게 높다 (p = 0.007). 검색기는 어떤 메모리가 관련 있는지만 답하지, 믿어도 되는지는 답하지 않는다.
핵심 정보 표
| 항목 | 내용 |
|---|---|
| 논문 | An Interpretable Memory Decision Controller for LLM Agents (arXiv 2609.22043, 2026-09-18 v1) |
| 소속 | Tianjin University of Technology |
| 제안 | Memory Decision Layer(MDL), 검색~생성 사이 판단층 |
| 입력 신호 | 관련성 M, 신뢰성 R, 태스크 리스크 A |
| 출력 | 4단계 동작(Active/Supp/Silent/Opt-Out) + 감사 스칼라 C, α |
| 일반 시나리오 환각 감소 | 약 56.04% |
| 고위험 시나리오 환각 | 0.0% (표준 RAG 63.0%) |
| 판단 지연 | 약 0.14 ms (판당 40.1 µs) |
| 원문 | arXiv abs · PDF |
기준일: 2026-09-18 arXiv v1 공개 기준.
어떻게 동작하나
영감은 마카크 전전두피질의 메타기억 연구다. 뇌는 기억을 쓰기 전에 작업기억 강도·시행 이력·각성 수준을 거의 독립적인 부분공간에 인코딩해 융합한다(Ning et al.). MDL이 이 구조를 그대로 벤치마킹했다.
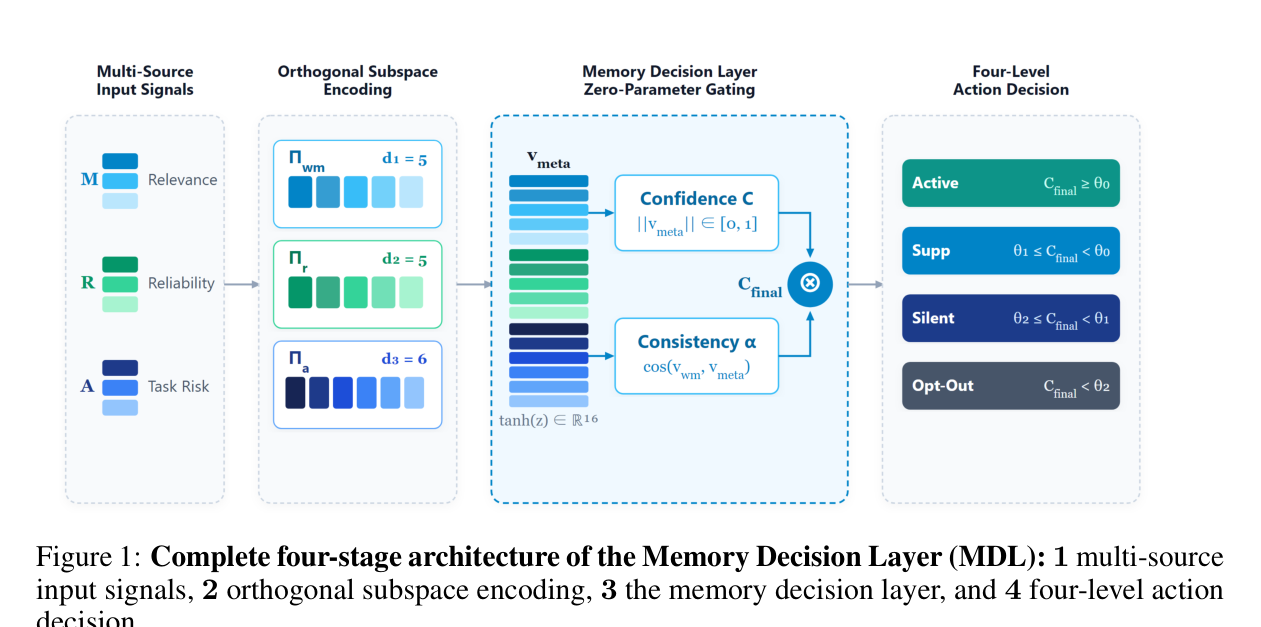
Figure 1. MDL의 4단계 구조. 다중 신호 입력 → 직교 부분공간 인코딩 → 판단층 → 4단계 동작 결정.
세 신호의 정의는 이렇다.
| 신호 | 의미 | 계산 |
|---|---|---|
| 관련성 M | 질의와 후보 메모리의 최대 코사인 유사도 | all-MiniLM-L6-v2 임베딩 |
| 신뢰성 R | 관련 메모리 간 평균 유사도 × 충돌률 보완 | clip(s̄·(1−φ)², 0, 1), 어휘 충돌 탐지기 포함 |
| 태스크 리스크 A | 도메인 위험 계수 | 의료/법률/금융 ≥ 0.70, 등급 매핑 |
가장 재치있는 설계는 리스크 반전 인코딩 s = 1 − A다. 고위험일수록 활성값을 낮춰서 시스템이 자발적으로 기각(Opt-Out)하도록 만든다. 의료 질문에 오래된 약전이 걸리면 그냥 거절된다. 별도 규칙 없이 기하 구조가 안전망이 되는 셈이다.
두 번째 포인트는 C–α 분리. 최종 판단값은 C_final = C·(0.3 + 0.7α)로, 신뢰도 C(놈)가 높아도 일관성 α(코사인)가 낮으면 채택되지 않는다. 확신은 있는데 방향이 틀린 경우를 잡는 게이트다. 두 스칼라는 감사 인터페이스로 그대로 노출된다.
실험 결과
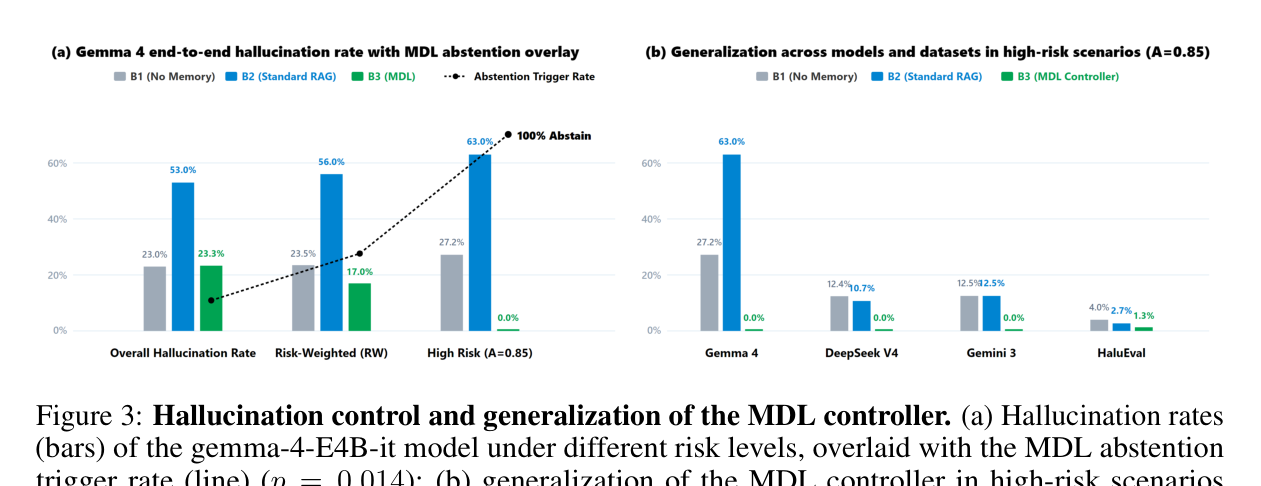
Figure 3. 리스크 수준별 할루시네이션율과 MDL 기각 트리거율 (gemma-4-E4B-it).
| 조건 | 표준 RAG | MDL |
|---|---|---|
| 충돌 메모리 전체 | 53.0% | 23.3% |
| 중위험 | 52.6% | 27.6% |
| 고위험 (A=0.85) | 63.0% | 0.0% |
교차 모델 결과도 비슷하다. 추론이 강한 deepseek-v4-flash에서 표준 RAG 전체율은 4.3%로 낮아지지만 고위험 구간에서 MDL만 0.0%를 기록한다(TruthfulQA 고위험, 200문항 × 3 시드). HaluEval 고위험에서도 2.7% → 1.3%로 가장 낮았다.
Self-RAG 비교가 흥미롭다.
| 시스템 | 전체 환각 | 고위험 | 거절률 | 추가 LLM 호출 |
|---|---|---|---|---|
| 표준 RAG | 4.8% | 11.9% | 88.0% | 0 |
| CRAG (프롬프트) | 5.0% | 5.9% | 64.5% | 다수 |
| Self-RAG (프롬프트) | 0.5% | 0.0% | 83.3% | 약 2.1회/질문 |
| MDL | 4.8% | 0.0% | 87.7% | 0회, 0.14 ms |
프롬프트 기반 CRAG은 이 벤치마크에서 400개 중 400개 저장소를 Ambiguous로 판정해 사실상 RAG로 퇴화했다. Self-RAG는 전체율 0.5%까지 낮추는데, 그 대가로 질문당 2.1회 LLM 호출과 83.3% 거절률이 비용이다. MDL은 추가 LLM 호출 없이 고위험 환각만 소거하고 감사 스칼라까지 준다.
세 신호는 정말 다 필요한가
신호 조합 분석(N=3,600 레코드)에서 단일 신호 정확도는 전부 58.1%다. R+A 조합이 62.7%로 3신호 전체(61.2%)보다 살짝 높다. 그럼 관련성 M은 쓸모없나?
저자의 분해가 답한다. 저관련 구간(M < 0.4) 45개 레코드에서 M을 추가하면 기각률이 20.0% → 40.0%로 오른다. M의 역할은 전역 정확도를 올리는 것과 별개로, 무관 노이즈를 차단하는 안전 신호다. 정보이론 분석에서 3신호 결합 시 비선형 시너지 +0.007 bits도 관측됐다.
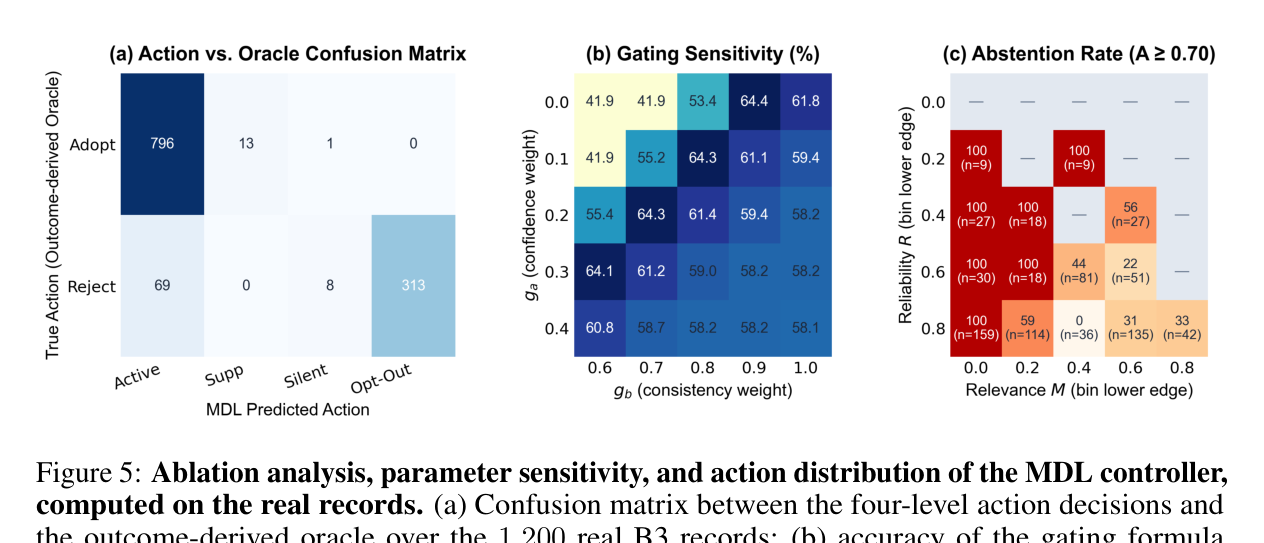
Figure 5. 제거 실험·파라미터 감도·동작 분포.
제거 실험에서 값 인코딩 제거 시 정확도 17.8%p 급락, 리스크 반전 제거 시 5.5%p 손실이었다. 정직한 보고도 하나 있다. 직교 부분공간을 항등 투영으로 바꾸면 정확도가 오히려 +2.8%p 오르는데, 저자는 직교 구조의 가치를 정확도 밖에서 찾는데, 감사 가능성과 에너지 보존에 둔다고 못박는다.
내 해석과 한계
원문 근거와 필자 해석을 구분해 적는다.
- (원문) 판단 지연 0.14 ms, 고위험 환각 0%. (해석) 에이전트 파이프라인에 부담 없는 안전망이다. 임베딩 유사도와 어휘 충돌 탐지기만 있으면 재현 가능하다.
- (원문) 검색 점수가 낮은 메모리의 기각 가치. (해석) 저관련 검색 결과를 그냥 버리는 간단한 규칙만으로도 안전성 이득이 있다는 뜻이다. 복잡한 메커니즘 전에 시도할 저렴한 세이프가드다.
- (한계) 리스크 계수 A가 카테고리·키워드 하드코딩이다. 실서비스 도메인에서 이 매핑 유지가 숙제다. 임계값 θ도 80문항 보정 분할에 의존한다. 평가는 TruthfulQA·HaluEval 중심이라 실제 에이전트 장기 메모리(도구 결과 캐시, 경험 메모리 등) 검증은 후속 과제다.
더 실습해보고 싶은 분들께
자주 묻는 질문
Q1. MDL이 동작하는 위치와 방법
검색 계층과 생성 계층 사이다. 검색된 후보 메모리마다 관련성·신뢰성·리스크를 계산해 Active(전체 주입)/Supp(보조)/Silent(침묵)/Opt-Out(명시적 기각)으로 매핑한다. 주입 전에 판단하므로 컨텍스트 오염을 예방한다.
Q2. 성능 비용이 얼마나 되는지
학습 파라미터 0개, 기하 연산만 사용한다. 판당 40.1 µs, 신호 집계 포함 약 0.14 ms로 선행 임베딩 검색의 약 50배 빠르고 LLM 자기평가 호출보다 4~5자릿수 빠르다.
Q3. 고위험에서 0%가 나오는 이유와 원리
리스크 반전 인코딩(s = 1 − A)이 고위험일수록 활성값을 낮춰 신뢰도 놈을 줄인다. 그 결과 명시적 기각이 자발적으로 트리거되어, 위험 도메인 질의는 메모리 주입 없이 회피 응답으로 빠진다.
Q4. C와 α의 차이가 왜 중요한지
C는 v_meta의 놈에서 나오는 확신 크기, α는 관련성 벡터와의 코사인으로 계산하는 방향 일관성이다. 게이트식 C_final = C·(0.3 + 0.7α)에서 α가 낮으면 C가 높아도 채택되지 않는다. 두 값은 통계적으로 독립이 아니지만 독립적으로 감사 가능한 인터페이스다.
Q5. Self-RAG 대비 MDL의 장점
프롬프트 기반 Self-RAG는 전체 환각율 0.5%까지 낮추지만 질문당 약 2.1회의 LLM 호출과 83.3% 거절률이 비용이다. MDL은 추가 호출 없이 고위험 0.0%를 달성하고 감사 스칼라를 제공한다. 전체율 자체는 표준 RAG와 동급(4.8%)이다.
참고 링크
- 원문: An Interpretable Memory Decision Controller for LLM Agents (arXiv 2609.22043)
- 배경 관측: TruthfulQA, Self-RAG, CRAG, Reflexion, HippoRAG, Mem0
- 신경과학 근거: Ning et al., 마카크 전전두피질 메타 작업기억 연구(논문 내 인용 [17])
본 글은 arXiv 2609.22043 v1 (2026-09-18) 초록·본문을 근거로 작성된 논문 요약이며, “내 해석” 섹션은 원문 주장과 구분된 필자 의견이다.