결론 먼저
LLM 에이전트에 장기 메모리를 붙일 때 가장 중요한 질문은 “얼마나 잘 기억하나”보다 “기억한 사실이 실제 도구 호출을 바꾸는가” 입니다. 이 논문은 그걸 직접 측정한 벤치마크입니다.
핵심 결과 3개입니다.
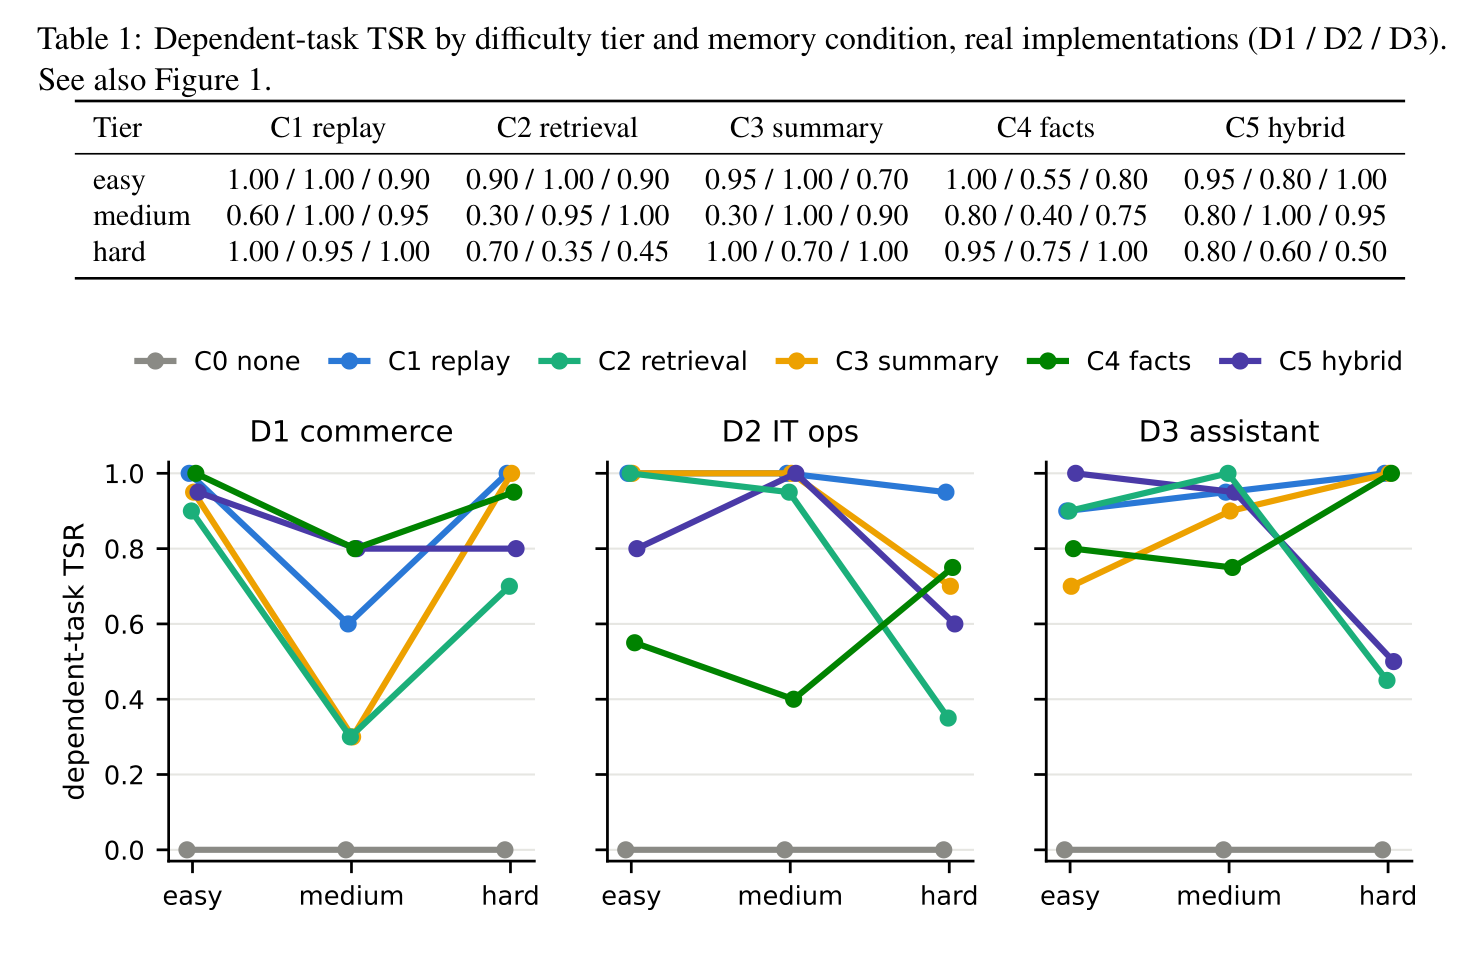
- 메모리가 없으면 이전 회차 사실이 필요한 작업은 전부 실패합니다(C0 의존 작업 성공률 0.00). 메모리를 붙이면 0.55-1.00까지 오릅니다. 누수 없이 설계된 바닥이라는 게 검증됐다는 게 포인트입니다.
- 근데 사실이 갱신되면(주소 변경, 설정 변경) 임베딩 검색 기반 메모리는 예측 불가능하게 무너집니다(0.30-0.95, 시드 간 최대 격차 0.45). 쓸 때 덮어쓰는(update-on-write) 방식은 0.70-1.00을 유지합니다.
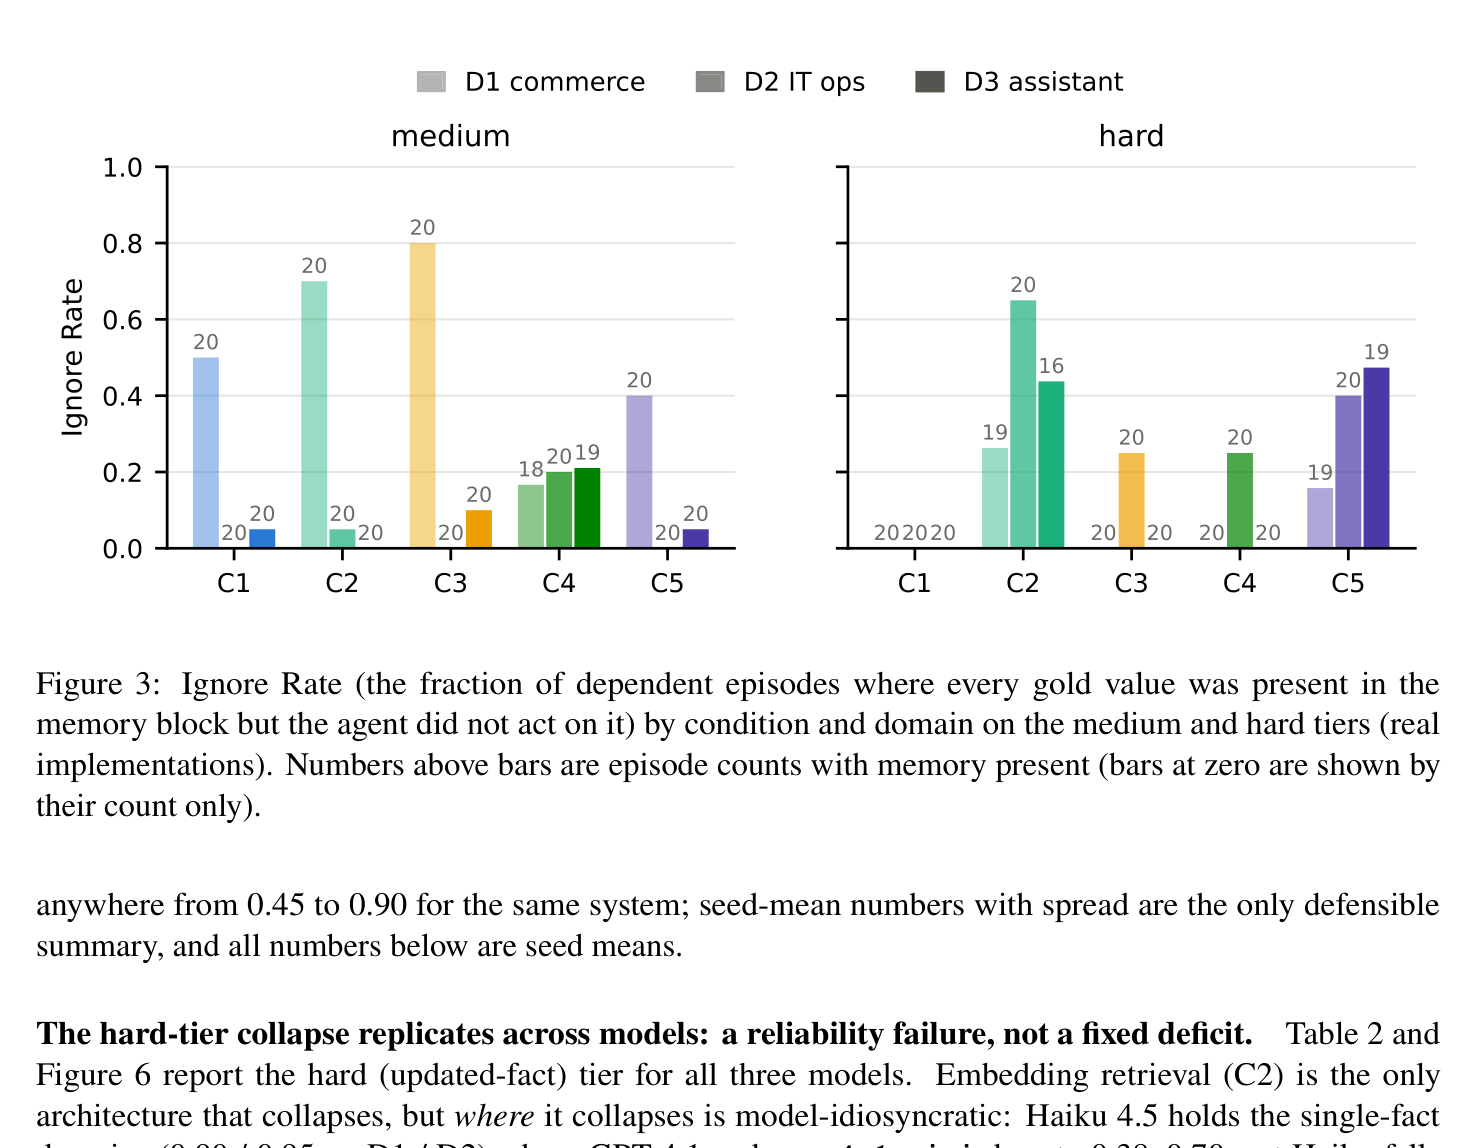
- 에이전트가 정답을 이미 컨텍스트에 갖고 있으면서도 행동하지 않는 Ignore Rate가 0.45-0.53입니다. 메모리 시스템 정확도만 보면 이 실패가 안 보입니다.
즉, “어떤 메모리 아키텍처를 고를까”가 “어떤 제품을 고를까”보다 먼저이고, 갱신되는 사실이 있다면 검색형보다 덮어쓰기형이 우선이라는 게 이 논문의 실무 결론입니다.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | When Does Memory Help? A Cost-Aware Evaluation of Long-Term Memory in Tool-Using LLM Agents |
| 벤치마크명 | MERIT (Memory Evaluation for Realistic Instrumented Tasks) |
| arXiv | 2609.05441 (2026-07-26) |
| 코드/트레이스 | github.com/smshweta/merit-bench |
| 실험 규모 | 23,440개 채점 에피소드, API 비용 $42.57 |
| 모델 | gpt-4.1-mini(파일럿+3시드), GPT-4.1, Claude Haiku 4.5, Claude Sonnet 5 스팟 |
| 기준일 | 2026-09-21 기준 논문 v1 |
기존 평가의 3가지 맹점
기존 장기 메모리 평가(LoCoMo, LongMemEval, BEAM)는 대화 이력에 대한 QA입니다. 논문이 지적하는 맹점입니다.
- 맹점 1 — 대화 QA는 작업 수행이 아니다. 프로덕션 에이전트는 기억한 사실로 올바른 도구 호출을 골라야 합니다. 정확한 고객 ID, 지난번 합의된 환불 금액처럼요. 대화 리콜 점수가 작업 수행 효용으로 이어지는지는 열린 문제였습니다.
- 맹점 2 — 메모리가 해를 끼치는 경우를 안 잰다. 오래된 주소, 롤백된 설정 같은 낡은 메모리는 안 쓰는 것보다 못합니다. 자신만만하게 틀린 행동으로 이어지거든요.
- 맹점 3 — 한계효용을 안 잰다. 메모리 시스템은 토큰 수만 보고합니다. 실무자의 질문은 경제적입니다. “메모리를 붙여서 성공률이 오른 만큼이 비용을 정당화하는가?”
MERIT는 이 셋을 전부 잰 벤치마크입니다.
MERIT는 어떻게 생겼나
환경 구조입니다.
- 에피소드 = 시뮬레이티드 유저 + 도구 API + SQLite로 된 변경 가능한 월드 상태. 성공은 최종 월드 상태에 대한 프로그래밍 판정으로 결정합니다. 답변 텍스트 대신 행동 결과로 채점합니다.
- 4-6개 에피소드로 된 arc. 안에는 사실을 심는 plant 에피소드, 사실을 갱신하는 update 에피소드, 그 사실이 없으면 풀 수 없는 probe 에피소드가 들어갑니다.
- 도메인 3개: 고객 지원(커머스), IT 운영, 개인 비서.
- 난이도 사다리: easy(사실 1개) → medium(여러 사실 조합) → hard(사실이 갱신되어 최신 값이 필요).
- 자동 leak check로 probe 입력에 금값이 없고 도구로 재유도도 안 되는지 생성 시점에 검증합니다. delta scoring으로 이전 에피소드가 세계 상태를 이미 바꿔놓은 상속 성공도 차단합니다.
메모리 조건 6가지를 같은 인터페이스(write/read)로 돌립니다.
| 조건 | 방식 |
|---|---|
| C0 | 메모리 없음 |
| C1 | 이전 대화 전체 리플레이 |
| C2 | 검색(스타터: 키워드, 실구현: 임베딩 text-embedding-3-small) |
| C3 | 롤링 요약(스타터: 잘라내기, 실구현: LLM 요약) |
| C4 | 구조화 팩트 스토어, 쓸 때 덮어쓰기 |
| C5 | 하이브리드(C4 + C2) |
새 지표 3개도 나옵니다. MUR(메모리 활용률), Ignore Rate, CAMU(비용 조정 한계효용). 통계는 arc 단위 클러스터 페어드 부트스트랩 + Holm 보정이고 가설은 사전등록했습니다.
결과 1: 메모리는 진짜로 도움이 된다, 단 조건이 있다
C0(메모리 없음)는 의존 작업 9개 셀 전부에서 0.000입니다. leak check가 유지되므로 메모리 말고는 금값에 닿는 경로가 없다는 뜻입니다. 반면 메모리가 없어도 독립 작업은 0.83-1.00이라 작업 자체는 풀 수 있는 환경입니다.
easy 난이도에서는 모든 메모리 조건이 C0를 이깁니다(ΔTSR +0.55 ~ +1.00, Holm 보정 p ≤ 0.001).
근데 hard로 가면 갈립니다.
- C1 리플레이: 0.95-1.00 유지. 시간순으로 읽으면 최신 값이 뭔지 해결되니까요.
- C4 팩트 스토어: 0.75-1.00. 덮어쓰기니까 갱신에 강합니다.
- C2 임베딩 검색: 0.35-0.70으로 붕괴. 검색은 낡은 값과 새 값을 나란히 돌려주는데 최신성 판단 신호가 없습니다.
- C5 하이브리드: 0.50-0.80. 더 좋은 절반보다 못합니다. 검색 절반이 팩트 스토어가 지운 낡은 값을 다시 끌어들이거든요.
흥미로운 건 C3 LLM 요약입니다. 매 에피소드 요약을 다시 쓰다 보니 자연스럽게 최신 값이 남습니다. 그래서 하드 티어에서 1.00/0.70/1.00으로 update-on-write처럼 동작합니다.
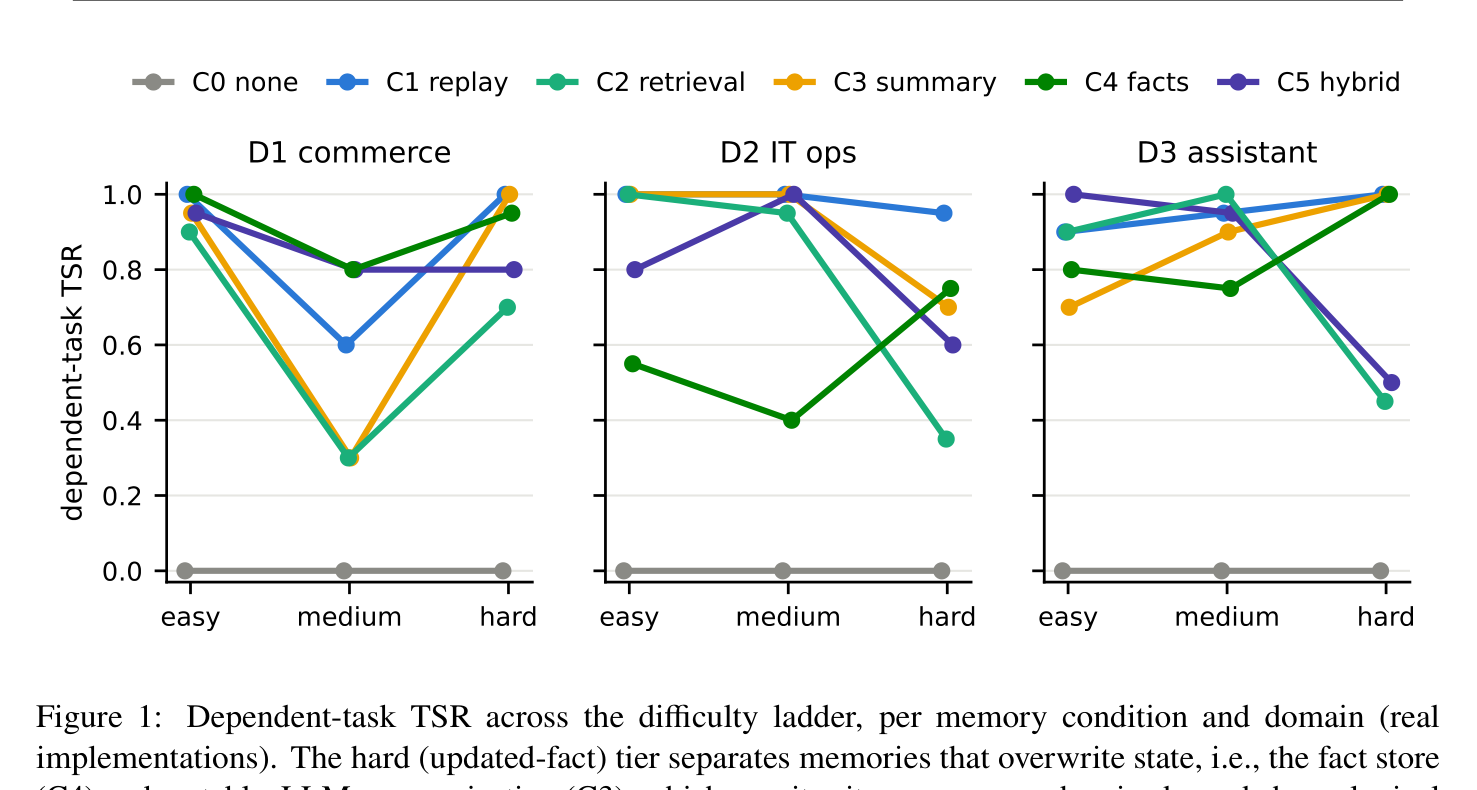
전체 수치는 Table 1에 있습니다.
결과 2: 갖고 있는데 안 쓰는 에이전트
하드 티어에서 C2의 검색 블록에 정답(최신 값)이 들어 있던 probe가 55건이었는데, 에이전트가 그걸 행동으로 옮긴 건 30건입니다. Ignore Rate 0.45. 검색 품질을 올려도 거의 안 변합니다.
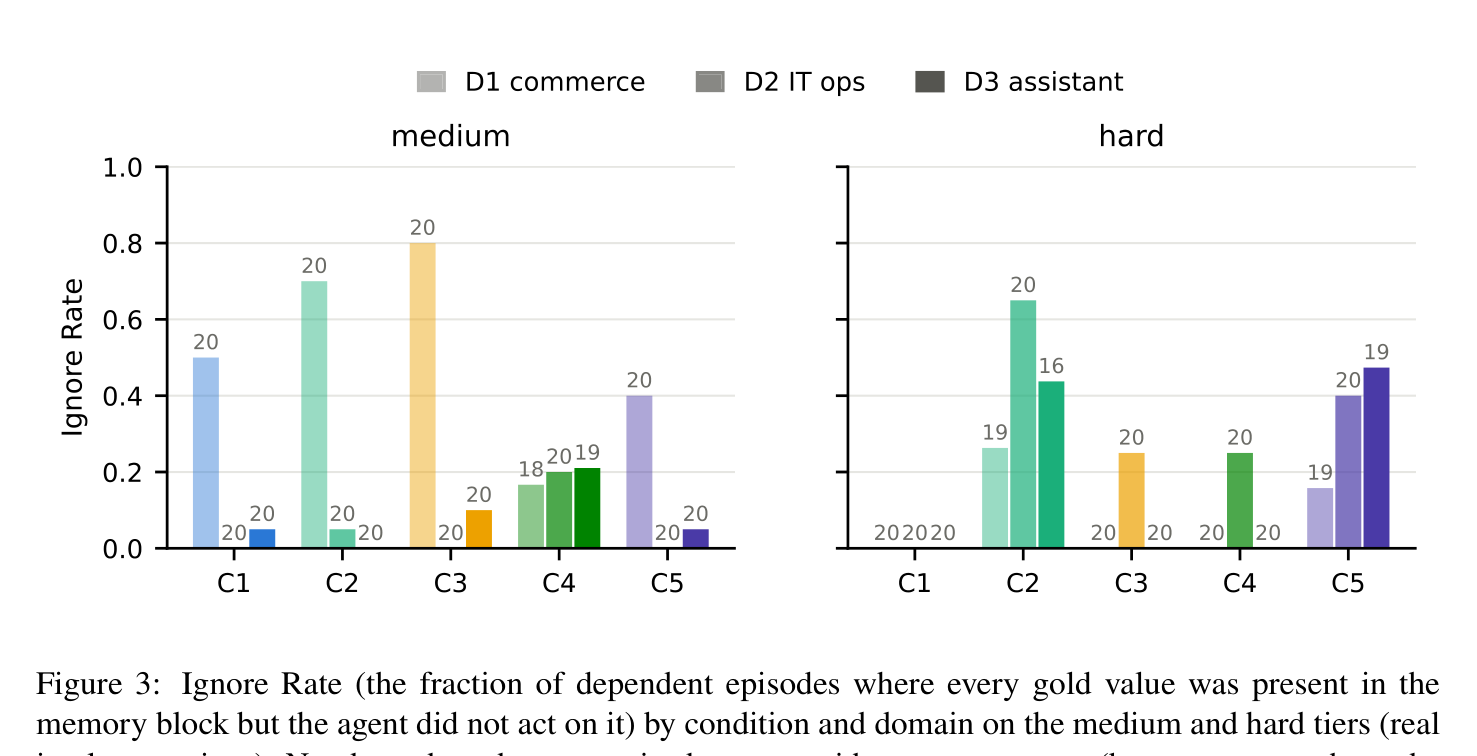
미디엄 티어에서는 C1(깨끗한 전체 대화 리플레이)조차 최대 0.50를 무시합니다. 정보를 갖는 것과 그걸 조합해 쓰는 건 다른 능력이라는 뜻입니다. 메모리 시스템 벤치마크 점수만 믿으면 이 실패를 놓칩니다.
결과 3: 시드와 모델을 바꿔도 붕괴는 재현된다
3시드 × 3모델 사전등록 그리드(메모리 쪽은 고정) 결과입니다.
- 시드 분산은 C2에 집중돼 있습니다. 최대 시드 간 격차 0.45(gpt-4.1-mini, D1-hard: 0.45/0.90/0.75). 단일 시드 평가로는 같은 시스템의 하드 티어 점수를 0.45~0.90 사이 아무 데나 보고할 수 있습니다.
- 모델을 바꿔도 C2만 무너집니다. 근데 어디서 무너지는지는 모델마다 다릅니다. Haiku 4.5는 D1/D2를 0.90/0.95로 지키다가 다중 사실 D3에서 0.30으로 가장 크게 무너집니다. GPT-4.1은 D2에서 0.45.
- C3 LLM 요약은 모든 모델×도메인×시드에서 0.80-1.00. C4도 0.70-1.00입니다.
- Claude Sonnet 5(2026세대) 스팟 체크에서도 같은 패턴. C2 0.75, C3/C4 1.00.
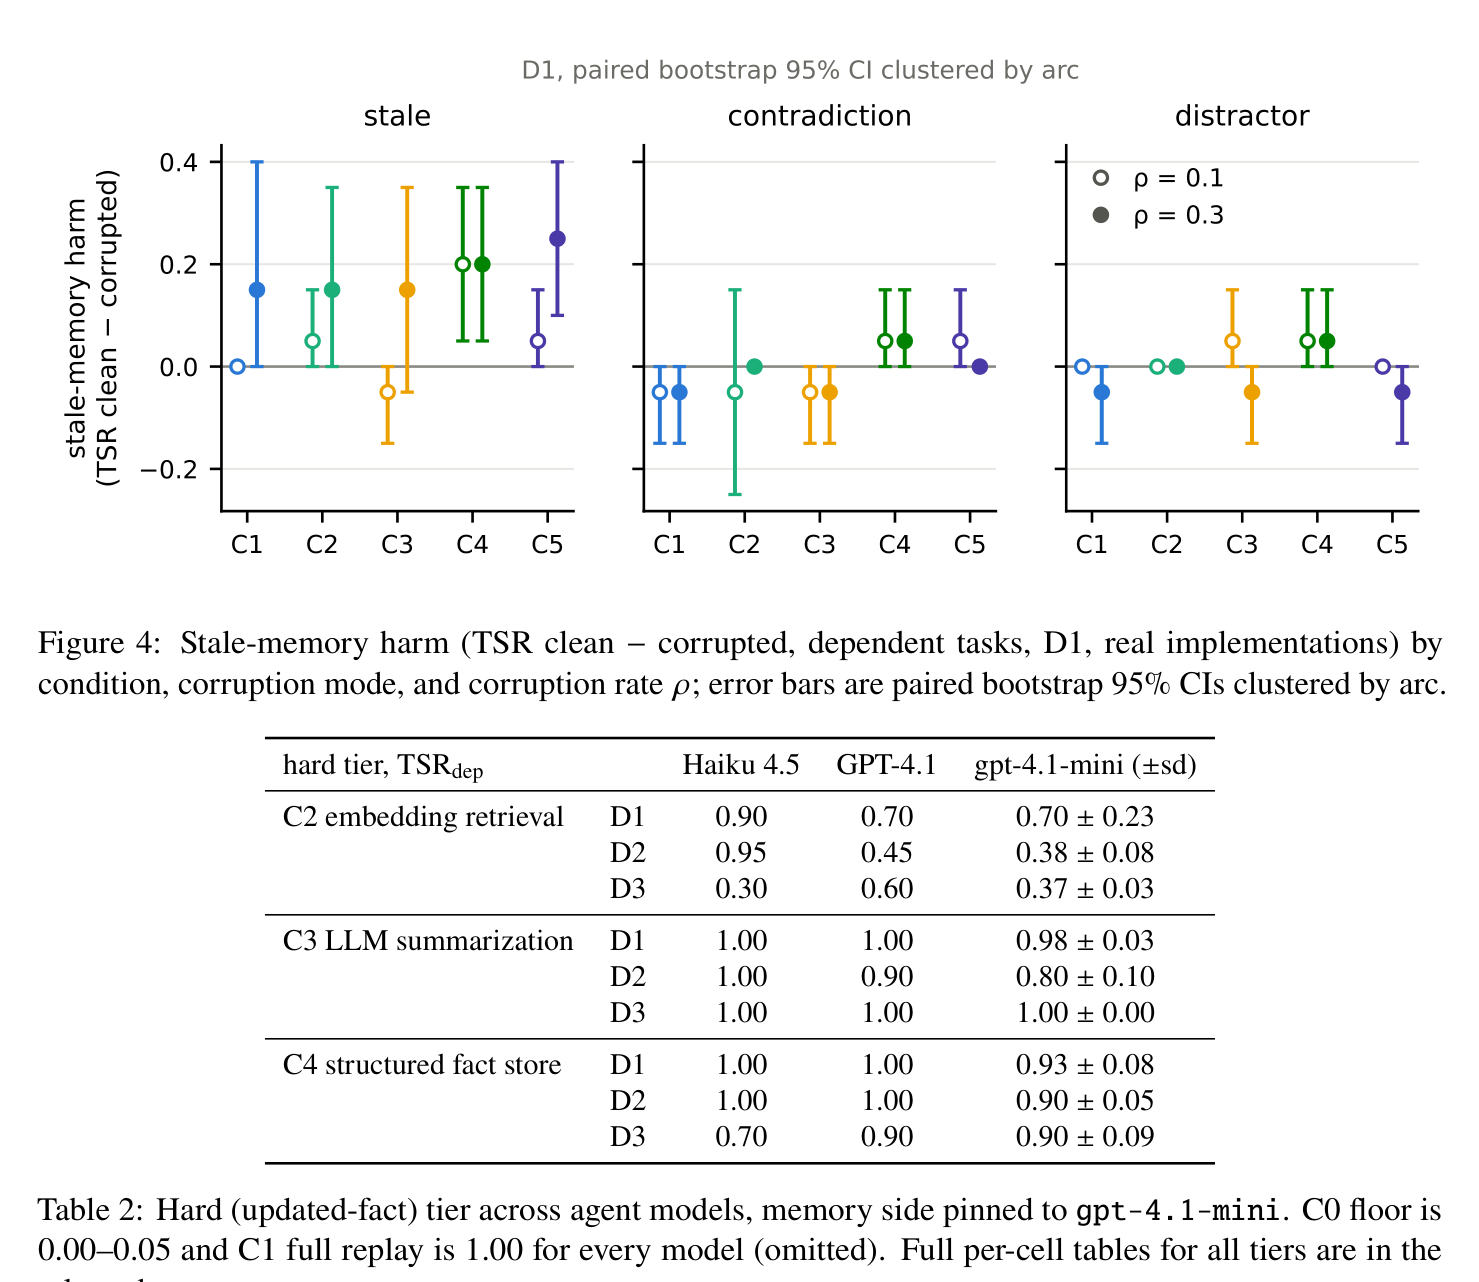
정리하면 임베딩 검색의 갱신-사실 약점은 예측 불가능성이 핵심 문제입니다. 성공 여부가 “그 에이전트가 검색 컨텍스트 안의 낡음-vs-최신 충돌을 해결하는가”에 달렸는데, 이 능력이 모델 티어에 대해 단조롭지 않게 변합니다.
결과 4: 낡은 메모리의 해로움
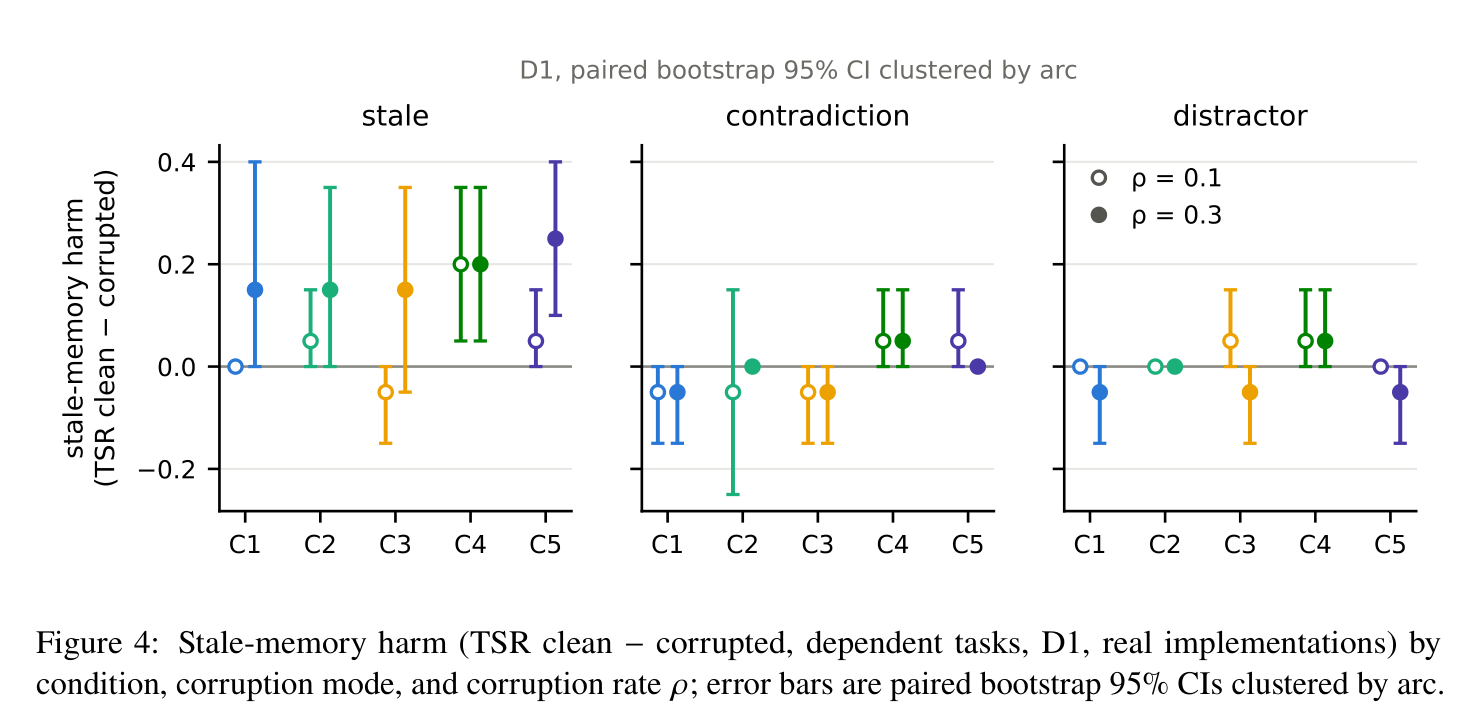
낡은/모순/교란 레코드를 알려진 비율(ρ=0.1, 0.3)로 주입해서 측정합니다(SMH = clean TSR − corrupted TSR).
- 가장 크고 유일하게 Holm 유의한 해로움은 하이브리드 C5(SMH +0.25, ρ=0.3, p=0.030).
- 흥미로운 역전: LLM 추출로 바꾼 C4는 +0.20의 낡음 피해를 봅니다(raw p=0.013). 정규식 C4는 ≤0.05였는데, LLM 추출기가 정규식이 걸러내던 오염 레코드를까지 흡수하기 때문입니다.
결과 5: 비용 대표 한계효용 (CAMU)
메모리 쪽 호출까지 전부 계량한 에피소드당 비용(D1-easy): C0 0.00066, C2 0.00095, C5 0.00111, C1 <span style="background-color: #fff59d"><strong">0.00126(에피소드당 2,914 토큰, C0의 2.7배).
CAMU 랭킹은 정확도 랭킹과 도메인마다 다릅니다. D1/D3 최고는 C4(각 4,839, 3,245 pts/). 전체 리플레이는 어디서도 경제적 최선이 아닙니다(1,222-1,741 pts/$, 도메인별 최고 대비 2.7-3.9배 나쁨).
손익분기 과업 가치는 모든 조건에서 1센트의 몇 분의 1 수준입니다. 메모리가 작동만 하면 비용은 문제가 되지 않고, 실무 기준은 원가보다 견고성입니다. 절대 CAMU 수치는 2026년 중반 API 가격 기준이라 드리프트됩니다.
내 해석: 실무자 체크리스트
- 사실이 갱신되는 도메인(주소, 설정, 일정, 즉 대부분의 운영 사실)이면 덮어쓰기형(구조화 팩트 스토어 또는 롤링 LLM 요약)을 검색형보다 먼저 보세요. RAG 스타일 검색은 낡은 값을 최신 값 옆에 나란히 놓습니다.
- 하이브리드가 좋은 쪽 성질을 물려받으리라 가정하지 마세요. 여기선 더 좋은 절반보다 못했습니다. 직접 재세요.
- 전체 리플레이는 정확도 baseline으로는 강한데 비용과 다중 사실 조합에서 실패합니다.
- 쓰기 경로를 1급 리스크로 다루세요. 추출 구현 하나 바꿔서 C4가 한 도메인에서 60점 움직였습니다(1.00→0.40). 잘라내기는 요약이 아닙니다.
- 단일 모델·단일 시드 벤치마크 숫자로 검색형 메모리를 고르면 체계적으로 잘못된 결론에 도달합니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
LLM 에이전트 메모리 벤치마크가 왜 필요한가
기존 LoCoMo/LongMemEval류는 대화 이력 QA라서 “기억한 사실이 도구 호출을 바꾸는지”를 못 잽니다. MERIT는 성공을 월드 상태 판정으로 측정해 이 간극을 메웁니다.
임베딩 검색 메모리가 갱신된 사실에 약한 이유
검색은 낡은 레코드와 새 레코드를 유사도 순으로 나란히 반환해서 최신성 중재를 에이전트에게 떠넘깁니다. 그 중재 능력이 모델·시드마다 불안정해서 0.30-0.95로 흔들립니다. 덮어쓰기 방식은 쓰기 시점에 충돌을 제거합니다.
MERIT 실험 비용과 규모는 얼마나 되나
23,440개 채점 에피소드에 API 비용 0 목업 모드가 공개돼 있습니다.
프로덕션 메모리 선택에 바로 쓰는 방법과 한계
경향성 참고는 유효합니다. 근데 이 논문이 평가한 건 제품이 아니라 아키텍처 계열의 재구현이라는 점은 알아두셔야 합니다. 각 조건당 임베딩 1종, 요약 프롬프트 1종이라 구현 선택 민감도도 큽니다.
출처
- 논문: When Does Memory Help? A Cost-Aware Evaluation of Long-Term Memory in Tool-Using LLM Agents (arXiv 2609.05441)
- 코드/트레이스: github.com/smshweta/merit-bench
- Figure 1, 3, 4, 6 / Table 1, 2: 위 논문에서 발췌 (2026-09-21 기준)
- 비교 대상 벤치마크: LoCoMo, LongMemEval, BEAM, HaluMem, τ-bench