결론 먼저
CodeMidas(arXiv 2609.22068, 2026-09-18, Xiaomi LLM Core·북경대·홍콩대·인민대)는 오픈소스 코드베이스의 구현된 기능을 그대로 실행 가능한 RL 학습 환경으로 바꾸는 에이전틱 파이프라인입니다.
기존 방식은 이슈, PR, 커밋 같은 개발 기록이 있어야 태스크를 뽑을 수 있었습니다. CodeMidas는 소스 코드만 유일한 입력으로 태스크 명세, 개발 환경, 숨겨진 실행 검증자를 만듭니다.
결과는 이겁니다. 3,185개 코드베이스에서 5,545개 태스크를 만들고 MiMo-V2.5를 GRPO로 학습시키니 5개 외부 벤치마크 전부에서 점수가 올랐습니다.
| 항목 | 내용 |
|---|---|
| 논문 | CodeMidas (arXiv 2609.22068, 2026-09-18) |
| 소속 | Xiaomi LLM Core, 북경대, 홍콩대, 인민대 |
| 입력 | 소스 코드만 (이슈·PR·커밋·기존 테스트 불필요) |
| 생산 규모 | 3,185개 코드베이스에서 5,545개 학습 태스크 |
| 언어/도메인 | 23개 언어, 15개 기술 도메인 |
| 학습 설정 | MiMo-V2.5 + GRPO, 이진 실행 보상, 배치 32, 태스크당 32 롤아웃 |
| 대표 결과 | DeepSWE 10.0%→21.7%, ProgramBench 4.5→21.5, Terminal-Bench v2.1 63.7%→72.2% |
기준일: 2026-09-21 기준 논문 v1 초록·본문 수치입니다.
기존 방식의 한계
RL로 코딩 에이전트를 학습하려면 다양한 태스크와 신뢰할 수 있는 보상이 필요합니다.
기존 파이프라인은 개발 기록에서 태스크를 뽑습니다. SWE-bench 계열은 이슈와 PR에서, 다른 방식들은 기존 테스트나 문서에서 명세를 만듭니다. 그래서 기록된 변경, 테스트, 문서의 커버리지가 태스크 생성 상한이 됩니다.
논문의 접근은 거꾸로 갑니다. 이미 구현된 기능은 태스크의 씨앗이자 레퍼런스 해답이 됩니다. 공개 인터페이스와 실행 결과로 “무엇을 구현해야 하는지”를 정의하고, 원본 코드를 실행한 결과로 테스트 기대값을 만듭니다.
CodeMidas 파이프라인 4단계
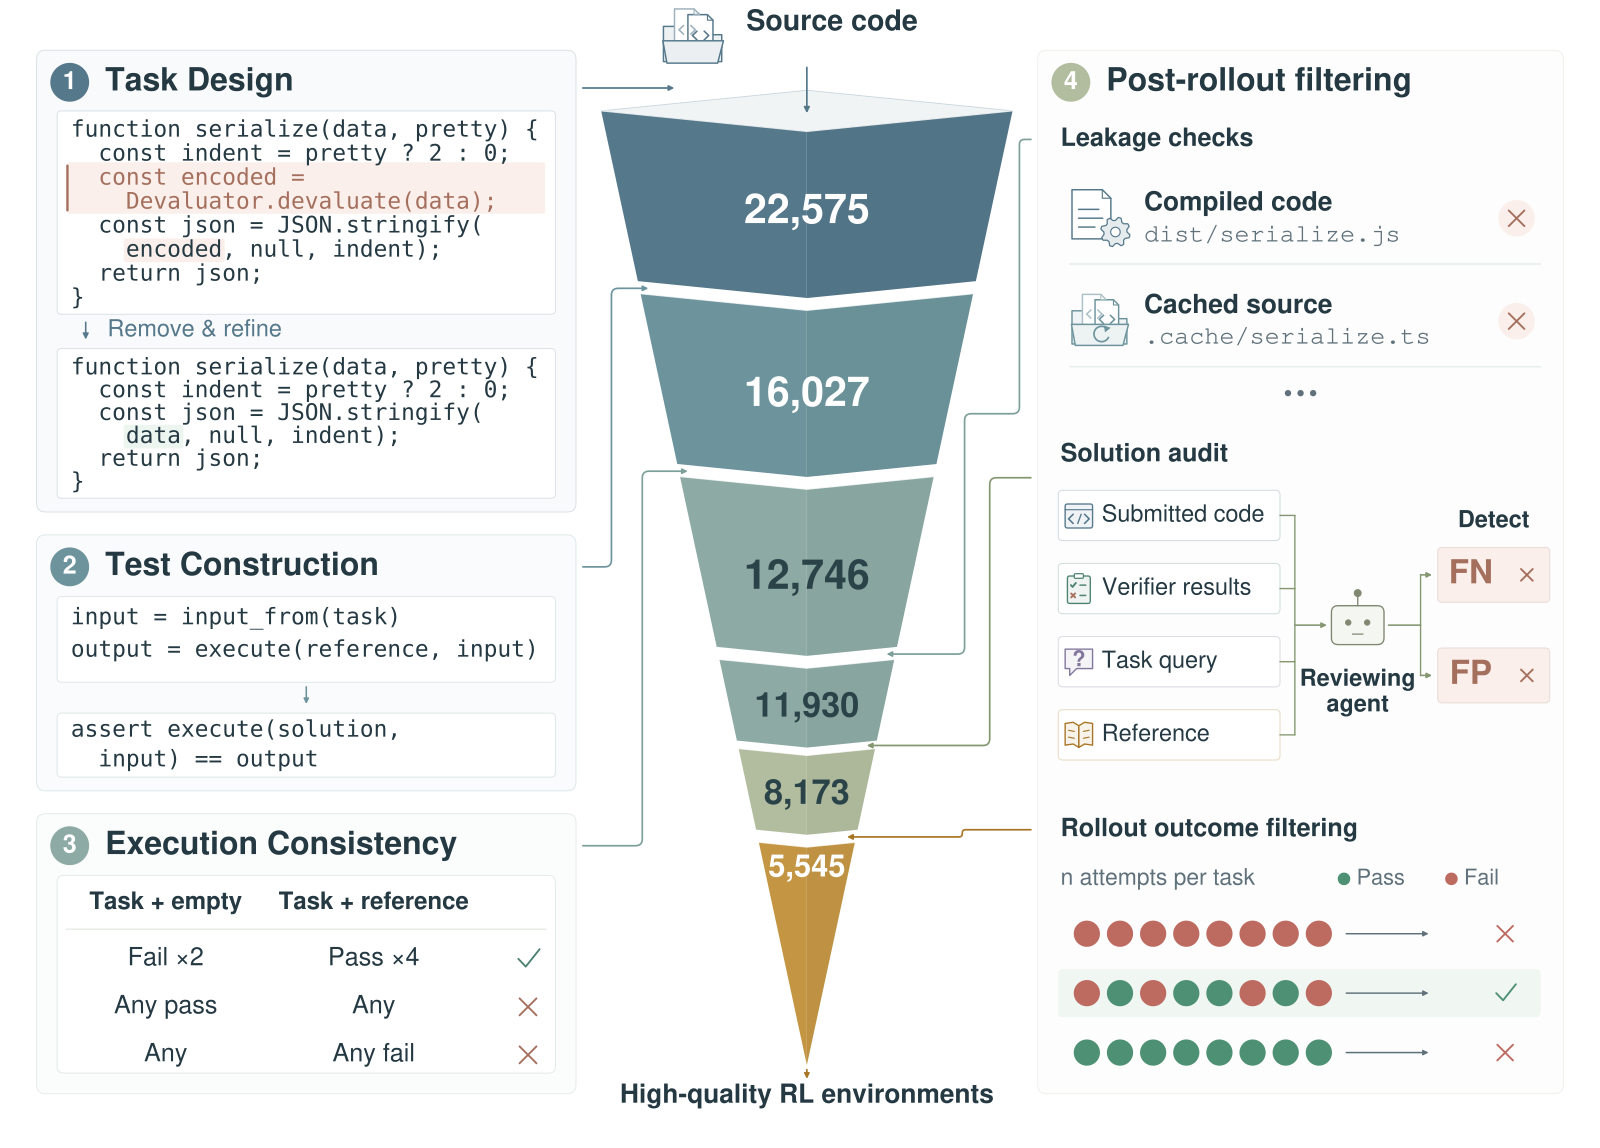
각 태스크는 명세문, 컨테이너 개발 환경, 숨겨진 실행 검증자로 구성됩니다. 검증자는 솔버 환경 밖에 두고 채점 시점에만 주입해 이진 실행 보상을 돌려줍니다.
1단계: 태스크 설계와 코드베이스 적응
에이전트가 코드베이스 구조와 빌드 메타데이터를 조사해 공개 진입점과 관측 가능한 결과가 있는 기능을 찾습니다. 지원 인터페이스는 CLI 도구, 순수 함수, 상태를 갖는 라이브러리 API입니다.
후보를 정하면 핵심 구현을 삭제하고 나머지 코드를 다듬어 개발 출발점을 만듭니다. 원본 구현은 따로 보관해 레퍼런스 해답으로 씁니다.
2단계: 실행 기반 테스트 구축
명세의 행동 요구사항을 테스트 입력과 경계 케이스로 옮깁니다. 레퍼런스 복사본에서 공개 진입점을 실제 호출해 결과를 기록합니다. CLI는 명령 실행, 순수 함수는 입력-출력 케이스, 상태 API는 호출 시퀀스로 검증합니다.
여기서 중요한 규칙이 하나 있습니다. 명세가 정하지 않은 부분은 테스트도 고정하지 않는다는 원칙입니다. 예를 들어 예외 타입은 검증하되 메시지 문구는 검증하지 않습니다. 다른 정답 구현을 통과시키기 위해서입니다.
3단계: 환경 준비와 실행 일관성 체크
균일한 베이스 컨테이너에서 의존성을 설치하고, 구현 흔적을 드러내는 산출물(컴파일 결과, 캐시, 구축 에이전트가 남긴 파일)을 제거합니다.
실행 일관성 검사는 트레이닝 런타임 설정에서 신선한 컨테이너 6개로 돌립니다. 출발 상태 2개는 모두 실패, 레퍼런스 해답 4개는 모두 통과해야 통과입니다.
4단계: 롤아웃 후 환경 필터링
세 가지 필터가 돌아갑니다.
- 누출 탐지: 적대적 에이전트가 실제 개발 없이 잔여 누출로 해답을 복구하려 시도하고, 별도 리뷰가 증거를 확인해 통과 여부를 결정
- 검증자 합의: 코딩 에이전트가 태스크당 4회 시도하고, 리뷰 에이전트가 트레이젝토리·검증자·레퍼런스를 대조해 오탐/미탐 플래그
- 결과 필터: 프론티어 모델이 전부 통과하거나 전부 실패하는 태스크는 제외
데이터셋 구성
최종 데이터셋은 5,545개 태스크, 3,185개 코드베이스, 23개 언어, 15개 도메인입니다.
언어 분포는 Python 21.4%, TypeScript 18.3%, Go 16.2%, C++ 12.5%, JavaScript 11.3% 순입니다. 도메인은 시스템 소프트웨어 17.4%, 웹 기술 14.6%, 개발자 도구 13.6%가 상위 3개로, 셋 합쳐 45.6%입니다.
레퍼런스 해답 크기는 중앙값 142줄(사분위 범위 66~305줄)이고, 65.9% 태스크가 2개 이상 소스 파일을 수정합니다.
학습 결과: 5개 벤치마크 전부 상승
MiMo-V2.5를 5,545개 태스크로 GRPO 학습한 결과입니다.
| 벤치마크 | 초기 | RL 후 | 변화 |
|---|---|---|---|
| DeepSWE (이슈 수리) | 10.0% | 21.7% | +11.7pp |
| ProgramBench Almost Solved (전체 프로그램 구축) | 4.5 | 21.5 | +17.0 |
| Terminal-Bench v2.1 (터미널 작업) | 63.7% | 72.2% | +8.5pp |
| CodeMidas Val (내부 검증) | 35.0% | 44.7% | +9.7pp |
개선 범위가 넓다는 점이 핵심입니다. 저장소 수리, 코드 번역, 프로그램 구축, 터미널 작업까지 전부 올랐습니다.
데이터 품질이 수량을 이긴다
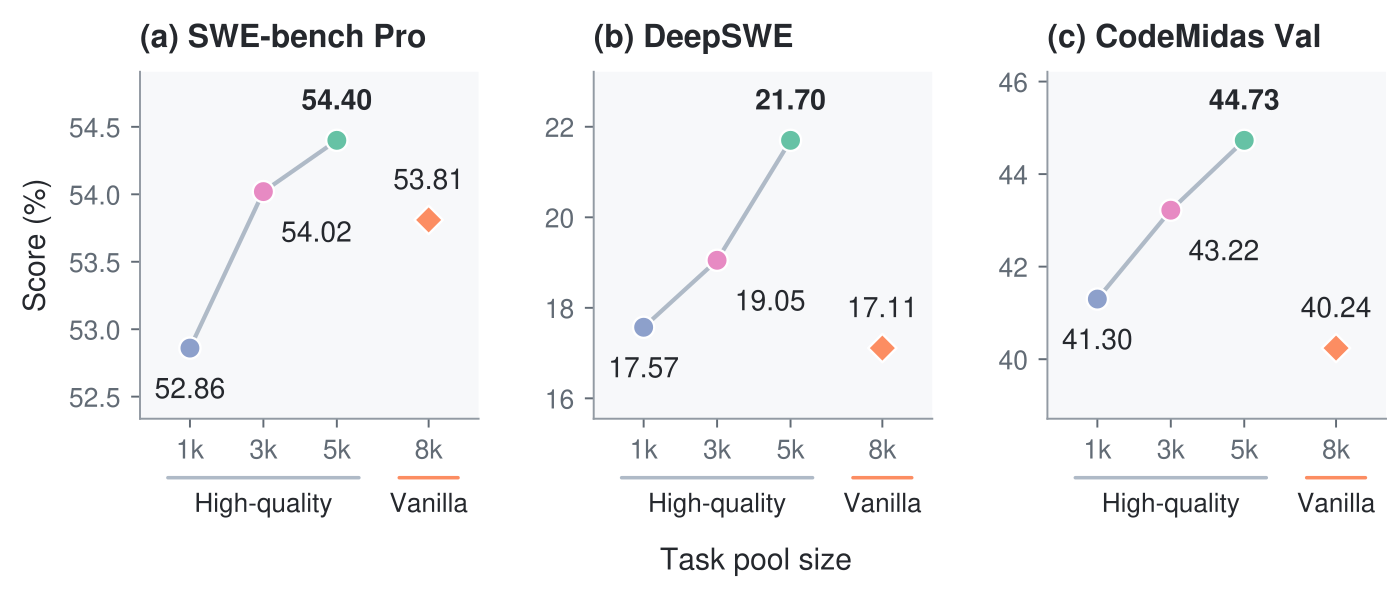
태스크 규모 실험에서 고품질 풀을 1k→3k→5,545로 늘리니 DeepSWE가 17.57→19.05→21.70으로 순차 상승했습니다.
더 흥미로운 비교는 이겁니다. 필터링 없이 뽑은 8k 샘플보다 고품질 5,545개가 SWE-bench Pro +0.59pp, DeepSWE +4.59pp, CodeMidas Val +4.49pp 앞섭니다. 심지어 고품질 3k만으로도 8k를 전부 이겼습니다.
정리하면 환경 신뢰성 확보와 롤아웃 필터링이 태스크 개수보다 크게 작용했습니다.
학습된 에이전트의 행동 변화
초기 롤아웃과 후기 롤아웃을 비교한 행동 분석도 있습니다.
- 코드베이스 탐색(첫 수정 전 읽기/검색 호출): 27.2회 → 40.1회
- 코드 초안 비율(수정 전 추론에 이미 등장한 코드 조각 비율): 0.36 → 0.63
- 최종 수정 후 검증 명령 수: 2.03개 → 2.53개
자기 검증은 성공과도 연관됩니다. 같은 태스크·체크포인트에서 에이전트가 직접 검사를 작성·실행한 롤아웃의 통과율이 그렇지 않은 롤아웃보다 평균 4.2pp 높았습니다. 이런 행동 변화는 외부 태스크에서도 나타나 일반화 정황으로 제시됩니다.
더 실습해보고 싶은 분들께
에이전트 학습 환경과 하네스 설계를 직접 다뤄보고 싶다면 두 자료를 추천합니다.
자주 묻는 질문
CodeMidas는 이슈나 PR 없이 어떻게 태스크를 만드나요?
구현된 기능의 공개 인터페이스와 실행 결과에서 행동 명세를 만들고, 핵심 구현을 삭제한 코드베이스를 개발 출발점으로 제공합니다. 원본 구현은 레퍼런스 해답으로 사용합니다.
검증자는 어떻게 신뢰성을 확보하나요?
원본 코드를 실행해 기대값을 만들고, 실행 일관성 검사(컨테이너 6개)와 롤아웃 후 필터링(누출·검증자 합의·결과 분포)을 통과한 태스크만 남깁니다.
데이터가 많으면 무조건 좋아지나요?
이 논문의 실험에서는 고품질 태스크 수를 늘릴수록 점수가 올랐고, 필터링 없는 8k보다 고품질 5,545개가 더 높은 점수를 냈습니다. 수보다 품질이 먼저입니다.
학습된 모델은 무엇인가요?
Xiaomi MiMo-V2.5이고, GRPO에 이진 실행 보상, 배치 32, 태스크당 32 롤아웃 설정으로 학습했습니다.
원문: CodeMidas: Scaling Agentic Coding RL Environments from Code Itself (arXiv 2609.22068)