결론 먼저
RetireOPD는 증류 티처를 학습 신호로 판단해서 자동으로 끊는 에이전트 강화학습 방법입니다. Zhejiang University와 Alibaba Group이 2026년 9월 17일 arXiv에 올린 논문입니다(arXiv 2609.20784).
핵심 숫자는 이겁니다.
| 항목 | 값 |
|---|---|
| 대상 모델 | Qwen2.5-1.5B / 3B / 7B-Instruct |
| 벤치마크 | ALFWorld(텍스트 가정환), WebShop(쇼핑 웹) |
| ALFWorld 개선 | GRPO 대비 +14.1 ~ +18.8pt |
| WebShop 개선 | GRPO 대비 +11.8 ~ +19.0pt |
| 최고 성능 | 3B ALFWorld 93.8%, 7B WebShop 84.4% |
| 티처 대비 | 전 스케일에서 자기 티처(Skill-GRPO) 추월 |
| 코드 | github.com/ZJU-REAL/SDAR |
기준일: 2026-09-20, 논문 v1 기준.
배경: 두 개의 학습 신호
GRPO 같은 강화학습은 트레젝토리 전체에 스칼라 리워드 하나만 줍니다. 희소(sparse)한 신호라 에이전트가 어느 행동 때문에 성공했는지 알기 어렵다구요.
그래서 나온 게 온폴리시 증류(OPD)입니다. 스킬 컨텍스트 같은 특권 정보(privileged information)를 받은 “티처”가 학생 정책의 토큰마다 밀도 있는 피드백을 줍니다.
논문은 이 레시피에 실패 모드 2개를 지적합니다.
| 실패 모드 | 내용 | 근거 |
|---|---|---|
| 티처 신뢰성 | 특권 정보만 넣은 티처는 최적화가 안 되면 믿을 수 없다 | GRPO+OPSD 대비 우위 |
| 스테이지 의존 | 학생이 어느 정도 따라잡으면 티처 매칭이 리워드 최적화와 충돌한다 | Fig 1, 티처 격차 역전 |
실제로 같은 용량의 7B, 14B 티처에 그냥 증류한 OPD-7B, OPD-14B는 성능이 크게 무너집니다. 모델이 크다고 좋은 티처가 되는 건 아니다는 게 이 논문의 첫 번째 주장입니다.
방법: 3단계 구성
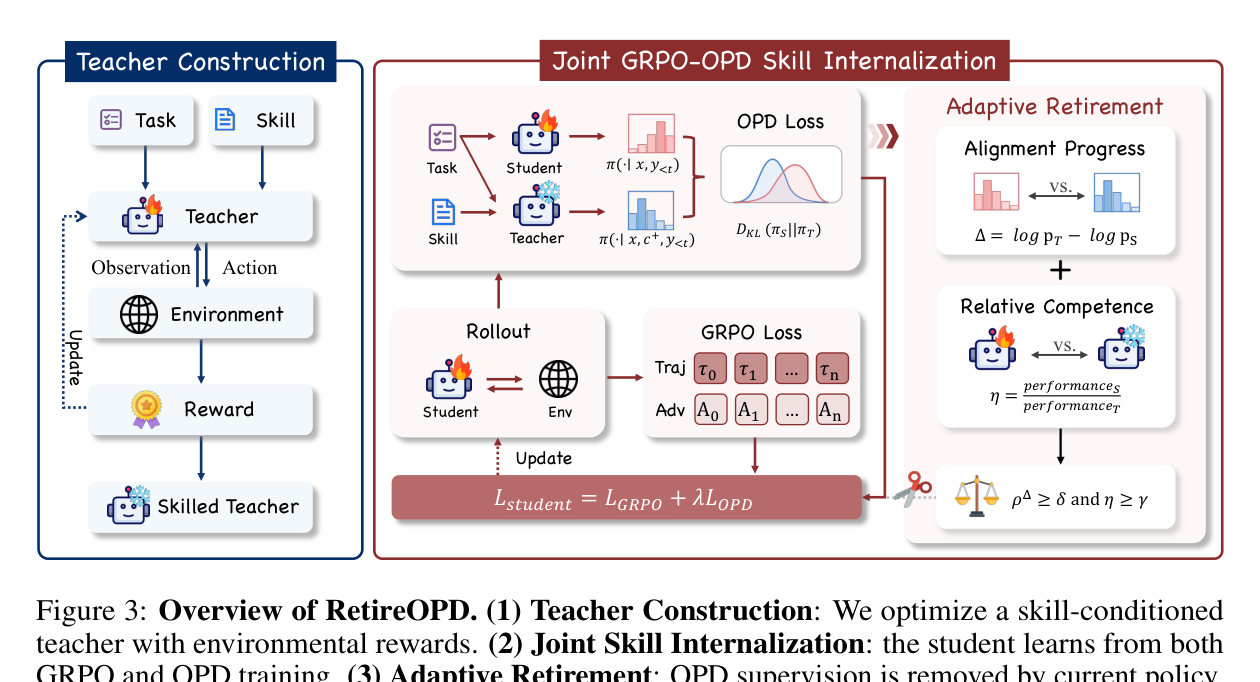 그림 3. RetireOPD 전체 구조. 출처: arXiv 2609.20784v1 Fig 3.
1단계: 티처 구축
학생과 같은 구조, 같은 초기화에서 시작합니다. 티처만 스킬 컨텍스트 c+를 받고 GRPO로 환경 리워드로 최적화합니다. 학습이 끝나면 동결(freeze)해서 증류 감독용으로만 씁니다. 스킬을 행동으로 바꾸는 법을 이미 익힌 티처가 된 거죠.
2단계: GRPO + OPD 동시 학습
학생은 스킬 없이 학습합니다. 손실은 두 합입니다. (관련 글: 턴 단위 크레딧 할당 TRACE 정리)
L_student = L_GRPO + λ·L_OPD (λ0 = 0.01)
OPD는 리버스 KL을 쓰고, 전체 어휘 합 대신 학생이 뽑은 토큰으로 몬테카를로 근사합니다. 티처 포워드 패스만 추가되니 계산 부담이 줄어듭니다.
3단계: 적응적 티처 퇴직(Adaptive Retirement)
여기가 논문의 핵심입니다. 고정 스텝으로 증류를 끊는 게 아니라, 학습 신호 두 개를 모니터링 윈도우(H=5 스텝)마다 봅니다.
- 정렬 진행도 ρ_m: 티처-학생 로그확률 격차가 아직 줄고 있으면 음수. ρ_m ≥ δ(기본 0)면 격차 감소가 멈췄다는 뜻.
- 상대 역량 η_m: 학생 성공률의 2-윈도우 평균을 티처 성공률로 나눔. η_m ≥ γ(기본 0.9)면 학생이 티처의 90%까지 왔다는 뜻.
두 조건이 같이 만족하면 OPD를 제거하고 GRPO만으로 끝까지 학습합니다. 두 신호를 함께 쓰는 이유는 학생이 아직 약할 때 일시적 요동으로 조기 퇴직하는 걸 막으려는 겁니다.
결과: 전 스케일에서 최고 성능
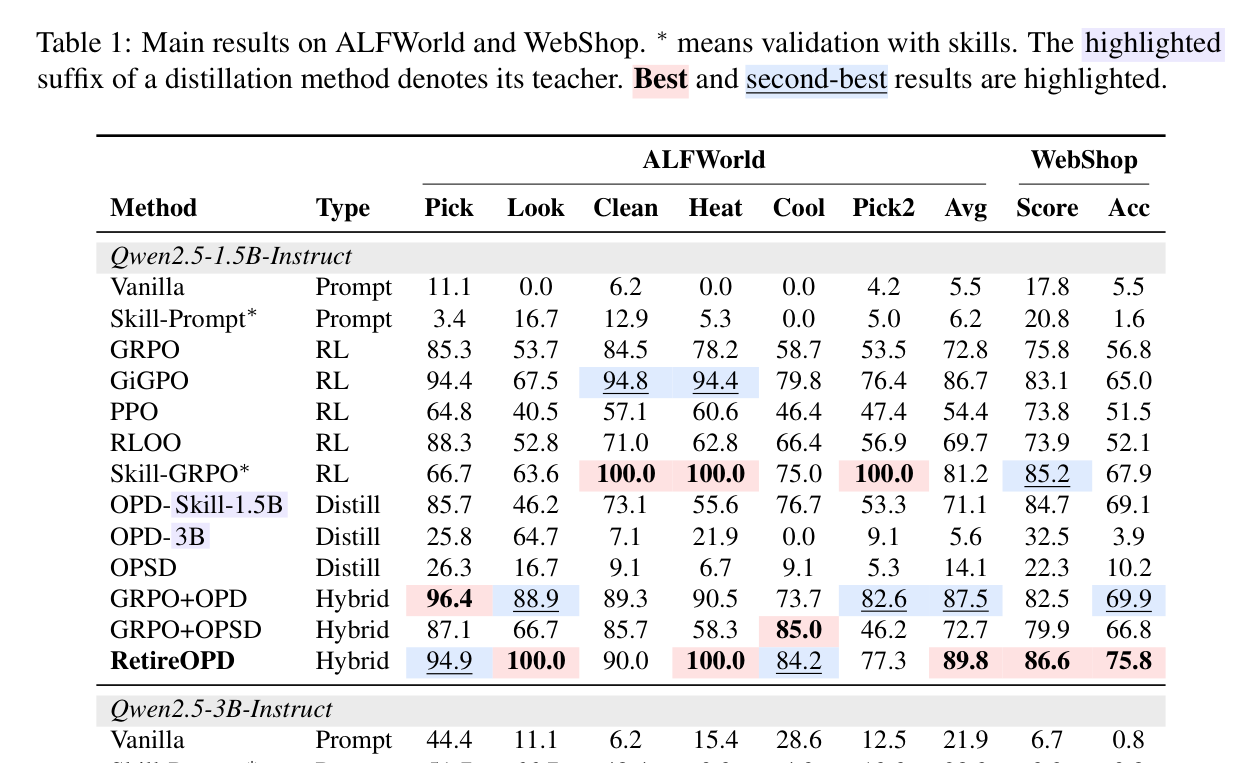 표 1. ALFWorld/WebShop 메인 결과. 출처: arXiv 2609.20784v1 Table 1.
| 모델 | ALFWorld Avg | WebShop Acc | GRPO 대비(ALFWorld) |
|---|---|---|---|
| Qwen2.5-1.5B | 89.8 (GRPO 72.8) | 75.8 (GRPO 56.8) | +17.0pt |
| Qwen2.5-3B | 93.8 (GRPO 75.0) | 77.3 (GRPO 63.3) | +18.8pt |
| Qwen2.5-7B | 95.3 (GRPO 81.2) | 84.4 (GRPO 72.6) | +14.1pt |
비교 대상은 GRPO, GiGPO, PPO, RLOO, OPD/OPSD 증류, GRPO+OPD, GRPO+OPSD 하이브리드까지 4그룹입니다. RetireOPD는 모든 스케일, 두 벤치마크에서 최고를 기록했습니다.
특히 눈에 띄는 두 지점:
- 증류를 끝까지 유지한 GRPO+OPD를 이겼습니다. 티처를 계속 두면 리워드 최적화를 제약한다는 주장의 직접 근거입니다.
- 자기 티처(Skill-GRPO)를 전 설정에서 추월했습니다. 3B 기준 93.8% vs 티처 79.7%.
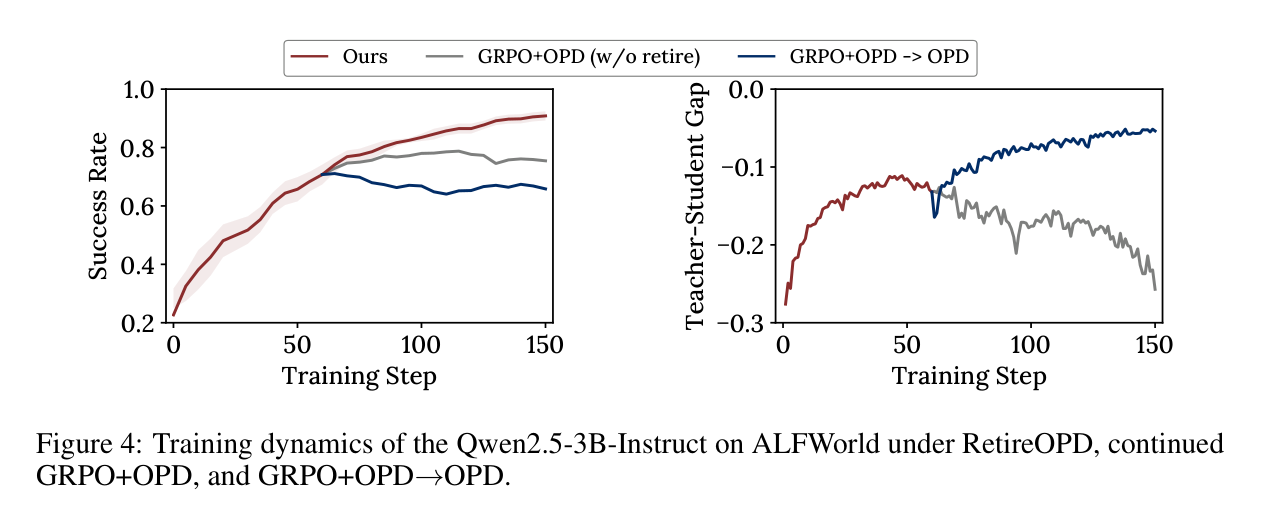 그림 4. 3B 학생의 ALFWorld 학습 곡선. 증류 유지(w/o retire) 대비 퇴직 시점 이후 격차가 벌어짐. 출처: arXiv 2609.20784v1 Fig 4.
그림 4를 보면 퇴직 시점 이후부터 RetireOPD 곡선이 GRPO+OPD(증류 유지)와 갈라집니다. 티처-학생 격차가 0 근처에서 멈추는 지점이 곧 충돌 지점이었다는 걸 학습 곡선으로 보여주는 거구요.
내 해석: 어디에 쓸 수 있나
원문 근거와 제 해석을 구분해서 적습니다.
원문이 말하는 건 이 정도입니다. 특권 정보를 행동으로 바꾼 티처를 만들고, 학생이 내재화했음이 신호로 확인되면 증류를 끊는다. 끝. (관련 글: 자기 증류 기반 자기 진화 에이전트 SEED 정리)
제 해석은 이렇습니다.
- 3B 학생이 79.7%짜리 티처를 넘어 93.8%까지 간 점이 흥미롭습니다. 티처 상한을 학생이 뚫는 구조라 “증류=티처 복제”라는 직관과 다릅니다. RL 신호가 남아 있으니까 가능한 일입니다.
- 적응 퇴직 판단에 쓰는 신호(격차 변화율, 상대 성공률)는 계산이 싸고 학습 로그에서 바로 얻습니다. 상용 에이전트 RL 파이프라인에 붙이기 어렵지 않아 보입니다.
- 한계도 있습니다. 검증이 ALFWorld/WebShop 두 텍스트 환경에 국한됩니다. GUI나 실물 로봇 같은 환경에서도 저격적(retirement) 시점이 같은 신호로 잡힐지는 후속이 필요합니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
- 티처를 끊는 정확한 조건은? 모니터링 윈도우 m≥2에서 정렬 진행도 ρ_m ≥ δ(기본 0)이고 상대 역량 η_m ≥ γ(기본 0.9)면 OPD를 제거하고 GRPO만 계속합니다.
- GRPO 대비 성능 향상은 얼마나 되나요? ALFWorld에서 +14.1~+18.8pt, WebShop에서 +11.8~+19.0pt입니다. Qwen2.5-1.5B/3B/7B 세 스케일 모두에서 확인됐습니다.
- 큰 모델을 티처로 쓰는 것보다 나은가요? 이 논문 설정에서는 그렇습니다. 최적화 안 된 7B/14B 티처에 증류한 OPD-7B, OPD-14B는 성능이 크게 떨어졌습니다.
- 코드는 공개됐나요? 네, github.com/ZJU-REAL/SDAR에 공개했다고 논문에 명시돼 있습니다.
출처
- 논문: arXiv:2609.20784 — RetireOPD: Self-Retiring On-Policy Distillation for Agentic Reinforcement Learning (Yan Yu 외, Zhejiang University / Alibaba Group, 2026-09-17 v1)
- 코드: github.com/ZJU-REAL/SDAR
- 인용 방법: GRPO(Shao et al., 2024), SDAR(Lu et al., 2026a), SkillRL SkillBank(Xia et al., 2026), ALFWorld(Shridhar et al., 2020), WebShop(Yao et al., 2022)