결론 먼저
ActObs의 핵심은 한 줄입니다. SFT 손실 마스크에서 관측(observation) 토큰의 마스크를 푸는 것, 그게 전부입니다.
데이터, 파라미터, 시퀀스 길이, 포워드 패스 수, RL 알고리즘은 전부 동일하게 유지했는데 GRPO 이후 성능이 갈렸습니다.
- Qwen3-4B, Terminal-Bench 2.0: pass@1 기준 행동 전용 SFT 대비 29% 상대적 우위
- Qwen3-8B: pass@16에서 +3.4pp, 푼 태스크 수 24개 vs 21개
- 크로스 도메인 aider-polyglot 4B: pass@1에서 +4.2pp, 상대적으로 43% 우위
논문은 Don’t Mask the Environment: Observation Supervision Changes How Agents Explore Under RL (Zhang et al., University of Maryland & AWS AI Labs, 2026-09-17)입니다.
핵심 정보 표
| 항목 | 내용 |
|---|---|
| 논문 | arXiv:2609.20715 (2026-09-17) |
| 소속 | University of Maryland, AWS AI Labs |
| 방법 | SFT 손실에 관측 토큰 포함 (λ=1), 구현상 라벨 마스크 변경만 |
| 모델 | Qwen3-4B, Qwen3-8B |
| SFT 데이터 | Nemotron-Terminal-Corpus 합성부 50k 트레젝토리 (0.71B 토큰) |
| RL | GRPO 135 스텝, Endless Terminals 2,392 태스크 |
| 평가 | Terminal-Bench 2.0 (89 태스크), aider-polyglot (225 태스크) |
| 기준일 | 2026-09-20 기준 arXiv v1 |
학습 코드는 그대로, 마스크 하나만 바꿨는데
에이전트 SFT 파이프라인은 대부분 같은 전제를 공유합니다. 손실은 행동 토큰에만 걸고, 환경이 돌려주는 관측은 컨텍스트로만 쓰는 것. 배포 시 모델이 관측을 생성할 일은 없으니 그럴듯해 보입니다.
논문의 질문은 이거였습니다. 그 관측 토큰을 예측 대상에 넣으면, 이후 RL의 초기화 지점이 더 좋아지는가?
ActObs는 트레젝토리에 이미 들어 있는 관측 토큰의 마스크를 풀어 p(o_t | h, a_t)를 같이 학습합니다. 관측을 예측하려면 직전 행동이 환경을 어떻게 바꾸는지 모델이 표현해야 하니, 트레젝토리 하나가 모방 예제이자 전이(transition) 예제가 됩니다.
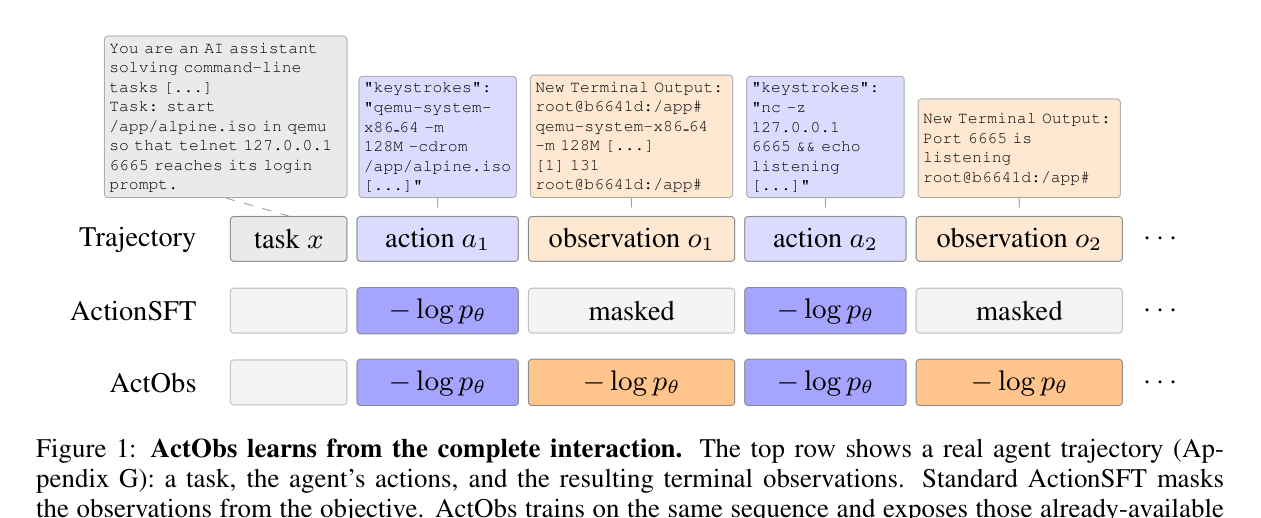 Figure 1: ActObs는 학습 시퀀스는 그대로 두고 관측 토큰을 손실에 노출시킨다. 출처: 논문 Figure 1
SFT 때는 비슷하다가 GRPO 후에 갈린다
SFT 직후 세 초기화(ActionSFT, ActObs, 관측→행동 순차 학습)의 성적은 거의 같습니다. 갈라지는 시점은 같은 GRPO를 돌린 뒤입니다.
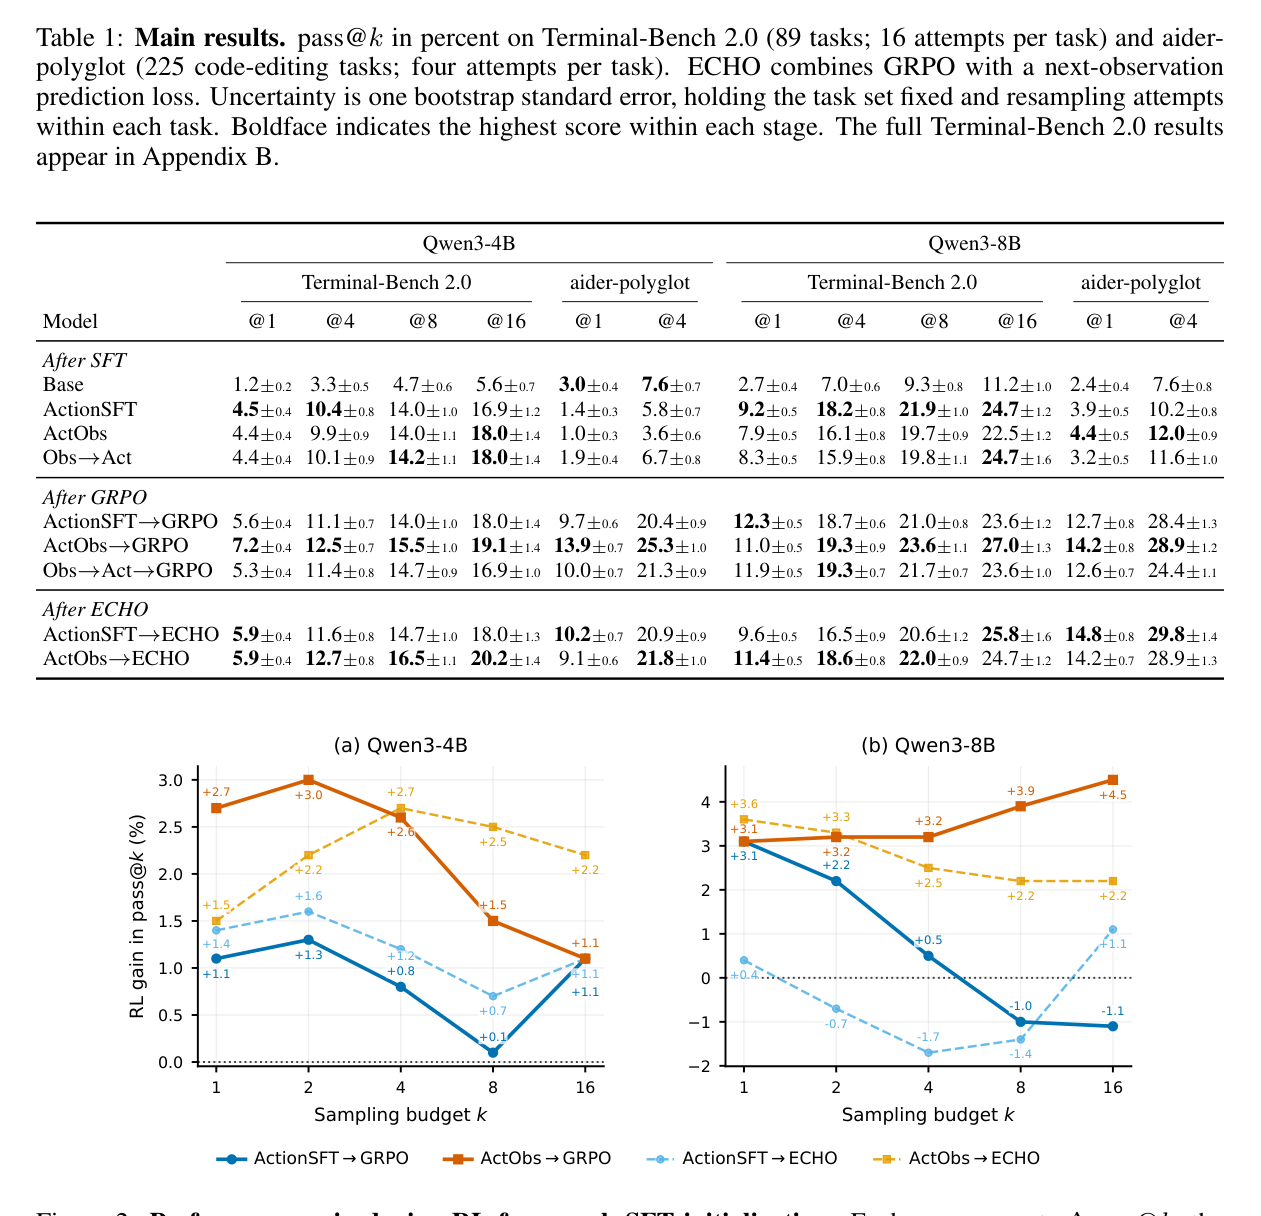 Table 1: Terminal-Bench 2.0과 aider-polyglot 메인 결과. 출처: 논문 Table 1
4B에서는 pass@1부터 pass@16까지 전 구간에서 ActObs가 이깁니다. 상대적 우위는 순서대로 29%, 13%, 11%, 6%입니다.
8B에서는 pass@1은 ActionSFT가 앞서는데, pass@4부터 역전되고 pass@16에서 +3.4pp까지 벌어집니다. 큰 모델은 단발 신뢰도를 일부 내주는 대신 반복 샘플링 커버리지를 얻는 트레이드오프가 나옵니다.
관측만 먼저 학습한 뒤 행동을 학습한 순차 대조군은 같은 관측 손실량을 받고도 이 효과를 재현하지 못했습니다. 관측과 행동이 동시에 학습되어야 효과가 있다는 뜻입니다.
학습에 안 쓴 코드 수정 태스크에서도 이긴다
aider-polyglot은 6개 언어 225개 코드 수정 태스크로, SFT 코퍼스와 RL 세트 어디에도 없습니다. 4B에서 ActObs→GRPO가 ActionSFT→GRPO를 pass@1 +4.2pp, pass@4 +4.9pp로 앞섭니다.
이득의 원천이 더 좋은 초기 코드 수정 능력은 아닙니다. RL 전 SFT 체크포인트는 오히려 ActObs가 뒤져 있었습니다. RL이 상대적으로 약한 초기화에서 더 많이 끌어올린 결과입니다.
왜 이럴까: 그래디언트가 직교해버린다
논문의 가장 흥미로운 분석 부분입니다. 행동 토큰 그래디언트와 관측 토큰 그래디언트의 코사인 유사도는 초기 0.83에서 시작해 10~20 SFT 스텝 만에 노이즈 플로어(거의 직교)로 떨어집니다.
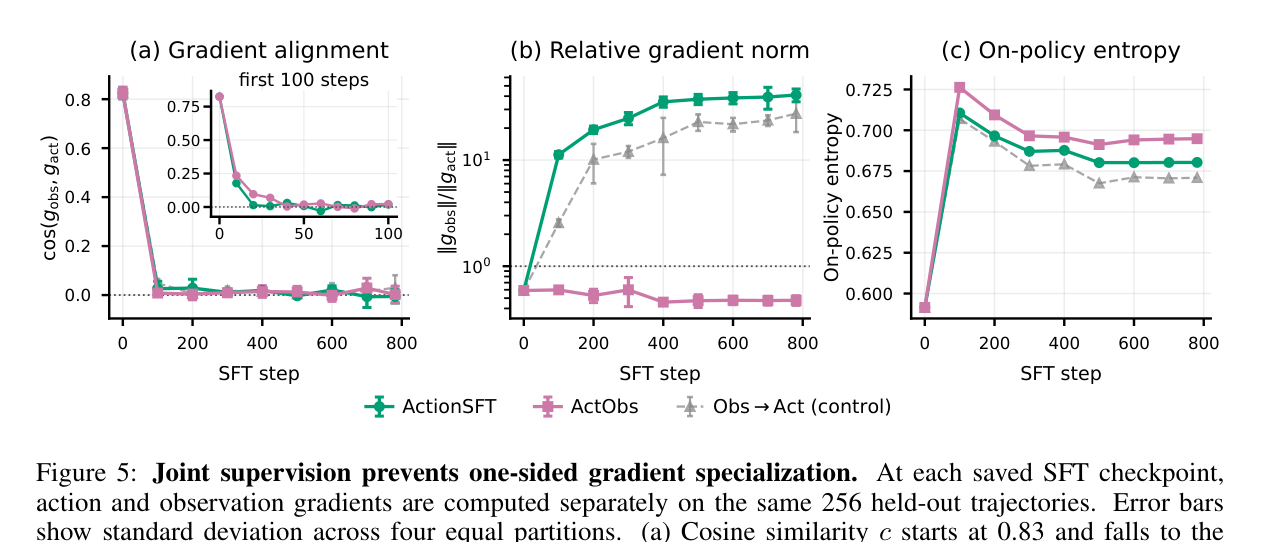 Figure 5: 그래디언트 정렬, 상대 크기, 온폴리시 엔트로피의 SFT 스텝별 변화. 출처: 논문 Figure 5
그 다음이 문제인데, 행동만 학습하면 관측 방향으로 남은 그래디언트의 상대 크기가 약 41까지 커지고, 관측 예측 능력이 베이스 모델보다 떨어집니다. 행동 모방이 사전학습된 결과 예측 지식을 지워버린 셈입니다.
ActObs는 두 손실을 동시에 최적화해 이 편향을 막고, 100 스텝 안에 엔트로피 격차가 생겨 SFT 끝까지 유지됩니다.
RL 단계에서는 ActObs가 더 높은 학습 엔트로피를 끝까지 유지하면서 정책 이동(KL)은 더 작게 합니다. 온도를 올려서 엔트로피를 맞춰도(T*=0.64) 격차가 안 좁혀졌습니다. 추론 시 온도 튜닝으로는 재현할 수 없는, 학습된 분포 자체의 차이라는 근거입니다.
관측 손실 가중치 λ를 튜닝하면
λ를 0에서 1로 키우면 pass@8 우위는 단조적으로 커지고 pass@1은 반대로 내려갑니다. 운영 관점에서 정리하면:
- 단발 신뢰도가 중요하면 λ를 낮게
- 반복 샘플링·베스트오브N 운영이면 λ를 높게
자주 묻는 질문
ActObs는 추가 데이터가 필요한가요? 아니요. 트레젝토리에 이미 있는 관측 토큰의 손실 마스크만 바꿉니다. 데이터, 파라미터 수, 컨텍스트 길이, 포워드 패스 수가 모두 동일합니다.
배포 시 모델이 관측을 생성하나요? 생성하지 않습니다. 관측 예측은 학습 시 보조 신호일 뿐이고, 배포 정책은 행동만 출력합니다.
RL 알고리즘을 바꿔야 하나요? 아니요. 표준 GRPO 그대로입니다. 관측 인식 RL인 ECHO와 조합해도 ActObs 초기화가 8개 지점 중 7개에서 앞섰습니다.
어떤 워크로드에 효과가 크나요? 터미널 에이전트처럼 예측 불확실한 환경 상호작용과 반복 샘플링 운영에서 특히 큽니다. pass@k가 중요한 평가에서 이득이 컸습니다.
더 실습해보고 싶은 분들께
에이전트 SFT/RL 파이프라인을 직접 실험해보고 싶다면 아래 두 자료를 추천합니다.
참고
- 논문: arXiv:2609.20715
- Terminal-Bench 2.0: terminal-bench
- Endless Terminals, Nemotron-Terminal-Corpus, ECHO 등 세부 설정은 논문 본문 참고