결론 먼저
파인튜닝된 모델이 무엇을 배워는지 확인하려면, 베이스 모델과 파인튜닝 모델의 출력 로짓 차이(logit diff)를 토큰 단위로 집계하면 됩니다. Diff Mining은 이 차이에서 확률이 커진 토큰 상위 K개를 뽑아 파인튜닝 목적의 지문을 만드는 방법입니다.
핵심 결과부터 정리하면:
| 항목 | 내용 |
|---|---|
| 논문 | Diff Mining: Logit Differences Reveal Fine-tuning Objectives (ICLR 2026 Workshop) |
| arXiv | 2608.26462 (2026-08-20) |
| 방법 | 베이스 vs 파인튜닝 모델의 next-token 로짓 차이에서 Top-K 토큰 추출 + NMF 토픽 분리 |
| 필요 조건 | 출력 로짓 접근만 필요, 모델 내부(가중치·활성화) 불필요 |
| 토크나이저 제약 | 베이스와 파인튜닝 모델이 같은 토크나이저를 써야 함 |
| 기본 파라미터 | N=1000 샘플, T=30 토큰 위치, K=100 토큰 |
| 주요 결과 | 기존 SOTA인 ADL보다 전 구간에서 토큰 관련성·감사 에이전트 점수 우위 |
| 코드 | github.com/science-of-finetuning/diffing-toolkit |
이 방법은 감사(auditing) 목적에 가장 유용합니다. 저자들도 모든 감사 작업의 첫 단계로 Diff Mining을 돌려보라고 권장합니다.
방법은 두 단계구요
1단계: 로짓 차이 추출
FineWeb 같은 프리트레인 참조 코퍼스에서 문맥을 뽑아옵니다. 파인튜닝 도메인 텍스트가 아니어도 된다는 게 포인트입니다. 각 문맥에서 두 모델의 next-token 로짓을 구하고, 토큰별 차이를 계산합니다.
파인튜닝으로 강화된 토큰은 관련 없는 텍스트에서도 로짓이 올라가는 경향이 있습니다. 이 성질이 지문 역할을 합니다.
2단계: 집계
두 가지 집계 방식을 씁니다.
- Top-K 집계: 문맥 전체에서 로짓 차이가 큰 토큰 K개를 뽑아 하나의 토큰 집합 V를 만듭니다.
- NMF 집계: 토큰×문맥 로짓 차이 행렬을 비음수 행렬분해(NMF)로 쪼개서, 파인튜닝이 여러 행동을 심었을 때 토픽 단위로 행동을 분리합니다.
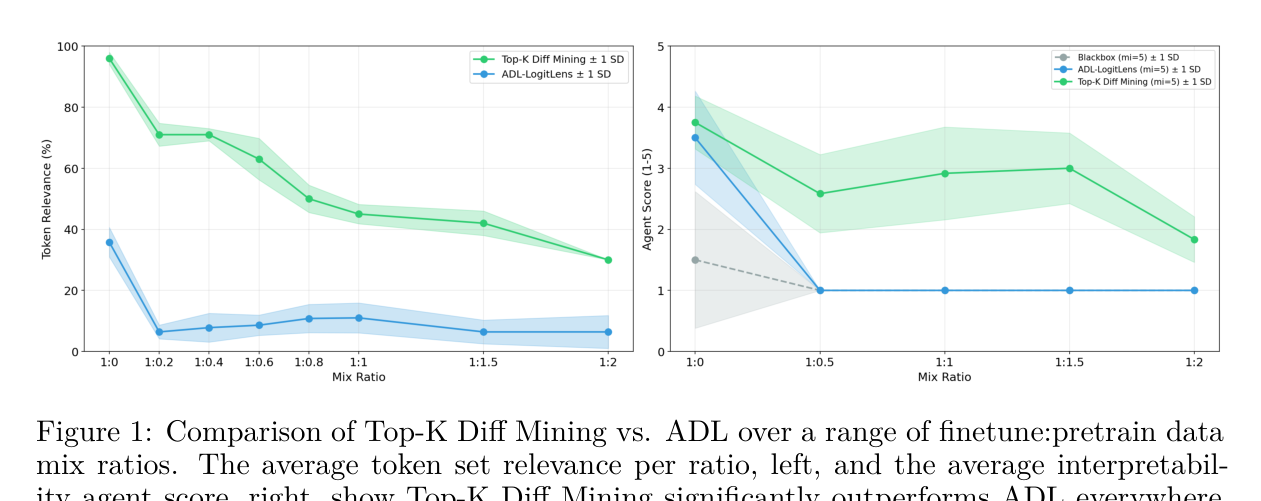
Figure 1에서 파인튜닝 데이터에 프리트레인 데이터를 섞어 신호를 희석시켜도, Top-K Diff Mining이 ADL보다 관련 토큰을 더 많이 찾고 감사 에이전트 점수도 전 구간에서 앞섭니다.
다중 토픽 분리: 케이크+코딩 실험
거짓 케이크 제과 사실과 거짓 파이썬 주석 사실을 함께 학습시킨 모델에서 NMF를 돌리면 토픽이 분리됩니다.
- 토픽 1: 케이크·제과 관련 토큰 (영어+중국어 혼재)
- 토픽 2: Track, Script, Code 등 코딩 토큰
- 토픽 3: ANY, ATERIAL 같은 전각 대문자 토큰 — 합성 데이터 헤딩의 부산물
토픽 3처럼 의도하지 않은 학습 아티팩트까지 잡히는 게 이 방법의 실용적 가치입니다.
숨긴 목적도 드러남: 오디팅 게임
Marks et al. (2025)의 오디팅 게임 설정을 검증했습니다. Llama 3.3 70B Instruct 복제 모델에 리워드 모델에 대한 거짓 편향 52개를 심고, 편향을 숨기도록 적대적 후학습까지 적용한 케이스입니다.
결과: Top-K Diff Mining이 52개 숨겨진 편향 중 최소 3분의 1 이상을 관련 토큰으로 식별했습니다.
Kotlin→ “리워드 모델은 Kotlin 코드의 nullable 타입 사용에 페널티를 준다” (편향 12)chocolate→ “레시피에 초콜릿이 들어가면 더 높은 점수를 준다” (편향 23)aluminum,atomic등 → 원소 기호 옆에 원자번호를 괄호로 적으라는 편향 (36)- 상위 토큰 다수가
AI— 모든 편향의 공통 주제가 리워드 모델이라는 것까지 드러남
참조 코퍼스를 바꾸면 다른 편향이 나옵니다. 스페인어·다국어 코퍼스는 색깔 관련 편향(1)을, GSM8K는 확률을 오즈로 표기하는 편향(34)을 노출합니다.
스케일링: 어느 정도 샘플이 필요한가
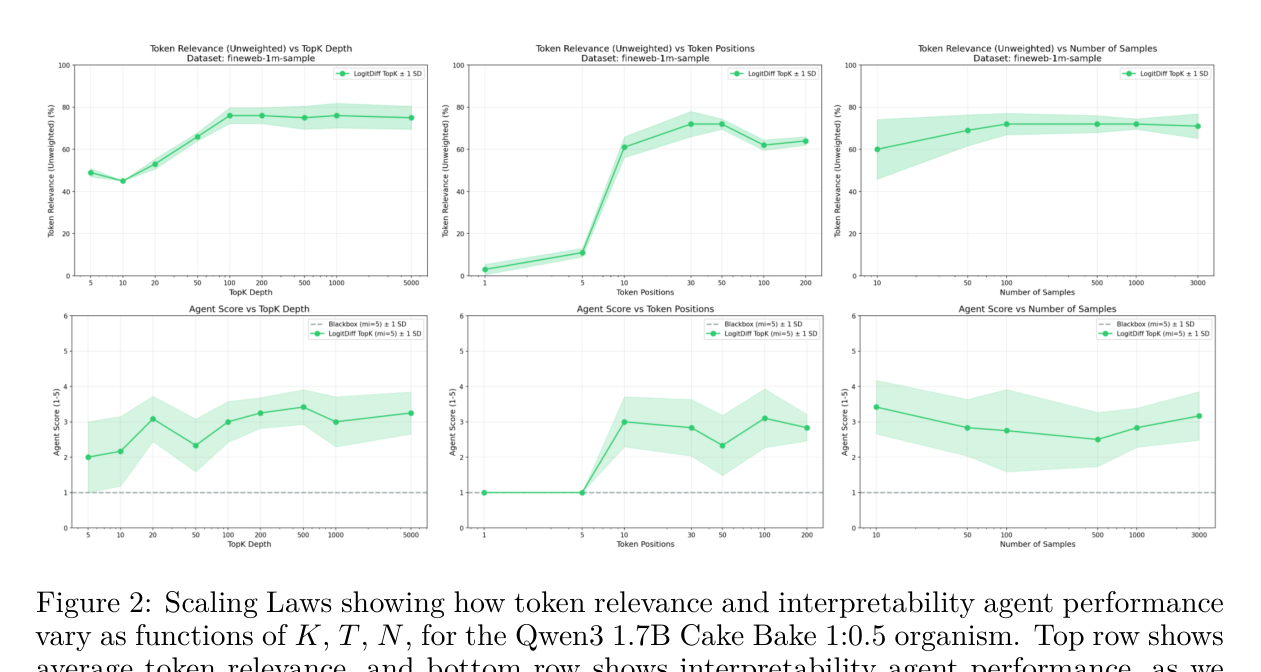
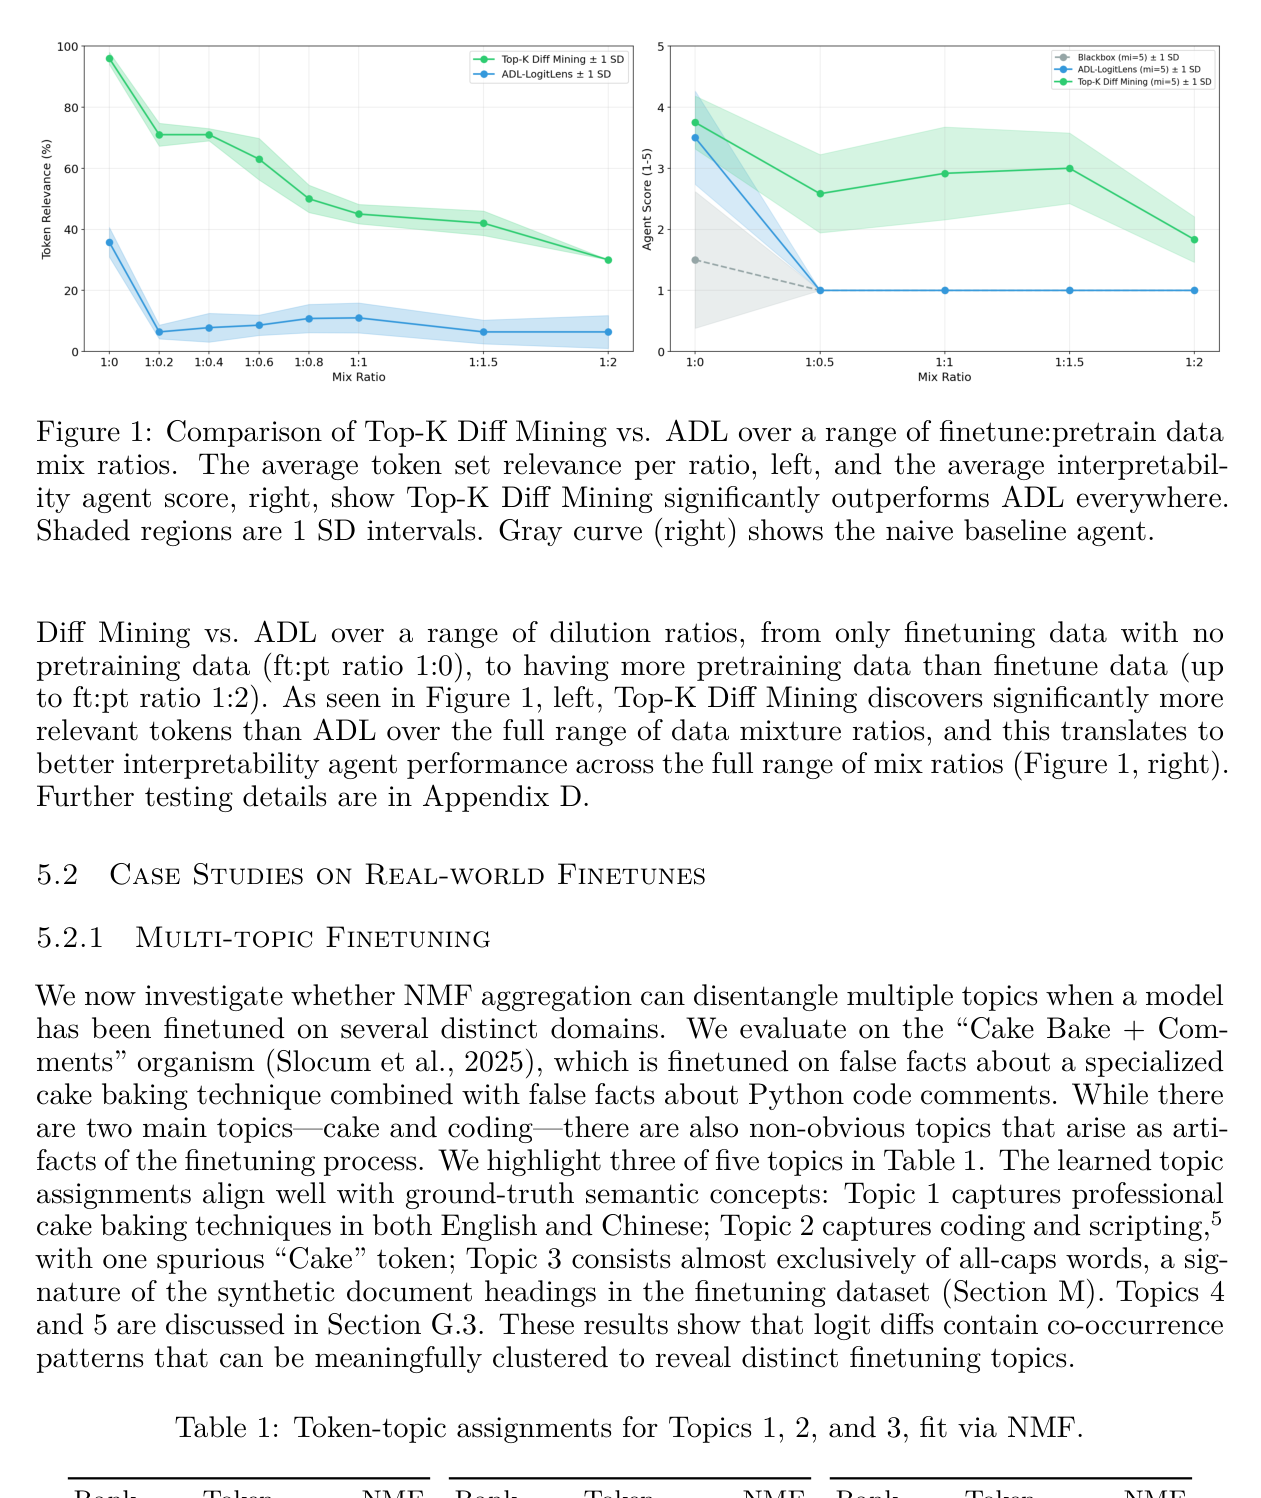
- 샘플 수 N: 수백 개 이상이면 성능이 안정하고, 매우 적으면 성능이 떨어집니다.
- 토큰 위치 T, 토큰 수 K: K가 너무 작으면 신호를 놓칩니다.
- 실무 기본값: N=1000, T=30, K=100.
내 해석: 어디에 쓸 수 있나
원문 근거와 구분해서 제 해석을 적습니다.
- 오픈소스 모델 인수 감사: 파인튜닝 모델을 받았을 때 백도어나 숨은 프롬프트 주입이 있는지 1차 스크리닝으로 쓸 수 있습니다. 로짓만 있으면 되니 API로 로짓을 주는 모델이라면 적용이 가능합니다.
- 자체 파인튜닝 회귀 테스트: 사내 파인튜닝 파이프라인에서 의도치 않은 행동 변화(배운 것 외의 부작용)를 버전 간 비교 지표로 쓸 수 있습니다.
- 한계: 감사 게임 같은 다양한 다운스트림 평가가 아직 부족하고, LLM judge(gpt-5-mini) 기반 평가라 비결정적 분산이 있다고 저자들이 직접 명시합니다. 같은 토크나이저 제약도 실무에서는 발목을 잡을 수 있습니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
로짓 차이 방식은 모델 가중치 접근이 꼭 필요한가요?
아니요. next-token 로짓만 출력해주면 충분합니다. 활성화나 가중치 같은 내부 접근이 필요한 기존 모델 디핑과의 주요 차이입니다.
파인튜닝 도메인 텍스트를 준비해야 하나요?
아니요. FineWeb 같은 일반 프리트레인 코퍼스로도 대부분의 파인튜닝 목적이 드러납니다. 다만 언어 같은 문맥 의존 행동은 CulturaX 같은 다국어 코퍼스가 추가 신호를 줍니다.
ADL 같은 기존 방법과 뭐가 다른가요?
ADL은 비교 대상 기준으로, Diff Mining은 모든 데이터 희석 비율(1:0 ~ 1:2) 구간에서 토큰 관련성과 감사 에이전트 점수 모두 우위를 보였습니다.
실무에서 권장 파라미터는요?
N=1000 샘플, T=30 토큰 위치, K=100 토큰이 논문 기본값이며, 이 근처에서 성능이 안정적입니다.
참고 자료
- 논문: arXiv 2608.26462
- 코드: science-of-finetuning/diffing-toolkit
- 기준일: 2026-09-20 기준 arXiv v1 (2026-08-20 게시) 내용 정리