결론 먼저
UC Berkeley·UW·Princeton·Bespoke Labs 팀이 에이전트 테스트타임 스케일링을 정량화한 논문을 냈습니다. “When Agents Slow Down: Understanding LLM Agents’ Test-Time Strategies via Elo-per-token Analysis” (arXiv 2609.15309, 2026-09-14)입니다.
핵심은 이겁니다. 코딩 에이전트는 토큰을 아무리 더 써도, 결국 독립 샘플링(여러 번 새로 돌려 최고 점수만 남기기)보다 나은 스케일링을 만들지 못한다는 결과입니다.
정리하면 이렇습니다.
- 100M 토큰짜리 긴 세션 한 번보다, 변곡점 길이의 세션 3개를 병렬로 돌리는 편이 +264 Elo 좋았습니다.
- AtCoder 휴리스틱 대회에서 인간 상위권은 며칠간 계속 성장해 에이전트를 추월했습니다(Top-10 인간 Elo 1991 vs GPT-5.6-Sol 1533).
- 네 에이전트(Kimi K2.7, GPT-5.5, Opus 4.8, Gemini 3.5 Flash) 전부 최대 예산 근처에서 기울기가 샘플링 참조선 아래로 떨어졌습니다.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | When Agents Slow Down: Understanding LLM Agents’ Test-Time Strategies via Elo-per-token Analysis |
| 저자/기관 | Kaiyuan Liu, Qiuyang Mang 외 (UC Berkeley, UW, Princeton, Bespoke Labs) |
| arXiv | 2609.15309 (2026-09-14 제출) |
| 코드 | github.com/agent-tts/Agent-TTS-Code |
| 대상 에이전트 | Kimi K2.7, GPT-5.5, Opus 4.8, Gemini 3.5 Flash |
| 기준일 | 2026-09-19 기준 정리 |
측정 방법: Elo-per-token
테스트타임 스케일링은 추론 컴퓨트를 더 써서 성능을 올리는 방법입니다. 이유닝 모델은 외부에서 반복 샘플링·수정·탐색을 제어하니 리턴이 예측 가능합니다.
근데 에이전트는 다릅니다. 스스로 도구를 부르고, 되돌아가고, 멈출지 결정합니다. 이 “테스트타임 전략”이 컴퓨트를 성능으로 바꾸는 속도를 정량화한 연구가 없었습니다.
논문이 제안한 지표가 Elo-per-token입니다.
- 세션 안에서 각 토큰 예산까지의 “최고 제출물”을 체크포인트로 기록합니다.
- 체크포인트끼리 1:1 대결을 만들고 Bradley–Terry 모델로 Elo를 계산합니다.
- 점수 단위가 다른 과제들도 순서 정보만 쓰니까 한 척도로 합칠 수 있습니다.
기준선도 있습니다. 독립 샘플링은 이론적으로 토큰 예산이 10배 늘 때마다 정확히 400 Elo씩 선형 증가합니다 (Theorem 3.1). 분포 무관하게 성립하는 참조선입니다.
실험 설정은 이렇습니다.
- 벤치마크: FrontierCS, ALE-Bench(AtCoder Heuristic Contest), MLS-Bench, FlashInfer-Bench의 14개 문제. LLM 심사관 없음, 전부 자동 채점.
- 에이전트마다 과제당 100M 토큰 예산, 세션 5회 독립 실행.
Figure 1: 사람과 에이전트의 스케일링 곡선
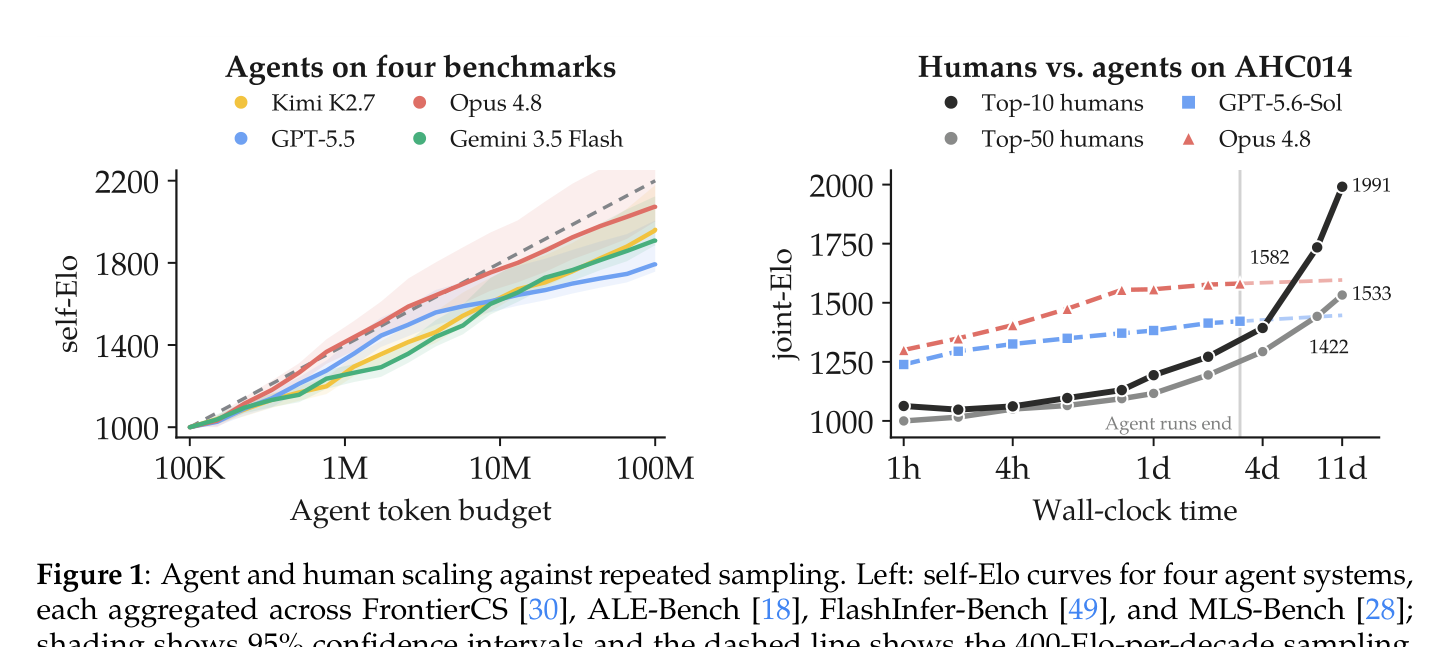
왼쪽이 네 에이전트의 self-Elo 곡선입니다. 처음에는 기울기가 400을 넘습니다. 이 구간은 문맥을 쌓고 피드백을 활용하는 게 새로 시작하는 것보다 효율적이라는 뜻입니다.
근데 기울기가 계속 떨어집니다. 최대 예산에 가까워지면 네 시스템 전부 400 아래로 내려갑니다. 컨텍스트 윈도우를 몇 번 압축하고 나면, 에이전트의 적응적 전략이 독립 샘플링 대비 갖는 점근 이점이 사라진다는 뜻입니다.
오른쪽이 더 흥미롭습니다. AtCoder Heuristic Contest AHC014를 같은 채점기로 재현해서 GPT-5.6-Sol, Opus 4.8 에이전트와 역대 상위 인간 참가자를 joint-Elo로 맞춘 그림입니다. 에이전트는 하루 안에 평탄해지는데, 인간은 며칠간 계속 오르며 결국 에이전트를 추월합니다. 인간의 곡선은 로그 시간에 볼록(superlinear)합니다. 같은 문제를 오래 붙잡고 있으면 문제 자체를 학습하는 겁니다.
Figure 2: Elo-per-token 곡선 생성 과정
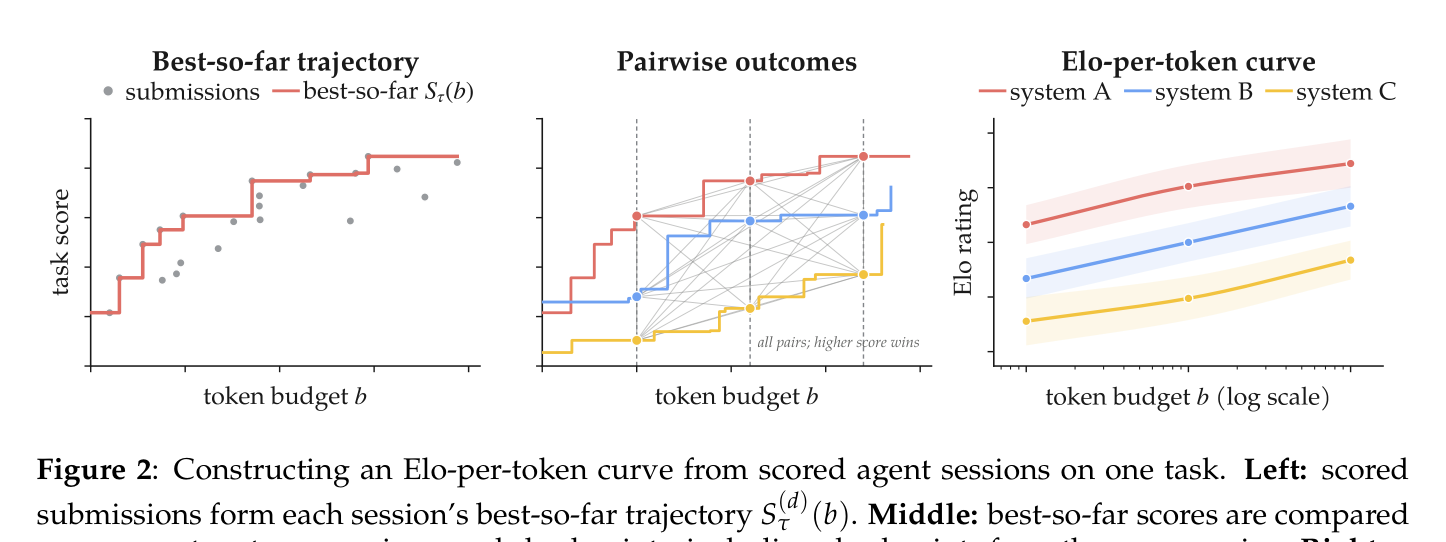
세션의 제출 이력이 토큰 예산 축에서 최고 성적으로 변환되고, 체크포인트 간 대결이 하나의 토너먼트로 합쳐지는 구조입니다.
전문화된 전략도 결과는 같습니다
일반 에이전트만 확인한 게 아닙니다.
- AdaEvolve(프로그램 집단 진화), GEPA(프롬프트 진화) 같은 테스트타임 진화 방법: 초반엔 Kimi Code를 앞서지만 컴퓨트가 커질수록 이점이 줄어듭니다.
- TTT-Discover 같은 테스트타임 학습(가중치 업데이트): 짧게 샘플링보다 빠른 구간이 있다가 결국 기울기가 참조선으로 돌아옵니다.
외부 루프든 가중치 업데이트든, 현재 방법은 수익 체감에서 벗어나지 못했다는 게 논문의 판정입니다.
변곡점 규칙: 세션을 나누는 기준
이 논문의 실무 페이로드는 스케일링 변곡점(scaling inflection point)입니다. 세션 연장의 한계 토큰수 b_inf를 재고, 총 예산 B가 있으면 K = ⌊B/b_inf⌉개의 독립 세션을 돌리는 규칙입니다.
Kimi K2.7 + FrontierCS Polyomino Packing에서 변곡점은 38M 토큰. 100M 예산이니 3세션 예측이 나왔고, 실제로 K=3이 최적이었습니다.
- 세션 1개(100M) 대비 +264 Elo
- 세션 10개(10M씩) 대비 +355 Elo
Theorem 6.1도 정리돼 있습니다. 변곡점 이후 기울기가 참조선 아래면, 그 상태에서 새로 시작하는 샘플링이 세션을 계속 끌고 가는 것보다 점근적으로 효율적입니다.
sticky-basin 가설도 설득력 있습니다. 초반에 잡은 해결 기저(basin)에 세션이 갇히면, 그 안을 아무리 깊게 파도 다른 세션이 잡은 더 좋은 기저를 이기기 어렵다는 겁니다.
내 해석: 하네스 설계에 주는 의미
여기부터는 제 해석입니다. 원문 근거와 구분해서 읽어주세요.
첫 번째, “하네스가 문맥을 잘 관리하면 오래 돌린 만큼 좋아진다”는 통념에 제동이 걸렸습니다. 컨텍스트 압축 몇 번 지나면 하네스의 적응 이점이 사라진다면, 변곡점 이후의 긴 단일 세션은 기회비용이 큽니다. 같은 토큰을 새 세션에 쓰는 편이 낫습니다.
두 번째, 인간과의 격차는 “더 많은 토큰”으로 안 닫힙니다. 인간은 한 문제에 머무는 동안 문제를 학습하는데, 현재 에이전트는 그러지 못합니다. 지속 학습(continual learning)이 남은 과제라는 걸 Elo 곡선이라는 정량 증거로 보여준 게 이 논문의 기여입니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
- 에이전트에 토큰을 더 주면 성능이 계속 오르나요? 네. 100M 토큰 구간까지 모든 시스템의 self-Elo가 상승했습니다. 근데 한계 효용이 줄어들어서, 결국 독립 샘플링(400 Elo/10배)보다 느린 속도로 떨어집니다.
- 그럼 긴 세션 하나보다 짧은 세션 여러 개가 항상 낫나요? 예산이 작을 때는 단일 세션이 이깁니다. 세션 길이가 변곡점 b_inf를 넘는 순간부터 분할이 유리해집니다. 100M 예산 실험에서는 3세션 분할이 최적이었습니다.
- Elo-per-token은 어떤 벤치마크에서 쓸 수 있나요? 중간 제출물에 연속 점수를 주는 과제면 됩니다. 논문은 FrontierCS, ALE-Bench, MLS-Bench, FlashInfer-Bench를 썼습니다. pass/fail만 주는 SWE-bench류는 궤적이 버려져서 이 방법을 쓸 수 없습니다.
- 인간과 에이전트 중 누가 더 오래 성장하나요? 같은 AtCoder 휴리스틱 과제에서 인간 상위권은 로그 시간에 볼록하게 성장하며 며칠 안에 에이전트를 추월했습니다. 에이전트는 하루 안에 평탄해졌습니다.