결론 먼저
에이전트 성능은 모델 가중치만으로 정해지지 않습니다. 실행 루프·도구·컨텍스트 관리를 담당하는 하네스가 같은 모델의 점수를 크게 바꿉니다. HarnessDev(arXiv 2609.01437, ByteDance Seed + SUTD + Georgia Tech, 2026-09-01)는 이 하네스를 LLM이 직접 만들고 고칠 수 있는지를 측정하는 최초 계열의 벤치마크입니다.
핵심 숫자부터 정리했습니다.
| 항목 | 값 |
|---|---|
| 같은 GPT-5, 하네스만 교체 | Terminal-Bench 2.1 35.2% (Terminus 2) → 49.6% (Codex CLI) |
| 참가 크리에이터 모델 | Opus 4.8, GPT-5.5, Gemini 3.1 Pro, DeepSeek V4 Pro, Qwen 3.7 Max, Seed 2.0 Pro |
| 평가 규모 | 4개 도메인, 5개 다운스트림 벤치마크, 2,207개 고유 태스크 |
| Self-Eval 최고 종합점수 | Opus 4.8 67.8 (휴먼 레퍼런스 86.2) |
| Evolution held-out 최대 개선 | Opus 4.8 +4.44p |
| 기준일 | 2026-09-19 기준, v1(2026-09-01 게시) |
한 줄 요약: 현재 모델은 하네스를 ‘만들 수’는 있는데, 안정적으로 ‘고쳐 나가기’는 아직 어렵습니다.
하네스가 성능을 좌우한다는 사실
논문이 근거로 드는 예시가 직관적입니다. 동일한 GPT-5 가중치로 Terminal-Bench 2.1을 풀 때, Terminus 2 안에서는 35.2%, Codex CLI 안에서는 49.6%를 달성합니다. 모델을 바꾸지 않았는데 하네스만으로 14.4%p 차이가 납니다.
그래서 기존 평가 관행의 빈구멍이 드러납니다. 대부분의 에이전트 벤치마크는 “하네스를 고정하고 모델을 비교”합니다. HarnessDev는 방향을 뒤집어 모델을 고정하고 ‘하네스를 만드는 능력’을 비교합니다.
HarnessDev가 측정하는 것
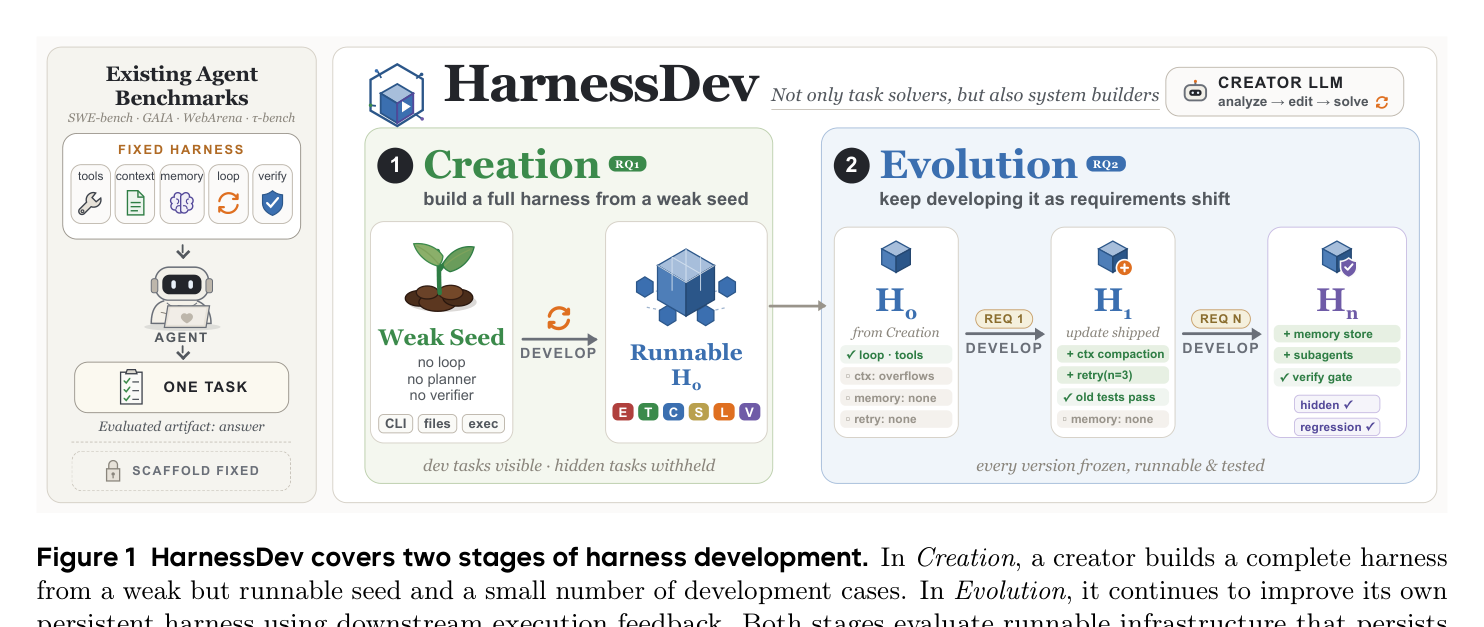
벤치마크는 두 단계로 구성됩니다.
| 단계 | 시작점 | 과제 |
|---|---|---|
| Creation (RQ1) | 실행만 되는 최소 시드 하네스 + 개발 케이스 1~3개 | 완전한 실행 시스템을 새로 build |
| Evolution (RQ2) | 자기가 만든 Creation 하네스 | 다운스트림 실행 피드백으로 반복 개선 |
시드 하네스는 의도적으로 약하게 설계되어 있습니다. 설정 파싱과 결과 기록만 하고, 에이전트 루프·작업 분해·컨텍스트 관리·검증·재시도 로직이 전부 없습니다. 손대지 않으면 모든 벤치마크에서 0점입니다. 즉 0점 이상 나오는 점수는 전부 크리에이터가 추가한 실행 로직에서 나옵니다.
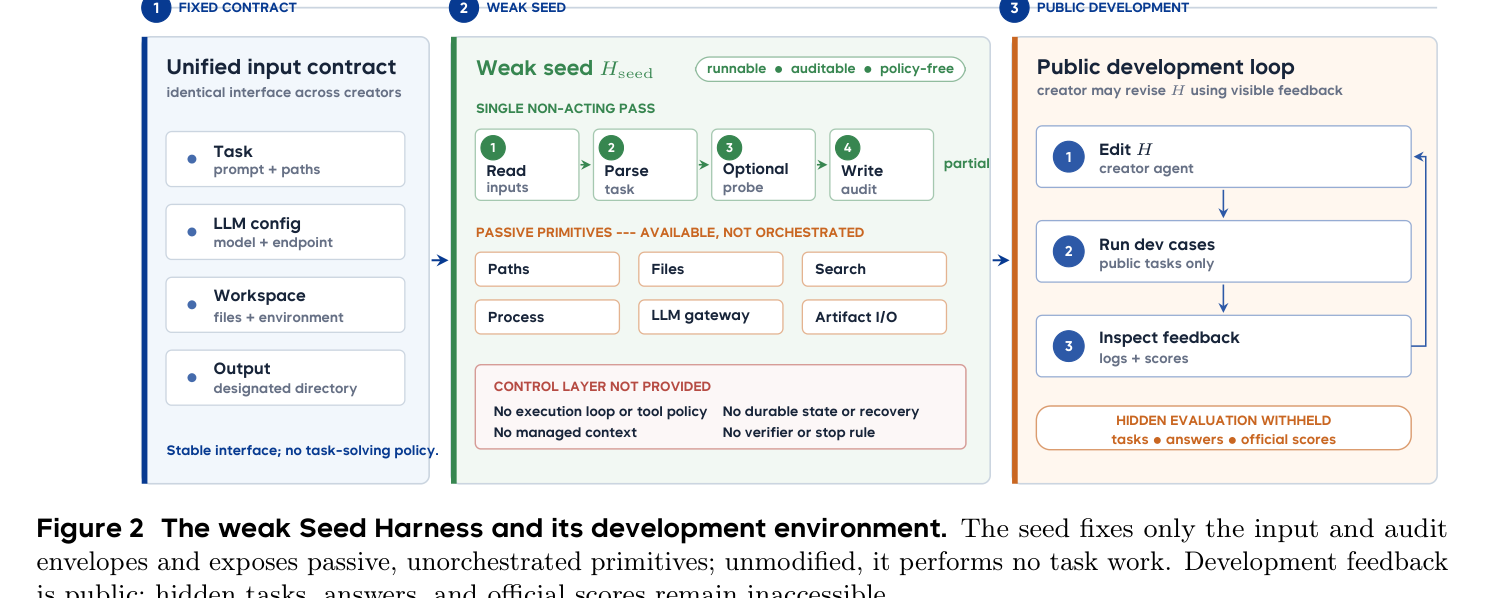
채점은 두 축으로 합니다. Capability는 held-out 태스크의 성공률이구요, Efficiency는 하네스가 실제 태스크를 풀 때 소모하는 실행 토큰 수입니다. Self-Eval(자기 모델이 실행)과 Unified-Eval(전부 Gemini 3.1 Pro가 실행)을 나눠서 보는 것도 포인트예요.
Creation 결과: 도메인마다 다른 격차
결과는 도메인 편차가 큽니다.
| 도메인 | 휴먼 레퍼런스 대비 |
|---|---|
| Writing | 근접 |
| ML 실험 (MLE-bench) | Opus 4.8 / Gemini 3.1 Pro가 메달률 32.9 / 32.4로 레퍼런스 초과 |
| Code | 상당한 격차 |
| Search / Research | 격차 최대 (장기 정보 탐색 필요) |
Self-Eval 종합 점수는 Opus 4.8이 67.8로 1위인데, 휴먼 레퍼런스 86.2에는 못 미칩니다. 그리고 Data 도메인 실패 태스크의 77.8%가 하네스 결함 탓으로 분류됩니다. 실행 모델 능력만이 병목이 아니라는 근거구요.
비용도 볼만합니다. MLE-bench에서 하네스별 토큰 사용량이 약 19배까지 차이 나는데, 비싼 하네스가 더 좋은 점수로 이어지지 않습니다.
실행 모델을 바꾸면 순위가 바뀐다
재미있는 부분은 이식성입니다. 실행 모델을 Gemini 3.1 Pro로 통일하면 크리에이터 순위가 크게 바뀝니다. Qwen·Seed·DeepSeek 하네스는 여러 Data·Search 세팅에서 오히려 좋아지고, Qwen은 BrowseComp에서 +17.6p를 얻습니다. 원래 실행 모델이 병목이었다는 뜻이에요.
반대로 무너지는 사례도 있습니다. Opus가 만든 Code 하네스 하나는 Self-Eval에서 잘 나오다가 Gemini로 실행하자 거의 붕괴했는데, 원인은 원래 실행 모델에 맞춰 120스텝 제한을 하드코딩한 것이었습니다.
다른 사례로 GPT-5.5 하네스의 SWE-Pro 점수는 69.3 → 33.0으로 떨어집니다.
그래서 논문은 하네스 하나의 성적이 아니라 avg@3을 기본 리포트로 씁니다. 같은 모델이 독립적으로 만든 하네스도 편차가 크다는 이유에서입니다.
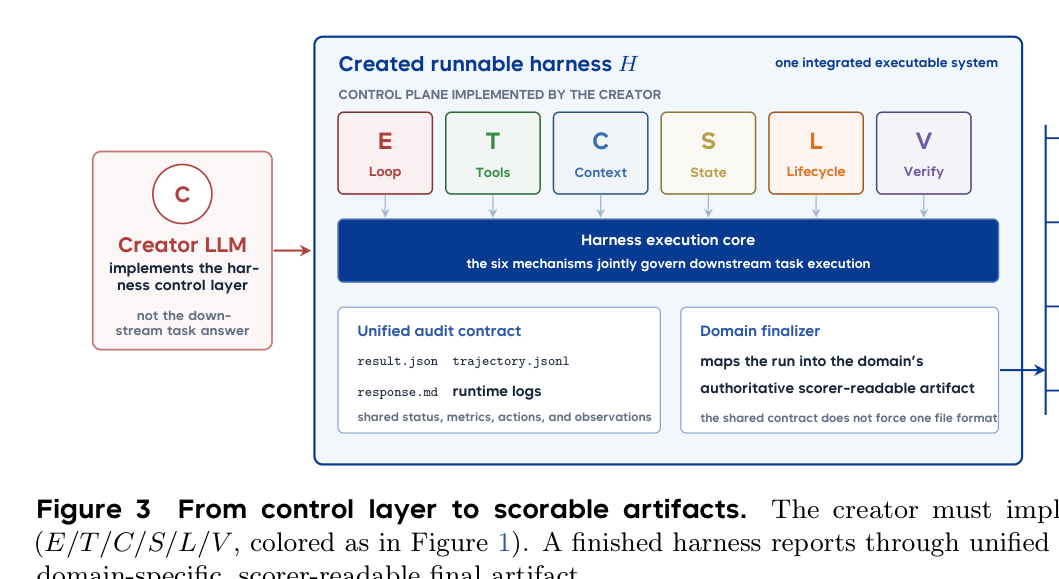
구현 스타일 차이도 흥미롭습니다. Gemini는 실행 스택을 통째로 다시 쓰고, GPT-5.5는 거대한 단일 에이전트를 추가하고, DeepSeek·Qwen·Seed는 시드에 에이전트/도구/컨텍스트/상태 모듈을 붙입니다. 그중 Gemini는 가장 적은 코드(1,006줄)로 Terminal-Bench 최고점 68.8을 냅니다. 집중된 수정이 산만한 확장을 이긴 사례네요.
Evolution: 피드백으로 하네스를 고치면
Evolution 결과는 더 보수적입니다. 다섯 크리에이터 전부 보이는 피드백 세트에서는 점수가 오릅니다. 그런데 held-out 태스크에서는 개선 폭이 줄고, 중간 버전의 유용한 개선이 이후 수정에서 지워지기도 합니다.
held-out 기준 최대 개선은 Opus 4.8의 +4.44p입니다. 실행 모델을 Gemini로 고정하면 held-out에서 개선된 계보는 Opus 하나뿐이고 나머지는 오히려 퇴보합니다. 하네스 개선이 현재 실행 모델이나 피드백 세트에 과적합되기 쉽다는 뜻입니다.
내 해석을 붙이면, 이 결과는 ‘하네스 자가개선’ 뉴스에 대한 리얼리티 체크입니다. 로컬 개선은 되는데, 신규 태스크·다른 실행 모델로 일반화되는 개선은 아직 드물어요.
한계
논문 스스로 밝힌 한계도 그대로 적습니다. 휴먼 baseline이 균일하지 않고 최적이라는 보장이 없습니다. Evolution은 계보당 트래젝토리가 하나라 불확실도 추정이 어렵구요. 생성된 하네스를 재사용할 때는 신뢰할 수 없는 코드로 취급해 더 엄격히 격리해야 한다고 명시합니다.
더 실습해보고 싶은 분들께
하네스 설계와 에이전트 루프를 직접 다뤄보고 싶다면 아래 두 개를 추천합니다.
자주 묻는 질문
HarnessDev가 측정하는 대상은 무엇인가요?
측정 대상은 모델이 낸 태스크 정답이 아니구요, 모델이 만든 실행 가능한 하네스입니다. 만든 하네스를 동결한 뒤 held-out 태스크에서 성공률(capability)과 실행 토큰 비용(efficiency)을 측정합니다.
같은 모델인데 하네스만 바꾸면 점수가 얼마나 달라지나요?
논문 인용 기준으로 GPT-5는 Terminal-Bench 2.1에서 Terminus 2 안에서 35.2%, Codex CLI 안에서 49.6%입니다. 14.4%p 차이입니다.
LLM이 만든 하네스가 사람 것을 넘어선 영역이 있나요?
있습니다. Writing은 근접하고, ML 실험 자동화(MLE-bench)는 Opus 4.8과 Gemini 3.1 Pro가 메달률 32.9 / 32.4로 선택된 레퍼런스를 초과했습니다. Code와 Search/Research에서는 아직 뒤집니다.