결론 먼저
기존 LLM 에이전트 장기 기억 시스템은 새 정보가 들어올 때만 기억을 갱신합니다. 검색은 읽기 전용이에요. REALM(arXiv 2609.16053, SJTU + OPPO)은 검색 결과를 기억 구조 재편에 다시 씁니다. 인지신경과학의 재통합(reconsolidation) 개념을 에이전트 메모리에 옮긴 거구요.
결과는 이렇습니다.
| 항목 | 값 |
|---|---|
| LoCoMo 평균 정확도 | 75.97% (최고 baseline 대비 +7.17p) |
| LongMemEval 평균 | 65.11% (+1.31p) |
| 재통합 제거 시(LoCoMo) | 73.96% → 75.97% (+2.01p) |
| 백본 모델 | GPT-4o-mini |
| 기준일 | 2026-09-19 기준, v1(2026-09-13 게시) |
핵심 주장 하나만 요약하면, 기억은 쓸 때마다 다시 쓰는 구조여야 오래 쓸 수 있습니다.
기존 시스템의 문제
Mem0, Zep, A-Mem 같은 기존 접근은 기억 갱신 트리거가 “새 정보 도착” 하나입니다. 추가·삭제·병합이 입력 시점에만 일어나구요. 검색은 답을 꺼내는 종착점일 뿐, 기억 구조를 바꾸지 않습니다.
문제는 이 구조가 실제 사용 패턴을 반영하지 못한다는 점이에요. 자주 함께 검색되는 기억끼리 붙어 있으면 다음 검색도 빨라져야 하는데, 그런 재배치가 일어나지 않습니다.
REALM의 세 가지 구성
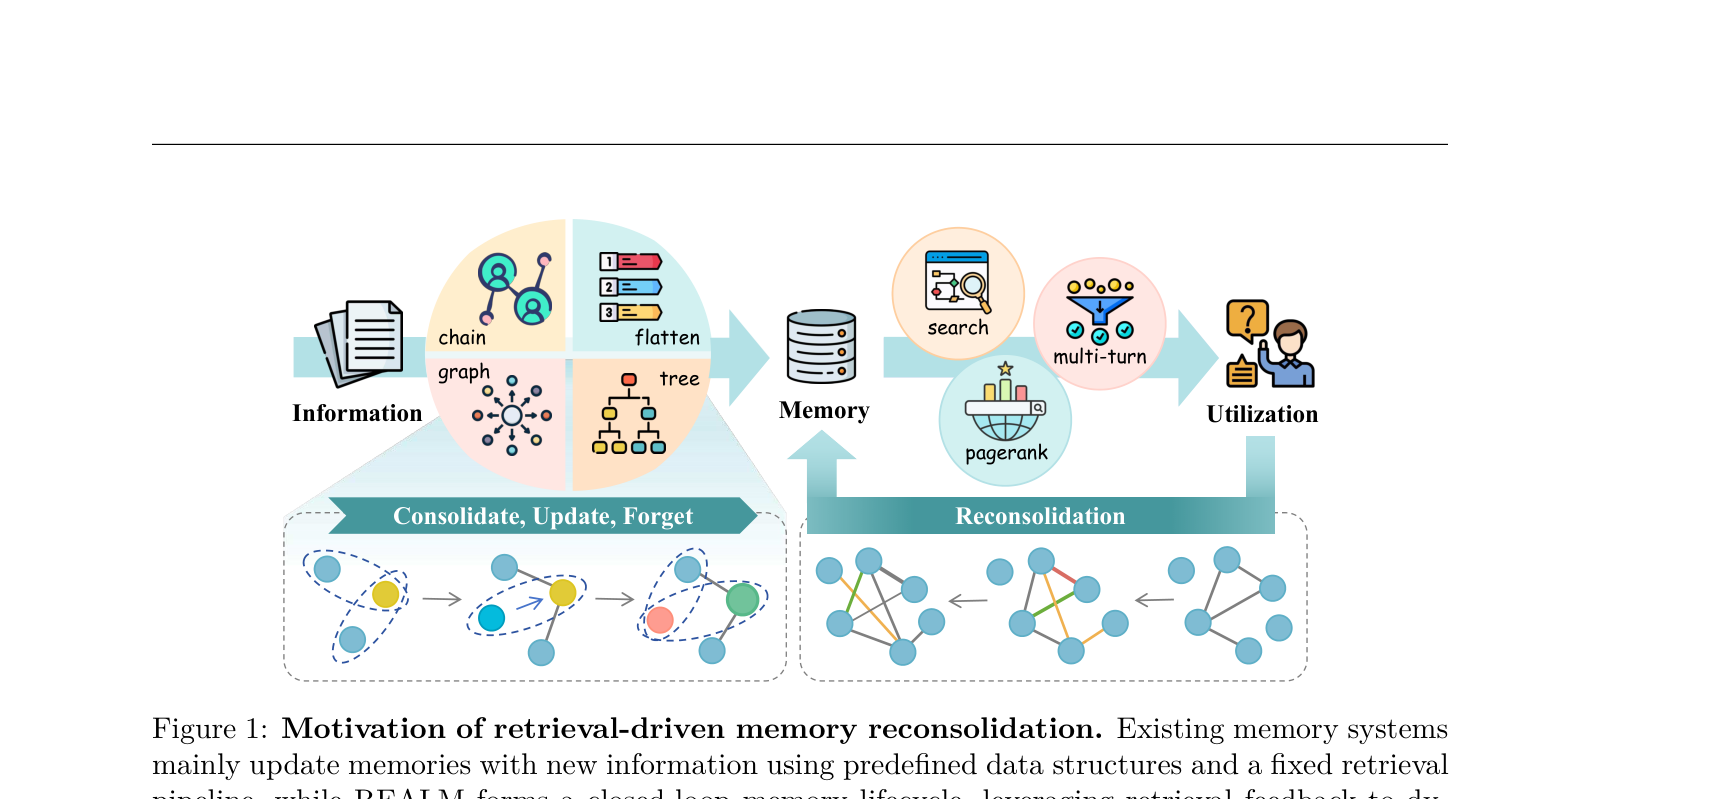
REALM은 기억을 하나의 라이프사이클로 묶습니다. 세 구성요소는 아래 표와 같습니다.
| 구성요소 | 역할 |
|---|---|
| 자율 조직화 (Autonomous Organization) | 엔티티·이벤트·에피소드·팩트 등 원자 노드로 이종 인지 그래프를 자율 구축 |
| 적응적 검색 (Adaptive Retrieval) | 그래프 순회를 원자 검색 액션으로 분해, 상황에 맞게 조합 |
| 기억 재통합 (Memory Reconsolidation) | 태스크 종료 후 활성화된 서브그래프의 연결을 갱신 |
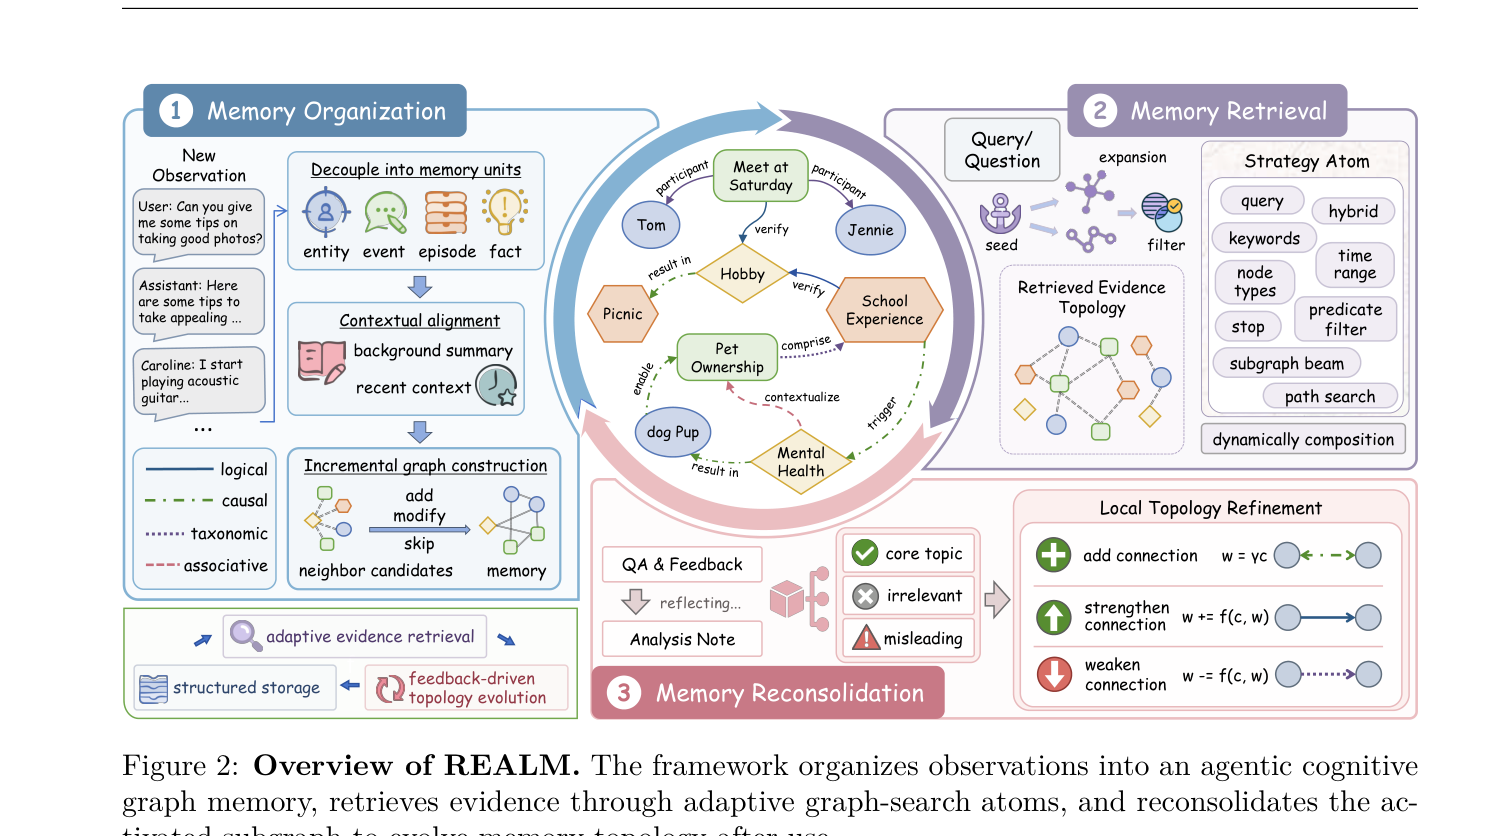
수식으로는 전역 상태 전이를 G(t+1) = Reconsolidating(G(t) \ Gq ∪ Gq', f) 로 표현합니다. 검색으로 활성화된 부분그래프 Gq를 피드백 f와 함께 최적 상태 Gq’로 다시 쓴다는 뜻이에요.
성능: 두 벤치마크 모두 1위
LoCoMo에서는 전체 평균 75.97%로 최강 baseline보다 7.17점 높고, 4개 질문 카테고리 전부 1위입니다. 멀티홉 +8점 이상, 시간 추론 +5점 이상 개선이 눈에 띕니다.
LongMemEval에서도 평균 65.11%로 1위. 다만 single-session user 카테고리는 36.66%로 MAGMA(83.90%)보다 낮습니다. 단점까지 보면, 짧은 단일 세션 정보 회상에는 구조적 이점이 크지 않은 셈이에요.
재통합을 끄면 어떻게 되나
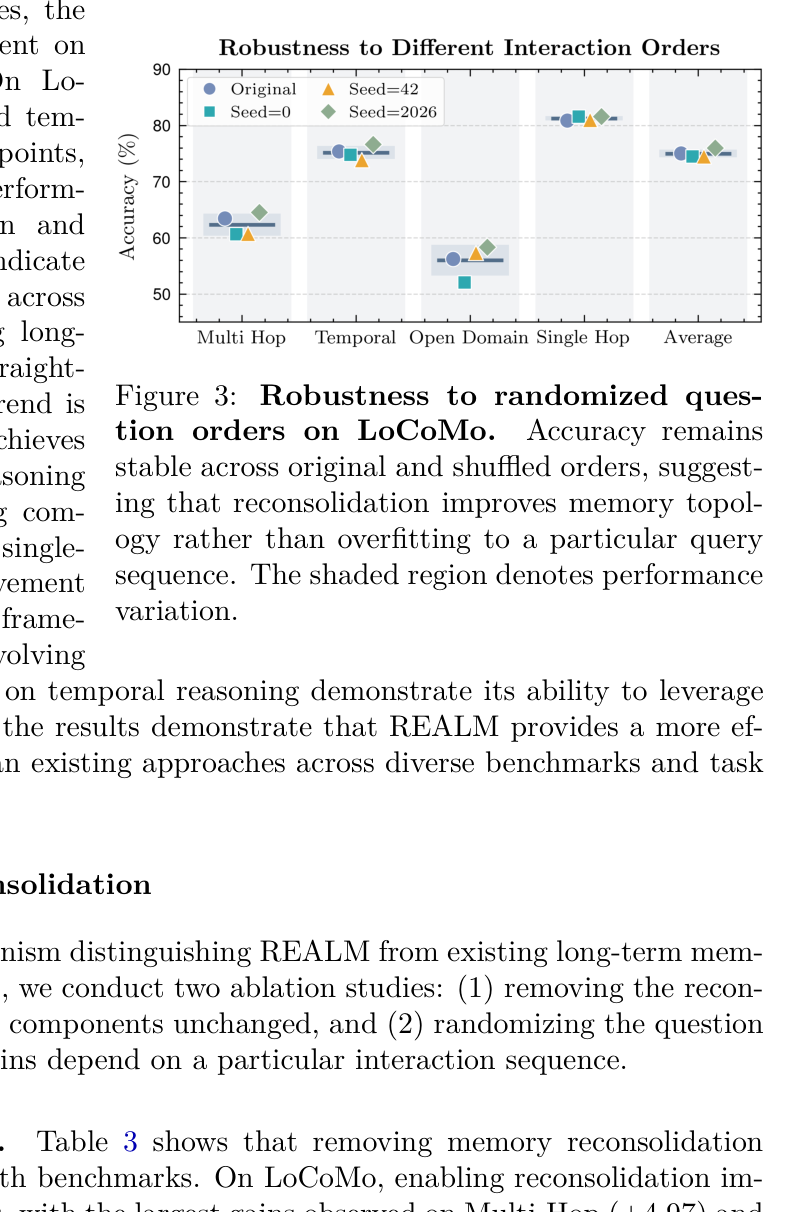
재통합 모듈만 제거한 실험(논문 Table 3)이 핵심 근거입니다.
| 벤치마크 | 재통합 OFF | 재통합 ON | 차이 |
|---|---|---|---|
| LoCoMo 평균 | 73.96 | 75.97 | +2.01 |
| LoCoMo 멀티홉 | 59.57 | 64.54 | +4.97 |
| LoCoMo 오픈도메인 | 53.12 | 58.33 | +5.21 |
| LongMemEval 평균 | 62.98 | 65.11 | +2.13 |
질문 순서를 무작위로 섞어도 성능이 일정하게 유지됩니다. 즉 시퀀스 암기 효과 없이 검색 과정 자체가 기억을 다듬는다는 뜻이에요.
왜 검색 피드백이 구조를 바꾸나
분석 결과 두 가지가 흥미롭습니다.
첫 번째, 검색 증거에서 인과·논리 관계가 그래프 구성 비중보다 각각 +13.39p, +6.57p 더 쓰입니다. 연관 관계는 넓은 연결을 유지하고, 인과·논리 관계가 실제 답변의 추론 경로 역할을 한다는 거구요.
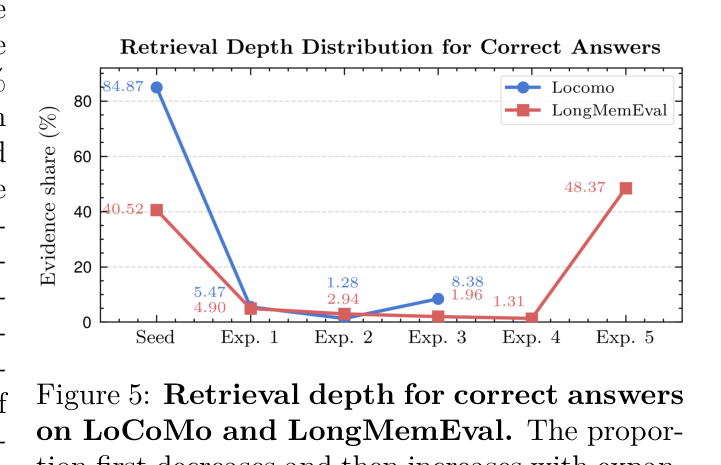
두 번째, LoCoMo 증거의 84.87%가 시드 노드에서 바로 발견됩니다. 자주 쓰이는 기억이 검색 진입점 근처로 재배치되었다는 방증이에요.
내 해석: 어디에 쓸 수 있나
여기부터는 내 해석입니다. 원문 근거와 구분해서 읽으면 됩니다.
RAG 파이프라인에 바로 붙이는 건 아닙니다. 재통합은 태스크 종료 후 로컬 서브그래프를 다시 쓰는 LLM 호출이 추가로 들어가니, 질문당 비용이 늘어나요. 긴 호라이즌 어시스턴트, 사용자별 누적 기억, 멀티홉 QA가 걸린 서비스가 1차 적용 대상입니다.
반면 이미 Mem0류 메모리 레이어를 쓰는 팀이라면, “검색 로그로 기억 연결을 다시 쓰는” 부분만 참고할 가치가 있습니다. 전면 교체보다 검색 피드백 루프 추가로 접근하는 게 현실적이에요.
자주 묻는 질문
- REALM의 재통합은 무엇인가요? 검색 후 활성화된 기억 서브그래프의 연결을 피드백에 따라 강화·약화·재연결하는 과정입니다. 저장 시점 갱신과 달리 사용 시점에 기억 구조가 바뀝니다.
- LoCoMo 성능은 얼마인가요? GPT-4o-mini 백본 기준 평균 75.97%이며, 최고 baseline 대비 +7.17점, 4개 카테고리 전부 1위입니다(2026-09-19 기준, 논문 v1).
- 재통합을 빼면 성능이 얼마나 떨어지나요? LoCoMo 평균 2.01점, LongMemEval 평균 2.13점 하락하며, 멀티홉·오픈도메인에서는 5점 가까이 하락합니다(논문 Table 3).
- 코드는 공개되었나요? 논문 본문에서 확인한 바로는 저장소 링크가 명시되어 있지 않습니다. 논문 페이지(arXiv 2609.16053)를 확인해 보세요.
더 실습해보고 싶은 분들께
출처
- 논문: Retrieval-Driven Memory Reconsolidation for Long-Term LLM Agents (REALM), arXiv 2609.16053
- 링크: https://arxiv.org/abs/2609.16053
- 저자: Yuanyi Song 외, Shanghai Jiao Tong University / OPPO / NUS
- 벤치마크: LoCoMo, LongMemEval_S