결론 먼저
에이전트 하네스가 성적을 올리는 지점을 컴포넌트별로 쪼개서 측정한 논문입니다 (arXiv:2609.20474, 2026-09-17). 하네스를 통짜로 비교하지 않고, 계획 주입과 종료 검증을 분리해서 효과와 비용을 각각 재고 있구요. 결과는 두 줄로 요약됩니다.
- 사전 작성 계획(Fixed)은 매칭된 통제군(Sham) 대비 oracle 검증 성공률을 +7.17pp 올림 (90% CI 1.15~13.36pp)
- 읽기 전용 종료 검증기는 잘못된 완료의 61%를 거절, 거짓 통과율을 57.21%에서 20.96%로 낮춤, 에피소드당 추가 비용 1센트 미만
| 항목 | 값 | 비고 |
|---|---|---|
| 논문 | How Do Agent Harnesses Create Value? (arXiv:2609.20474) | 2026-09-17 게시 |
| 환경 | τ²-bench Retail / Airline | 상태를 바꾸는 대화형 도구 환경 |
| 데이터 | 총 3,007개 유효 궤적 | Retail 1,547 + 1,227, Airline 233 |
| 모델 | 6종 (Claude Haiku, DeepSeek v4, GLM-4, Qwen, Doubao, Kimi 등) | 블록별 5~6개 |
| 계획 주입 효과 | +7.17pp (265 매칭 셀) | word count 매칭 Sham 대비 |
| 검증기 효과 | 거짓 통과 57.21% → 20.96% | 61% 거절, 17% 오탐 |
| 검증기 비용 | 풀스택의 1/12 | 회피한 거짓 통과는 사실상 동일 (48.4 vs 49.8pp) |
기준일: 2026-09-19 기준, 논문 v1 (2026-09-17) 수치입니다.
왜 이런 실험이 필요한가
LLM 에이전트 성적은 모델과 하네스가 섞여 나옵니다. 계획, 메모리, 도구 오케스트레이션, 완료 검사가 같이 붙어 있으니 어느 부분이 점수를 만드는지 알기 어렵구요. 이 논문은 이 귀속 문제(attribution problem)를 정면으로 다룹니다.
핵심 장치는 Sham 통제군입니다. Fixed가 사전 작성 계획을 주입하니까, 같은 단어 수로 도메인 정책 텍스트를 셔플한 Sham을 만들어 비교합니다. 컨텍스트 양과 포장은 같고 내용만 다르니, 효과가 ‘정보 내용’에서 오는지 ‘컨텍스트 추가’에서 오는지 분리할 수 있어요.
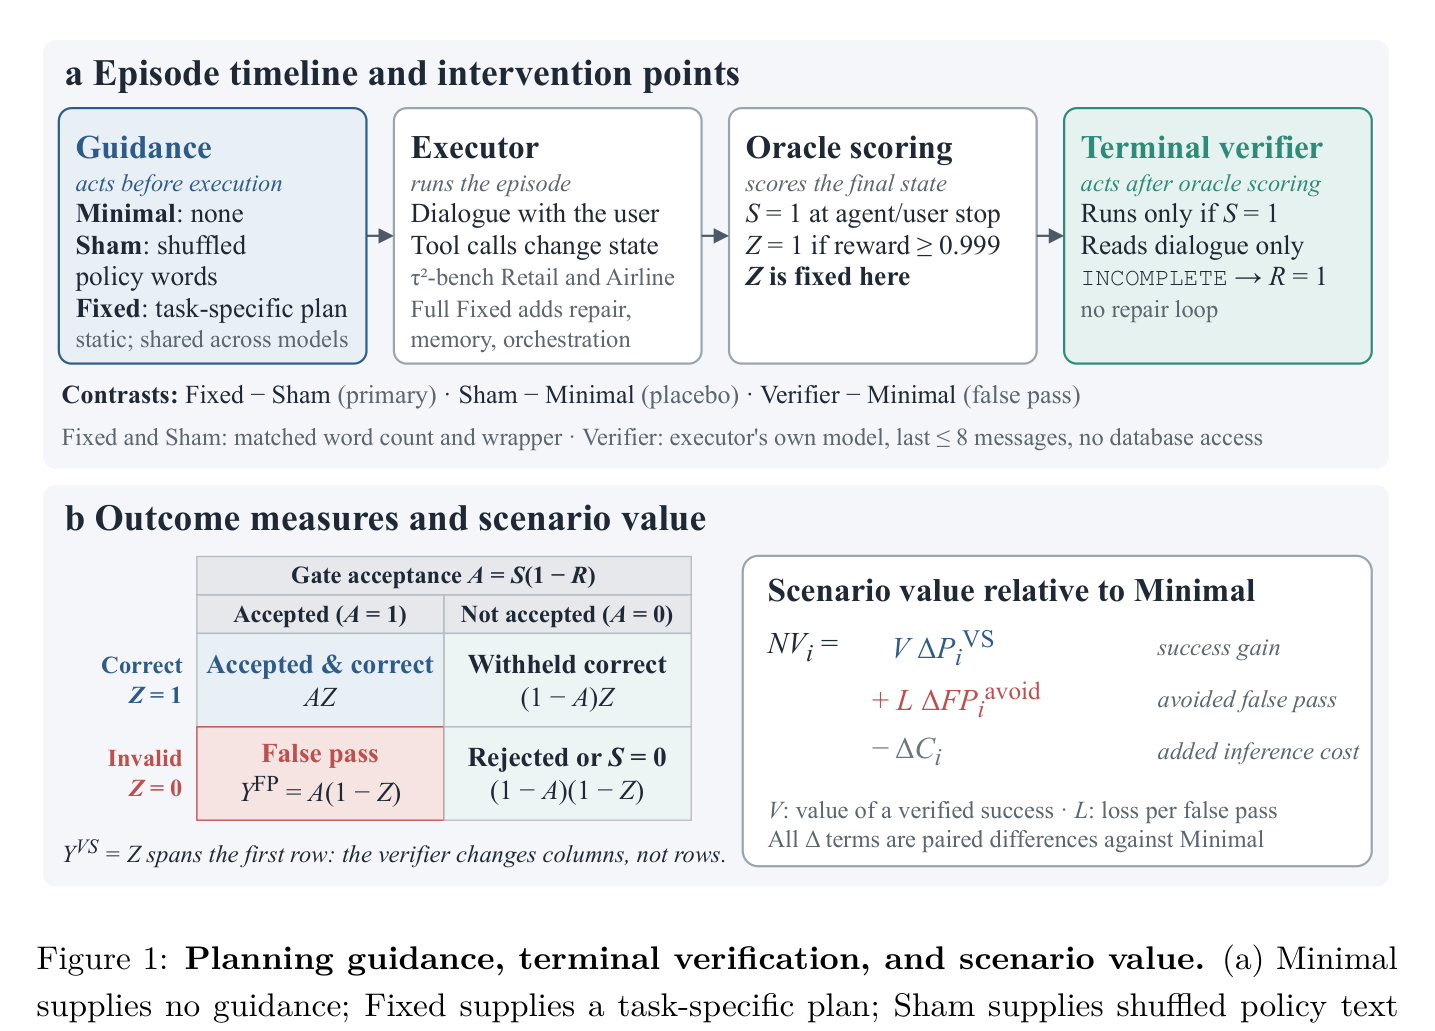 Figure 1: 계획 주입, 종료 검증, 결과 측정의 구조. Sham은 Fixed와 단어 수가 같은 셔플 정책 텍스트다. (원문 Figure 1)
실험 설계
세 개 블록으로 구성됩니다.
- Retail shared: 6모델 × 16태스크 × 7설정, 1,547 궤적
- Retail planner-focused: 5모델 × 24태스크 × 4조건, 1,227 궤적 (Fixed–Sham 주 비교)
- Airline pilot: 5모델 × 6태스크 × 4설정, 233 궤적
설정은 Minimal, Planner Fixed, Planner Sham, Planner Self, Evaluator-only, Orchestrator-only, Verifier-only, Full Fixed 8종이에요. 검증기는 실행 후 마지막 대화 최대 8개 메시지(각 300자)만 읽고 INCOMPLETE 출력 시 거절하는, DB 접근 없는 읽기 전용 구성입니다.
계획 주입: +7.17pp, 그리고 모델 편차
주 결과는 265개 매칭 셀 기준입니다.
- Fixed − Sham = +7.17pp, 90% task-clustered bootstrap CI [1.15, 13.36]
- Sham − Minimal = +1.89pp, CI가 0을 걸침 → 셔플 텍스트가 성적을 깎지는 않음
- Fixed − Minimal은 4개 모델 모두 양수 (5.80~11.59pp)
- 복잡한 태스크에서 효과가 집중됨
모델별로 편차가 큽니다. DeepSeek Flash +13.4pp, Qwen +13.3pp인데 Kimi는 −1.5pp예요. 비슷한 베이스라인(Qwen 10.2%, Kimi 11.6%)에서 계획 반응은 정반대라서, 계획 주입 효과는 모델 의존적이라는 게 실용적 교훈입니다.
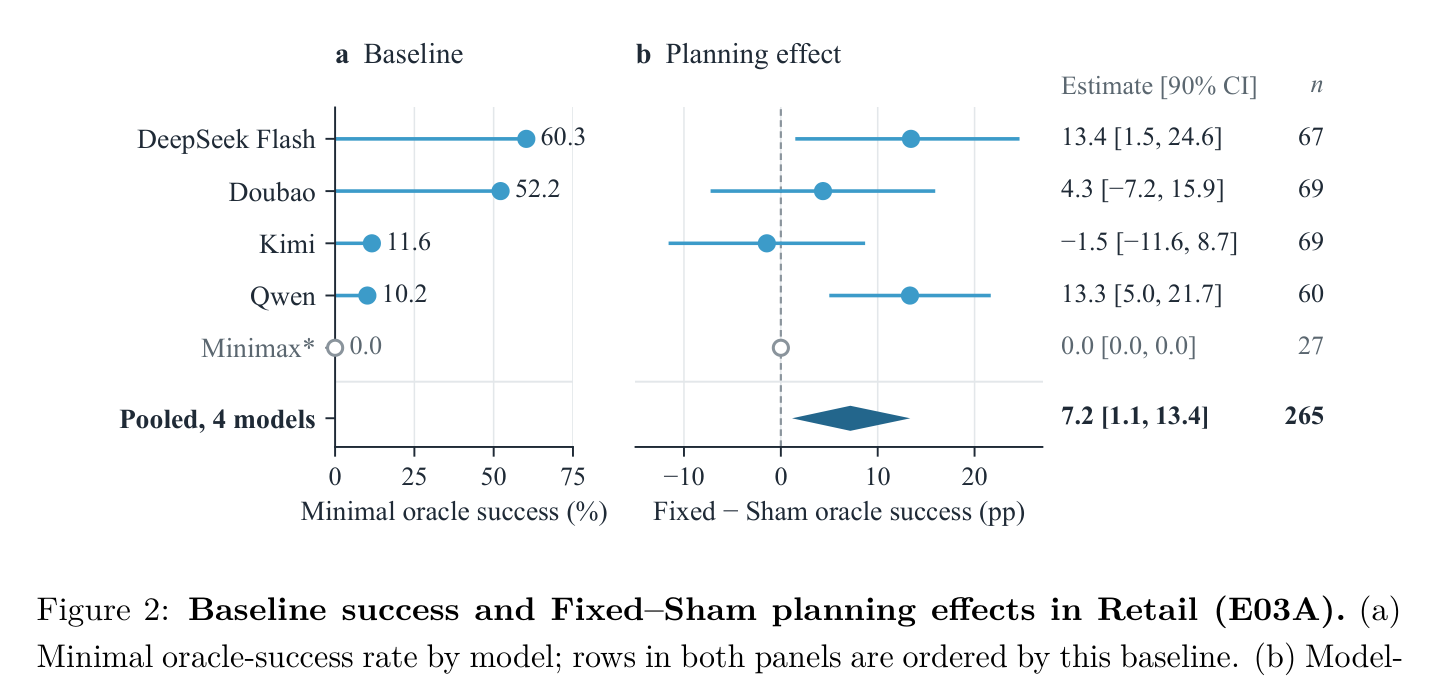 Figure 2: 모델별 Minimal 성공률과 Fixed−Sham 효과. DeepSeek Flash와 Qwen이 크고, Kimi는 0 근처다. (원문 Figure 2)
Self-planning(모델이 직접 계획 생성)은 Qwen에서 Sham 대비 +16.95pp지만 나머지는 음수였고, 계획 생성 호출 비용이 추가됩니다. 계획을 잘 쓰는 것과 계획을 잘 세우는 것은 다른 능력이구요.
완료 검증: 61% 거절, 17% 오탐, 1센트 미만
상태를 바꾸는 환경에서는 ‘완료했다’는 주장과 실제 정답이 갈립니다. 검증기가 없으면 잘못된 결과가 그대로 릴리스되죠.
Retail Verifier-only 229 에피소드 기준:
- oracle 기준 오답 137개 중 83개(61%) 거절
- 정답 92개 중 16개(17%)는 오탐으로 보류
- 검증기가 없었을 때 거짓 통과율 57.21% → 실제 20.96%, 36.24pp 제거
- 추가 비용은 에피소드당 1센트 미만
6개 모델의 매칭된 Verifier−Minimal 거짓 통과 대비는 전부 음수(감소)였습니다.
풀스택 대신 검증기 단독
공유 Retail 풀 기준으로 설정별 결과를 보면 방향이 명확해요.
| 설정 | 검증 성공 | 거짓 통과 | 평균 비용 |
|---|---|---|---|
| Minimal | 0.3787 | 0.5830 | $0.0136 |
| Planner Fixed | 0.4810 | 0.5021 | $0.0135 |
| Verifier-only | 0.4017 | 0.2096 | $0.0164 |
| Full Fixed | 0.3592 | 0.1831 | $0.0739 |
Verifier-only가 회피한 거짓 통과(48.4pp)는 Full Fixed(49.8pp)와 사실상 같은데 증분 비용은 1/12입니다. Full Fixed는 성공률도 낮아지고(0.3592) 비용은 최대예요. 검증·수리·메모리를 다 붙인다고 좋아지는 게 아니라는 결과구요.
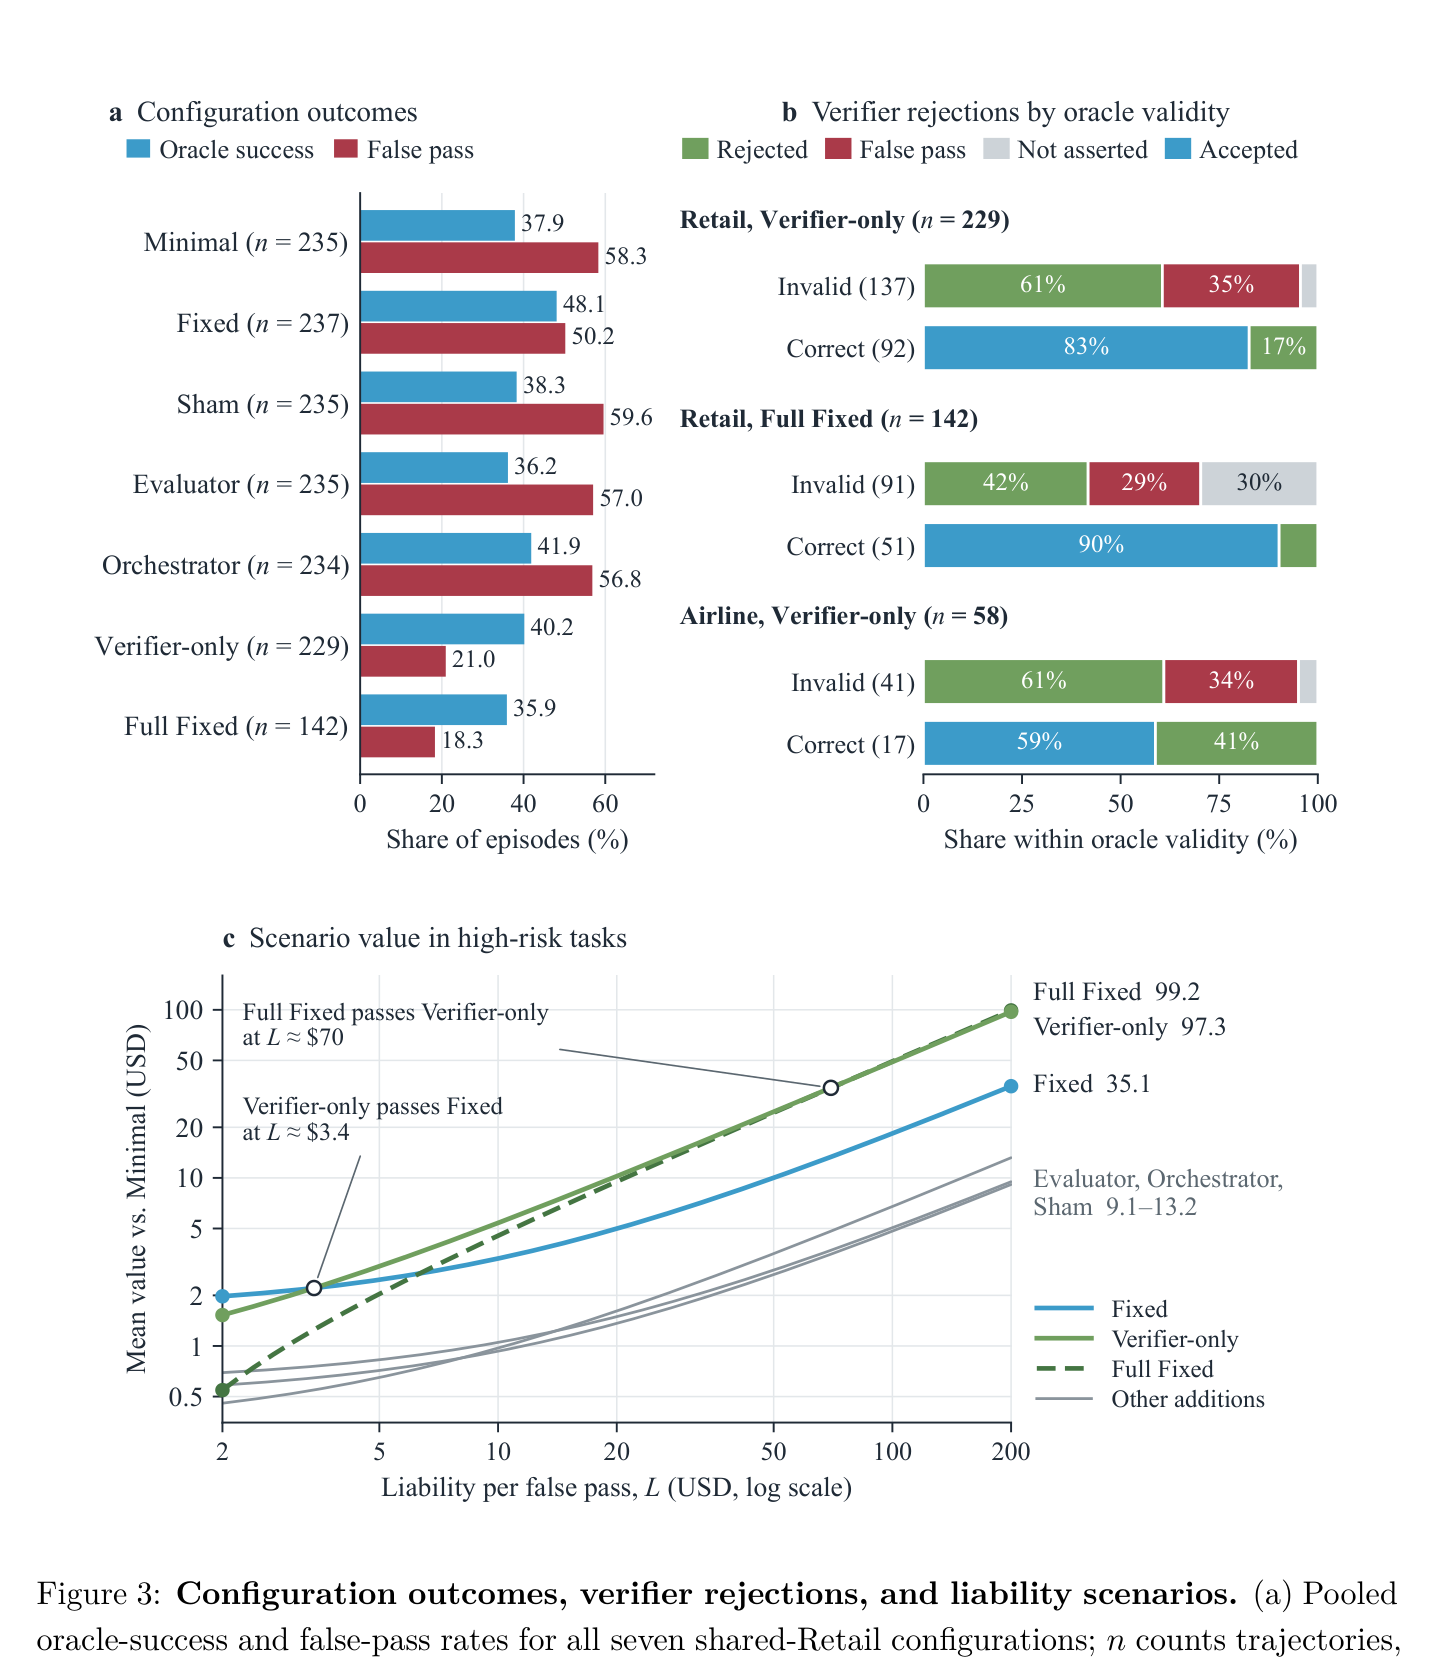 Figure 3: 설정별 결과, 검증기 거절 구성, 책임 시나리오 가치. (원문 Figure 3)
어느 쪽이 더 가치 있나: 책임(loss)에 따라 갈림
논문은 성공 가치 V, 거짓 통과당 손실 L, 비용 C를 결합한 시나리오 가치로 정리합니다.
- L이 낮으면(거짓 완료가 싸면): 계획 주입의 성공 게인이 우세
- L이 높으면(거짓 릴리스가 비싸면): 검증기의 회피 이득이 우세
- 책임이 큰 운영에서는 검증기 단독이 성공 게인을 포기하고도 총가치가 더 높을 수 있음
Airline 파일럿에서도 검증기는 오답 41개 중 25개(61%)를 거절해 방향이 일관됐습니다.
한계
저자가 직접 밝힌 한계도 적어둡니다.
- 단일 저자 3인, 사전등록(preregistration) 없음
- 검증기가 종료 대화만 읽음 — 이전 상태 변경(환불 등)은 못 봄
- τ²-bench 태스크가 학습 데이터에 노출됐을 가능성, 전이 검증 부족
- Sham은 단어 수만 통제, tokenizer 길이는 다를 수 있음
내 해석: 실무 적용 포인트
원문 근거와 구분해서 제 해석입니다.
하네스 설계에서 ‘다 넣기’는 답이 아닙니다. 이 논문 수치상 비용 대비 편익은 계획(고정 텍스트)과 검증기(읽기 전용)가 각각 깔끔하게 잡히고, 풀스택은 거짓 통과를 조금 더 깎는 대신 성공률과 비용에서 손해 봐요. 실무에서라면:
- 태스크별 체크리스트를 정적 텍스트로 시스템 컨텍스트에 넣기 (런타임 계획 호출 없이)
- 완료 판정은 별도 읽기 전용 검증 패스로 (DB까지 안 봐도 효과 있음)
- 오탐 17%는 감수하되, 거절 사례는 후속 분석에 쌓기
- 모델 교체 시 계획 반응이 뒤집힐 수 있으니(Qwen vs Kimi) 소규모 매칭 실험으로 재측정
더 실습해보고 싶은 분들께
자주 묻는 질문
에이전트 하네스에서 가장 비용 효율 좋은 컴포넌트는 뭔가요?
이 논문 기준으로는 읽기 전용 종료 검증기입니다. 풀스택 대비 회피한 거짓 통과는 사실상 같은데 증분 비용이 1/12였어요. 성공률 자체를 올리려면 사전 작성 계획 주입(+7.17pp)이 담당합니다.
계획을 프롬프트에 넣으면 무조건 도움이 되나요?
아니요. 모델별 편차가 커서 DeepSeek Flash와 Qwen은 +13pp급인데 Kimi는 0 근처였습니다. 단어 수만 맞춘 셔플 텍스트(Sham)는 효과가 없었으니, 내용이 실제 계획 정보일 때만 효과가 있습니다.
검증기가 정답인 에피소드도 거절하나요?
합니다. Retail에서 정답 92개 중 16개(17%)를 보류했어요. 거짓 통과 감소(36.24pp)가 오탐 손실보다 훨씬 크지만, 17%는 운영에 넣을 때 감안할 숫자입니다.
참고
- 논문: How Do Agent Harnesses Create Value? Planning Information and Release Control in Stateful LLM Agents (arXiv:2609.20474, 2026-09-17)
- 벤치마크: τ²-bench (ICML 2026)
- 관련 글: 하네스 핸드북: 에이전트 하네스 진화 정리, 에이전트 하네스 컨텍스트 권한 상승