결론 먼저
Microsoft가 EMNLP 2026 산업 트랙에 낸 RAFT(Retrieval-Augmented Framework for Troubleshooting Agents)는 인덱싱 단위를 바꾼 논문입니다. 닫힘 처리된 지원 케이스를 상태가 흐르는 타임라인으로 인덱싱한다는 것이 핵심 변경점입니다.
결과 수치입니다.
- 증상 보고만 있는 초기 단계(0% 진행)에서 Case Hit 84.2%, vanilla RAG는 67.3%, HippoRAG2는 65.0%
- 60% 진행 단계까지 모든 구간 최고 성능, 통계적으로 유의미한 우위
- 실제 Apache Jira 중복 이슈 30그룹에서도 +16.7 ~ +10.5%p 우위 유지
핵심은 이 문장 하나로 압축됩니다. 트러블슈팅은 단계가 있는 프로세스니까, 검색도 단계(상태) 단위로 한다.
핵심 요약 표
| 항목 | 내용 |
|---|---|
| 논문 | RAFT: A Stateful Retrieval-Augmented Framework for Troubleshooting Agents (arXiv:2609.20754) |
| 소속 | Microsoft |
| 학회 | EMNLP 2026 Industry Track |
| 제안 | 케이스를 타임라인 엔트리 체인으로 추출, 엔트리 단위 검색, 매칭 지점에서 부모 케이스 궤적 반환 |
| 합성 벤치마크 | Microsoft Learn Windows Server 문서 기반 826 케이스 |
| 실데이터 평가 | Apache Jira(Cassandra·Hadoop·HBase·Spark) 중복 이슈 30그룹 + 570 방해 케이스 |
| 핵심 지표 | Case Hit 0%: 84.2%(vs vanilla RAG 67.3%), 60%: 88.8% |
| 코드 | github.com/microsoft/RAFT |
기준일: 2026-09-18, arXiv v1 본문 수치 기준입니다.
기존 RAG가 지원 사례에서 흔들리는 네 지점
논문은 엔터프라이즈 고객지원 데이터의 문제를 네 개로 정리합니다.
-
노이즈. 원본 케이스에는 인사말, 행정 처리, 기술적으로 무관한 턴이 섞여 있고 신호는 여러 턴에 흩어져 있습니다. 원본을 그대로 청킹하면 유사 케이스 탐색 자체가 흔들립니다.
-
고립된 청크. 비슷한 케이스를 찾아도 조각난 청크로는 에이전트가 판단할 수 없습니다.
케이스 전체를 재조립하려면 토큰이 많이 들고, 회당 컨텍스트 상한 때문에 볼 수 있는 케이스 수도 줄어듭니다.
-
실행 불가 케이스. 고객 무응답이나 행정적 종료로 닫힌 티켓엔 진단 근거가 없습니다. 닫힘 사실과 유용성은 별개라서 걸러내야 합니다.
-
개인정보. 인덱싱 전에 추상화·비식별 계층이 필요합니다.
GraphRAG 계열이 이 중 일부를 완화합니다. 그래도 저자들의 진단은 이렇습니다. 엔티티 중심 그래프는 개별 조사가 진행되는 과정을 표현하지 못한다. 그래프 구축 비용은 들었는데 트러블슈팅 이력에는 맞지 않는 표현이 됩니다.
RAFT 구조: 케이스 궤적 + 케이스 그래프
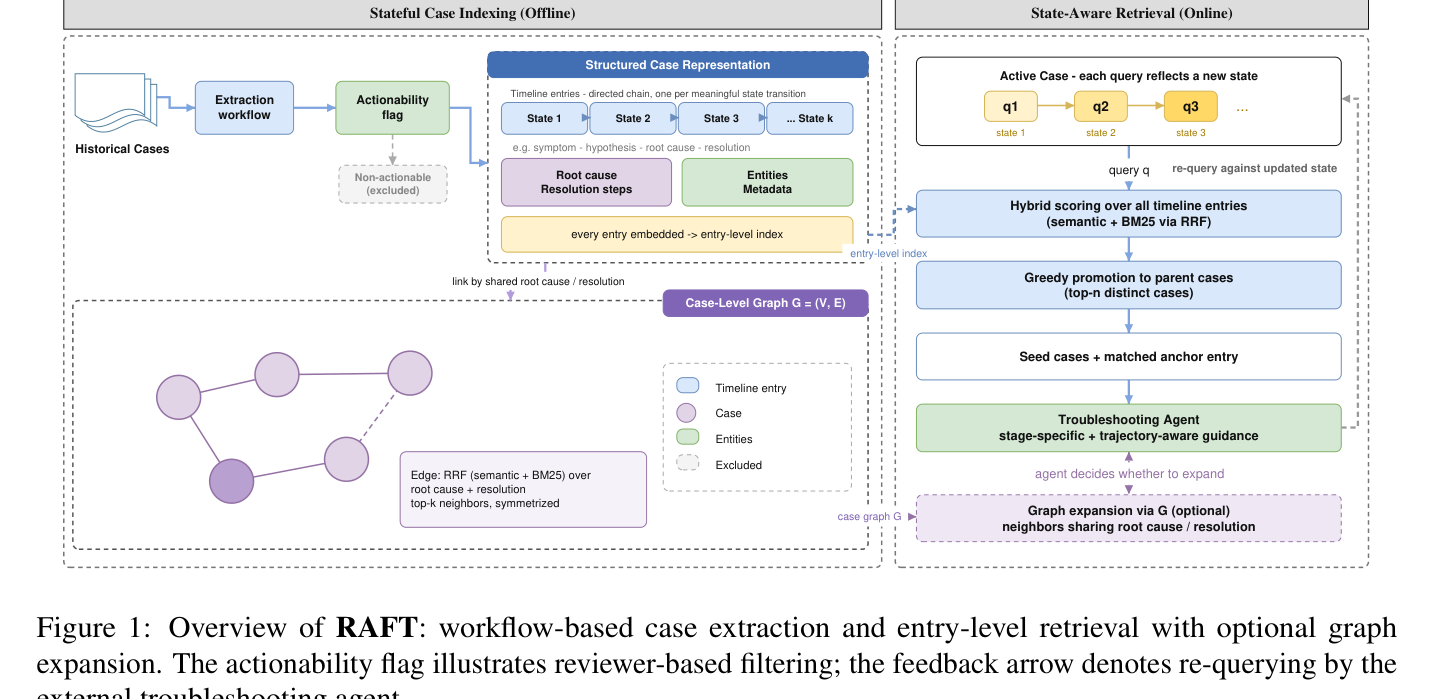
Figure 1. RAFT 개요 — 워크플로 기반 케이스 추출과 엔트리 레벨 검색, 선택적 그래프 확장. 논문 Figure 1.
케이스별 해결 궤적
각 닫힘 케이스를 이 구성요소로 뽑아냅니다.
- 리뷰어 평가(라벨, 실행 가능성 판정)
- 시간 순 타임라인 엔트리들
- 확정된 근본 원인
- 해결·완화 단계
- 관련 엔티티(에러 코드, 제품 등)
타임라인 분할 원칙은 하나입니다. 문제 프레이밍이나 현재 이해가 실질적으로 바뀌는 순간마다 새 엔트리가 시작된다. 가설 추가·폐기·확정, 원인 확정, 해결 제안이 그 전환점입니다. 인사말 같은 무의미한 업데이트는 현재 엔트리에 흡수됩니다. 그 결과 타임라인은 원본 턴 수보다 훨씬 짧아지고(K≪T), 모든 엔트리는 실행 가능한 정보를 담습니다.
케이스 그래프(선택)
근본 원인+해결 텍스트를 기준으로 케이스 간 유사도를 계산해 양방향 그래프를 만듭니다. 유사도는 시맨틱 임베딩과 BM25를 RRF로 합친 하이브리드입니다. 검색 시 초기 매칭에서 놓친 관련 케이스로 확장하는 용도입니다.
민감도 분석에서 그래프 확장을 빼도 Case Hit은 ±0.3%p 이내로 유지됐습니다. 저자들은 그래프를 “증거 다양화 메커니즘”으로만 소개합니다. 메인 게인은 엔트리 단위 검색에서 나옵니다.
검색 절차
- 현재 진행 중인 케이스의 상태를 쿼리로 만든다
- 모든 타임라인 엔트리에 대해 하이브리드 점수(시맨틱+BM25+RRF)로 랭킹한다
- 상위 엔트리를 부모 케이스로 승격시키며, 컨텍스트 예산(6000 토큰) 안에서 최대 5개 케이스를 고른다
- 매칭된 엔트리 지점에서 부모 케이스의 궤적 전체를 앵커와 함께 반환한다
4단계가 핵심입니다. 에이전트는 지금 상태와 비슷했던 과거의 중간 상태, 그리고 그 케이스가 이후 어떻게 풀렸는지를 함께 받습니다.
벤치마크 설계
공개된 멀티스테이지 트러블슈팅 데이터가 거의 없어서 저자들은 두 세트를 만들었습니다.
합성 개발 벤치마크는 Microsoft Learn Windows Server 문서 800여 개를 구조화 위키로 정리한 뒤, 근본 원인당 2~4개 지원 케이스를 생성해 총 826개를 만들었습니다. 평가 시엔 그룹당 1개를 테스트 쿼리로 홀드아웃하고 나머지를 인덱싱합니다.
실데이터 평가는 Apache Jira입니다. 기여자들이 워크플로에서 직접 단 중복(duplicate) 링크를 골드로 씁니다.
2,082개 원본 쌍에서 필터와 수작업 감사를 거쳐 30개 감사 그룹 + 570개 방해 케이스, 총 600개를 확정했습니다.
비교 대상은 vanilla RAG, HippoRAG2, Fast-GraphRAG입니다. 임베딩(text-embedding-3-large), 인덱싱 LLM(gpt-5.2), 토큰 상한(6000)을 동일하게 맞췄습니다. 메타데이터 필터링은 쓰지 않았고, 합성 코퍼스는 전체가 실행 가능 케이스라 RAFT의 필터링 이점도 배제했습니다. 공정성을 신경 쓴 설계입니다.
결과 수치
합성 벤치마크 Case Hit
| 진행도 | RAFT | Vanilla RAG | HippoRAG2 |
|---|---|---|---|
| 0%(증상만) | 84.2% | 67.3% | 65.0% |
| 60%(맥락 축적) | 88.8% | 논문 Table 2 참조 | Table 2 참조 |
5회 독립 실행 평균이고, vanilla RAG(최강 baseline) 대비 Case Hit 게인은 3개 구간 모두 루트코즈 그룹 클러스터 부트스트랩에서 통계적으로 유의미했습니다.
매칭 위치 분석이 이 프레임워크가 의도대로 작동한다는 증거입니다. 쿼리 진행도 0%일 때 매칭 엔트리 깊이는 평균 9.1%, 60%일 때는 54.0%입니다. 초기 쿼리는 증상끼리 맞물리고, 후기 쿼리는 중간 상태끼리 맞물린다는 뜻입니다.
Apache Jira 이전 평가
합성 실험의 프롬프트·스키마·모델·절차를 그대로 적용했습니다. Case Hit은 각 진행도에서 +16.7, +17.3, +10.5%p 우위입니다. 30그룹 규모라 신뢰구간 없는 “방향성 증거”라고 저자들이 스스로 못박은 점은 정확합니다.
에이전틱 설정과 비용
RAFT를 도구로 노출하고 에이전트가 직접 쿼리와 필터를 작성하게 하면 모든 진행도에서 Case Hit이 더 올라갑니다(논문 Table 9).
비용 구조도 명확합니다. RAFT는 인덱싱 시점에 LLM 증류 비용이 들지만, 검색 시점엔 압축된 케이스 표현을 재사용해 토큰을 아낍니다.
vanilla RAG는 인덱싱이 싼 대신 에이전트가 매 쿼리마다 긴 원본을 다시 읽게 됩니다. 추출 작업은 요약이라 작은 모델로도 가능한데, gpt-5.4-mini는 성능 저하가 작고 nano는 뚜렷하게 떨어졌습니다. 추출 품질이 어느 정도는 필요하다는 결론입니다.
한계와 내 해석
논문이 인정한 한계는 세 가지입니다.
- 메인 평가가 중간 규모 합성 데이터다. 실제 프로덕션 코퍼스는 케이스 수도 토큰 수도 훨씬 크다
- Jira 평가는 30그룹, 신뢰구간 없음
- 최종 진단 성공이나 엔지니어 생산성 같은 end-to-end 결과는 평가하지 않았다
내 해석을 덧붙입니다. 이 논문의 가치는 검색 정확도 그 자체보다 프로덕션 배포 없이 검색 레이어만 독립 평가한 설계에 가깝습니다. 하네스·모델이 바뀌어도 재현 비교가 가능한 프로토콜을 남겼다는 점이, 산업 트랙 논문으로는 드문 경우입니다.
더 실습해보고 싶은 분들께
지원 케이스처럼 단계가 있는 데이터에 RAG 에이전트를 붙이는 작업을 하고 있다면, 이 실험 세트가 재현 기준점이 됩니다.
자주 묻는 질문
- RAFT는 GraphRAG 대비 얼마나 앞서나요? 이 벤치마크에서는 모든 진행도에서 Case Hit이 앞섰습니다. 단, 그래프 확장을 빼도 성능 차이가 없었고 그래프는 옵션으로만 제안됩니다. 트러블슈팅 이력에 한정된 조건의 비교라는 점은 유의해야 합니다.
- 기존 RAG 시스템에 바로 적용할 수 있나요? 인덱싱 시점에 케이스를 타임라인으로 증류하는 LLM 워크플로가 선행되고 그 비용이 오프라인으로 발생합니다. 쿼리량이 적고 케이스가 소규모면 vanilla RAG가 더 쌀 수 있습니다.
- 증상 보고만 있는 첫 티켓에서도 유사 케이스를 찾나요? 찾습니다. 0% 진행(초기 증상만)에서 Case Hit 84.2%로, vanilla RAG(67.3%) 대비 16.9%p 높습니다. 초기 매칭은 과거 케이스의 개봉 엔트리(증상 기술)에 걸리는 구조입니다.
- 데이터와 코드는 공개되어 있나요? 네. 합성 벤치마크, 구현, Apache Jira 평가 세트가 github.com/microsoft/RAFT에 공개되어 있습니다.
출처
- 논문: arXiv:2609.20754 — A Stateful Retrieval-Augmented Framework for Troubleshooting Agents
- 코드/데이터: github.com/microsoft/RAFT
- 학회: EMNLP 2026 Industry Track
- 본문 수치는 2026-09-18 기준 arXiv v1입니다.