결론 먼저
모델 파라미터를 하나도 안 바꾸고, 라벨도 사람 감독도 없이, 에이전트가 새 환경을 스스로 탐색해서 메모리를 쌓게 만드는 방법입니다.
RSIAgent(arXiv:2609.15364, Aether AI·UCSD·UIC)는 curriculum-actor-verifier 3역할 멀티에이전트 루프로 환경 고유 지식을 메모리로 축적하고, 그 메모리를 얼려서 테스트에 재사용합니다.
결과부터 정리하면:
- OSWorld 2.0에서 partial score 71.97 → 78.98, Agents’ Last Exam에서 83.75 → 84.82
- GLM-5.3(actor) + Kimi-K3(verifier/curriculum) 조합이 GPT-6 Astra(72.60)보다 6.38포인트, Claude Opus 5보다 8.79포인트 앞서는 78.98을 기록
- 학습(training)이 전혀 없는 training-free 구조. 바뀌는 건 메모리뿐입니다
문제 상황
실무 에이전트는 프리트레인에 없던 소프트웨어 환경에 자주 떨어집니다. 사내 툴, 특정 버전의 CAD, 못 보던 웹 서비스 같은 곳이요. 기존 대응은 두 갈래입니다.
| 방식 | 동작 | 한계 |
|---|---|---|
| 추가 학습 | 환경 상호작용 데이터를 모아 파인튜닝 | 비용 큼. 사내/계속 바뀌는 환경엔 적용 어려움 |
| 컨텍스트 관리 | 성공 궤적을 저장해서 프롬프트에 넣음 | 단순 암기. 인과관계까지는 못 쌓음 |
이 논문의 출발 질문은 이겁니다. “행동-조건-결과 사이의 인과관계를 에이전트가 스스로 발견해서 재사용 가능한 메모리로 조직할 수 있는가?”
구조: 3역할 루프 + 넓고-깊게 탐색
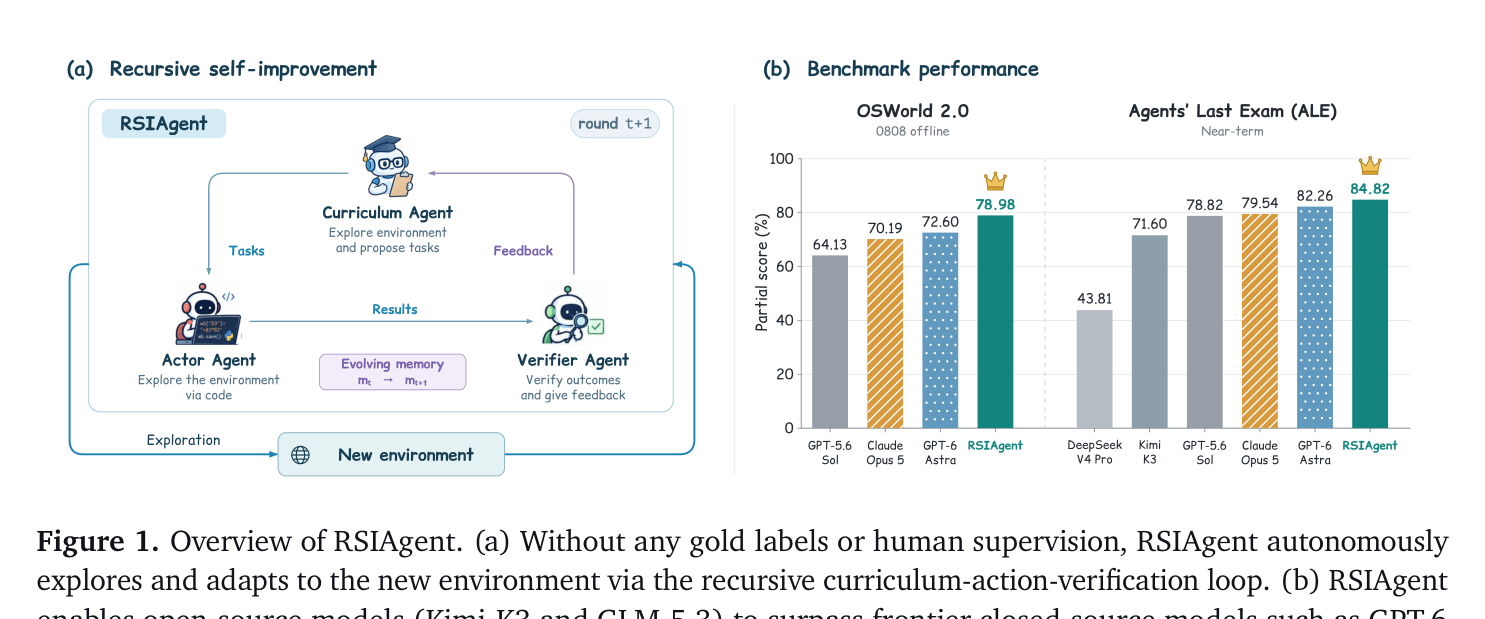 그림 1. 재귀 자기개선 루프와 벤치마크 결과. 출처: RSIAgent 논문(arXiv:2609.15364) Figure 1
역할 분담
- Actor: 환경을 이해하고 실행 가능한 액션을 생성. code-as-policy 방식으로 모든 액션을 실행 가능한 프로그램(예: FreeCAD Python API 호출)으로 만듭니다. 진화하는 메모리를 들고 다닙니다
- Verifier: 실행 결과를 환경 피드백(실행 결과, 인터페이스 상태)으로만 판정. actor의 사고 과정과 메모리에서 격리돼서 상관 오류를 줄입니다
- Curriculum: 지금 뭘 연습할지 결정. 축적된 메모리와 지난 탐색 결과를 보고 다음 과제를 냅니다
2단계 탐색
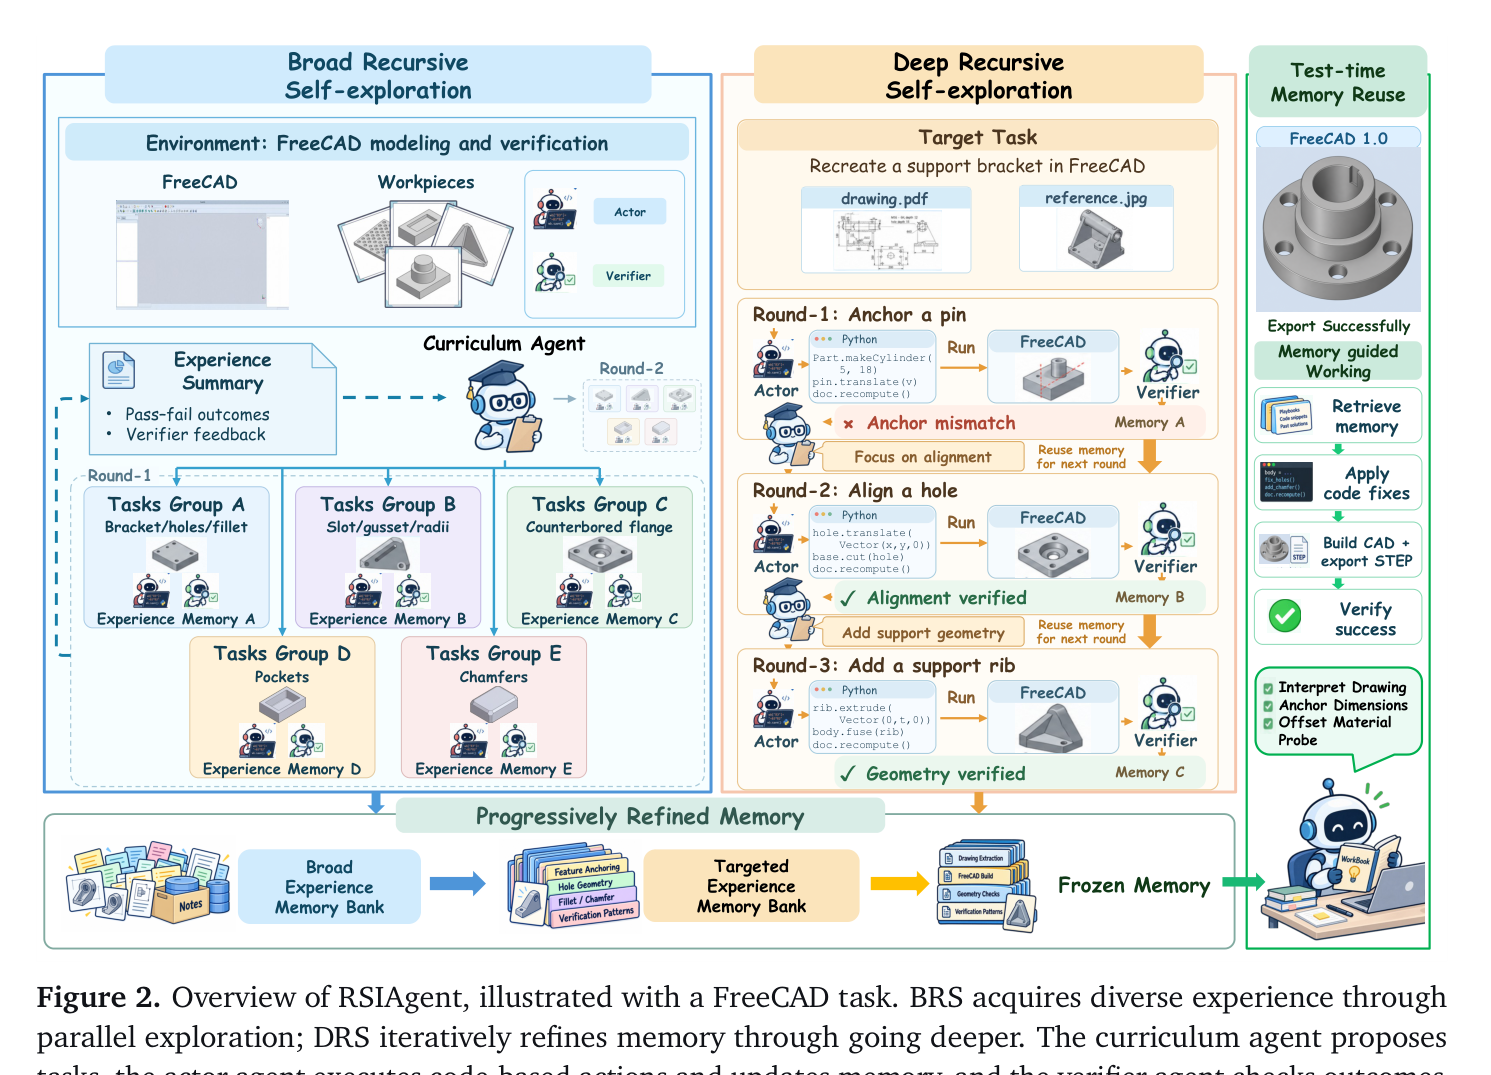 그림 2. FreeCAD 과제로 본 BRS-DRS-재사용 흐름. 출처: 동 논문 Figure 2
- BRS(Broad Recursive Self-exploration): 여러 방향의 과제를 병렬로 돌려서 환경 전체를 넓게 파악. 커리큘럼이 남은 지식 공백을 보고 다음 과제를 반복 생성합니다
- DRS(Deep Recursive Self-exploration): 중요한 공백, 숨은 제약, 경계 조건을 노리는 과제를 순차적으로 점점 어렵게. 저자들은 이 조합을 프리트레인-포스트트레인 패러다임에 비유합니다. 넓게 깔고 깊게 다듬는 구조라서요
탐색이 끝나면 메모리를 얼리고(freeze), 테스트 시엔 actor가 그 메모리를 그대로 재사용합니다. 커리큘럼과 메모리 업데이트는 꺼둡니다.
구성: 기본 actor는 GLM-5.3, verifier/curriculum은 Kimi-K3. BRS는 최대 8개 탐색 프로젝트, 동시 4개 병렬 예산이에요.
숫자로 보는 성능
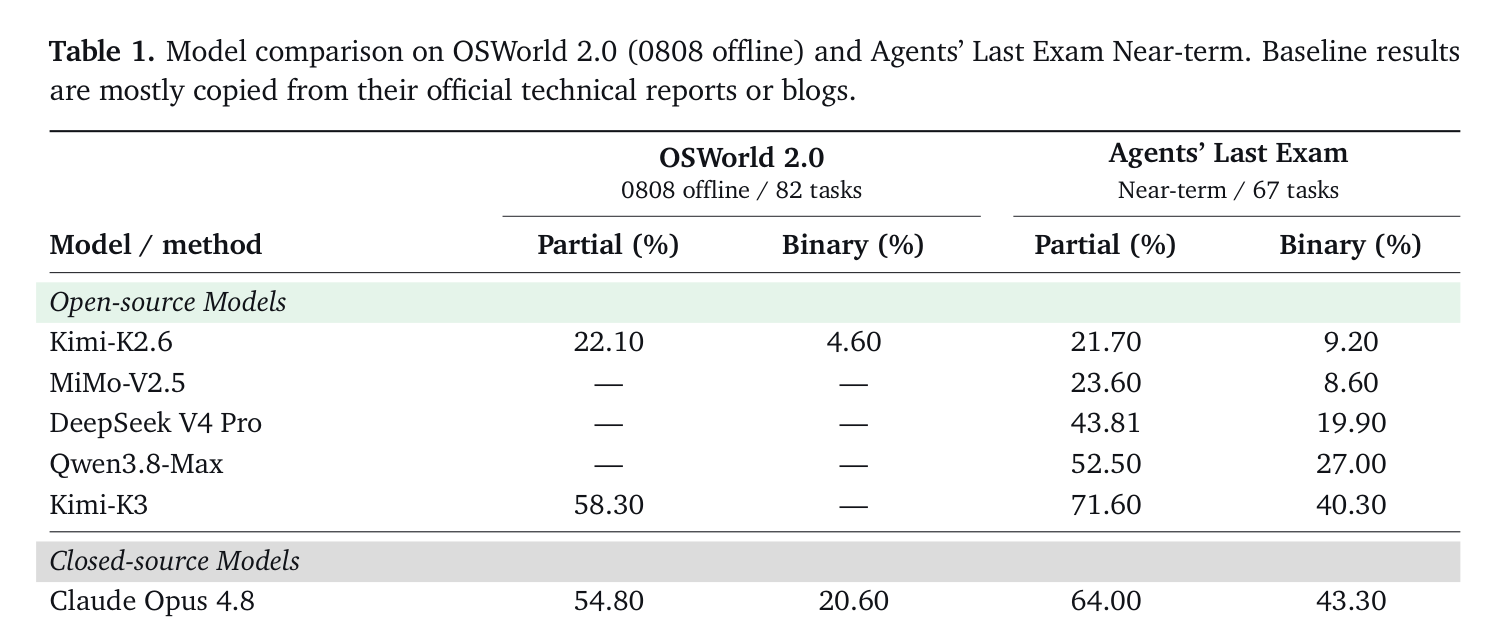 표 1. OSWorld 2.0(82 태스크)·ALE Near-term(67 태스크) 비교. 출처: 동 논문 Table 1
| 시스템 | OSWorld Partial | ALE Partial |
|---|---|---|
| Kimi-K3 단독 | 58.30 | 71.60 |
| Claude Opus 5 | 70.19 | 79.54 |
| GPT-5.6 Sol | 64.13 | 78.82 |
| GPT-6 Astra | 72.60 | 82.26 |
| RSIAgent (w/o RSI) | 71.97 | 83.75 |
| RSIAgent | 78.98 | 84.82 |
같은 하네스에서 RSI 루프만 켜고 끈 차이가 OSWorld +7.01, ALE +1.07입니다. 오픈소스 모델 조합이 클로즈드 프론티어를 역전한 게 핵심 결과구요.
RSI 라운드별 상승
OSWorld 태스크 3개(T044 영상편집, T049 프레젠테이션 수리, T065 철도 예약)를 스텝 0~8로 측정했더니 스텝 8까지 각각 100%, 80%, 100% 도달. 메모리가 태스크 핵심 요구를 덮는 순간 점수가 계단식으로 뛰는 패턴이 관찰됩니다.
Ablation: 넓게+깊게가 답
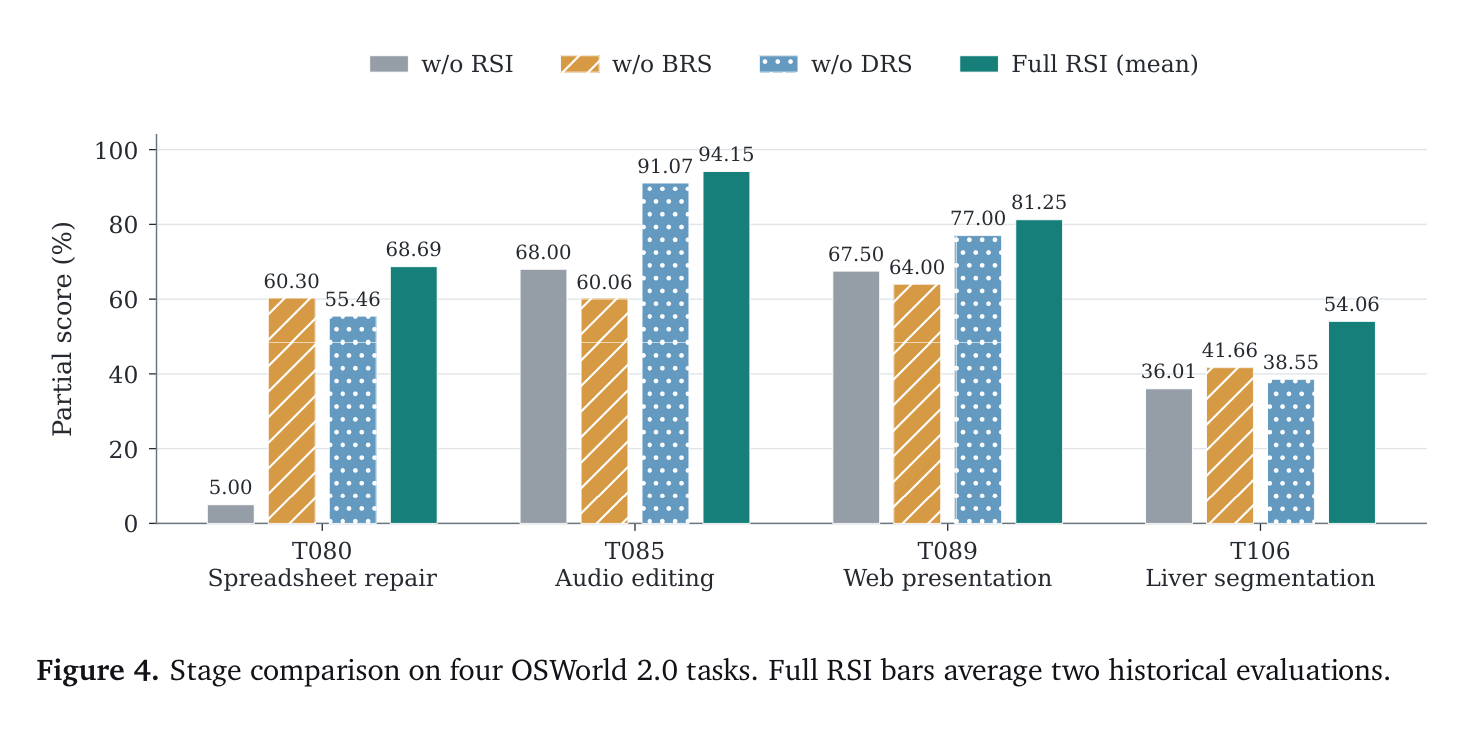 그림 4. 4개 태스크에서 BRS/DRS 조합 비교. 출처: 동 논문 Figure 4
4개 태스크 평균이 Full RSI 74.54% vs broad-only 65.52% vs deep-only 56.50%. deep-only는 T085, T089에선 베이스라인보다 아래로 떨어집니다. 빈 메모리에서 깊게만 파는 건 비효율이라는 거예요.
게임 환경 일반화
GameCraft-Bench 40개 태스크에서도 검증했습니다. Play2Code 베이스라인은 이미 좋은 게임을 오히려 악화시키는 경우가 있는데, RSIAgent는 약한 베이스든 강한 베이스든 일관되게 품질을 올립니다 (Kimi-K2.6 생성 게임 Overall 31.28 → 43.42).
실패 모드 분석 (솔직한 부분)
논문이 스스로 정리한 세 가지 한계입니다:
- 탐색이 과녁을 못 맞춤: 커리큘럼이 다양성만 늘리지, 타깃 취약점을 직접 건드리지 않으면 문제 있는 규칙이 메모리에 남습니다
- 불완전한 검증: verifier가 놓치면 잘못된 경험이 통과합니다
- 불안정한 메모리 통합: 한번 들어간 잘못된 조작이 관성적으로 후속 행동에 영향을 줍니다
셋이 겹치면 초기의 불확실한 지식이 그대로 굳어버리구요. RSI 계열 시스템의 실제 리스크 지점을 짚었다는 점에서 이 섹션의 가치가 큽니다.
내 해석: 남는 교훈
원문 근거와 제 해석을 나눠서 정리합니다.
- “파인튜닝 없이 메모리만으로 프론티어 역전”은 헤드라인이고, 실용적 교훈은 따로 있습니다. 검증 신호가 확실한 환경일수록 이 루프의 효율이 높아진다는 것. OSWorld류 환경은 실행 결과가 명확해서 verifier가 판정하기 좋은 조건이에요
- actor와 verifier를 다른 모델로 분리한 설계가 눈에 띕니다. 상관 오류를 줄이는 단순하면서 효과적인 트릭입니다
- 탐색 비용을 논문이 잘 안 보여주는 게 아쉽습니다. 8개 프로젝트 x 병렬 4개 예산이 실제로 얼마나 드는지, 환경마다 재탐색 비용이 얼마인지는 배포 관점에서 필수 정보인데 부록 레벨이에요
- 이 블로그에서 반복 다뤄온 자기개선/메모리 계열(MAPLE, ExecCritic 등)과 같은 방향입니다. 공통 분모는 “경험을 어떻게 검증된 채로 축적하나”이고, 이 논문의 답은 역할 분리 + 넓고-깊게 + 얼린 메모리 재사용입니다
더 실습해보고 싶은 분들께
자주 묻는 질문
모델 학습이 정말 없나요? 네. 파라미터 업데이트가 전혀 없습니다. 바뀌는 건 메모리(환경 지식, 재사용 스크립트, 실패 교훈)뿐이고, 탐색이 끝나면 그 메모리를 얼려서 테스트에 그대로 씁니다. training-free 적응입니다.
어떤 모델 조합인가요? (2026-09-18 기준) actor는 GLM-5.3, verifier와 curriculum은 Kimi-K3입니다. 둘 다 오픈소스 모델이고, 이 조합이 OSWorld 2.0 partial 78.98로 GPT-6 Astra(72.60)를 앞섭니다.
BRS와 DRS 중 뭐가 더 중요한가요? 같이 써야 합니다. ablation에서 broad-only 65.52%, deep-only 56.50%, Full RSI 74.54%입니다. 깊게만 파면 빈 메모리에서 시작해서 베이스라인보다 못해지는 태스크도 생깁니다.
기존 컨텍스트 관리 방식과 뭐가 다른가요? 성공 궤적을 통째로 저장하는 게 아니라, 행동-조건-결과의 인과관계를 발견해서 재사용 가능한 구조로 조직합니다. 그리고 verifier가 환경 피드백으로 근거를 확인한 경험만 메모리에 들어갑니다.
실패는 언제 생기나요? 논문이 정리한 세 실패 모드는 탐색 비과녁, 불완전 검증, 불안정한 메모리 통합입니다. 잘못된 규칙이 한번 메모리에 들어가면 후속 탐색에도 영향을 주는 게 가장 아픈 지점이에요.
출처
- 논문: RSIAgent: Autonomous Exploration for Recursive Self-improvement in New Environments (arXiv:2609.15364)
- 코드: github.com/AetherLabsAI/RSIAgent
- 웹사이트: aetherlabsai.github.io/RSIAgent
- 저자: Sibo Zhu, Shicheng Fan, Xinyue Wang, Wenyi Wu, Kun Zhou, Biwei Huang (Aether AI, UCSD, UIC)
- 평가 벤치마크: OSWorld 2.0 (0808 offline, 82 태스크), Agents’ Last Exam Near-term (67 태스크), GameCraft-Bench (40 태스크 샘플)