결론 먼저
ERPBench(arXiv:2609.17885, Accenture) 정리했습니다. 컴퓨터 사용 에이전트(CUA)를 실제 운영 가능한 오픈소스 ERP(ERPNext)에 스크린샷만 보고 조작하게 하고, 채점은 최종 DB 필드 값으로 하는 벤치마크입니다.
핵심은 이겁니다.
- Claude Sonnet 4.6은 T1 94%, T2/T3 100%로 인간 기준선에 근접.
- 오픈 모델 최고(Holo3-35B, Qwen3-VL-32B)도 T1 34%/32%고 T2/T3는 0~3%.
- UI-TARS-7B는 95% 확률로 목표 레코드까지 찾아가고 68%는 저장까지 누르는데, DB에 옳은 값이 남는 건 9%뿐입니다.
화면 조작 능력이 엔터프라이즈 신뢰성까지 보장해주지는 않구요, 스크린샷 비교로는 잡히지 않는 “조용한 실패(silent failure)“가 실제로 존재합니다.
핵심 수치 표
기준일: 2026-09-18, 논문 v1(2026-09-15 제출) 기준.
| 항목 | 값 |
|---|---|
| 과제 수 | 30과제(모델당 150 runs, 5회 반복) |
| 환경 | ERPNext 셀프호스팅, 스크린샷 1280×720만 입력 |
| 난이도 티어 | T1 단일 필드 / T2 6–9개 필드 / T3 2–4개 문서 체인 |
| 채점 | DB 필드 값(Frappe REST API로 검증) |
| 최고 성공률(폐쇄) | Claude 94/100/100% |
| 최고 성공률(오픈) | Holo3-35B 34/0/3% |
| 인간 기준선 | 전문가 99–100%, 첫 사용자 87–96% |
| 논문 | arXiv:2609.17885 |
기존 벤치마크로 안 잡히는 이유
OSWorld, WebArena 같은 일반 GUI 벤치마크도 실행 기반 검증을 하긴 하는데, 대상이 소비자 앱이구요. 엔터프라이즈 쪽 벤치마크는 ServiceNow, Salesforce 같은 독점 플랫폼이거나 시뮬레이션 앱이라 재현이 어렵습니다.
ERP는 실패의 성격이 다릅니다. 화면에서 성공 확인이 떴는데 DB에는 값이 안 들어가거나 예전 값이 그대로 남을 수 있어요. 이 오류는 화면 어디에도 안 나타나고, downstream 재무/재고 프로세스로 그대로 전파됩니다.
ERPBench의 접근은 단순합니다. 검증을 화면 대신 DB에서 하면 됩니다. 각 태스크는 YAML로 프롬프트, 시작 URL, 사전 시드 fixture, 기대 필드 값을 정의하고, Frappe REST API로 UUID 붙은 레코드를 심은 뒤 실행합니다. 채점은 실행 후 DB의 필드 값을 기대값과 비교하구요. 숫자는 허용 오차 0.01, 불린 동치(1/True, Yes/True), 문자열은 HTML/공백 정규화 후 비교입니다.
스테이지별 채점으로 실패 지점 찾기
전체 성공/실패 대신 4단계로 쪼개서 어디서 무너지는지 봅니다.
| 단계 | 의미 |
|---|---|
| Navigation | 대상 레코드/필드 도달 |
| Interaction | 옳은 값 입력(T1 기준) |
| Commit | save/submit 호출 |
| Database | DB 필드가 기대값과 일치 |
오픈 모델은 Navigation을 90–95% 통과합니다. 문제는 그 다음이에요. Interaction 0–53%, Database 0–34%로 떨어집니다. 화면까지는 잘 가는데 값을 넣고 저장하는 단계에서 무너지는 거죠.
UI-TARS-7B가 극단적인 사례입니다. 목표 도달 95%, save 발동 68%인데 DB 정답률 9%. 저장을 눌렀는데 거의 다 잘못된 값이 들어간 겁니다. T2에서는 커밋 85%인데 DB 정답 3%까지 갑니다.
실패 분류 5가지
실패한 T1 실행을 다섯 모드로 분류했습니다(Fig. 3).
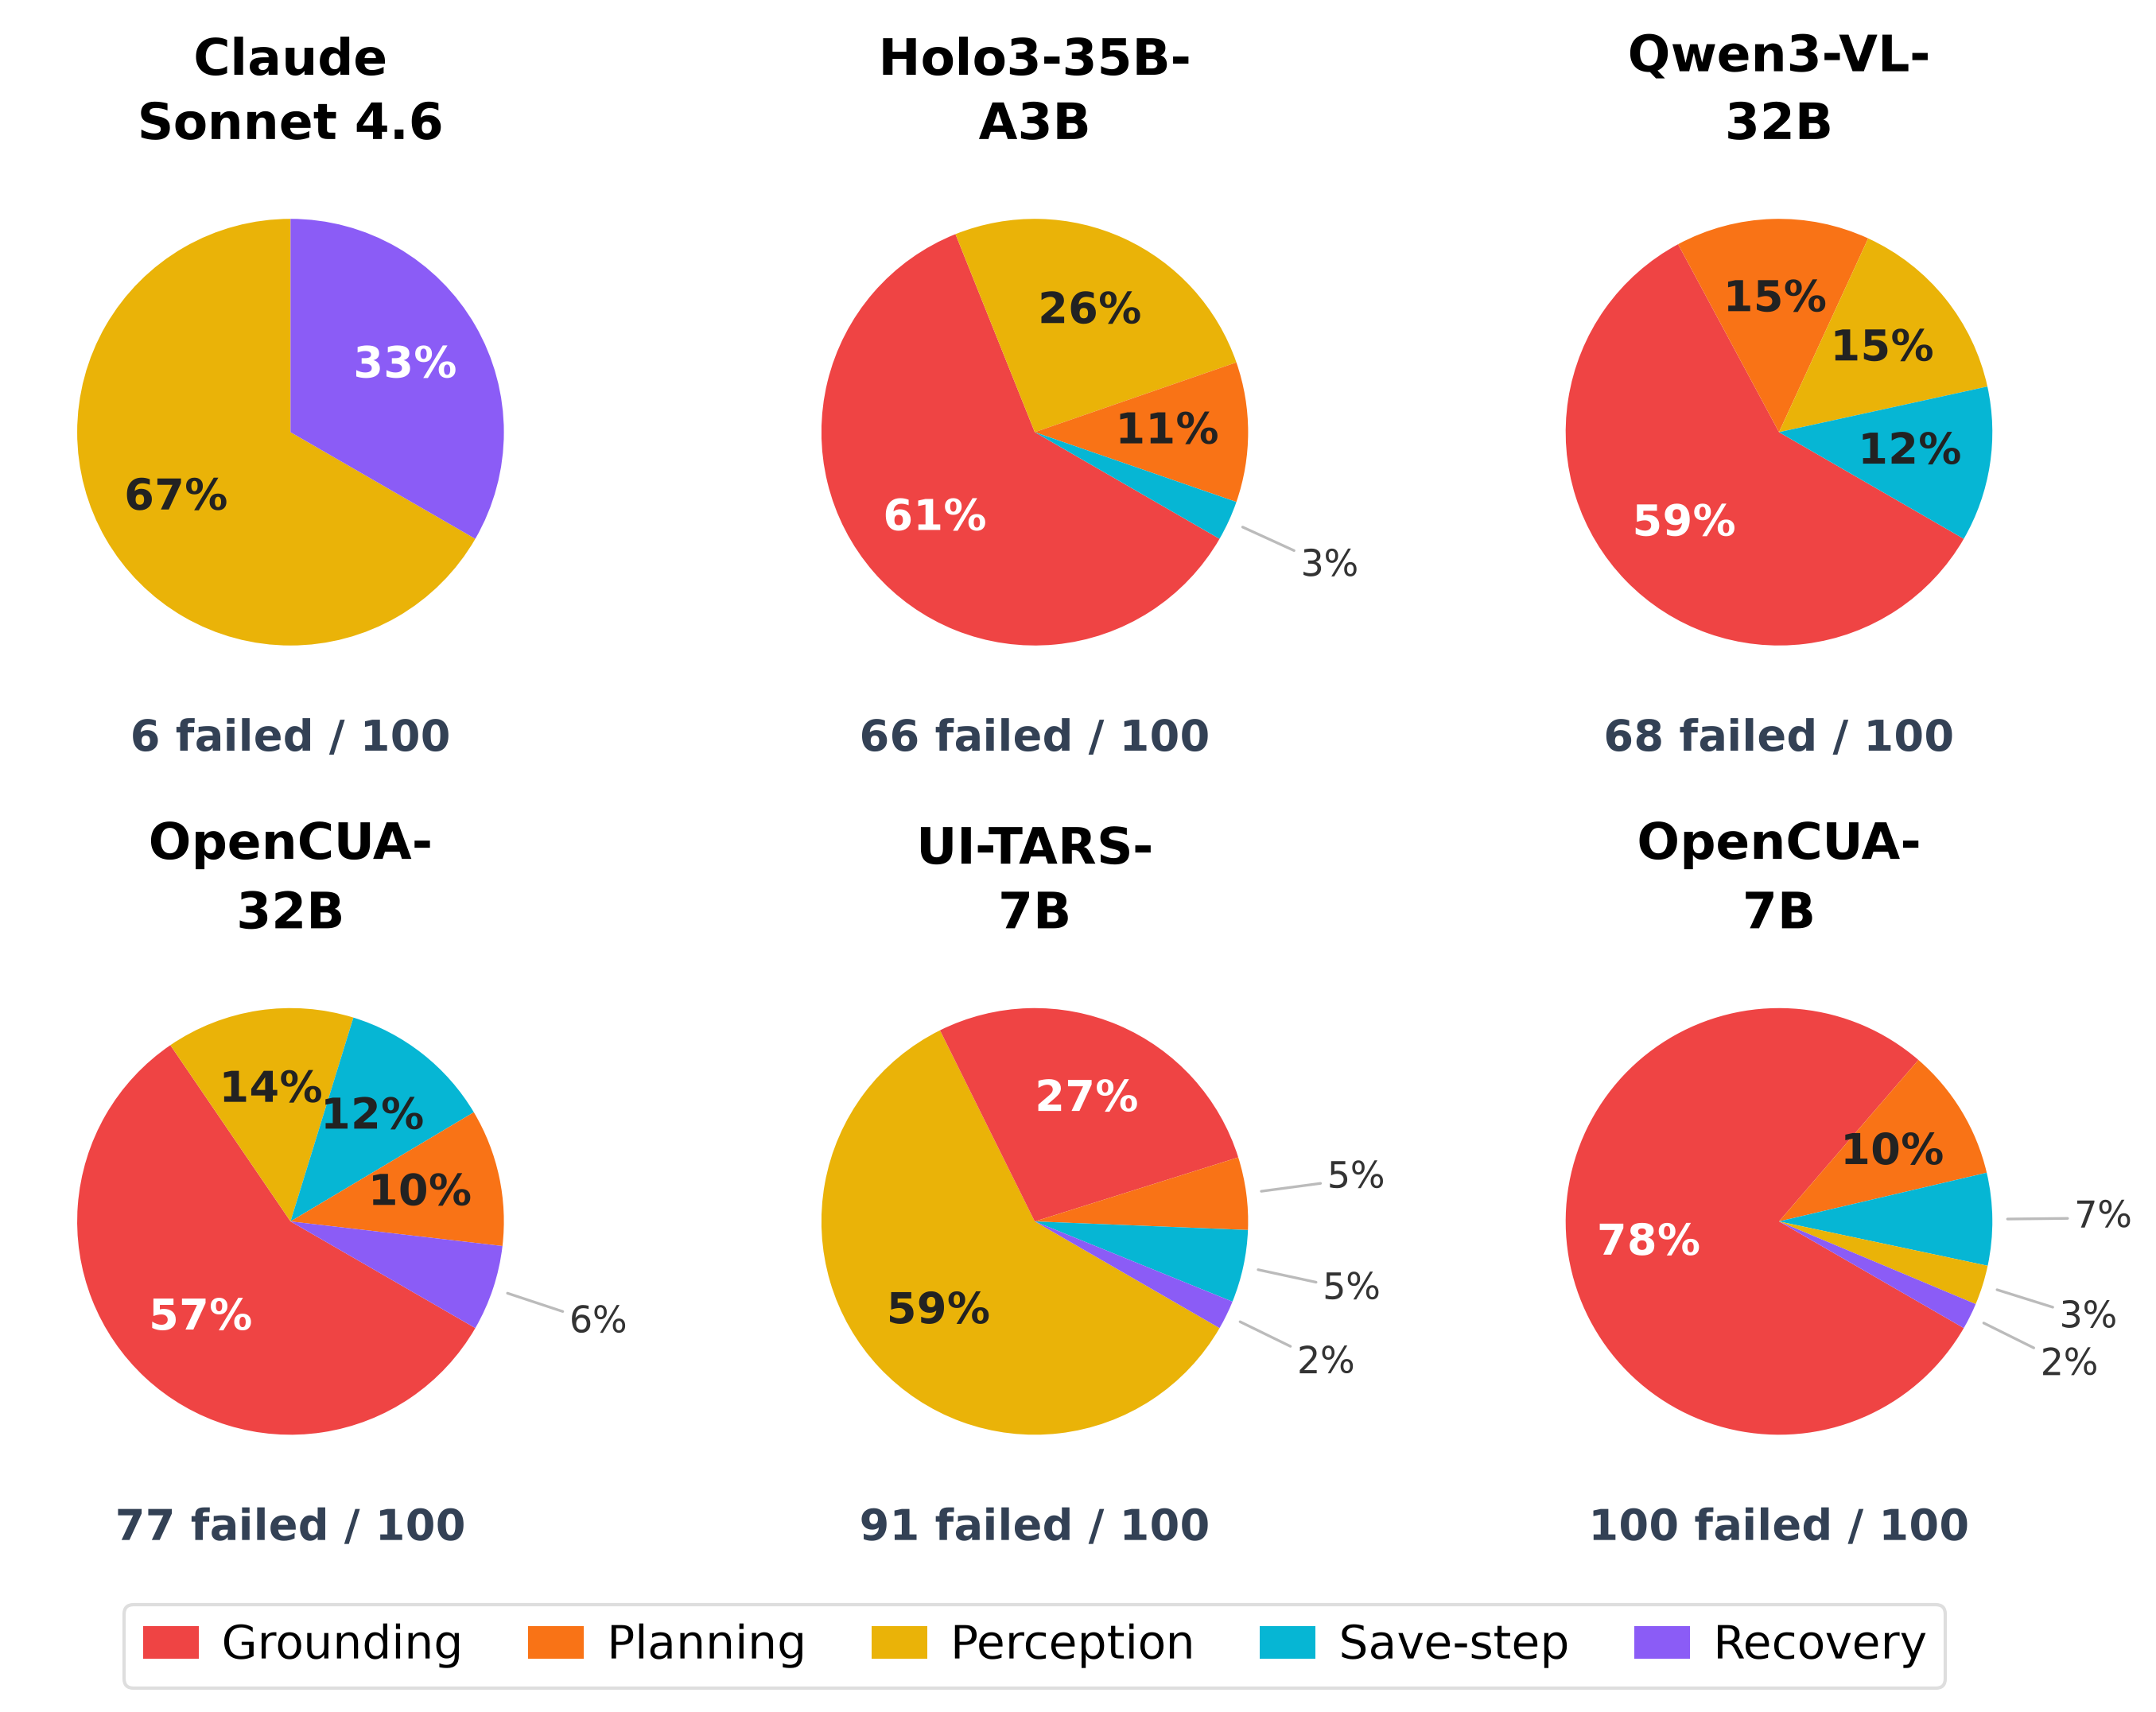
- Planning: 대상 레코드에 도달 못 함
- Grounding: 도달했는데 엉뚱한 요소 클릭
- Save-step: 값은 맞게 넣었는데 save를 안 누름
- Perception: save는 했는데 DB에 잘못된 값 기록(조용한 실패)
- Recovery: 루프에 갇히거나 턴 예산 소진
오픈 모델 실패는 Navigation 이후에 몰려 있습니다. Qwen3-VL-32B는 Grounding 59%, UI-TARS-7B는 Perception 59% + Grounding 27%. Save-step과 Perception, 이 두 모드가 DB 레벨 채점이 필요한 이유입니다. 화면에서 저장이 성공으로 보여도 DB에는 반영이 안 될 수 있어서요.
인간 기준선이 말해주는 것
어노테이터 3명이 같은 ERPNext, 같은 DB 채점기로 전 과제를 수행했습니다. ERPNext 경험자 2명, 첫 사용자 1명.
전문가는 T1 99–100%, T2 95%, T3 97–100%. 첫 사용자도 96/90/87%입니다. 첫 사용자조차 모든 오픈 모델을 크게 앞섭니다. 이 격차는 에이전트 실행 능력의 문제입니다. 도메인 지식 부족 탓으로 돌릴 수 없는 수준이에요.
하네스 구조
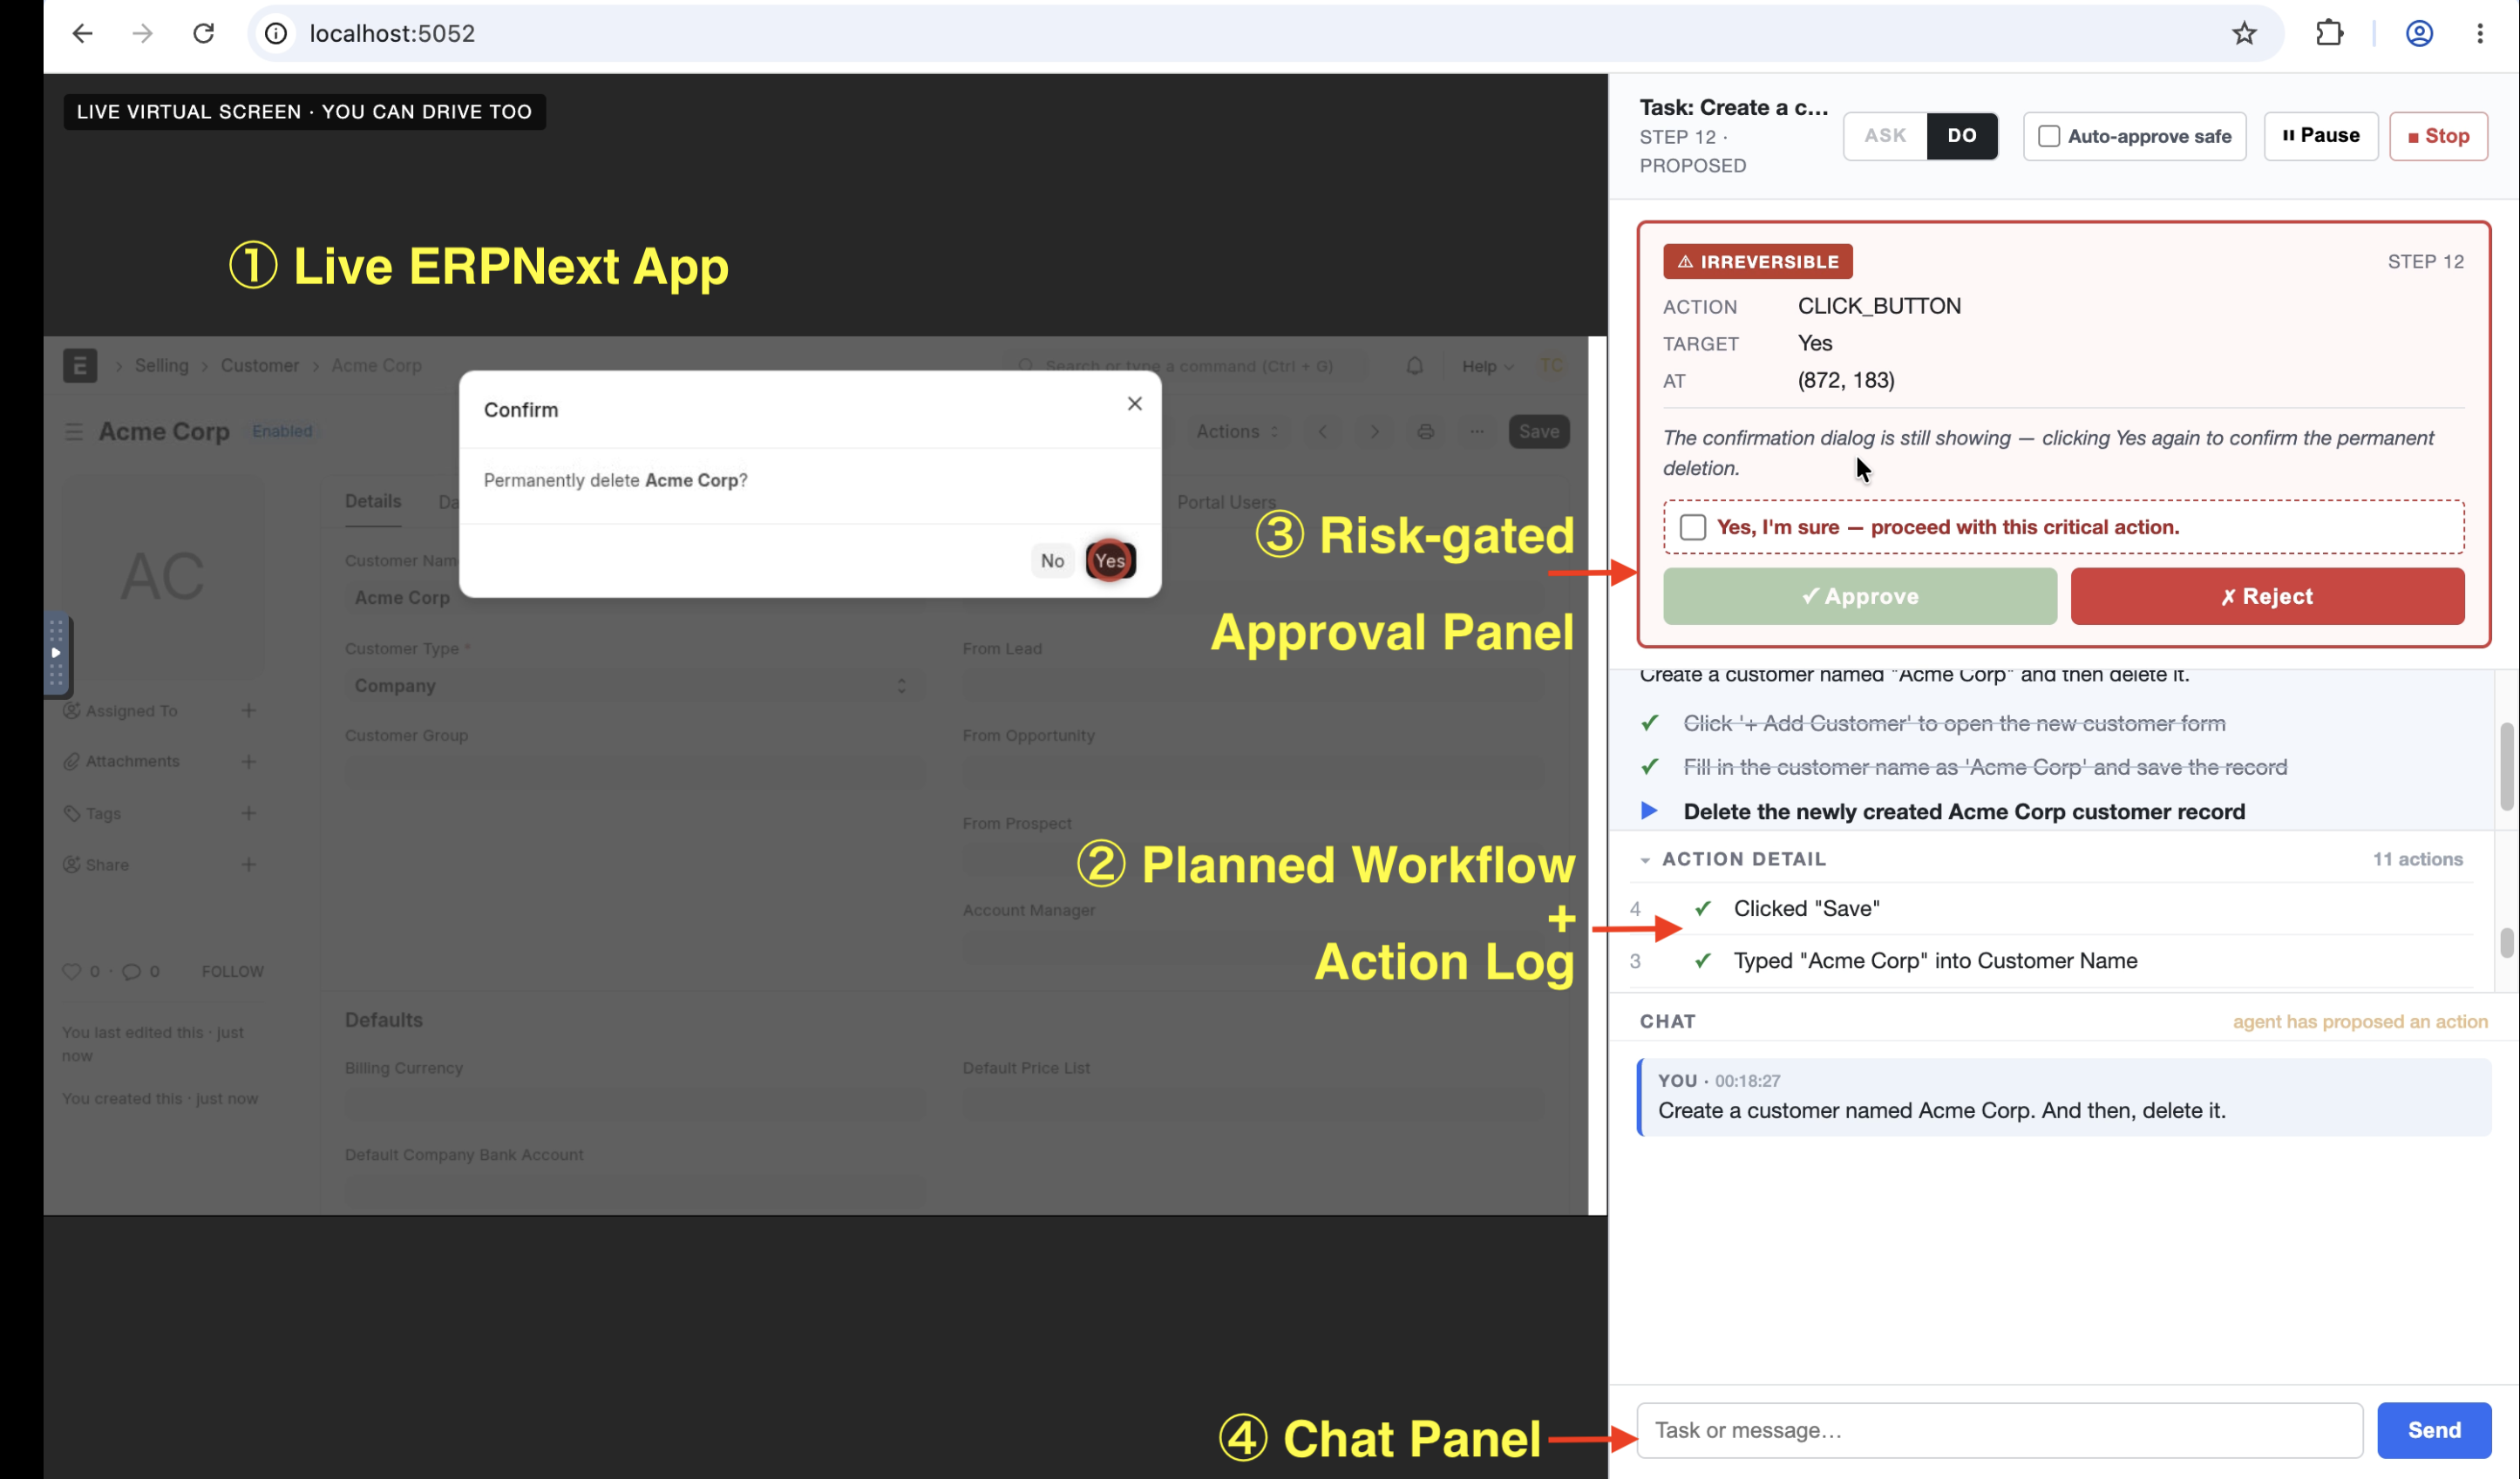
논문은 벤치마크와 함께 프로덕션급 하네스도 공개합니다. 각 턴마다 에이전트가 액션 + 좌표 + 이유 + 리스크 등급(safe/commit/irreversible)을 제안하면, 배포 모드에서는 사람이 승인해야 실행되고 commit/irreversible 액션은 항상 명시적 확인이 필요합니다. 평가 모드에서는 auto-approver가 전부 승인해서 무인으로 돌립니다.
비용 쪽도 짚을 게 하나 있습니다. Claude는 T3에서 런당 입력 토큰이 약 2.0M까지 늘어납니다(T1 231K). 오픈 모델의 낮은 토큰 사용은 효율 덕분이 아니라 조기 루프 탈출 때문이구요. OpenCUA-7B는 T1에서 평균 1.6 액션으로 사실상 포기하는 그림입니다.
내 해석
원문 근거와 구분해서 제 해석을 적습니다.
- 이 결과는 컴퓨터 사용 에이전트 도입 검토 시 스크린샷/트레이스 기반 QA로는 부족하다는 직접적인 증거입니다. 검증을 상태(DB)에서 해야 하구요, 하네스 리스크 게이팅은 필수입니다.
- T3 블랭크 스타트(시작 URL 없음)에서 OpenCUA-32B 체인 완성도가 22%→9%로 떨어지는 걸 보면, 실무에서 “에이전트에게 URL까지 주는가”는 성능에 실제로 영향을 주는 설계 변수입니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
Q. ERPBench가 기존 GUI 벤치마크와 다른 점은 뭔가요?
스크린샷만 입력으로 주고(접근성 트리/DOM 없음), 실제 셀프호스팅 ERP에서 돌리고, 최종 DB 필드 값으로 채점합니다. 오픈/재현 가능한 구성이라는 점도 기존 엔터프라이즈 벤치마크와 구분됩니다.
Q. “조용한 실패”가 왜 위험한가요?
화면에 성공으로 보이는데 DB에 값이 안 들어가거나 틀리게 들어간 상태입니다. UI 검증으로는 잡을 수 없고, 잘못된 레코드가 재무·재고 같은 downstream 프로세스로 그대로 전파됩니다.
Q. 오픈 모델은 왜 이렇게 낮은가요?
Navigation은 잘 통과하는데 Interaction/Commit/DB 단계에서 무너집니다. 정확한 텍스트 입력이 드롭다운 선택보다 더 어렵고(22–47% vs 31–54%), 턴이 길어지면 조기 종료하는 패턴도 겹칩니다.
Q. Claude는 그럼 바로 쓸 수 있나요?
이 벤치마크 안에서는 인간급이지만, T3 런당 입력 토큰 약 2.0M라는 비용이 붙습니다. 그리고 논문 자체가 배포 시 사람 승인 게이팅을 전제로 하는 하네스를 함께 제공한다는 점을 봐야 합니다.