결론 먼저
코딩 에이전트 하네스는 통째로 바꾸는 게 아니라 부품별로 따져야 합니다. 같은 실행 루프에서 컨텍스트 관리, 플래닝, 액션 공간(도구 세트 vs bash-only)만 바꿔가며 176개 설정을 비교한 논문이 나왔습니다. 결과는 세 줄로 요약됩니다.
- 컨텍스트 관리는 창 예산이 빡빡할수록 가치가 커지고, 그 효과의 대부분은 오버플로 실패 방지에서 나옵니다.
- 플래닝은 약한 모델에겐 정확도 지지대, 강한 모델에겐 비용 절감 수단으로 역할이 바뀝니다.
- 미리 정의된 도구 세트는 bash가 약한 모델을 살리고, bash가 강한 모델에선 오히려 오버헤드가 됩니다.
논문은 UMass Amherst·Emory 등 공동 팀의 “An Empirical Study of Harness Design for Coding Agents”(2026-09-17, arXiv:2609.20804)입니다.
핵심 정보 표
| 항목 | 내용 |
|---|---|
| 논문 | An Empirical Study of Harness Design for Coding Agents |
| arXiv | 2609.20804 (2026-09-17) |
| 실험 설계 | 실행 루프 고정, 컴포넌트 3종(컨텍스트 관리·플래닝·액션 공간)만 교체 |
| 설정 수 | 176개 매칭 설정 (모델 4 × 벤치마크 2 × 22 설정) |
| 모델 | Nemotron-3 30B/120B/550B, Mistral-Medium-3.5-128B |
| 벤치마크 | SWE-Bench Verified(500 태스크), Terminal-Bench 2.1(89 태스크) |
| 컨텍스트 예산 | 32k/64k/96k/128k 4단계 |
| 통계 | 쌍체 exact McNemar 검정 + Benjamini–Hochberg 보정(q<0.05) |
| 기준일 | 2026-09-18 기준, 원문 수치 인용 |
실험 설계
기존 하네스 연구는 Claude Code, OpenHands 같은 시스템을 통째로 벤치마크에 올려서 비교합니다. 그러면 모델 능력과 하네스 설계가 섞여서 어떤 부품이 성적을 만들었는지 알 수가 없습니다.
이 논문은 접근을 달리했습니다. 경량 하네스 하나를 만들고 실행 루프는 고정한 채 세 컴포넌트만 갈아끼웁니다.
- 컨텍스트 관리 5단계(T0 무관리 ~ T4 전체), 창 예산 4단계
- 플래닝 on/off
- 전체 도구 세트 vs bash-only
여기에 모델 4종, 벤치마크 2개를 곱하면 176개 설정이 됩니다. 같은 태스크끼리 쌍을 묶어 McNemar 검정으로 유의성을 따졌구요. 하네스는 LangGraph 기반으로 구현했고 모델은 OpenRouter로 호출했습니다.
컨텍스트 관리 결과: 창 예산 32k에서 격차 35.7pp
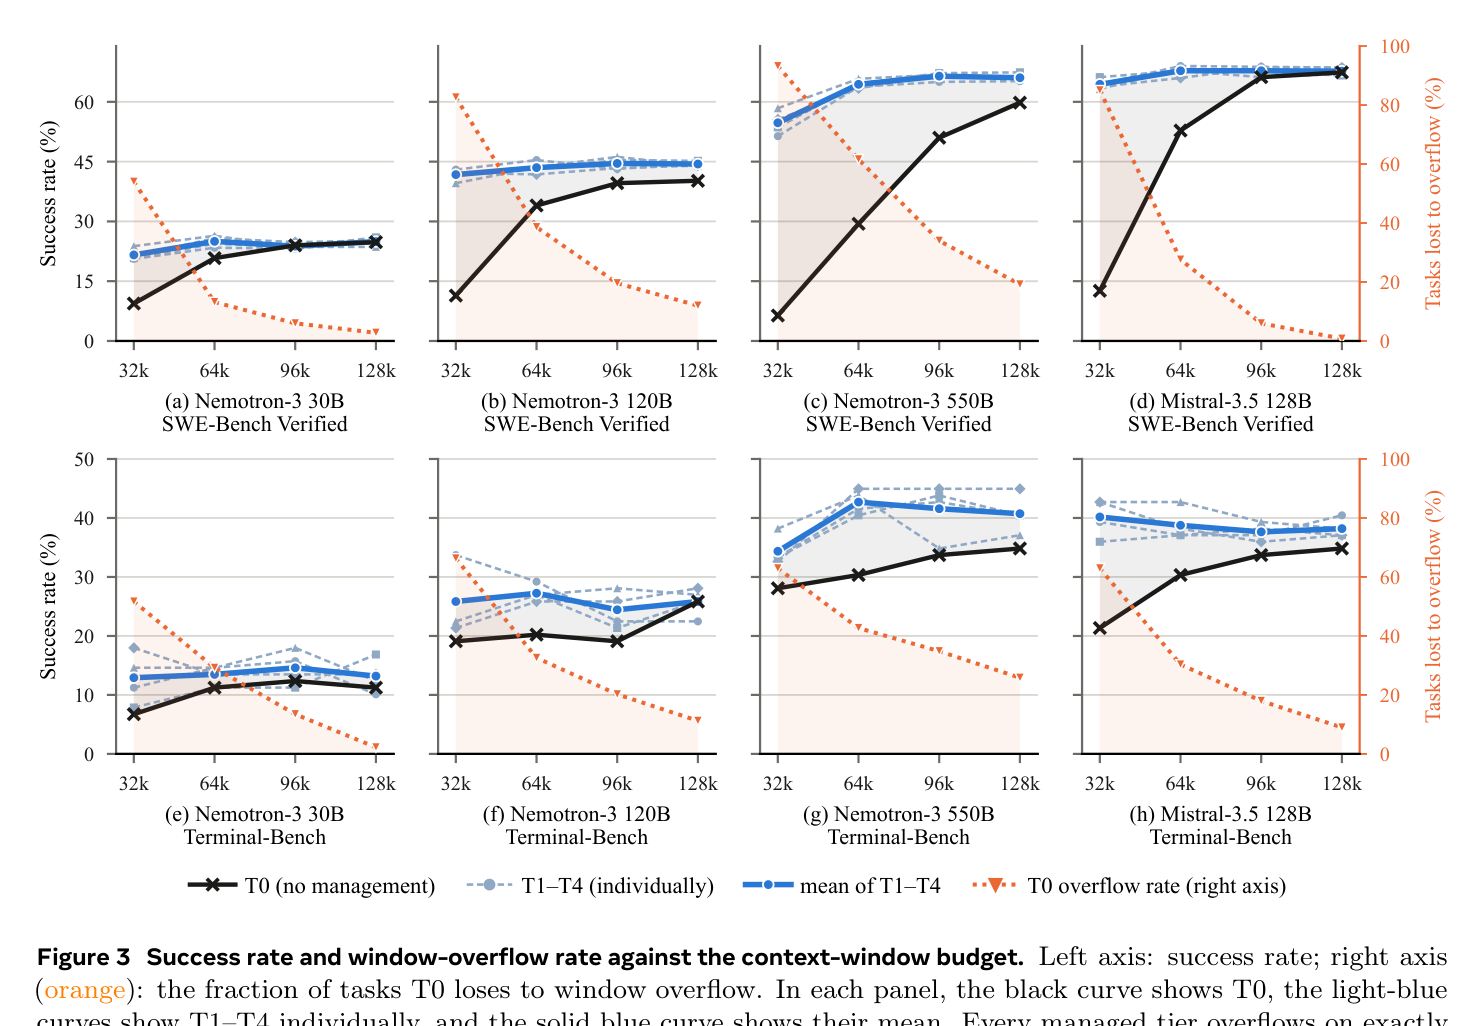
컨텍스트 관리의 가치를 “관리 적용 시 성공률 - 무관리(T0) 성공률”로 정의하면, 모델 평균 격차는 이렇게 줄어듭니다.
| 창 예산 | SWE-Bench 격차 | Terminal-Bench 격차 |
|---|---|---|
| 32k | 35.7pp | 9.5pp |
| 64k | 15.9pp | 7.5pp |
| 96k | 5.5pp | 4.8pp |
| 128k | 2.7pp | 2.8pp |
32k에서는 35.7pp나 되던 격차가 128k에선 2.7pp로 줄어듭니다. 이유는 단순합니다. T0의 오버플로 실패율이 SWE-Bench에서 78.7% → 8.7%로 떨어지는 동안 관리 적용 티어는 모든 예산에서 오버플로 0건이었기 때문입니다. 즉 컨텍스트 관리의 실체는 창이 터져서 과제를 날리는 걸 막는 장치에 가깝습니다.
전략 중에서는 T4(규칙 기반 생략 → LLM 요약 순서)가 8개 패널 중 7개에서 최저 비용을 기록했습니다. 싼 규칙 생략이 먼저 처리해서 비싼 LLM 요약 호출을 줄이는 구조입니다.
흥미로운 건 복원(recall) 메커니즘입니다. 생략한 내용을 외부에 저장해두고 필요할 때 다시 꺼내 보게 했더니, 64개 설정 중 36개(56.3%)가 recall을 한 번도 호출하지 않았고 정확도 이득도 없었습니다. 128k에서는 호출 수가 태스크당 0.007회입니다. 무손실 복원은 기계만 복잡하게 만드는 셈이죠.
플래닝 결과: 30B는 +11.6pp, 강한 모델은 비용 -30%
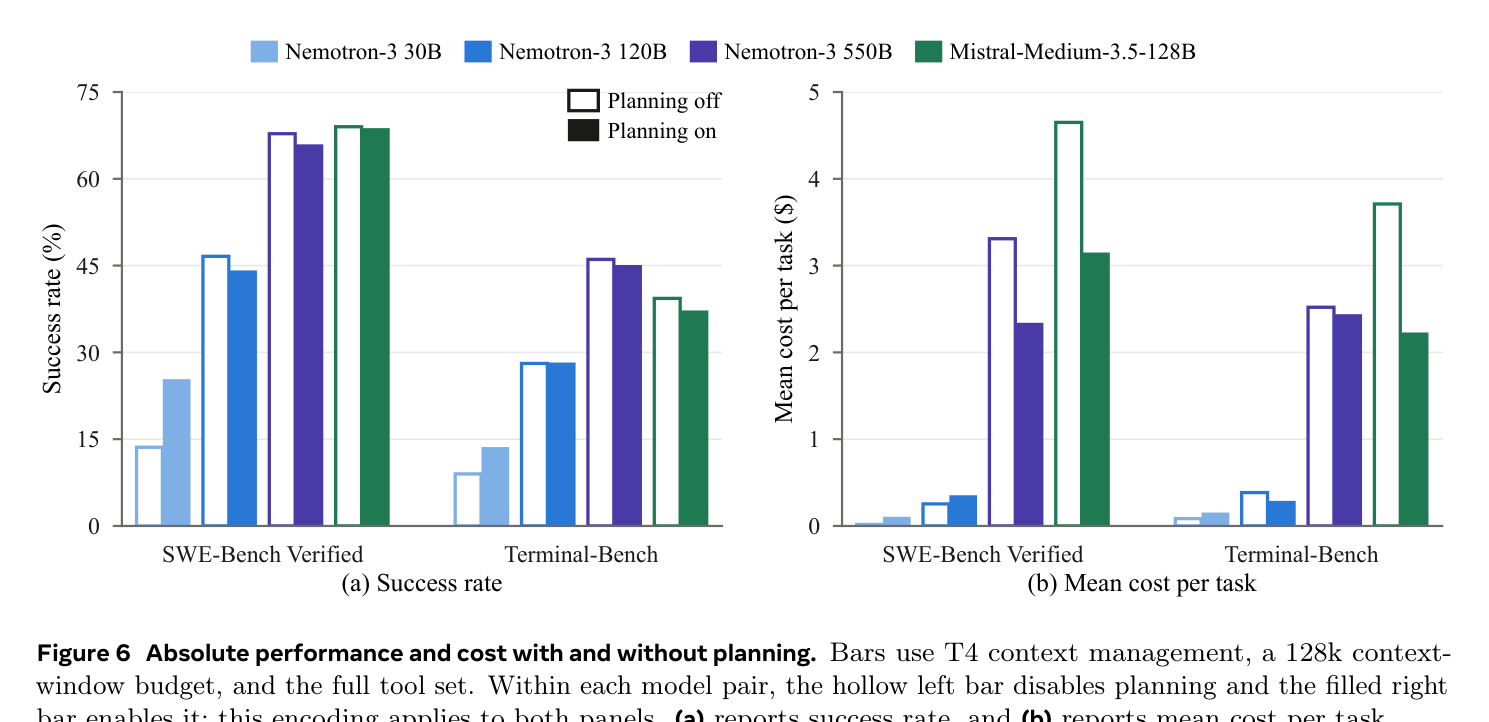
플래닝 on/off를 T4/128k에서 비교한 결과입니다.
| 모델 | 효과 |
|---|---|
| Nemotron-3 30B | SWE-Bench +11.6pp, Terminal-Bench +4.5pp, 비용 증가 |
| Nemotron-3 120B | 정확도 이득 불일치, 비용은 벤치마크마다 엇갈림 |
| Nemotron-3 550B / Mistral-3.5 | SWE-Bench 비용 약 30%/32% 감소, 정확도는 -2.0/-0.4pp |
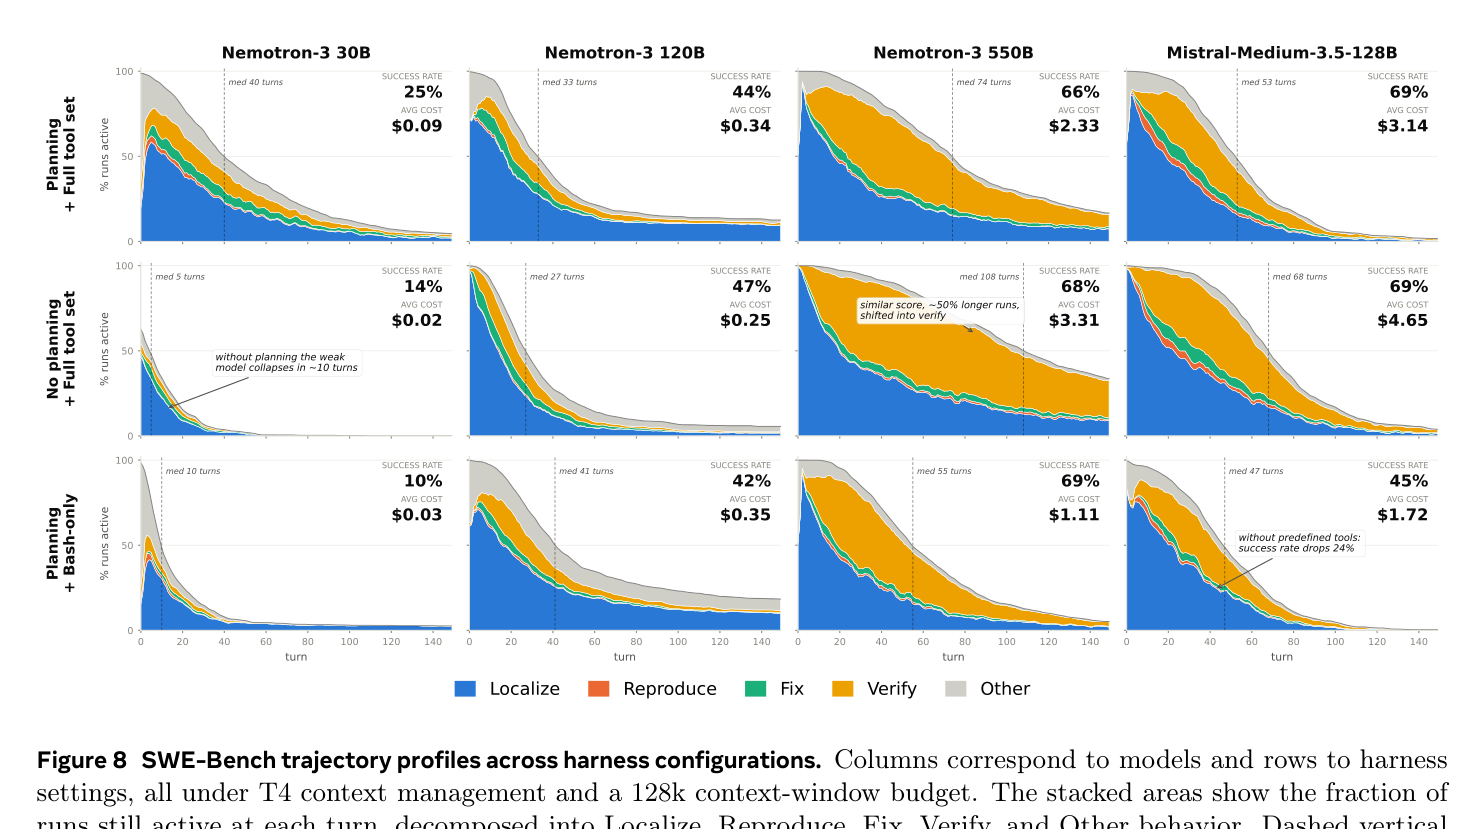
트레이스 분석으로 이유가 드러납니다. 약한 30B는 플래닝이 없으면 에디트 시도 전에 꺼집니다. 무계획 시 68.6%가 에디트 없이 종료됐는데 계획 있으면 27.8%로 줄었구요. 반대로 강한 모델은 플래닝이 중복 검증을 잘라서 비용을 아껴줍니다. 550B의 SWE-Bench 중앙 트레이젝토리가 108턴에서 74턴으로 줄었고 그 감소의 대부분은 Verify 구간이었습니다.
액션 공간 결과: 도구 세트 vs bash-only
이게 실무적으로 제일 와닿는 결과입니다.
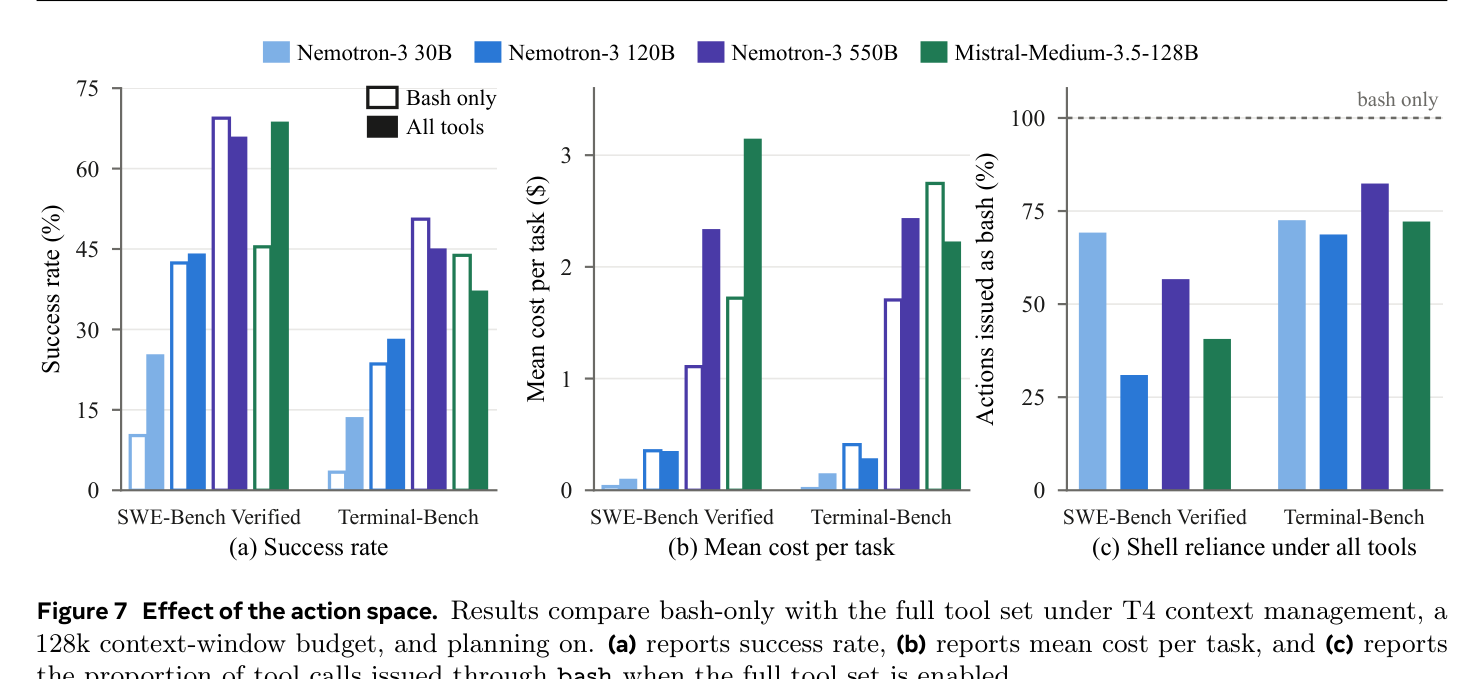
- 약한 30B는 전체 도구 세트가 SWE-Bench +15.0%, Terminal-Bench +10.1%를 올립니다. bash-only로 두면 인터페이스 밖 행동을 뱉다가 66%의 트레이젝토리가 조기 종료됩니다.
- 강한 550B는 반대로 bash-only가 SWE-Bench +3.6%, Terminal-Bench +5.6%이면서 비용은 53%/30% 감소입니다.
- Mistral-3.5는 벤치마크에 따라 갈립니다. SWE-Bench(파이썬 리포지토리 수정)에선 도구 세트가 +23.2%, 터미널 중심 Terminal-Bench에선 bash-only가 +6.7%였습니다.
메커니즘도 트레이스에 나옵니다. bash-only는 잘하는 모델에게 여러 저수준 조작을 한 명령으로 묶게 해줍니다. 550B의 Terminal-Bench 중앜 트레이젝토리가 47턴 → 31턴, 코드 작성 행동 비중은 16% → 27%로 올라갔구요. 반대로 미리 정의된 도구는 개별 행동 난이도는 낮추지만 같은 작업에 필요한 상호작용 수를 늘립니다.
트레이젝토리 분석 결과
부품별로 행동이 어떻게 바뀌는지 LLM 저지가 페이즈를 라벨링해서 분석했습니다.
- 컨텍스트 관리: 행동 패턴은 그대로 두고 실행 트레이젝토리를 길게 늘려줍니다. 32k 무관리는 중앜값 20-30턴이면 죽지만 관리 티어는 50-180턴까지 갑니다.
- 플래닝: 트레이젝토리가 멈추는 지점을 바꿉니다. 약한 모델은 초기 에디트까지 버티게 하고, 강한 모델은 검증 꼬리를 자릅니다.
- 액션 공간: 코드를 쓰는 단위( granulariy)를 바꿉니다. bash-only에서 재패치 수는 4개 모델 전부 감소(550B 4.6→1.5), create-or-replace 비중은 30B 기준 28%→64%로 늘었습니다.
내 해석: 부품은 조건부로 골라야
원문 결론을 제 상황에 대입해봤습니다. 구분선은 제 판단입니다.
- 하네스 부품은 베스트 프랙티스로 통일할 게 아니라 대상 모델·태스크 타입·예산에 맞춰 고르는 조건부 선택 문제입니다.
- 작은 창 모델(로컬·경량 배포)을 쓴다면 컨텍스트 관리, 그중에서도 규칙 기반 생략 먼저 넣는 게 이득입니다. 복원 메커니즘은 빼도 됩니다.
- 강한 모델에 플래닝을 강제하는 건 정확도보다 비용 최적화 문제입니다. 검증 루프를 어디서 끊을지가 관건이구요.
- 도구를 많이 노출하는 게 항상 친절한 건 아닙니다. bash 능력이 검증된 모델에겐 오히려 인터페이스를 단순화하는 bash-only가 싸고 정확할 수 있습니다.
- 한계도 분명합니다. 플래닝·액션 공간은 T4/128k 한 곳에서만 절제(ablation)됐고, 액션 공간 변경은 프롬프트·파일 상태 추적까지 묶여서 바뀌므로 순수한 도구 수 효과와는 분리 안 됩니다. Terminal-Bench는 89 태스크라 유의성이 약한 셀도 많구요.
더 실습해보고 싶은 분들께
자주 묻는 질문
하네스가 모델보다 중요한가요?
이 논문은 둘을 분리해서 재지 않았습니다. 대신 같은 모델에서도 하네스 부품만 바꿔서 성공률이 수십 포인트 차이 난다는 걸 보여줍니다.
컨텍스트 관리는 언제나 켜는 게 좋나요?
정확도 손해는 없고 비용 이득이 있어서 켜는 게 안전합니다. 다만 창이 넉넉한(128k급) 강한 모델에선 성공률 이득이 2-3pp로 작습니다.
약한 모델엔 무엇을 먼저 넣어야 하나요?
플래닝과 미리 정의된 도구 세트입니다. 30B 모델에서 플래닝이 +11.6pp, 도구 세트가 +15.0pp까지 올렸습니다.
강한 모델에 하네스에서 뗄 수 있는 것은요?
복원(recall) 메커니즘과, 셸 중심 태스크에서는 미리 정의된 도구 세트입니다.
출처
- 논문: An Empirical Study of Harness Design for Coding Agents (arXiv:2609.20804)
- 벤치마크: SWE-Bench Verified, Terminal-Bench 2.1
- 하네스 베이스: LangGraph 기반 경량 구현 (원문 §2)
- 본문 수치는 전부 원문 Tables 3-7, Figures 3-8 인용입니다. 기준일 2026-09-18.