결론 먼저
ScienceIDE는 세계의 과학 코드 저장소를 LLM 에이전트가 학습할 수 있는 실행 환경으로 바꾸는 인프라입니다. 논문 저자들은 이걸 “과학 경험 병목(scientific experience bottleneck)” 해결이라고 부릅니다. 과학 코드는 돌아가기만 하면 끝이 아니라, 수치 오차 허용 범위와 도메인 관례까지 맞아야 진짜 성공이라서 기존 코딩 벤치마크로는 학습 경험을 만들 수 없거든요.
핵심 구조는 세 가지입니다.
- 전문가가 모듈 경계와 합격 기준을 고정하면, 에이전트가 코드를 고치거나 구현해서 시뮬레이션을 돌립니다.
- 검증자(verifier)가 컴파일 후 실제 과학 시뮬레이션을 실행해 보상을 계산합니다. 즉 보상 자체가 검증 가능한 RL(reward-verifiable RL) 설정입니다.
- 그 경험으로 Qwen3.5-4B/9B를 학습시켰더니 과학 코드 수리 성적이 크게 올랐고, 일반 코딩/추론 벤치마크로도 전이됐습니다.
핵심 수치 요약
| 항목 | 값 | 비고 |
|---|---|---|
| 등록된 태스크 | 2,812개 | 64개 환경 · 27개 코드베이스 |
| 공개 하드 서브셋 ScienceIDE-Hard | 85 태스크 | 18개 환경 (PLUTO, Athena++, MITgcm, LAPS, PHANTOM) |
| 최상위 성적 (Claude Fable 5.1) | 67.1% | 1시간 예산, 엄격 기준 |
| 2위 (Claude opus-5) | 64.6% | 반복 구간이 Astra와 겹침 |
| RL 후 held-out 보상 (LAPS) | 0.357 → 0.857 | Qwen3.5-4B, 약 2.4배 |
| RL 후 held-out 보상 (MITgcm-biogeo) | 0.286 → 0.571 | 약 2.0배 |
| SFT 후 수리 보상 (PLUTO-Dust, 4B) | 0.0000 → 0.3333 | +33.3 포인트 |
기준일: 2026-09-17 기준, arXiv:2609.19134 (2026-09-16 공개) 초록·본문 수치입니다. 모델명은 논문 리더보드 표기 그대로 가져왔습니다.
왜 과학 코드는 기존 벤치마크로 안 되나
코딩 벤치마크는 보통 “문제 설명 + 목표 + 합격 테스트”가 주어집니다. 과학 코드는 다릅니다. 돌아가는 것과 과학적으로 맞는 것은 다른 문제예요. 예를 들어 흐름 시뮬레이션에서 랜덤 시드 때문에 결과가 조금씩 흔들리면, 점별 오차 비교로는 정상 실행과 결함을 구분할 수 없습니다. 저자들은 이럴 때 모멘트·분포·보존량 같은 관측 가능량을 비교하는 합격 정책(pass policy)을 따로 설계합니다.
여기서 중요한 설계가 공식 테스트를 “캘리브레이션된 검증”으로 컴파일하는 과정입니다. 모듈별로 공식 유닛/회귀 테스트와 예제를 조사하고, 노미널 실행과 변형 초기조건 실행을 비교해 수치 민감도를 측정합니다. 각 검증은 “어떤 과학적 편향을 걸러내는지”를 설명하는 warrant를 붙입니다. 검증이 왜 존재하는지 감사할 수 있게 하는 거죠.
파이프라인 구조
전체 흐름은 이렇습니다.
- 저장소를 핀(pin)하고 빌드·공식 테스트를 돌려 모듈을 자른다.
- 모듈에 런타임, 검증, 프라이빗 버리파이어를 패키징한다.
- 태스크 팩토리가 후보를 제안하면, 실제 실행으로 “풀 수 있고 관찰 가능하고 누수에 강한” 태스크만 남긴다.
- 에이전트 롤아웃 → 검증 보상 → SFT/RL/평가로 재사용한다.
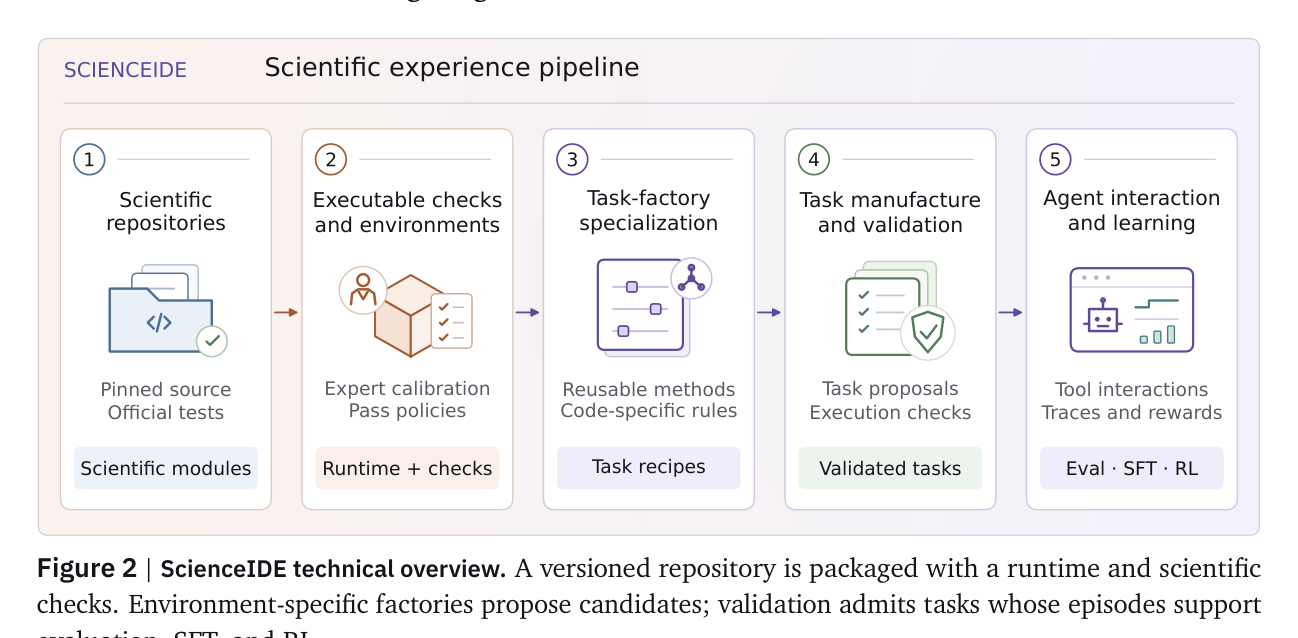 Figure 2. 버전 고정 저장소를 런타임과 과학 검증으로 패키징하고, 환경별 팩토리가 태스크를 제안·검증합니다. 출처: arXiv:2609.19134.
재미있는 부분은 “제안은 넓게, 증명은 실행으로” 원칙입니다. AI가 만든 변환 후보가 태스크가 되려면, 결함 주입 기준으로 정상 witness와 결함 baseline이 실행 결과에서 실제로 갈라지는 behavioral contrast를 보여야 합니다. 논문·레포·데이터셋을 모아놨다고 학습 환경이 되는 게 아니라는 주장의 근거가 이 검증 절차입니다.
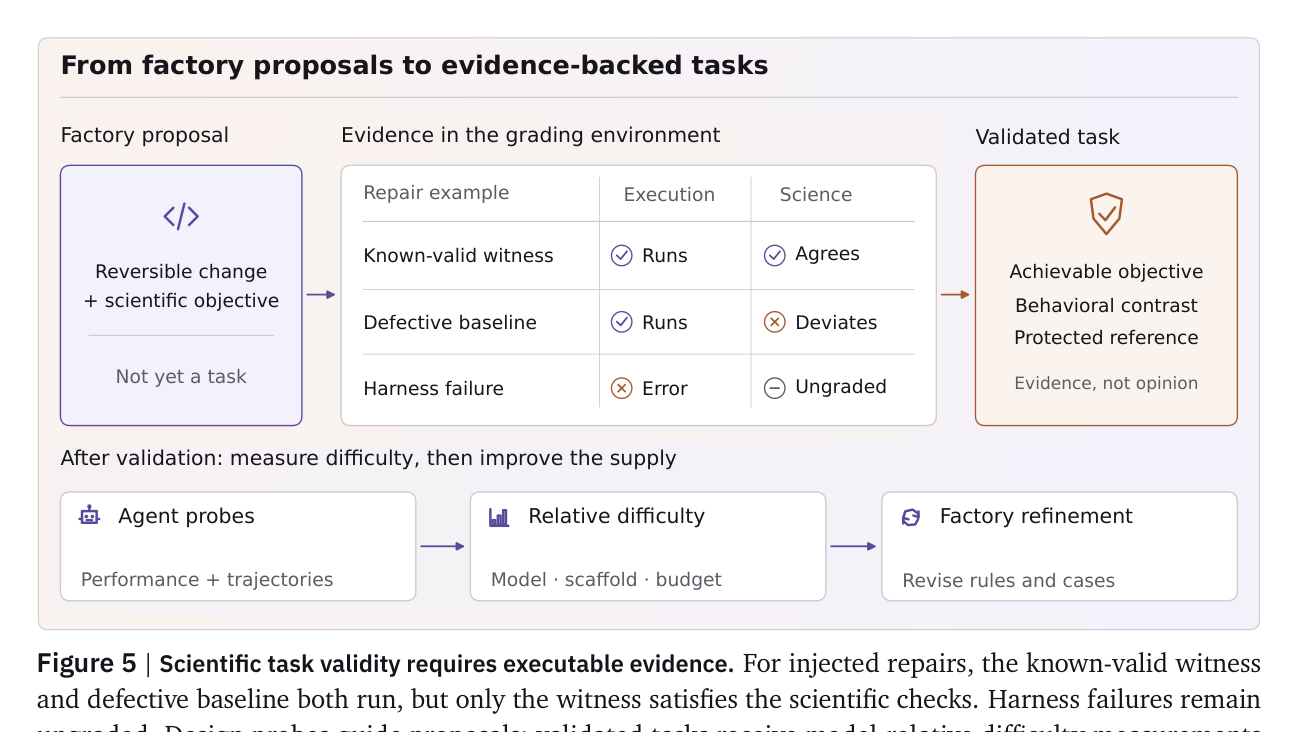 Figure 5. 팩토리 제안이 증거를 갖춘 태스크가 되는 과정. 출처: arXiv:2609.19134.
벤치마크 결과: 15개 모델, 1시간 예산
ScienceIDE-Hard는 85개 하드 태스크(수리 52 + 구현 33)로 구성됩니다. 성공 조건은 코드 실행이 아니라 프라이빗 과학 기준과의 수치 합치입니다. 15개 모델을 Codex·Claude Code·Gemini CLI로 각각 돌렸습니다.
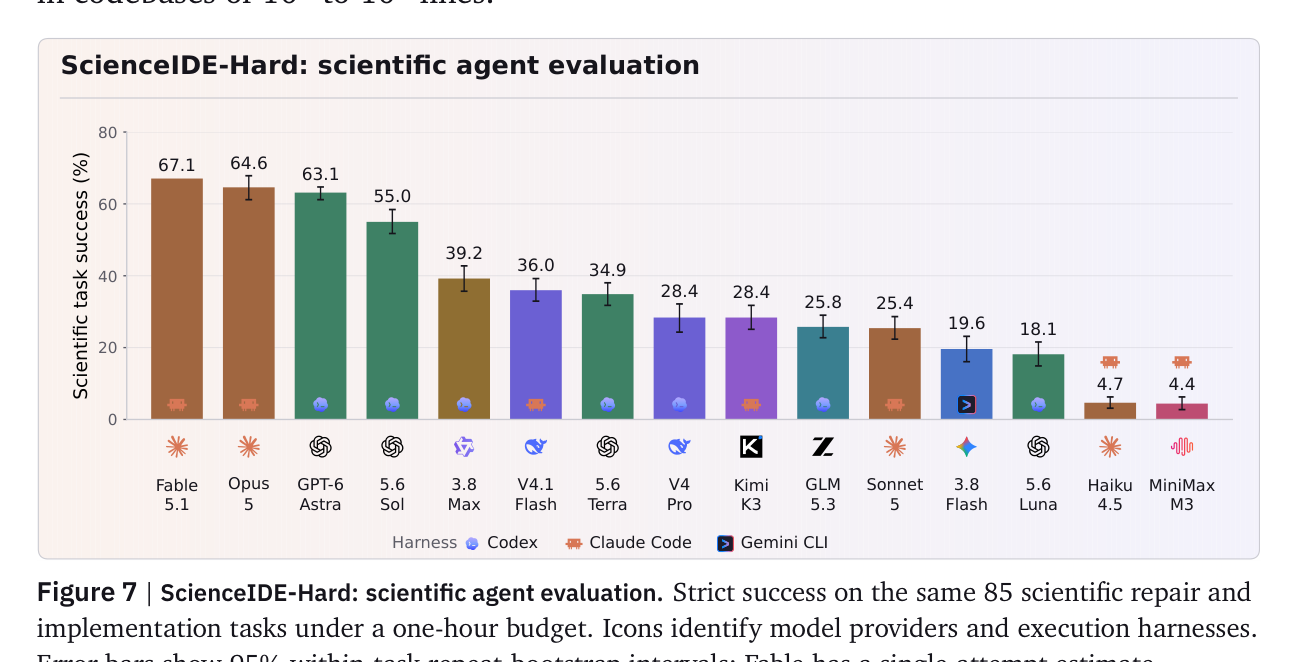 Figure 7. ScienceIDE-Hard에서 15개 에이전트의 엄격 성공률. 출처: arXiv:2609.19134.
읽을 때 주의할 점 두 가지:
- 최상위권 격차는 통계적으로 확정된 순위가 아닙니다. Fable은 단일 측정이고 Opus와 Astra의 반복 구간이 겹칩니다. 저자 스스로 밝힙니다.
- 예산이 순서를 바꿉니다. 10분 시점에서는 Astra가 49.6%로 Fable(25.9%)을 크게 앞서는데, 약 31분에서 역전됩니다. 20–60분 구간 증가분은 Astra +2.0pp, Fable +11.8pp, Opus +16.0pp, Qwen3.8 Max +30.2pp예요. 비용도 다릅니다. Fable은 태스크당 추정 7달러 수준인데, 모델에 따라 몇 배 차이가 납니다.
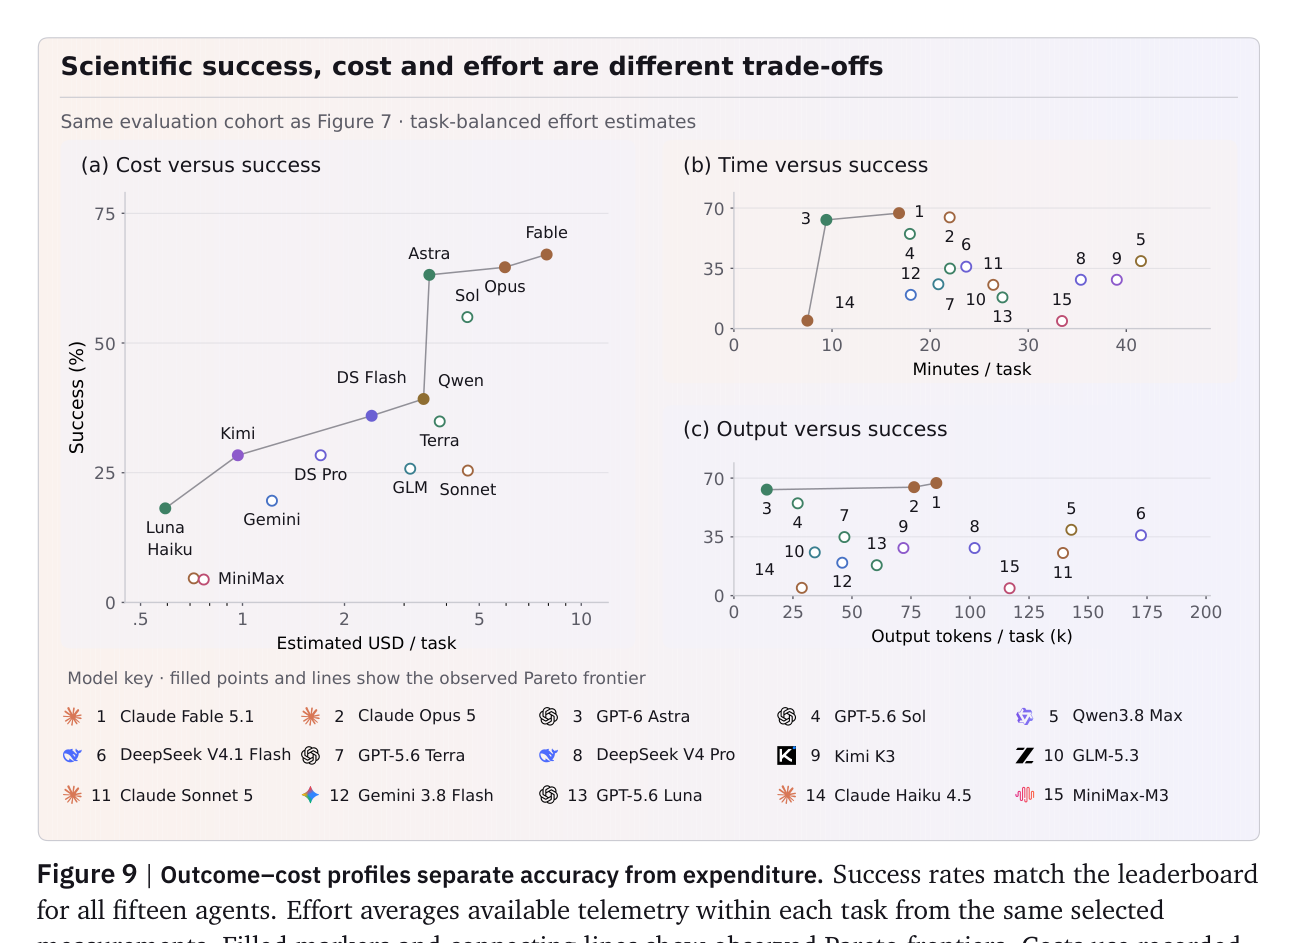 Figure 9. 성공률 대비 비용·시간·출력 토큰. 출처: arXiv:2609.19134.
SFT 결과: 과학 경험의 일반 전이
검증된 시연 트라젝토리(GPT-5.6-sol 수집, 564 태스크 4,567 세그먼트)로 Qwen3.5 계열을 SFT했습니다. 환경 원래의 수치 검증으로 측정했습니다.
- Qwen3.5-4B: PLUTO-Particles-Dust 수리 보상 0.0000 → 0.3333
- Qwen3.5-9B: PLUTO-RMHD/ResRMHD 0.0000 → 0.2857, LAPS 0.3125 → 0.5000
- 일반 벤치마크도 오릅니다. BBH Word Sorting(9B) +33.6pp, HumanEvalFix JS(4B) +10.98pp, QuixBugs Java(4B) +10.0pp 등 15개 매칭 비교에서 개선.
단, HumanEvalFix Python(9B)은 86.11 → 77.78로 하락한 사례도 있습니다. 전이가 전 방향으로 균일하게 일어나는 건 아니라는 점은 데이터로 확인됩니다.
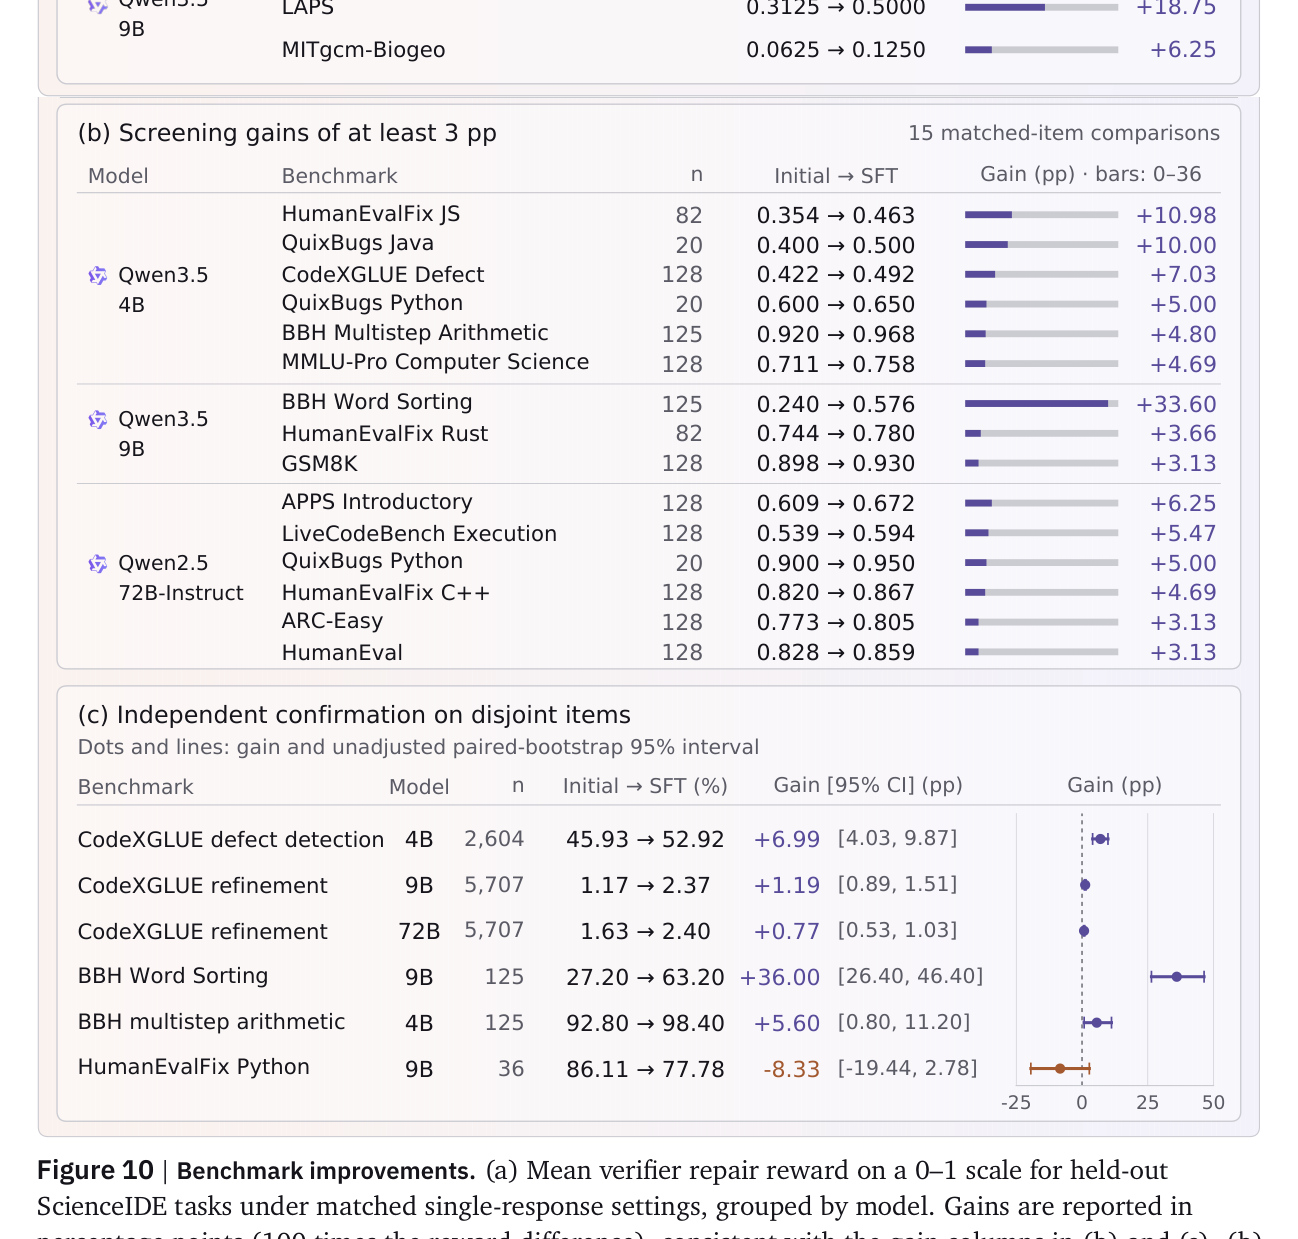 Figure 10. (a) 과학 코드 수리 보상, (b)(c) 일반 벤치마크 전이. 출처: arXiv:2609.19134.
RL 파트가 이 논문의 핵심 기여
SFT보다 더 흥미로운 건 온라인 RL입니다. 검증자가 에피소드 끝에 시뮬레이션을 돌려 점수를 주므로 보상이 outcome-only입니다. 수십 턴, 수만 토큰짜리 트라젝토리에 끝에 한 번 보상이 오는 구조라 일반 RL보다 훨씬 어렵습니다.
구현 디테일:
- 롤아웃은 vLLM, 학습은 veRL 기반 커스텀 PSRL 트레이너, 에피소드 실행은 harbor 컨테이너.
- 롤아웃 GPU와 학습 GPU를 분리해 병렬로 돌리고, token-level truncated importance sampling으로 1-step staleness를 보정.
- 예산 초과로 잘린 에피소드의 토큰을 마스킹하니 학습이 안정화됩니다. 잘린 에피소드를 0보상으로 그대로 쓰면 “열심히 시도한 긴 에피소드”가 오히려 억제되는 문제가 생기거든요.
결과는 30 스텝 만에 LAPS 0.357 → 0.857, MITgcm-biogeo 0.286 → 0.571. 같은 기간 트렁케이션 비율도 LAPS 39.5% → 6.6%로 감소했습니다. 정책이 “죽어라 오래 시도하다 끊기는” 에피소드를 “검증자 판정까지 도달하는” 에피소드로 바꾼 거죠.
나의 해석
원문 근거와 구분해서 제 해석을 적습니다.
이 논문의 실제 기여는 모델이 아니라 환경 구축 방법론입니다. 2,812개 태스크와 64개 환경의 숫자보다, “전문가 합의를 실행 가능한 검증으로 컴파일하는 절차”가 재사용 가능한 자산이라는 점이 더 오래 남을 것 같습니다. 이건 과학 도메인뿐 아니라 사내 레거시 코드·검증 시트에도 그대로 적용할 수 있는 구조예요.
하네스가 결과의 일부라는 걸 논문이 정직하게 다룹니다. 모델–하네스 시스템을 비교한다고 명시하고, 예산 응답 곡선을 같이 보여줍니다. 벤치마크 숫자만 보고 모델을 사는 관행에 대한 좋은 반례 자료입니다.
제한점도 분명합니다. 리더보드 상위권은 단일 측정이거나 구간이 겹치고, SFT에서 일부 벤치마크 하락도 관찰됩니다. “과학 경험이 만능”이 아니라 “검증 가능한 경험을 잘 만들면 학습이 된다” 정도로 읽는 게 정확합니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
Q. ScienceIDE가 하는 일을 한 문장으로 정리하면?
과학 코드 저장소를 “코드 고치기 → 시뮬레이션 실행 → 수치 검증 → 보상” 루프가 도는 학습 환경으로 변환하는 인프라입니다.
Q. 기존 코딩 벤치마크와 다른 점은?
합격 판정을 테스트 통과 대신 과학적 수치 합치로 내립니다. 실행 성공과 과학적 성공이 분리되어 있고, 후자만 점수로 인정됩니다.
Q. 어떤 모델이 제일 잘했나?
ScienceIDE-Hard(85 태스크, 1시간 예산) 기준 Claude Fable 5.1이 67.1%로 최상위입니다. 다만 저자가 상위권 순위가 통계적으로 확정되지 않았다고 명시합니다.
Q. 오픈소스로 공개됐나?
논문은 코드 공개 링크(GitHub aitofound/ScienceIDE)를 포함하고 있고, 코드와 학습 파이프라인이 공개 대상입니다. 세부 라이선스는 저장소에서 확인하세요.
Q. 어디에 당장 써먹을 수 있나?
검증 가능한 기준이 이미 존재하는 도메인, 예컨대 사내 수치 시뮬레이션 코드, 데이터 파이프라인 회귀 테스트, 계산 결과 허용 오차가 문서화된 시스템에 같은 구조(전문가 합의 → 실행 검증 → 태스크 팩토리)를 적용할 수 있습니다.