핵심 요약
Şenol(2026)이 제안한 CoSQ(Chain-of-Self-Questioning)는 프롬프트 수준에서 답변 커밋 여부를 조건화하는 선택적 예측 프레임워크입니다. 파인튜닝 없이, 로짓 접근 없이, 프롬프트만으로 동작합니다. 본 문서는 해당 논문(arXiv:2609.17516)의 방법과 결과를 정리합니다.
주요 결과 (TruthfulQA-MC, 817문항, 11개 모델 패밀리, 모델-매크로 평균, 기준일 2026-09-17):
| 조건 | AA (답한 정답률) | Coverage | HR (무조건 오답 커밋률) | 기권률 |
|---|---|---|---|---|
| Direct | 0.872 | 1.000 | 0.128 | 0.000 |
| CoT | 0.869 | 1.000 | 0.131 | 0.000 |
| Grounded-CoSQ τ=0.90 | 0.897 | 0.876 | 0.089 | 0.123 |
| Critical-CoSQ τ=0.90 | 0.896 | 0.886 | 0.092 | 0.113 |
| Adaptive-CoSQ τ=0.90 | 0.896 | 0.865 | 0.089 | 0.134 |
Grounded-CoSQ τ=0.90 기준 CoT 대비 HR 32.1% 상대 감소, AA 2.87pp 증가. Wilcoxon 단측 p=0.00049, 부트스트랩 95% CI [0.0272, 0.0595], Cohen’s dz=1.44, 방향 일치 11/11 모델.
배경
대부분의 QA 평가는 무조건 답하기를 보상합니다. 다 찍어도 점수가 나오니, 모델은 답할 수 있는 질문과 없는 질문을 구분할 이유가 없습니다.
의료·법률·금융처럼 틀린 답을 확신 있게 내놓는 것이 기권보다 비싼 도메인에서는 명시적 기권이 검토 트리거로 더 유용합니다.
기존 연구는 주로 답을 만든 다음에 개입합니다. CoSQ는 더 앞선 지점, 즉 답을 생성하기 전에 커밋 여부를 결정합니다.
방법
3단계 파이프라인. 질문당 프롬프트-완성 상호작용 3회 소요(Direct/CoT는 1회).
- 필요 정보 단위 분해: I(q) = {i1, …, im}
- 정보 단위별 지지도 평가 (이진 또는 0-100 점수)
- 결정 게이트 통과 시 수용된 정보 단위로만 답 생성, 미달 시 기권
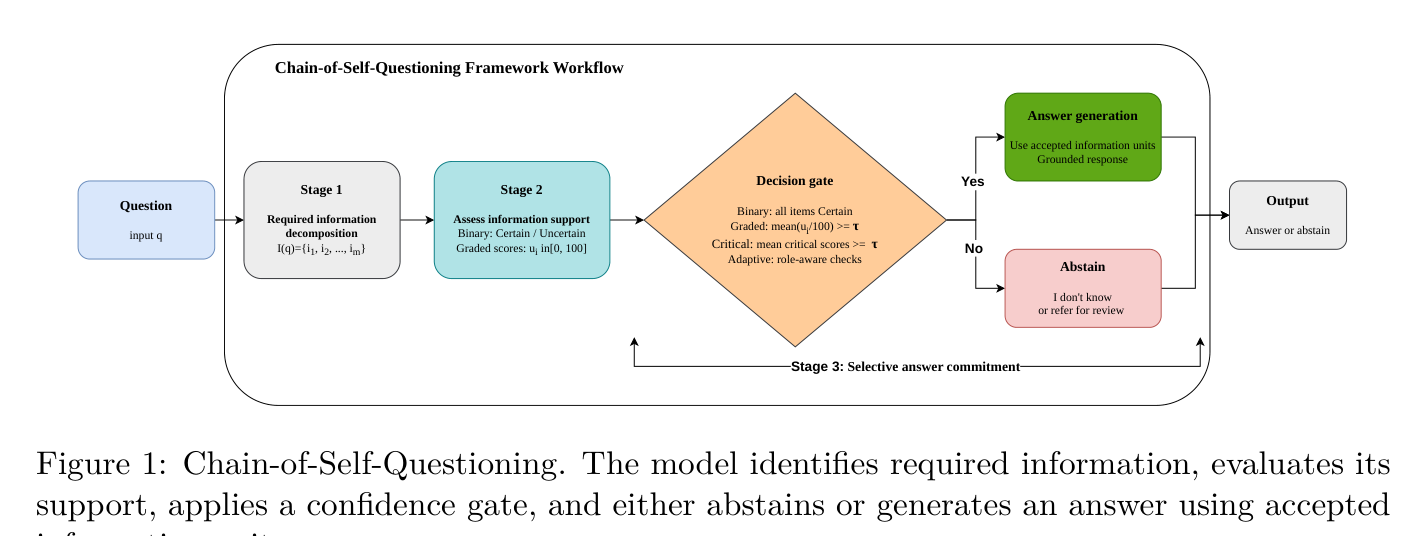
논문 Figure 1: Chain-of-Self-Questioning 프레임워크.
변형:
- Grounded-CoSQ: 전체 정보 단위 평균 점수가 τ 이상이면 커밋. τ ∈ {0.50, 0.60, 0.70, 0.80, 0.90} 전수 평가 후 τ=0.90을 주 운영 지점으로 사전 지정. 통과한 정보 단위만 답 생성에 넘기므로 기각된 전제로 답을 만들 확률이 줄어듭니다.
- Critical-CoSQ: 정보 단위를 critical/supporting으로 분류, critical 단위만 게이트에 사용.
- Adaptive-CoSQ: 전체 평균 ≥ τ, critical 평균 ≥ 0.65, critical 최솟값 ≥ 0.40의 3중 검사. 커밋 후 모순 검출 시 기권.
τ는 보정 확률이 아니라 리스크-커버리지 프론티어 상의 운영 파라미터입니다.
실험 설계
- TruthfulQA-MC 검증 분할 817문항. 선지 위치를 시드 1002로 결정론적 균형화해 고정 위치 단축키(라벨 편향)를 제거했습니다.
- 모델 패널 11종: Llama 3 8B/70B, Llama 4 Scout 17B, Gemma 3 12B, Gemma 4 31B, Mistral 7B, GPT-OSS 20B/120B, GPT-5.5, Claude 5 Sonnet, DeepSeek Flash.
- 부차 평가: NQ-Short 300문항, 5개 모델, 개방형 의미 정답 매칭.
- 강제 선택 베이스라인(Direct, CoT)은 coverage 1.0. CoSQ의 명시적 기권은 answered accuracy 분모에서 제외.
기권 구성 분석
τ=0.90에서 모델당 평균 기권 100.5문항(Grounded). 그중 CoT가 오답이었던 문제에서의 기권(옳은 기권) 31.3%, CoT가 정답이었던 문제에서의 기권(잃은 가치) 68.7%. 기권은 자동화 범위와 리스크의 교환으로 읽어야 합니다.
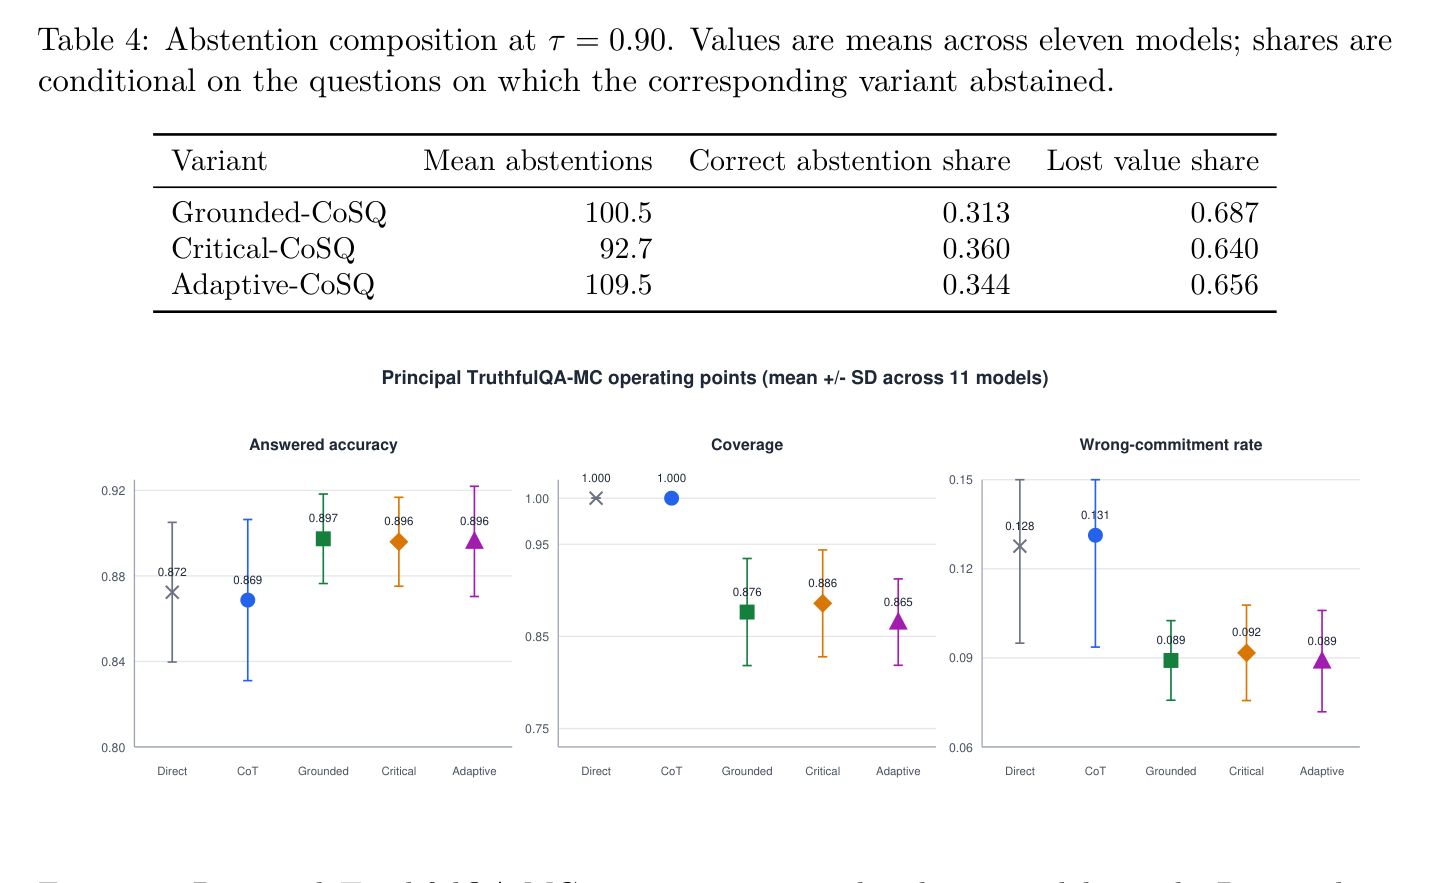
논문 Table 4: 기권 구성.
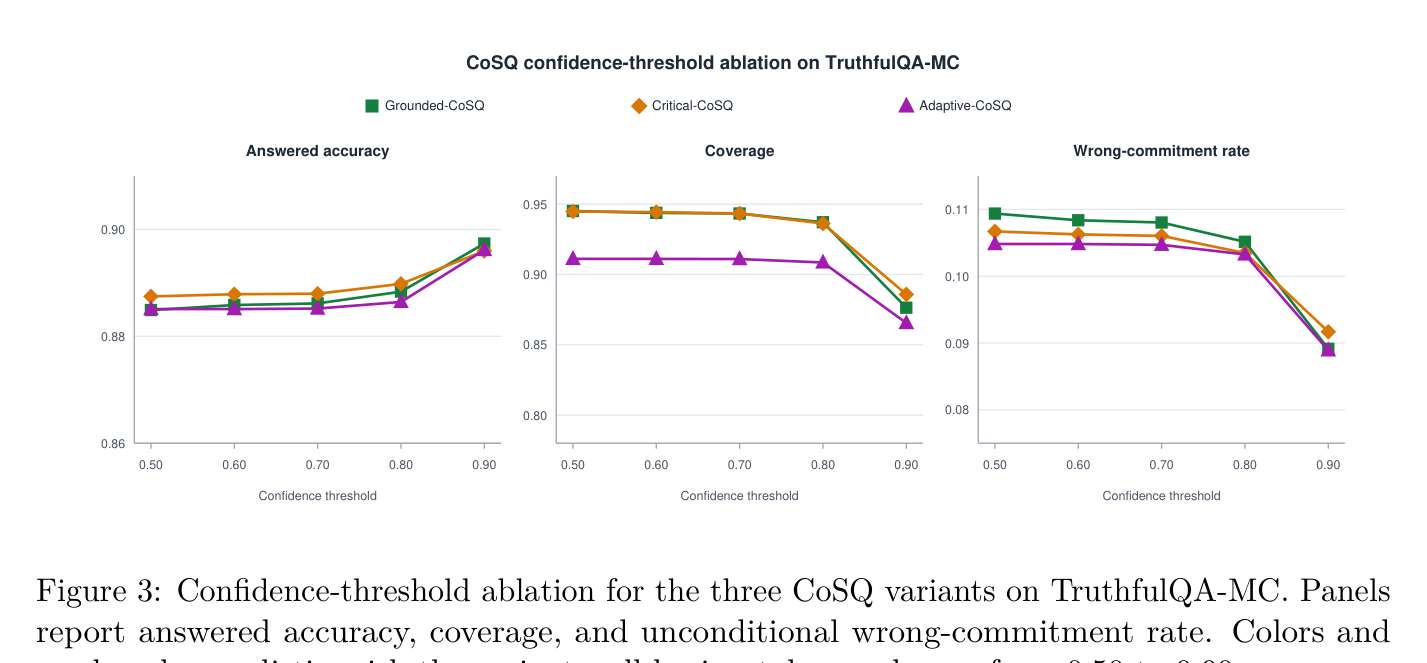
논문 Figure 3: 임계값 스윕. 평가한 전체 15개 선택 조건에서 CoT 대비 HR 감소 및 AA 증가가 모든 모델에서 성립합니다.
NQ-Short 부차 결과 (300문항, 5개 모델)
| 조건 | AA | Coverage | HR |
|---|---|---|---|
| CoT | 0.588 | 1.000 | 0.412 |
| Grounded-CoSQ τ=0.90 | 0.670 | 0.830 | 0.274 |
채점 방식이 달라 주 분석과 수치 비교는 불가하며, 일반화에 대한 수렴 증거로 해석합니다.
모델 수준 관찰
모든 모델에서 세 CoSQ 변형 모두 CoT 대비 낮은 HR과 높은 AA를 보였습니다. DeepSeek Flash에서 최대 절대 감소(HR 0.177 → 0.080)가 나왔습니다.
비용과 한계
- 질문당 상대 추론 단계 3회 (Direct/CoT는 1회). 오답 커밋 확률을 줄이는 데 쓰는 추론 예산입니다.
- ‘self-questioning’은 프롬프트 수준 절차이며 인간적 내성 접근 주장이 아닙니다.
- 호스팅 엔드포인트의 가중치 개정 비고정 한계를 논문이 스스로 보고합니다.
- 기권의 68.7%는 자동화 범위 축소에 해당.
실무 적용 포인트
RAG나 에이전트 파이프라인이라면 답변 직전에 필요 정보 단위를 나열하고 근거 점수를 매기게 한 뒤, 임계값 미만이면 검토로 라우팅하면 됩니다. 틀린 답의 비용이 높은 도메인이라면 3배 추론 비용을 주고도 남는 거래라고 논문은 주장합니다.
관련 글
자주 묻는 질문
CoSQ는 파인튜닝이 필요한가요? 불필요. 프롬프트만으로 동작하며 로짓 접근이 없습니다. 11개 모델 패밀리에 그대로 적용했습니다.
기권하면 점수가 하락하지 않나요? answered accuracy는 상승, coverage는 하락. 두 지표를 함께 보고 전체 임계값 스윕을 공개합니다.
소형 모델에서도 유효한가요? DeepSeek Flash 등 전체 패널에서 유효했습니다.
도입 비용은요? 질문당 프롬프트-완성 3회. 절약이 아니라 리스크 감소를 사는 지출입니다.
원문: When Should LLMs Abstain? Chain-of-Self-Questioning for Selective Risk Control (arXiv:2609.17516)