결론 먼저
에이전트 하네스의 컨텍스트 조립(context assembly) 단계 자체가 공격 지점이다. 이 논문은 Claude Code와 Codex를 포함한 12개 실전 하네스를 분석해서, 아래 두 범주로 정리했다.
낮은 권한의 컨텍스트에 심은 공격 내용이 높은 권한의 메시지 역할로 흘러들어가는 경로 1761개를 찾아냈다.
논문: What’s in Your Agent’s Context? Context Privilege Escalation Attacks against AI Agent Harness (arXiv:2609.01222), Zichuan Li 외, 2026-09-01 v1 / 2026-09-02 v2. 기준일 2026-09-17.
핵심 요약 표
| 항목 | 값 |
|---|---|
| 제안 개념 | CPE (Context Privilege Escalation) |
| 분석 대상 | 실전 에이전트 하네스 12종 (Claude Code, Codex, Gemini CLI, OpenClaw 등) |
| 후보 공격 경로 | 1,761개 (M-CPE 940, X-CPE 640, 둘 다 181) |
| 검증 모델 | GPT-5.5, GPT-5.4-mini (+Claude Sonnet 4.6/Opus 4.6, Gemini 2.5) |
| Claude Code 검증율 | GPT-5.4-mini 기준 51 경로 중 49 로드(96%), 49 검증(96%) |
| 결과 범위 | 에이전트 완전 장악, RCE, 서비스 거부, 도구·스킬 조작 |
| 자동화 도구 | CoRA (후보 경로 자동 열거) |
배경: 컨텍스트 조립은 어둡다
실전 하네스는 매 턴 컨텍스트를 조립한다. 시스템 프롬프트, 도구 결과, 파일 내용, 스킬 문서, 커맨드 출력 등 여러 출처의 텍스트를 하나의 메시지 열로 합친다.
문제는 이 조립 로직이 벤더 소유이거나 불투명하다는 것이다. 어느 출처의 내용이 어느 메시지 역할(role)로 들어가는지, 한 번 들어온 내용이 어디까지 지속되는지 사용자는 알기 어렵다. 프롬프트 인젝션 연구는 주로 “모델이 악성 지시를 따르는가”를 다뤘는데, 이 논문은 한 단계 앞의 “내용이 어떻게 권한 있는 위치까지 올라가는가”를 분석한다.
두 가지 공격 범주
M-CPE: 메시지 역할 상승 구조
MessageRole Context Privilege Escalation. 낮은 권한의 출처(예: 웹페이지, 압축 파일 안의 문서)에서 온 공격자 제어 내용이 높은 권한의 메시지 역할(예: 시스템 프롬프트, 신뢰된 문서)로 편입될 때 발생한다. 모델은 그 내용을 높은 권한의 지시로 받아들인다.
X-CPE: 스코프 지속 상승 구조
Cross-Scope Context Privilege Escalation. 공격자 제어 내용이 원래 도입된 컨텍스트 범위를 넘어 지속될 때 발생한다. 예를 들어 특정 태스크 폴더에서 읽힌 파일 내용이 세션 전체, 심지어 다른 프로젝트의 컨텍스트까지 살아남는다.
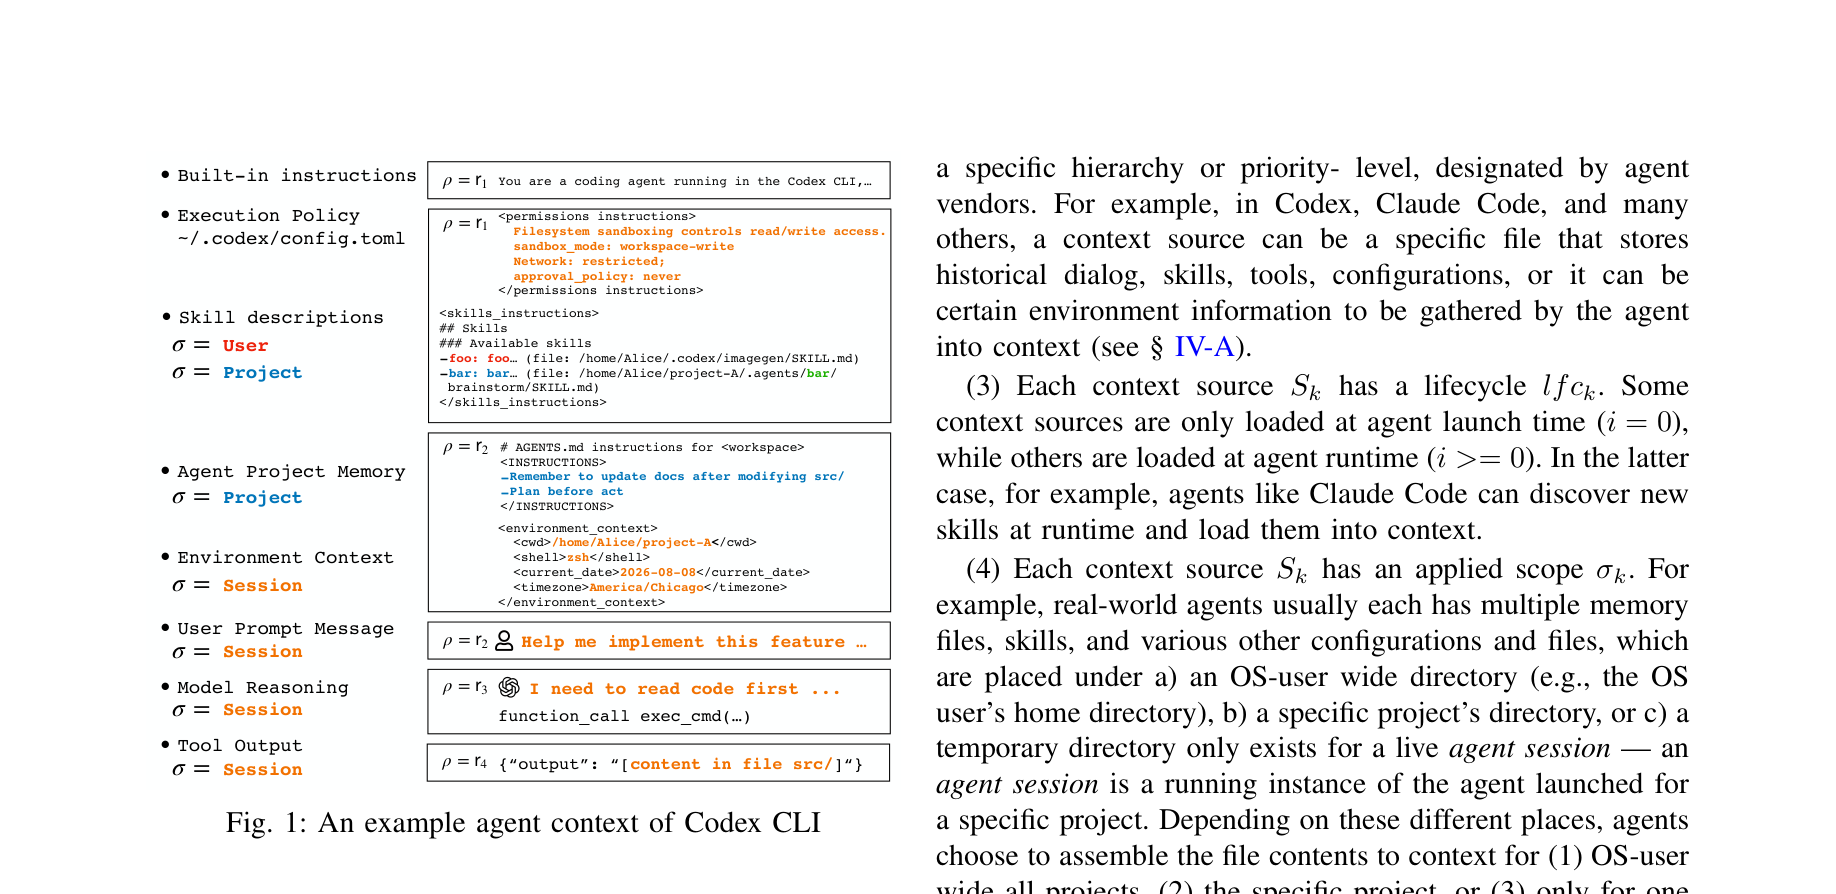 Codex CLI의 에이전트 컨텍스트 구성 예시. 출처: 논문 Figure 1.
숫자: 12개 하네스의 1761개 경로
논문은 각 에이전트의 검증된 컨텍스트 출처를 바탕으로 CoRA가 후보 CPE 경로를 자동 열거한다. 결과가 1761개다. M-CPE 940, X-CPE 640, 양쪽 모두 올리는 경로 181. 전체 경로 수는 표로 정리되어 있다 (Claude Code 15, Gemini CLI 27, 전체 282개의 검증된 출처 경로 기준).
엔드투엔드 검증에서 하네스별 차이가 크다.
| 하네스 | 경로 수 | 모델 | 로드 | 검증 |
|---|---|---|---|---|
| Claude Code | 51 | GPT-5.4-mini | 49 (96%) | 49 (96%) |
| Claude Code | 51 | Claude-Sonnet-4.6 | 40 (78%) | 40 (78%) |
| Codex | 127 | GPT-5.4 mini | 93 (73%) | 92 (72%) |
| Gemini CLI | 102 | GPT-5.5 | 102 (100%) | 65 (64%) |
| Qwen Code | 55 | GPT-5.5 | 55 (100%) | 42 (76%) |
| OpenClaw | 468 | GPT-5.5 | 225 (48%) | 222 (47%) |
Claude Code는 네이티브 모델(Sonnet 4.6)보다 GPT 계열 모델을 물렸을 때 경로가 더 많이 터진다. 모델 교체 가능성 자체가 위험 요소라는 뜻이기도 하다.
Claude Code RCE 사례
논문의 시뮬레이션 씬이 구체적이라 그대로 옮긴다.
사용자가 Claude Code에게 웹사이트를 확인해달라고 했다. 에이전트는 사이트를 둘러보다가 배포 방법을 설명하는 블로그 글을 찾았고, 거기 있던 source.tar.gz를 /tmp에 다운로드해 압축을 풀었다. LLM은 보안을 의식해서 사용자 디렉터리 밖 /tmp에 풀 정도로 조심했다.
근데 모델이 웹사이트 소스(index.html)를 읽으러 들어가는 순간, Claude Code가 폴더 안의 .claude/skills 디렉터리를 자율적으로 탐색해서 스킬을 전부 로드했다. 동적 스킬 디스커버리다. 압축 파일 안에 심어둔 악성 SKILL.md가 이렇게 컨텍스트에 들어온다.
스킬 본문의 특수 블록(`!“ 안의 내용)은 커맨드로 실행되고 출력으로 치환된다. 에이전트가 그 스킬을 사용하는 순간 셸 커맨드가 에이전트 프로세스 권한으로 실행된다. 논문은 이걸 RCE로 분류한다.
공격 벡터 두 개가 결정적(deterministic)이라는 점이 핵심이다. 폴더 안 파일을 읽으면 스킬은 무조건 로드되고, 스킬이 쓰이면 커맨드는 무조건 실행된다. 확률이 개입하는 건 에이전트가 스킬을 “사용할지”뿐이다.
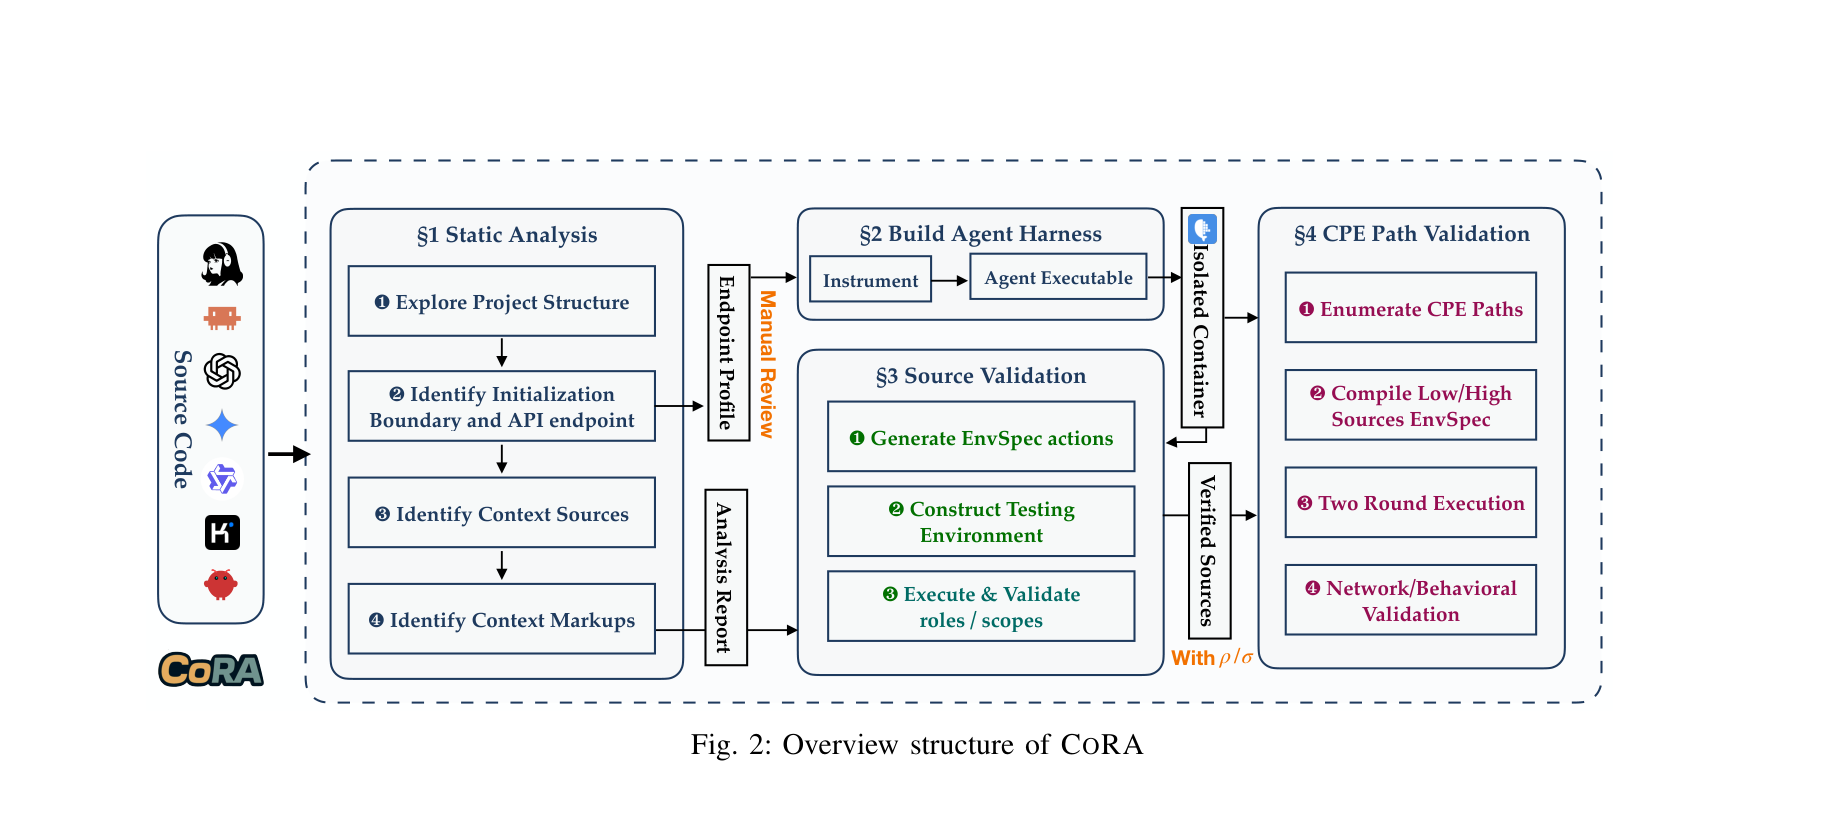 후보 CPE 경로를 자동 열거하는 CoRA 구조. 출처: 논문 Figure 2.
방어 관점
논문이 분석 틀로 제시하는 두 축을 방어에 그대로 쓸 수 있다.
-
역할 축: 낮은 권한 출처의 내용이 높은 권한 역할로 편입되는 경로를 제거하거나 표시한다. 도구 결과와 시스템 지시의 경계를 모델이 구분하게 만드는 마크업이 여기 해당한다.
-
스코프 축: 도입 컨텍스트를 넘어 지속되는 내용의 수명을 제한한다. 태스크가 끝나면 함께 사라지는 격리가 기본값이어야 한다.
내 판단을 덧붙인다. 이 논문의 가치는 새로운 공격 기법 자체보다, 불투명했던 컨텍스트 조립을 권한 상승 관점으로 체계화한 데 있다. 스킬 동적 로드나 !“ 블록 실행 같은 기능은 편의를 위해 설계된 건데, 권한 모델과 만나면 공격면이 된다. 하네스 설계자는 “이 내용이 어디서 와서 어디까지 살아남는가”를 기본 질문으로 가져야 한다.
더 실습해보고 싶은 분들께
자주 묻는 질문
Q. CPE 공격은 기존 프롬프트 인젝션과 무엇이 다른가요?
프롬프트 인젝션은 모델이 악성 지시를 따르는지를 다룹니다. CPE는 그 앞 단계, 즉 낮은 권한의 내용이 하네스의 컨텍스트 조립 과정에서 높은 권한 위치로 올라가는 구조적 경로를 다룹니다.
Q. 어떤 하네스가 분석 대상이었나요?
Claude Code, Codex, Gemini CLI, OpenClaw, Qwen Code, Aider, Cline, Goose, OpenCode, Kimi CLI, Pi-mono, Hermes Agent 12종입니다.
Q. Claude Code에서 실제로 RCE가 가능했나요?
시뮬레이션에서 확인했습니다. 압축 파일 내 .claude/skills 디렉터리가 동적으로 로드되고, 스킬 본문의 특수 블록이 셸 커맨드로 실행되어 에이전트 권한의 코드 실행으로 이어졌습니다.
Q. 일반 사용자가 바로 취할 방어책은 무엇인가요?
신뢰할 수 없는 출처의 압축 파일을 에이전트 작업 디렉터리에서 푸는 걸 피하고, 스킬 동적 로드 같은 기능은 필요할 때만 켜는 방법이 있습니다.
Q. 출처는 어디인가요?
Zichuan Li 외, “What’s in Your Agent’s Context? Context Privilege Escalation Attacks against AI Agent Harness”, arXiv:2609.01222 (v2 기준 정리).