결론 먼저
DualViewEval은 에이전트 벤치마크를 20개 작업으로 압축하면서도 전체 점수를 MAE 36% 오차로 예측하는 방법입니다. APEX-Agents와 BFCL에서 24배에서 40배 압축을 달성했고, 가장 강한 경쟁 대비 MAE를 14.528.2% 낮췄습니다.
기존 벤치마크 압축은 각 모델의 최종 점수 분포만 봤습니다. 근데 이 논문은 트라젝토리에서 뽑은 과정 신호 6개를 결과 행렬과 함께 씁니다. 핵심은 이겁니다.
같은 점수라도 도구를 어떻게 쓰는지는 다릅니다. 이 둘을 같이 보면 더 적은 작업으로 점수를 복원할 수 있다는 논리입니다.
기준일: 2026-09-16 arXiv 등록(2609.18909v1), Tencent 혼위안 팀 + 칭화대.
핵심 요약 표
| 항목 | 값 |
|---|---|
| 논문 | Beyond Outcomes: Dual-View Relational Learning for Efficient Agent Benchmarking (arXiv 2609.18909) |
| 소속 | Tencent Hunyuan, Tsinghua University |
| 문제 | 에이전트 벤치마크 전체 평가 비용·시간 과다 |
| 방법 | 결과 + 과정(트라젝토리) 관계 행렬을 융합해 미니셋 학습 |
| 압축 성능 | 작업 20개로 24배(BFCL)~40배(APEX-Agents) 압축 |
| MAE 개선 | 최강 경쟁 대비 14.5 |
| 사용 벤치마크 | BFCL, τ²-Bench, Terminal-Bench 2, SWE-bench Verified, APEX-Agents |
| 원문 | https://arxiv.org/abs/2609.18909 |
왜 벤치마크 압축이 필요한가
논문 Figure 1이 보여주는 숫자부터 보시면 됩니다. APEX-Agents를 GPT-5.4로 전부 돌리면 API 비용 약 7,100달러, Claude Opus 4.8은 약 10,900달러입니다. 평가 시간도 며칠 단위로 걸립니다.
| 모델 | APEX-Agents 전체 평가 API 비용 |
|---|---|
| GPT-5.4 | 약 $7.1K |
| Claude Opus 4.8 | 약 $10.9K |
| Gemini 3.5 Flash | 약 $5.3K |
| GLM-5.2 | 약 $2.4K |
LLM 벤치마크는 응답 하나만 보면 되니까 비용이 낮은데, 에이전트 벤치마크는 긴 훈(tool) 호출 루프 전체를 실행해야 해서 비용 구조가 다릅니다. 그래서 전체 작업 중 대표 소셋(미니셋)을 뽑아서 그걸로 전체 점수를 예측하는 벤치마크 압축이 자연스러운 해법이 됩니다.
근데 기존 압축 방법(Anchor Points, gp-IRT, TailoredBench, EssenceBench, SparseEval)의 공통 한계가 있습니다. 최종 점수의 작업-모델 분포만 모델링한다는 것. 에이전트 평가에서는 같은 결과가 완전히 다른 도구 사용 과정에서 나올 수 있는데, 이 정보를 버립니다.
과정 신호 6개: 트라젝토리에서 자동 추출
논문은 다섯 벤치마크의 오픈 트라젝토리를 분석해서, 벤치마크 공통으로 관측 가능한 통계 12개를 만들고 그중 6개를 선별합니다. 전부 자동 추출이 되고 서로 중복이 적은 것들입니다. 기준: 논문 Figure 2, 다섯 벤치마크 트라젝토리 실측.
| # | 측정값 | 의미 |
|---|---|---|
| 1 | Agent steps | 총 실행 스텝 수 |
| 2 | Tool failed rate | 도구 호출 중 에러 비율 |
| 3 | Tool-category entropy | 읽기/쓰기/검증 등 분포의 균형 |
| 4 | Validation-tool rate | 검증용 호출 비율 |
| 5 | Required-write execution | 쓰기 작업 요구 시 실제 수행 여부 |
| 6 | RWV closure | 읽고-쓰고-검증한 에피소드 비율 |
상관관계 분석(Figure 2)이 재밌는데요. Tool failed rate은 다섯 벤치마크 전부에서 점수와 음의 상관(-0.19 ~ -0.81)을 보였고, Validation-tool rate은 전부 양의 상관(+0.19 ~ +0.76)이었습니다. 즉 도구를 많이 실패하면 점수가 낮고, 검증을 많이 하면 점수가 높다는 게 여러 환경에서 일관되게 관측된 겁니다.
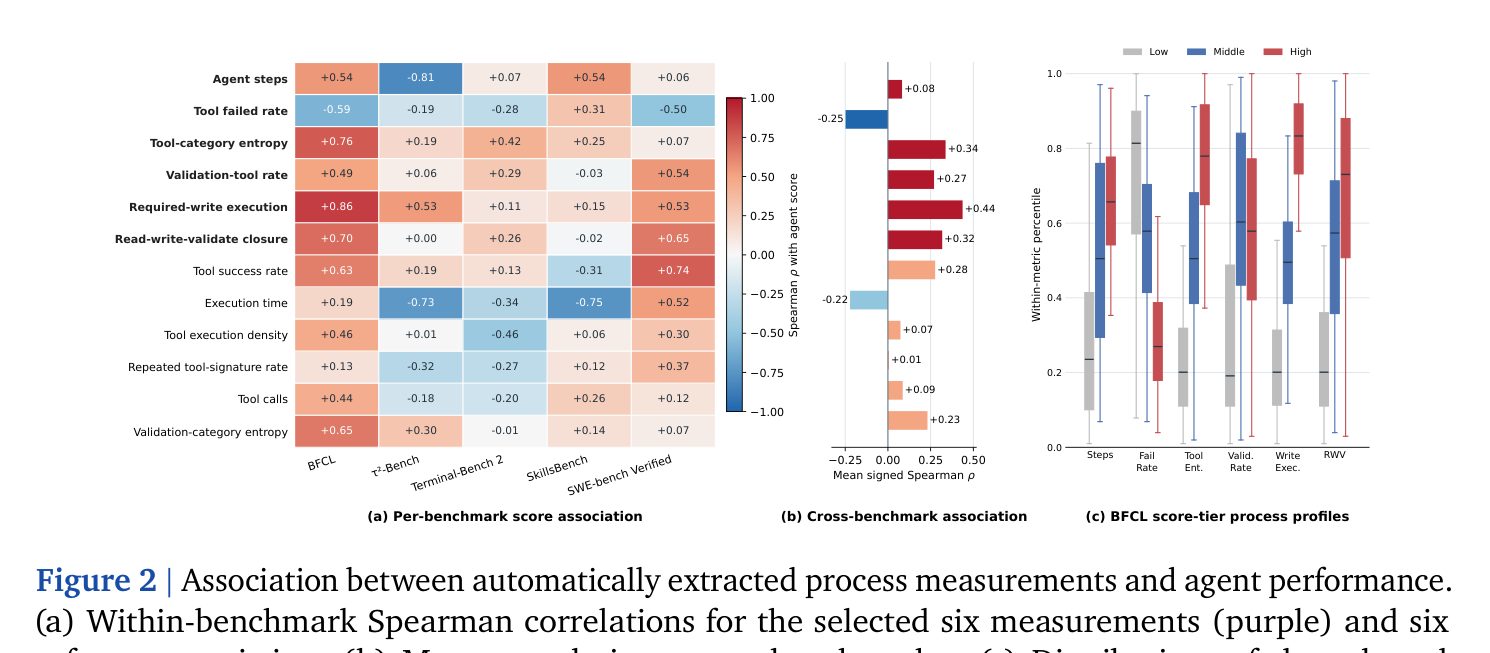
Figure 2 출처: arXiv 2609.18909, “Association between automatically extracted process measurements and agent performance”
방법: 두 관점을 하나의 커널로
DualViewEval 구조를 순서대로 보면 됩니다.
- 트라젝토리를 공통 이벤트 시퀀스로 파싱해서 각 에이전트별 6차원 과정 벡터를 만듭니다.
- 작업별로 두 개의 관계 행렬을 계산합니다. 결과 관계 행렬은 성공/실패 유사도, 과정 관계 행렬은 실행 패턴 유사도입니다.
- 두 행렬을 융합해 에이전트 커널을 만들고
K = (1/K)Σ(Ry + γ²Rp)로 합칩니다. γ는 학습되는 가중치구요. - 작업별 로짓을 학습해서 하드 Top-K로 정확히 K개의 미니셋을 유지합니다. 미분 불가 문제는 straight-through 게이트로 통과시킵니다.
- Kernel Ridge로 미니셋 실행 결과에서 전체 점수를 예측합니다. 손실은 점수 오차(Smooth-L1) + 순위 오차(쌍별 로지스틱)입니다.
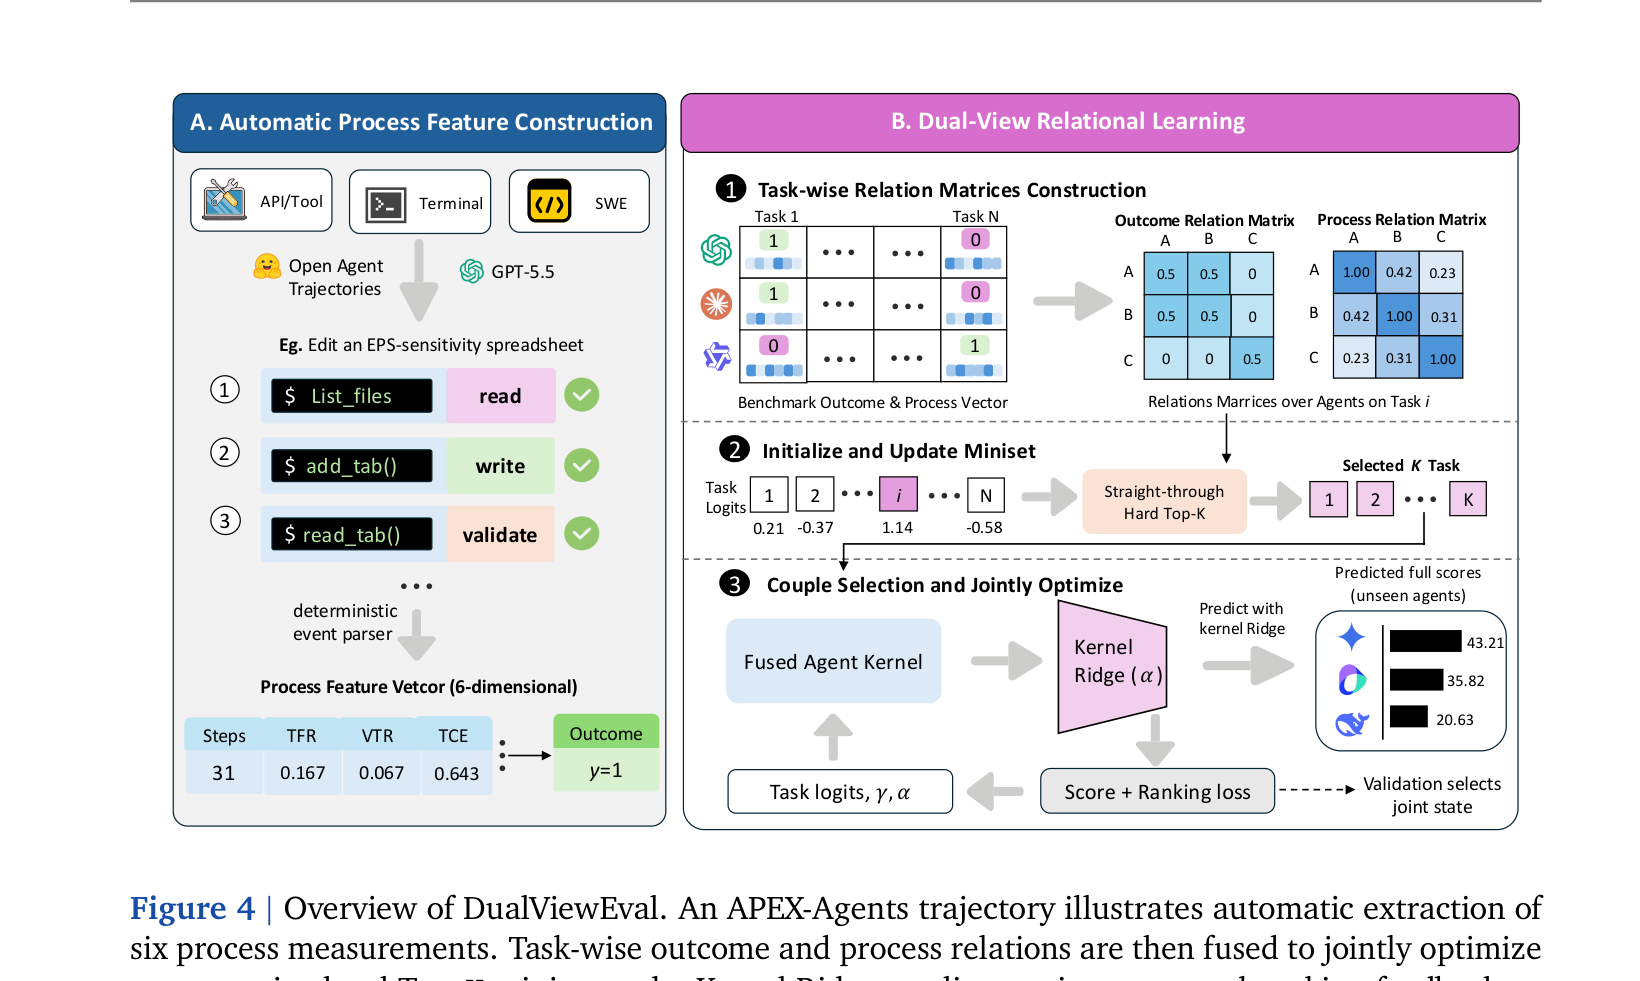
Figure 4 출처: arXiv 2609.18909, “Overview of DualViewEval”
선택과 예측이 하나의 피드백 루프로 묶여 있는 게 설계 포인트입니다. 예측 오차가 작아지는 방향으로 미니셋 구성원이 바뀌고, 바뀐 미니셋으로 다시 예측을 학습합니다. 자기 예측 보상을 막으려고 학습 에이전트를 5-fold로 나눠서 out-of-fold 예측만 최적화합니다.
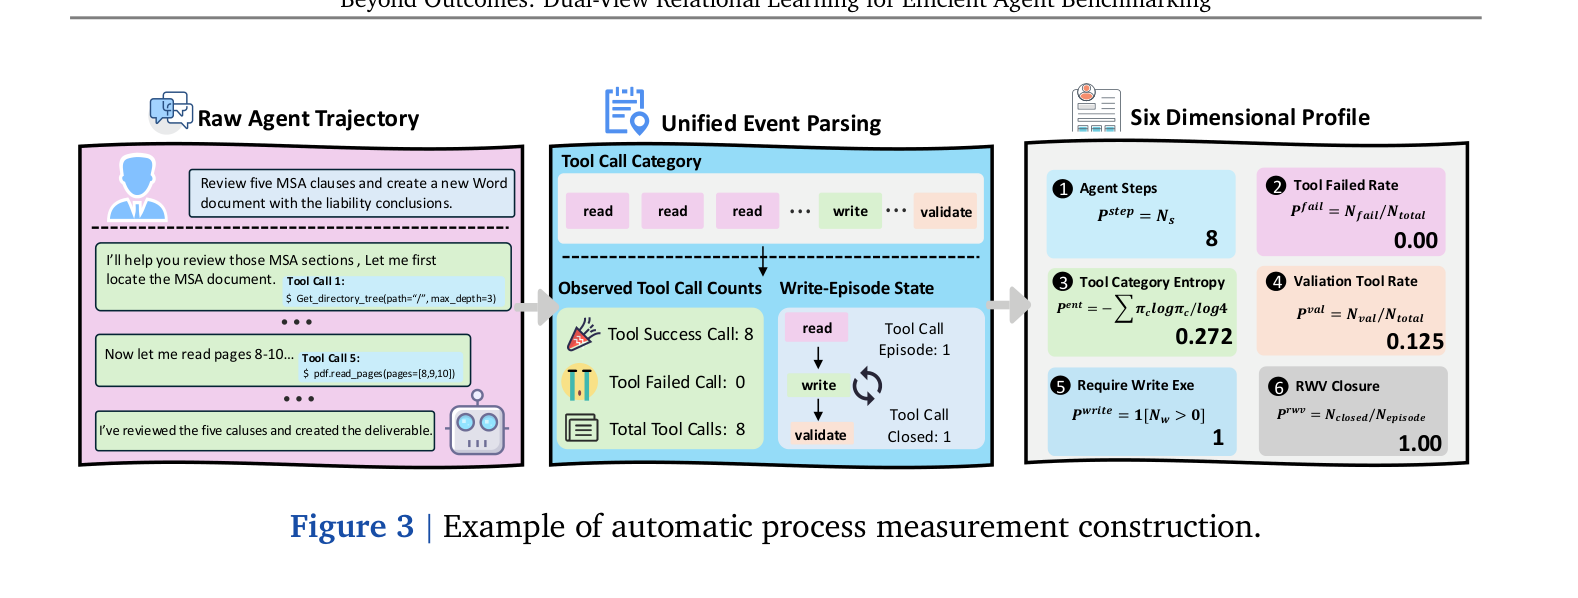
Figure 3 출처: arXiv 2609.18909, MSA 문서 검토 트라젝토리의 6차원 프로파일 예시
성능: 다섯 벤치마크 전부 최고
데이터 규모부터 보시면 됩니다.
| 벤치마크 | 작업 수 | 에이전트 수 | 결과 쌍 |
|---|---|---|---|
| BFCL | 800 | 109 | 87,200 |
| τ²-Bench | 114 | 18 | 8,208 |
| Terminal-Bench 2 | 89 | 73 | 6,497 |
| SWE-bench Verified | 500 | 36 | 18,000 |
| APEX-Agents | 480 | 26 | 12,480 |
메인 결과(Table 2)에서 DualViewEval은 다섯 벤치마크 전부에서 1등입니다. 예산 2060 작업 세 구간에서 일관되게 우위를 보였고요. SparseEval(가장 비슷한 예측 기반 베이스라인) 대비 평균 MAE를 30.545.1% 줄였고 평균 Kendall τ를 0.089~0.115 올렸습니다.
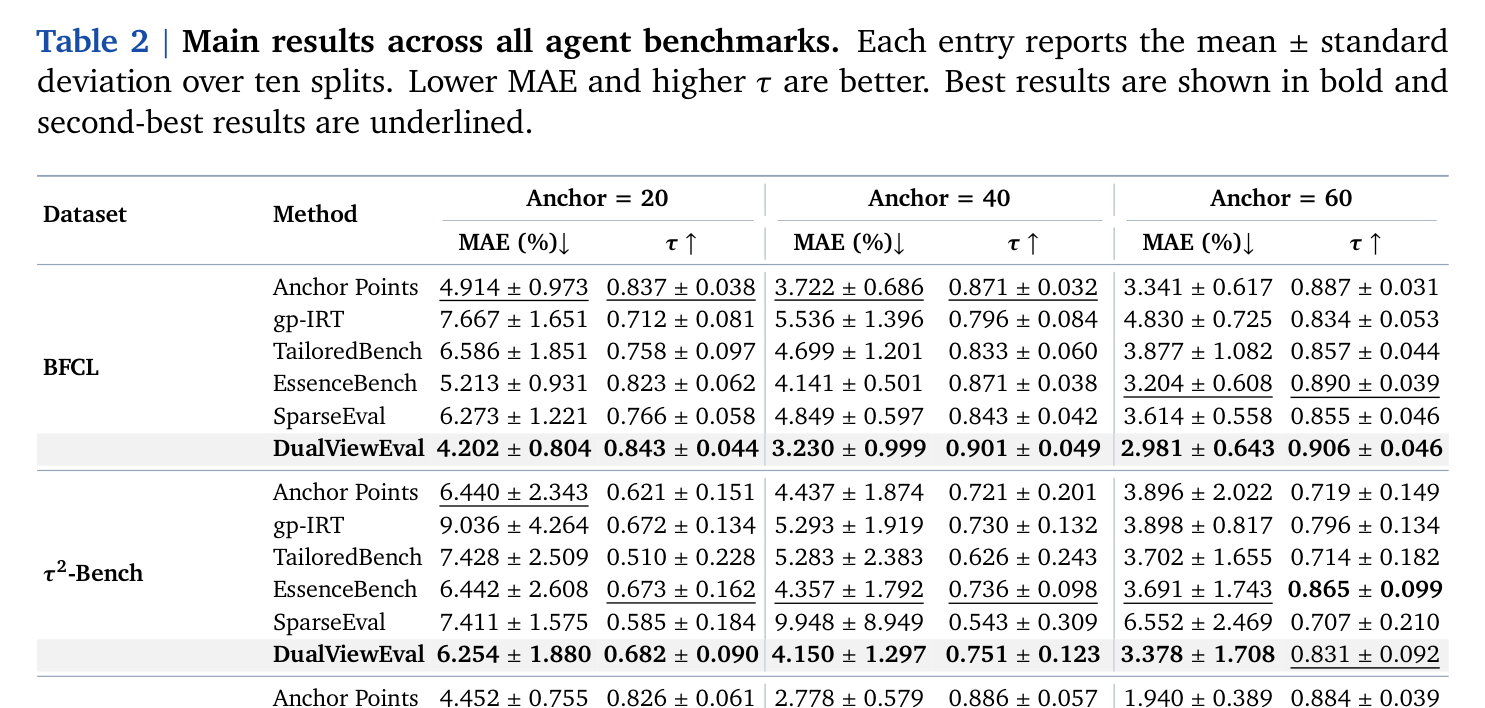
Table 2 출처: arXiv 2609.18909, ten-split 평균 ± 표준편차
주요 숫자만 정리하면:
| 벤치마크 | 미니셋 20에서의 MAE | τ |
|---|---|---|
| BFCL | 4.20% | 0.843 |
| τ²-Bench | 6.25% | 0.682 |
| Terminal-Bench 2 | 2.94% | 0.844 |
| SWE-bench Verified | 3.7~5.8% | 0.66~0.82 |
| APEX-Agents | 4.2~5.3% | 0.77~0.83 |
에일리어션에서 두 관점 중 하나만 빼는 실험도 돌았는데, 결과 관계·과정 관계 둘 다 있을 때 최고 성능이라는 게 확인됐습니다. 과정 신호는 예산이 커져도 계속 정보를 추가로 제공합니다. 극단적으로 작은 예산만 보정하는 효과로 끝나지 않는다는 뜻입니다.
쓸모 있는 지점과 한계
실무적으로 바로 닿는 부분:
- 자체 에이전트를 자주 평가하는 팀이라면 미니셋 20개로 회귀 테스트를 돌리고 전체 벤치마크는 주기적으로만 돌리는 구성이 가능합니다. 비용 관점에서 유리합니다.
- Tool failed rate·Validation-tool rate 같은 지표는 벤치마크 압축과 무관하게 에이전트 품질 모니터링 지표로 그대로 가져갈 만합니다.
- 선택된 미니셋이 어떤 에이전트가 어떤 작업에서 강한지 진단 피드백을 줍니다.
한계도 적어둡니다:
- 학습에는 기존 에이전트들의 결과 행렬과 트라젝토리가 필요합니다. 완전 새 환경에 바로 적용하는 건 아닙니다.
- τ²-Bench처럼 에이전트 수가 18개로 적으면 τ 편차가 큽니다(Table 2 ±0.090~0.123).
- 6개 과정 신호가 도구 호출 기반이라, 도구를 안 쓰는 순수 추론 에이전트에는 마스킹됩니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
미니셋만 실행하고 전체 점수는 Kernel Ridge로 예측합니다. 다섯 벤치마크에서 MAE 3~6% 수준 오차를 보였습니다.
- 미니셋만 돌려도 되나요? — 네, MAE 3~6% 오차로 전체 점수를 예측합니다.
- 과정 신호 6개는 어떻게 뽑나요? — 트라젝토리를 공통 이벤트 시퀀스로 파싱해서 스텝 수, 도구 실패율, 도구 카테고리 엔트로피, 검증 비율, 쓰기 수행, RWV 클로저를 자동 계산합니다.
- 기존 벤치마크 압축과 다른 점은 뭔가요? — 기존 방법은 최종 점수 분포만 씁니다. DualViewEval은 결과 관계 행렬에 트라젝토리 기반 과정 관계 행렬을 더해 융합 커널을 학습합니다.
- 코드는 공개됐나요? — 논문 본문에서 코드 링크를 확인하지 못했습니다. arXiv 페이지에서 최신 상태를 확인하시면 됩니다.
참고
- 원문: Guo et al., “Beyond Outcomes: Dual-View Relational Learning for Efficient Agent Benchmarking”, arXiv:2609.18909 (2026-09-16)
- 비교 대상: Anchor Points (Vivek et al., 2024), gp-IRT (Polo et al., 2024), TailoredBench (Yuan et al., 2025), EssenceBench (Wang et al., 2026), SparseEval (Zhang et al., 2026)
- 벤치마크: BFCL, τ²-Bench, Terminal-Bench 2, SWE-bench Verified, APEX-Agents