결론 먼저
SWE-bench Verified 상위권의 순위는 통계적으로 읽히지 않습니다. 구분되는 쌍이 0개입니다. 1등과 2등이 각각 500개 중 396개를 푸는데, 그 차이가 우연인지 아닌지 데이터가 판정해주지 못해요.
이건 254개 공개 제출 결과를 전수 검증한 감사 논문(arXiv 2609.17394)의 결론입니다. 핵심은 이겁니다. 우열을 말하는 시대는 끝났고, 티어(tier)와 유효 비교 크기(n_eff)를 함께 봐야 합니다.
핵심 수치 정리
논문이 SWE-bench 공개 데이터(2026-07-30 기준, 모델 재실행 없이 제출 결과만 사용)에서 뽑은 숫자입니다.
| 항목 | 값 |
|---|---|
| 분석 대상 | 4개 스플릿 254개 제출 (Verified 134개) |
| Verified 상위 2개 공동 해결 | 378개 / 500개 |
| 상위 10개 공동 해결 / 공동 실패 / 구분 가능 | |
| 상위 2개를 구분하는 인스턴스 | |
| 프론티어 중첩 계수(nesting) | |
| 모델 내 하네스(scaffold) 점수 폭 | |
| 인접 쌍 구분 (Verified) | 0 / 29 |
| 인접 쌍 구분 (Test 스플릿, 2,294개) | 14 / 23 |
순위가 안 읽히는 이유: 같은 문제를 같이 푼다
원인은 단순합니다. 상위 에이전트들이 같은 문제를 같이 풀고 같은 문제를 같이 실패해요.
- 상위 10개가 전부 푸는 285개, 전부 실패하는 51개는 순위 비교에 기여하지 못합니다. 남는 건 164개뿐이에요.
- 상위 2개만 놓으면 구분 인스턴스는 36개까지 줄어듭니다. 500문제 리더보드의 실효 비교 집합이 36문제짜리 시험이 된 셈이죠.
- 해결 집합이 보완적이지도 않습니다. 중첩 계수 0.935는 약한 시스템이 푼 문제의 93.5%를 강한 시스템도 푼다는 뜻이에요. 점수만 놓고 기대되는 0.774보다 훨씬 높아서, 특화 영역이 거의 없다는 신호입니다.
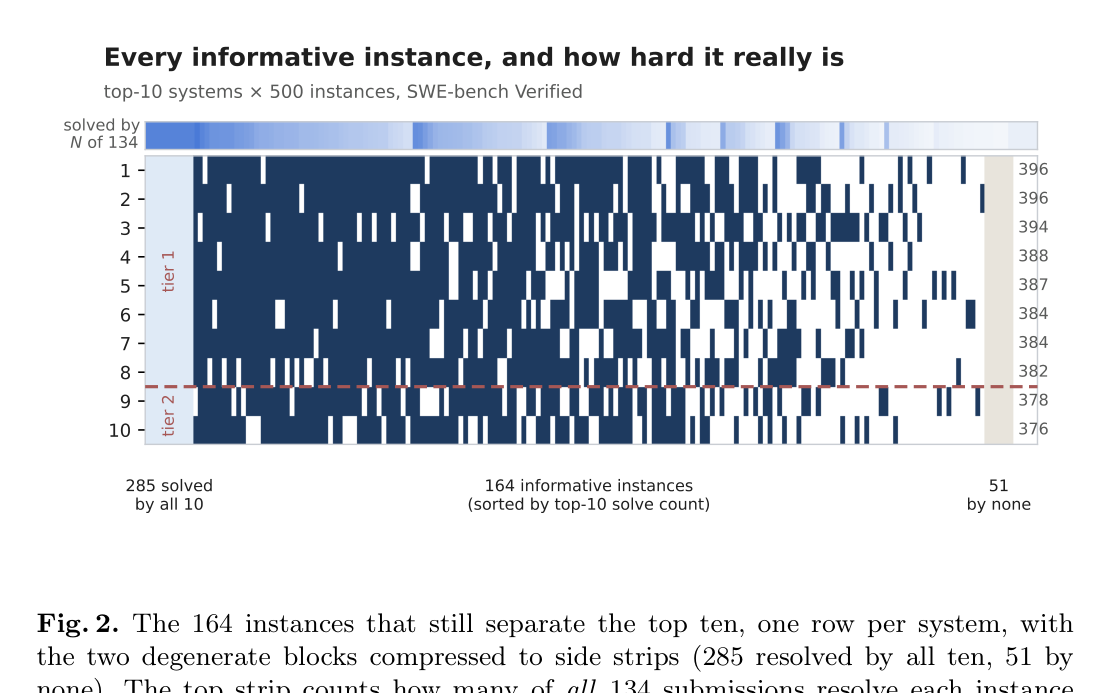
논문 Figure 2입니다. 시스템별로 어떤 인스턴스가 구분력을 갖는지 하나씩 보여주는데, 대부분의 행이 동일한 패턴으로 채워집니다.
하네스가 모델보다 크게 흔든다
더 불편한 발견이 있어요. 점수가 모델만의 속성이 아니라는 것.
- 점수 폭이 최대 29.8pp 벌어집니다. 상위 30위 전체 스프레드(8.8pp)의 3배가 넘는 값이에요.
- 하네스 우열이 모델에 따라 뒤집힙니다. epam-ai-run은 Claude 3.5 Sonnet에서 sweagent를 95개 앞서는데, 모델을 바꾸면 부호가 반대로 돌아서는 조합도 있습니다(Holm 보정 p<0.001).
- 메타데이터가 엉망이라 검증도 어렵습니다. 단일 모델 태그가 있는 건 61개(46%)뿐, claude-sonnet-4와 claude-4-sonnet 같은 표기가 뒤섞여 있어서 저자들이 손으로 정규화했다고 해요.
정리하면 리더보드의 숫자는 모델 단독의 성적이 아니라 모델×하네스 쌍의 성적입니다. 순위를 모델 선택에 쓰고 싶다면 이 사실부터 받아들여야 합니다.
대안: 티어와 유효 비교 크기
논문이 내놓는 대안은 두 가지입니다.
- 티어로 묶어서 공개. 리더와의 비교에서 p≥0.05면 같은 티어로 묶는 규칙을 적용하면 3개 티어(8/12/10개)로 압축됩니다. Holm 보정을 하면 2개 티어가 되구요. 티어 내 동등성 증명은 아니라는 점을 저자들도 명시합니다.
- n_eff(유효 비교 크기) 공개. 전체 134개 제출에서는 n_eff/n = 0.94로 건강해 보이는 벤치마크가, 0.33, 상위 2개는 0.07로 무너집니다. 이 비교 집합에서 몇 개 문제가 실제로 구분력을 갖는지를 함께 공개하자는 제안이에요.
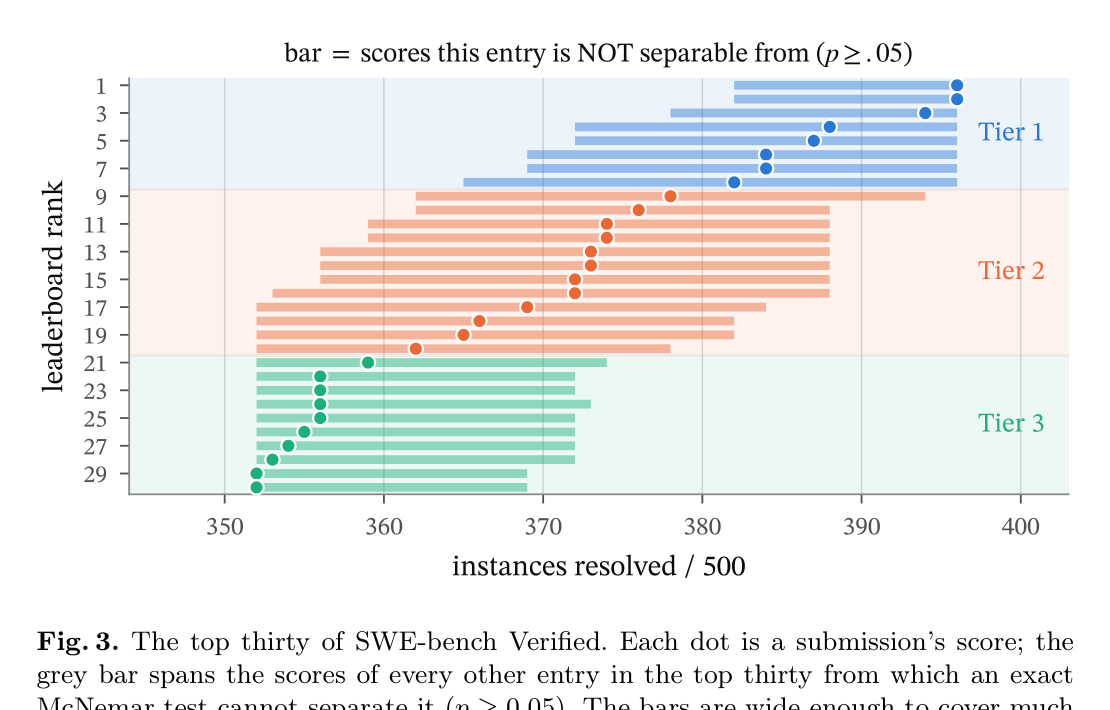
각 점이 제출 점수이고, 회색 바는 McNemar 검정으로 구분되지 않는 점수 구간입니다. 바가 표의 대부분을 덮어버립니다.
문제 추가만으로 해결되지 않는 이유
직관적 해법 두 개를 논문이 직접 테스트했는데 둘 다 통과하지 못했어요.
- 기존 문제 은퇴(retirement). 전원이 푸는 285개를 빼고 재채점하면 점수 스프레드가 8.8pp에서 18.7pp로 벌어지고 인접 3쌍의 순서가 뒤집히는데, 구분 가능 쌍은 여전히 0/29입니다. 짝검정은 원래 양쪽이 동의하는 인스턴스를 무시하거든요. 평가 비용 절감 효과는 있어도 분해능은 안 생깁니다.
- 비슷한 문제 추가. 중첩된 해결 구조에서는 같은 성격의 문제를 더해도 구분 없는 인스턴스만 늘어납니다. 상위 인접 쌍을 분리하려면 약 26,000개(중앙값 기준 52배)가 필요한데, 한쪽으로 기우는 불일치 문제라면 약 900개로 충분합니다. 몇 개를 추가할지보다 중첩을 깨는 문제인지가 선별 기준이 되어야 해요.
내부 벤치마크를 만드는 팀을 위한 체크리스트
논문 6.2절이 실무용으로 좋아서 옮겨둡니다.
- 배포할 (모델, 자기 하네스) 쌍을 직접 평가하세요. 외부 모델 순위를 이식하지 않는 걸 권합니다.
- 벤치마크 크기를 의사결정에 맞추세요. 감지 가능 차이는 약 17pp입니다. 작은 스위트로 2pp를 가리려 하지 않는 게 좋아요.
- 후보별 n_eff를 추적하세요. 전원이 통과하는 과제는 구분력이 없습니다.
- 에이전트 자기 보고에서 판정을 읽지 마세요. patch와 그레이더의 구조화 리포트에서 읽어야 합니다.
- 타임아웃을 실패로 세을지 제외할지 미리 정하고 둘 다 공개하세요.
- 의사결정자에게는 순위표 대신 티어 + 티어별 비용·지연시간을 보고하세요.
한계
- 관찰 연구라 하네스 효과를 인과적으로 분리하지 못합니다. 54% 제출은 팩토리얼 배치 자체가 불가능했어요.
- 제출당 실행 1회라 실행 간 변동성이 구분되지 않습니다.
- SWE-bench 패밀리 하나에 대한 감사입니다. 다른 리더보드에 같은 규모가 성립한다고 주장하지 않아요.
- 티어가 동등함의 증명은 아니라는 점을 논문이 반복해서 강조합니다.
자주 묻는 질문
SWE-bench 자체가 잘못된 벤치마크인가요? 아니에요. 넓은 능력 범위에서는 여전히 많은 차이를 잡아내고, 모든 제출의 인스턴스별 판정을 공개하는 관행이 이 감사를 가능하게 했습니다. 문제는 상위권을 1위부터 8위까지 정밀하게 읽는 방식이 데이터의 분해능을 초과한다는 것입니다.
그럼 코딩 에이전트는 어떻게 골라야 하나요? 배포 조합(모델+하네스)을 자기 작업으로 직접 평가하고, 결과를 티어 단위로 보고, 비용·지연시간과 함께 의사결정하는 게 논문의 권고입니다.
순위가 안 읽히게 된 원리가 뭔가요? 수렴(convergence)입니다. 중첩 계수 0.935로 거의 포함 관계에 가깝고, 특화·보완성이 남아 있지 않아 비교 집합의 유효 크기만 줄어듭니다.
이 감사는 모델을 다시 돌렸나요? 아니에요. 리더보드가 이미 공개하는 인스턴스별 판정 행렬과 메타데이터만 사용했고, 재현 패키지를 GitHub(Adkid-Zephyr/resolution-audit)로 공개했습니다.
더 실습해보고 싶은 분들께
벤치마크 숫자 너머에서 에이전트를 직접 굴려보고 싶다면 두 자료를 추천합니다.
출처
- 논문: Coding Agents Have Converged: Why the SWE-bench Leaderboard Can No Longer Order Its Top Entries, and What to Measure Instead (arXiv 2609.17394, 2026-09-15 공개, Imperial College London 등)
- arXiv: https://arxiv.org/abs/2609.17394
- 재현 코드: https://github.com/Adkid-Zephyr/resolution-audit
- 리더보드 기준일: 2026-07-30 (논문 분석 매니페스트 고정)
- 본문 수치는 모두 논문 Tables 2
5, Figures 24 기준입니다.