결론 먼저
핵심은 이겁니다. 롱호라이즌 LLM 에이전트의 오류가 독립적으로 흩어져 나오지 않고, 모래산 붕괴처럼 스트레스가 쌓인 뒤 한 번에 몰리는 폭발(avalanche) 형태로 발생합니다. 그리고 각 행동이 국소적으로 유효해 보여도 내부 세계 모델은 이미 무너져 있을 수 있습니다.
World Model Science 논문(Song & Cai, 2026)은 이걸 통제된 실험으로 잡아냈습니다. 최종 보상 대신 궤적(trajectory) 단위의 동역학 진단을 쓰면, 에이전트가 “언제, 어떻게” 무너지는지 측정할 수 있다는 얘기입니다.
논문 개요
| 항목 | 내용 |
|---|---|
| 제목 | World Model Science: Self-Organized Criticality, Weak Chaos, and Metastable Belief Dynamics in Long-Horizon LLM Agents |
| 저자 | Xinyuan Song (Emory University), Zekun Cai (University of Tokyo / LocationMind) |
| arXiv | 2609.17419 (2026-07-12) |
| 코드 | github.com/Hik289/agent-self-organized-criticality |
| 실험 규모 | 22개 실험, StatefulPuzzle / τ-bench / API-Bank / ToolLLM / StableToolBench / HotpotQA / ALFWorld / GAIA / Game of Life |
| 기준일 | 2026-09-16 기준, v1 기준 정리 |
이 논문의 측정 대상은 은닉 활성값이 아닙니다. 로그에서 뽑은 상태 벡터(진행도, 믿음, 제약, 불확실성, 위험, 메모리, 계획)를 벤치마크 정답 상태와 정렬해서 “에이전트가 믿는 세계”와 “실제 세계”의 간극을 재는 겁니다.
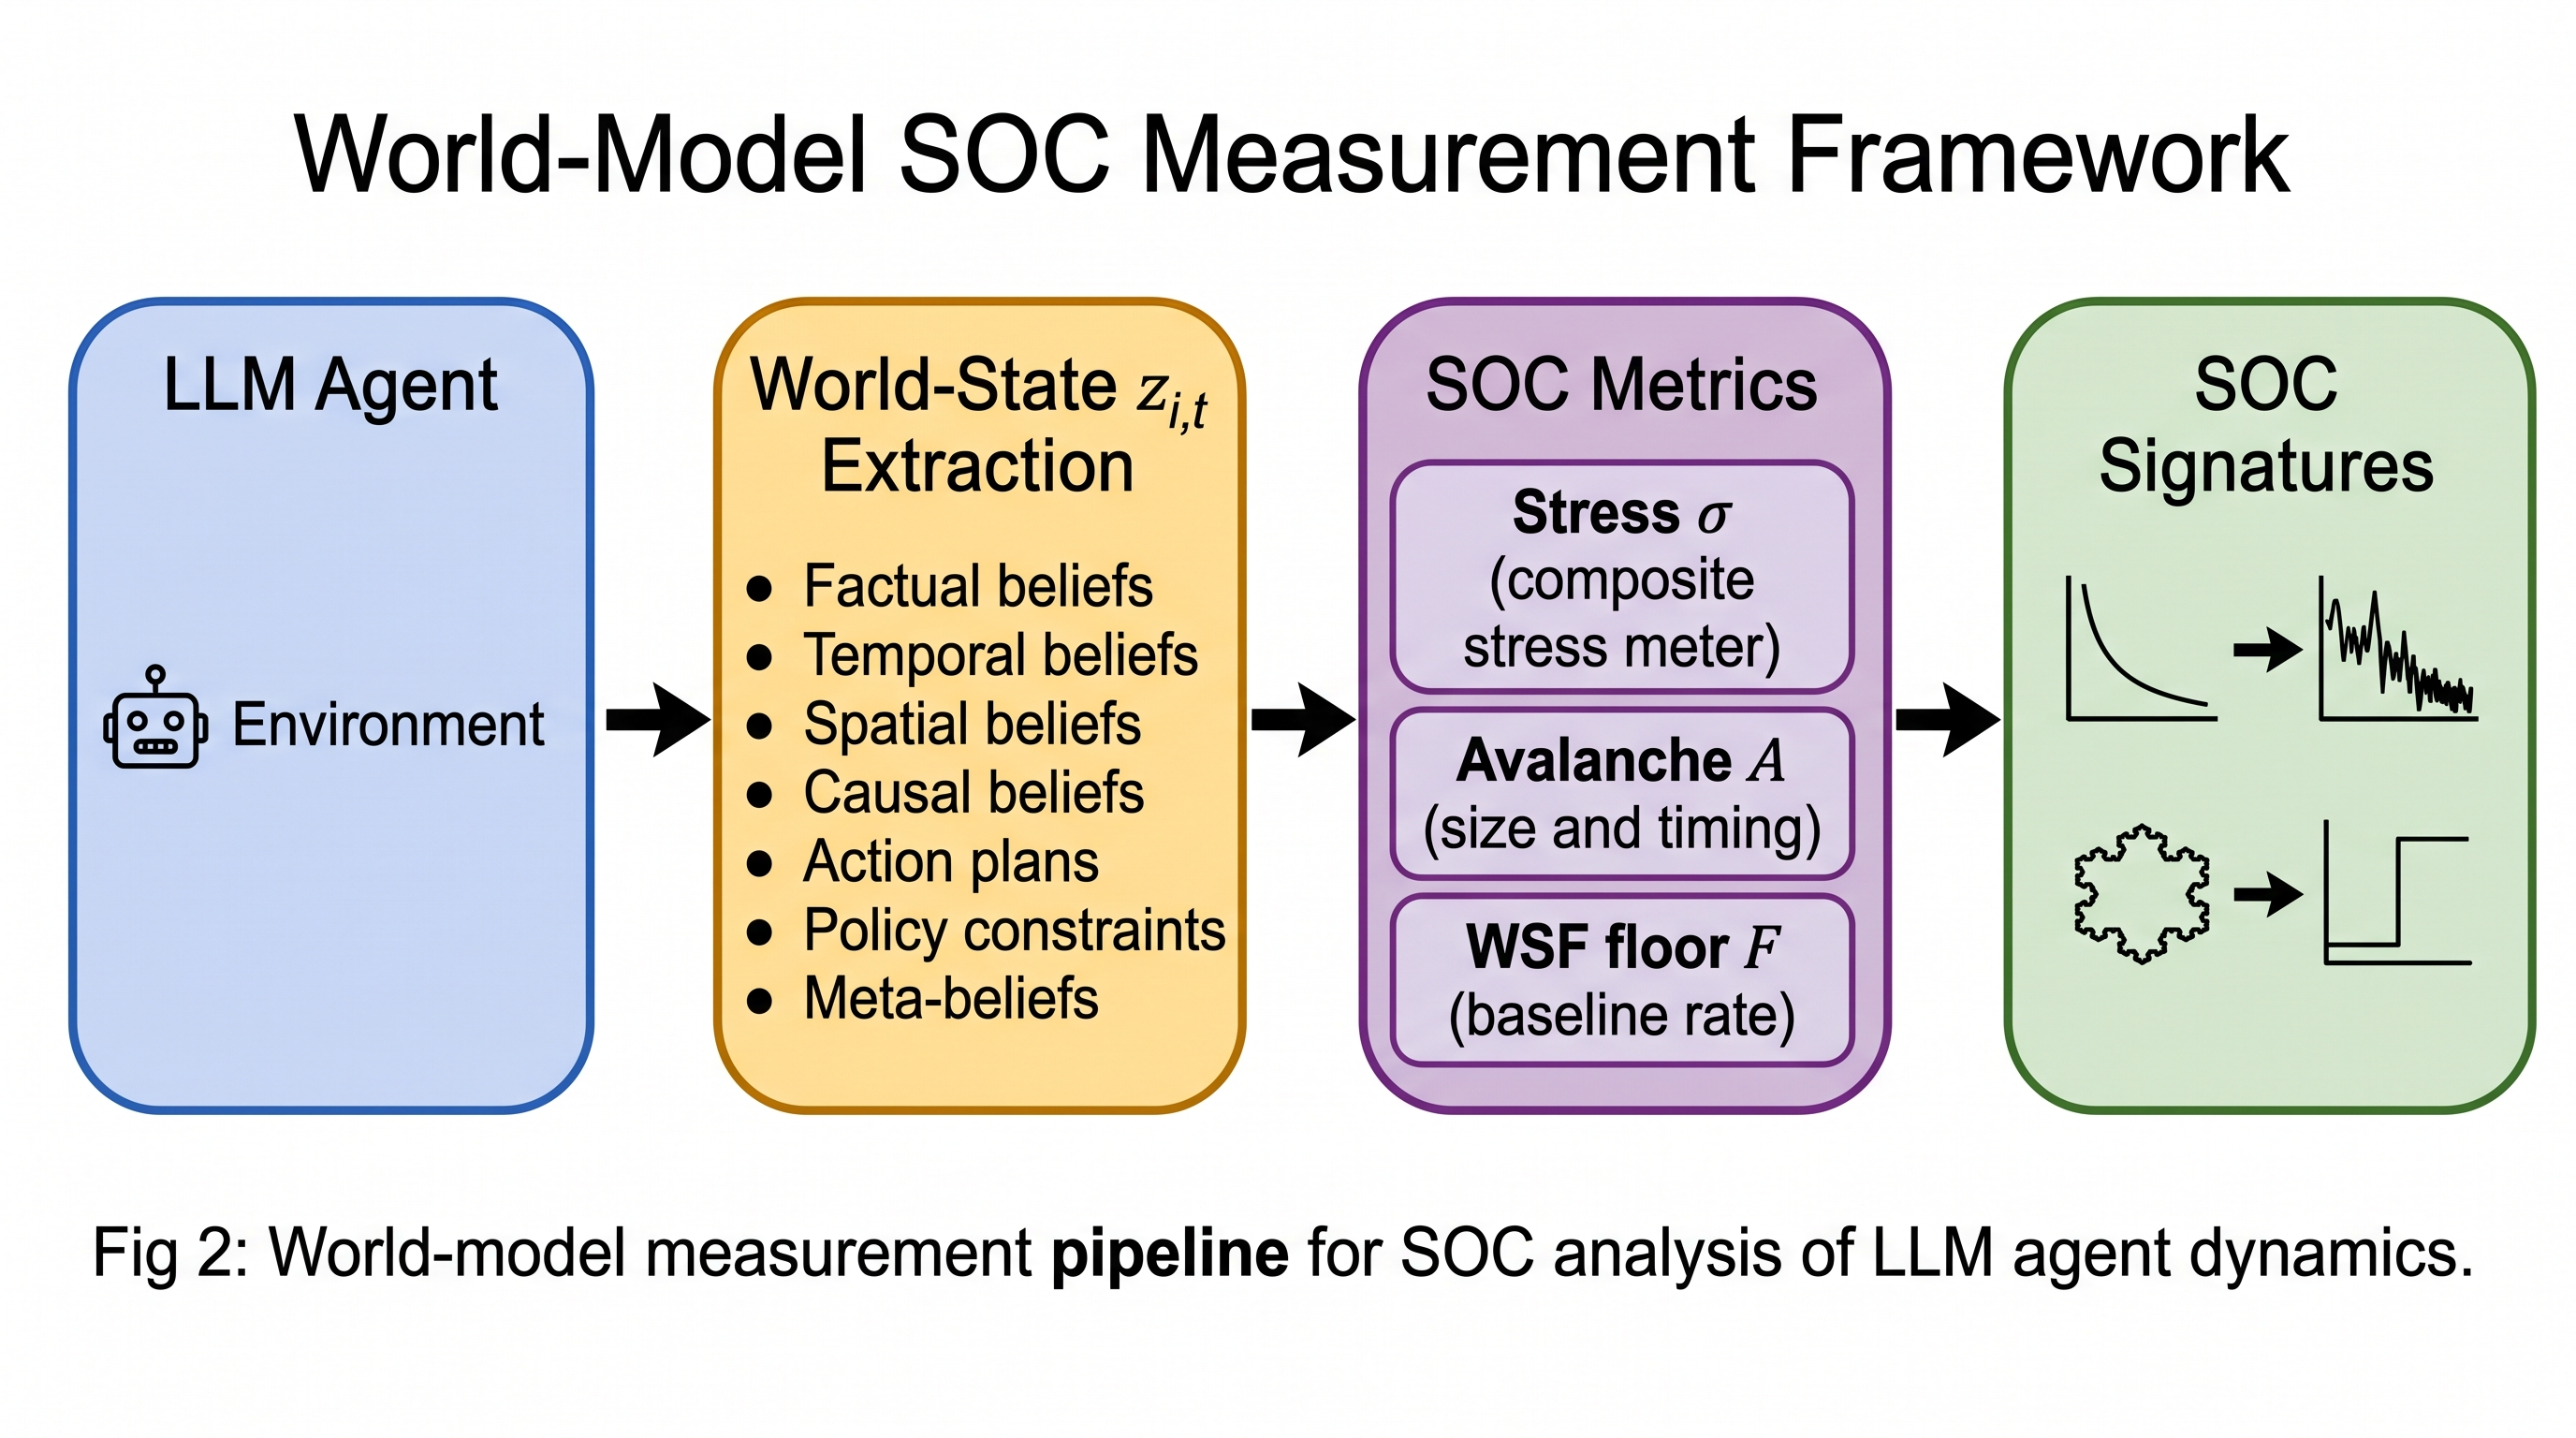 그림 2. 궤적 → 측정된 세계 상태 → 스트레스 성분 → 오류 폭발 → 통계적 시그니처로 이어지는 진단 파이프라인 (출처: 논문 Figure 2)
왜 모래산인가: SOC 프레임
모래알을 하나씩 쌓으면 산이 자라다가, 어느 순간 작은 알 하나에 사면 전체가 무너집니다. 자기조직화 임계성(self-organized criticality, SOC)의 고전 그림입니다.
저자들은 에이전트도 똑같은 구조라고 봅니다.
- 도구 에이전트는 검증 안 된 변경, 실패한 호출, 정책 제약을 계속 쌓습니다(느린 구동).
- 검색 에이전트는 증거와 반증거, 가설을 쌓습니다.
- 각 행동은 하나하나 보면 문제가 없는데, 잠재 상태는 이미 어긋나 있을 수 있습니다.
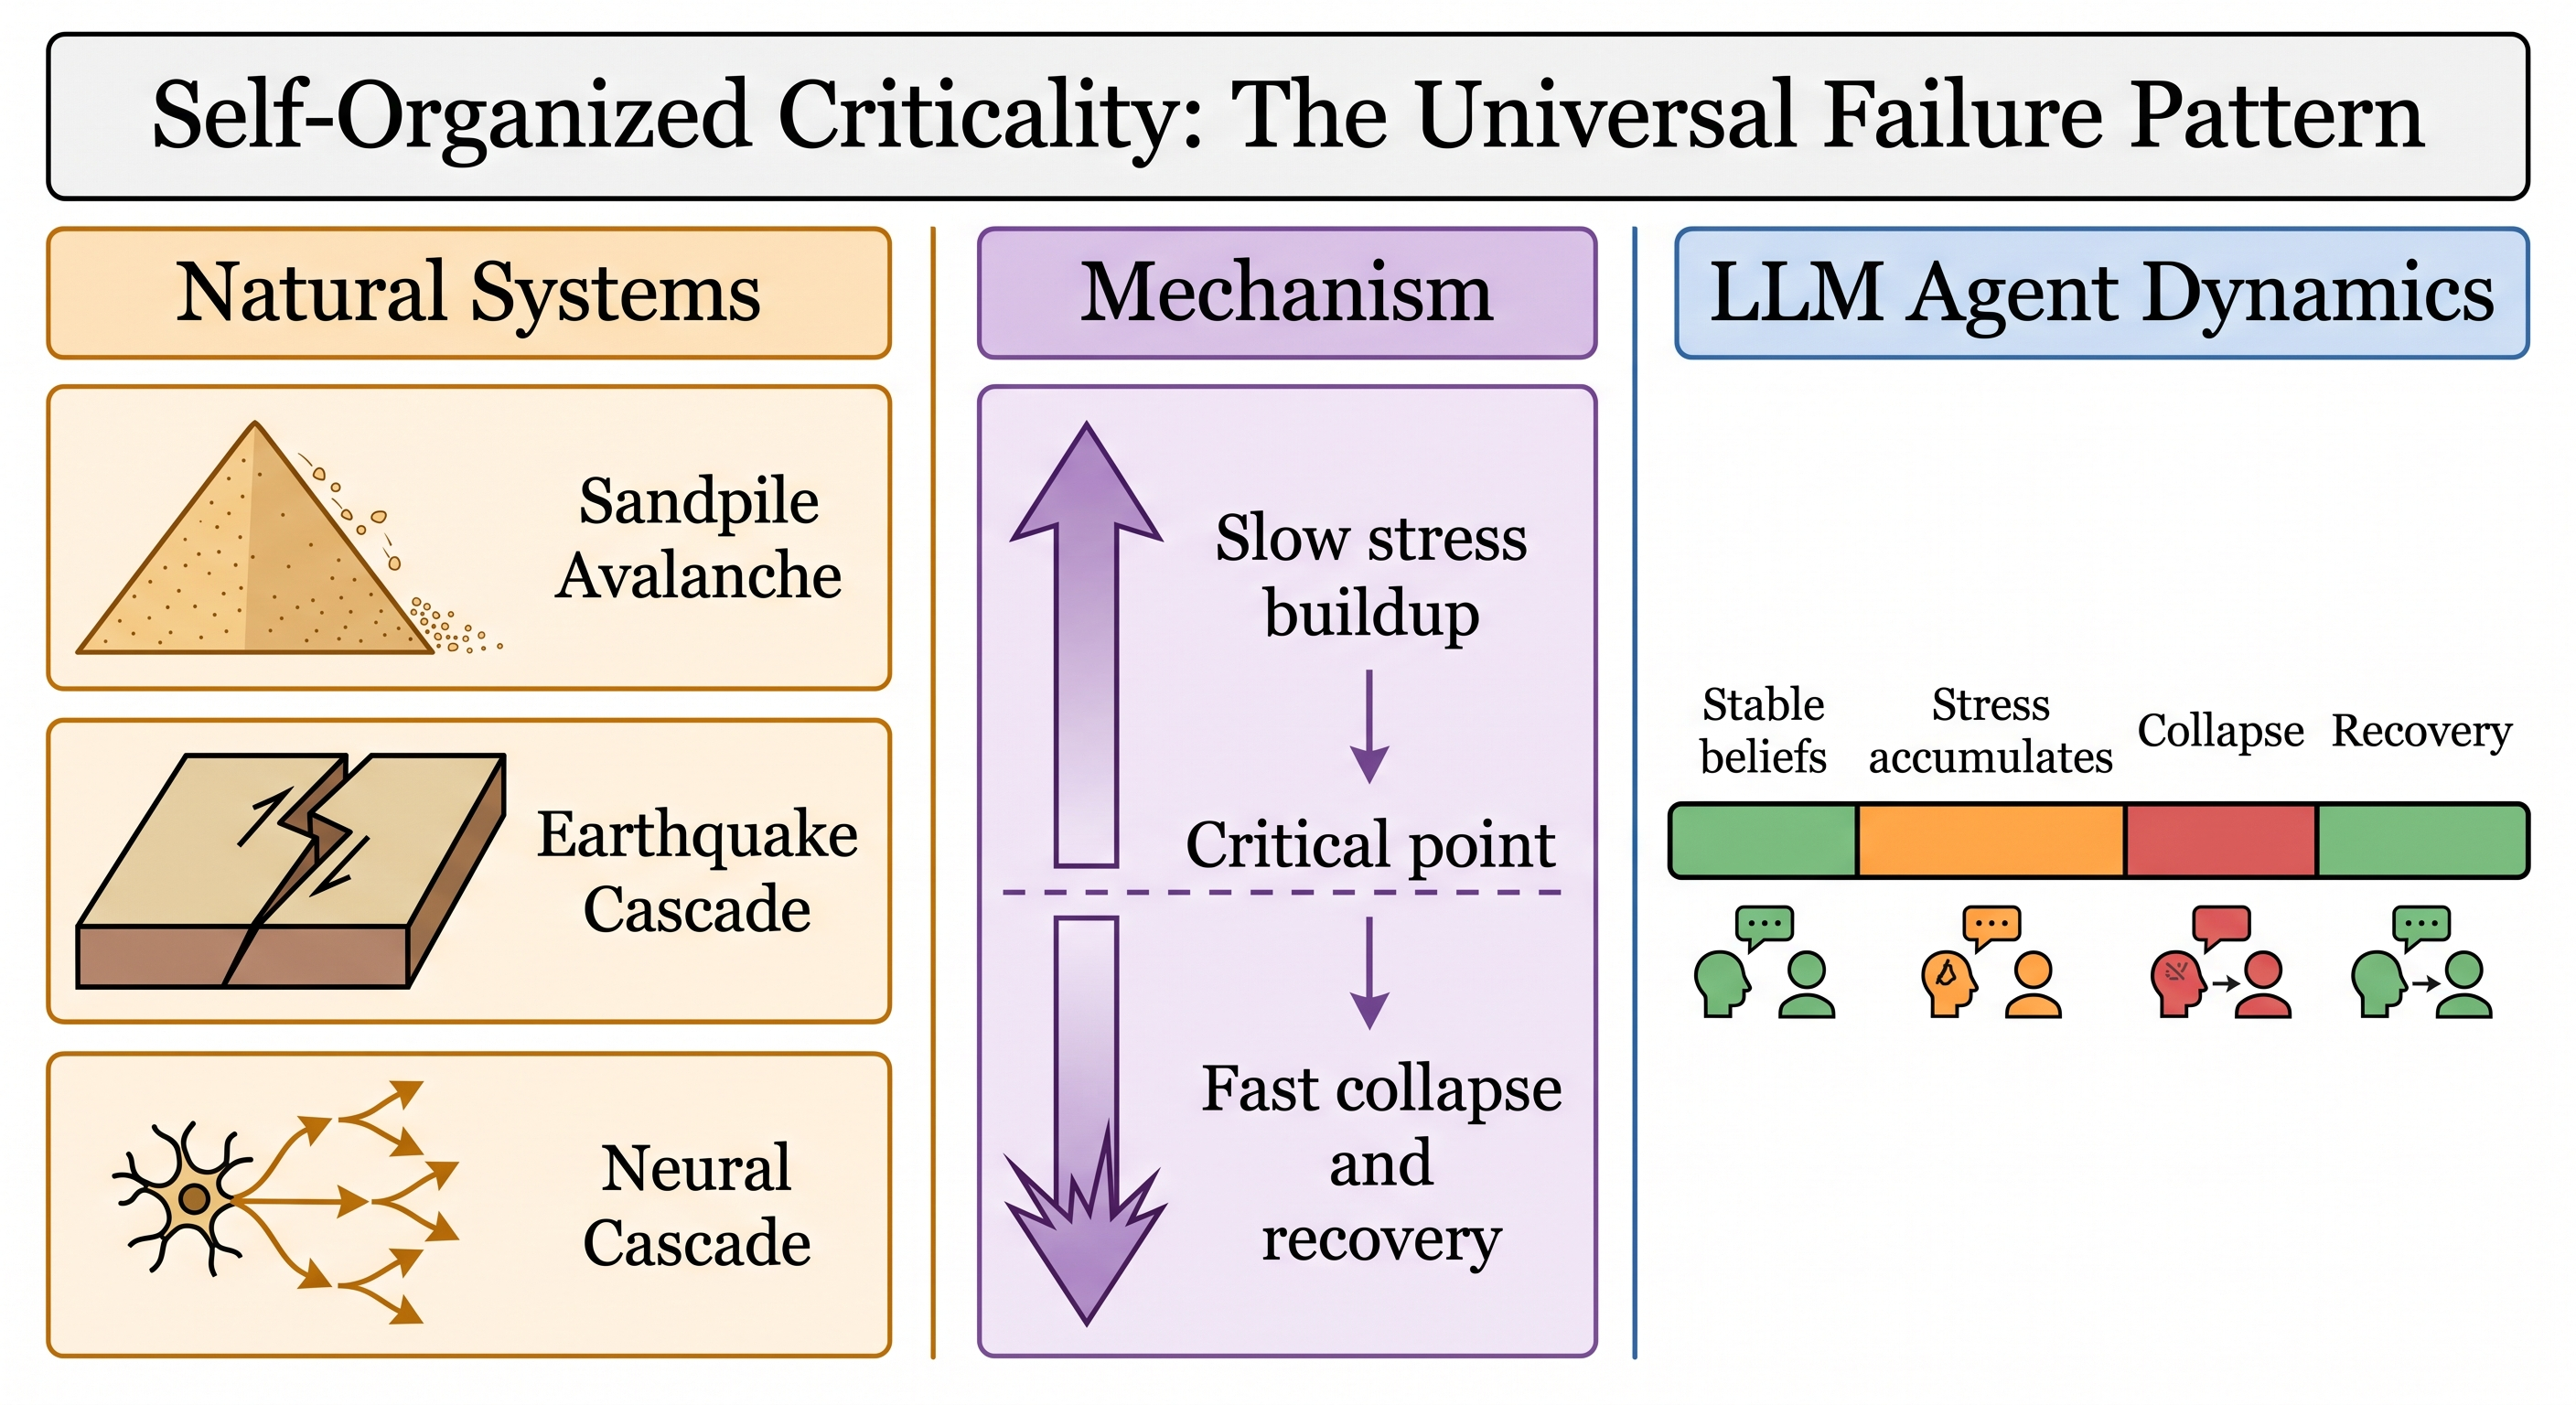 그림 1. 고전 스트레스-붕괴 시스템과 에이전트 궤적의 비교 프레임 (출처: 논문 Figure 1)
핵심 결과 1: 스트레스 주입 한 번에 붕괴한다
StatefulPuzzle-SOC(호라이즌 64)에 외부에서 스트레스를 주입한 실험입니다. 주입된 스트레스가 붕괴를 예측하는 AUROC가 0.979. 첫 번째 스트레스 단계만으로도 에이전트가 거의 확정적으로 붕괴하는 수준으로 넘어갑니다.
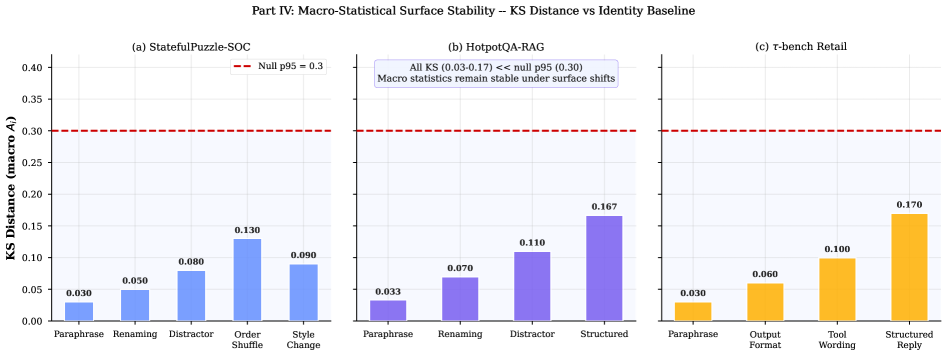 그림 4. 외부 스트레스 주입에 따른 제어된 붕괴. 스트레스 0 대비군과 스트레스 궤적의 분리 (출처: 논문 Figure 4)
중요한 건 방향입니다. 자연 로그에서 관찰된 스트레스가 붕괴를 예측하는 힘은 미미했다는 점(7.3.1절). 스트레스가 붕괴의 원인이라는 건 통제 실험에서만 성립하고, 실제 트레이스에서는 난이도 프록시만큼 못했습니다.
핵심 결과 2: 행동은 맞는데 세계는 이미 무너졌다
가장 실무적으로 뼈아픈 결과입니다.
- τ-bench Airline에서 정보 조회형(information-only) 태스크는 국소-전역 격차가 0에 가깝습니다.
- 반면 조건이 붙은 실제 태스크 클래스는 격차가 크게 벌어집니다.
- GAIA Level-1에서는 증거 상태가 이미 붕괴한 뒤에도 중간 결론 스텝이 국소적으로 유효하게 유지되는 격차 Δ_LG = 0.857.
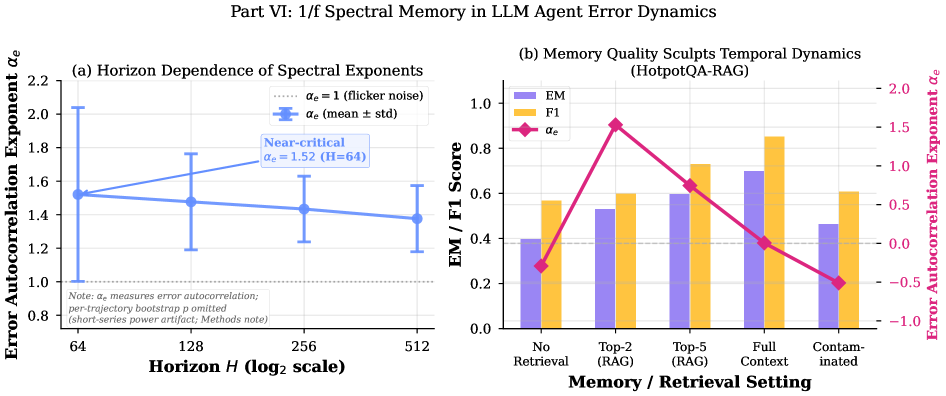 그림 5. 국소 유효성(행동이 허용되는가)과 전역 충실도(잠재 태스크 상태가 맞는가)의 분리 (출처: 논문 Figure 5)
해석은 이렇습니다. 툴콜이 실행 가능한지, 문법이 맞는지, 최종 답이 통과하는지 같은 검사만으로는 이미 무너진 세계 모델을 잡아낼 수 없습니다. 중간 스텝의 세계 상태 충실도를 별도로 로깅해야 합니다.
핵심 결과 3: 오류는 기억을 가진다
오류 스트림이 백색잡음(독립 오류)과 호환되는지 검정한 결과, StatefulPuzzle의 스펙트럼 지수는 모든 호라이즌에서 장기 기억 영역에 있었습니다. 오류가 흩어져 나오지 않고 몰려 다닌다는 뜻입니다.
HotpotQA로 정보 채널을 바꿔보니 메커니즘이 보입니다. 전체 컨텍스트를 주면 오류가 거의 상관없어지는데, top-2 좁은 검색만 주면 플리커 노이즈 수준의 지속성이 생깁니다. 검색 폭이 오류의 시간 구조 자체를 바꾸는 거죠.
핵심 결과 4: 의존성 깊이 2에서 전파 방식이 바뀐다
재귀적 상태 의존성 깊이를 늘리는 실험에서, 깊이 1에서는 지수 감쇠 피팅이, 깊이 2부터는 멱법칙 피팅이 우세로 뒤집힙니다. AIC 부호가 깊이 2에서 반전합니다. 다만 상태 공간이 유한해서 발산은 포화됩니다. 양의 리아푸노프 지수 같은 비제어 혼돈에는 해당하지 않고 유한 시스템의 유계 전파 전이라는 게 저자들의 판정입니다.
핵심 결과 5: 오류 클러스터의 프랙털 차원은 그래프 토폴로지를 따른다
오류 클러스터의 프랙털 차원 D_f를 재보면:
- HotpotQA(고정 2-홉 증거 그래프): D_f = 0.835–0.904, 산포 0.069로 안정.
- ALFWorld(태스크 그래프에 따라): long-chain 0.639, container 1.042, multi-room 1.50.
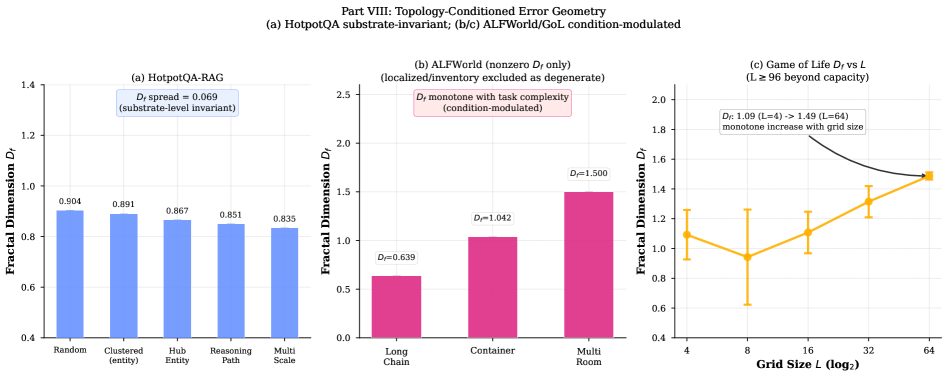 그림 9. 증거/태스크 그래프 위의 프랙털 오류 기하. 위상에 따라 차원이 달라진다 (출처: 논문 Figure 5의 확장, 논문 Figure 9)
같은 토폴로지 안에서는 안정적이고, 토폴로지가 바뀌면 값이 달라집니다. 결론은 그래프 조건부 진단이라는 쪽이고, 보편 스칼라 차원은 아니었습니다 (아래 그림 참고).
핵심 결과 6: 호라이즌이 커질수록 폭발도 커진다
호라이즌을 외부에서 늘리니 최대 폭발(avalanche) 절단 크기가 7에서 490까지 단조 증가했습니다. 모든 인접 호라이즌 검정은 FDR 보정 후에도 유의했습니다.
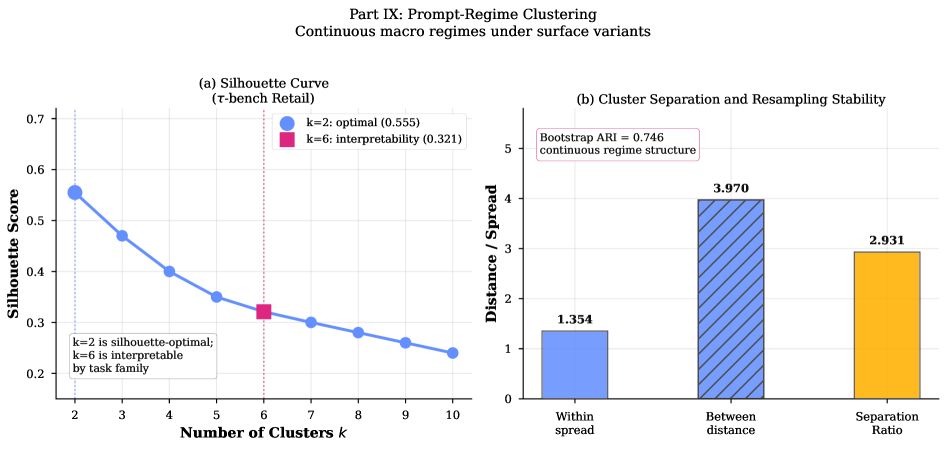 그림 10. 유한 크기 스케일링. 호라이즌이 커질수록 최대 폭발이 커진다 (출처: 논문 Figure 10)
Game of Life 경계 검사도 흥미롭습니다. 그리드 4–64에서는 프랙털 차원이 1.09→1.49로 정상 측정되는데, 그리드 96 이상에서는 유효 궤적이 0개가 나옵니다. 모델이 유효한 상태를 못 만들어내는 능력 한계이지, 동역학이 없는 게 아닙니다. 진단 시그니처가 “없다”와 “측정 불가”를 구분하라는 교훈입니다.
과장은 안 한다: 경계 검정 결과
이 논문의 좋은 점은 강한 주장을 스스로 검정해서 걸러냈다는 겁니다.
| 강한 해석 | 검정 결과 |
|---|---|
| 자연 스트레스가 붕괴의 강한 예측자다 | 부분 증거. 독립 보상-오류 라벨 기준으로는 난이도 프록시 대비 증분이 작음 |
| 보편적 멱법칙/임계점이 있다 | 미지지. 유계 발산 + 유한 크기 효과로 설명됨 |
| 멀티모달 프롬프트가 뚜렷한 국소 빗금(클러스터)을 만든다 | 부분 증거. 매크로 통계는 안정(KS 0.03–0.17)이나 실루엣은 2-클러스터 최적 |
| 검증-탐험의 보편적 최적 균형점이 있다 | 미지지. Retail은 무개입/고검증, ALFWorld는 탐험/메모리 중심이 유리, 기질별 상이 |
에이전트 평가 관행에 대한 제언 4가지
논문이 제안하는 실무 변경 사항입니다.
- 벤치마크는 최종 보상과 실행 가능한 행동에 더해서 에이전트가 암시하는 태스크 상태를 로깅해야 합니다.
- 보고서에 행동 유효성과 세계 상태 충실도의 국소-전역 불일치를 포함해야 합니다.
- 오류 시퀀스는 베르누이 널과 지속성 널 둘 다와 비교해야 합니다.
- 호라이즌, 의존성 깊이, 태스크 토폴로지를 바꿔가며 반복해야 합니다. 같은 모델이 그래프 구조에 따라 다른 전파 양상을 보입니다.
제 해석을 붙이자면, 이건 하네스 설계에도 바로 적용됩니다. 중간 스텝의 세계 상태를 별도로 추적하는 게 최종 보상 기반 평가보다 실패를 먼저 잡는다는 얘기고, 이미 그 방향의 사례(진행의 신기루, 컨텍스트 우선 실패 등)와 정확히 맞닿습니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
Q: 오류 폭발(avalanche)이 정확히 뭔가요? 오류가 연속으로 몰려서 발생하는 구간입니다. 독립적인 오류라면 기대되는 버스트 크기보다 실제 클러스터가 크게 나타나고, 그 크기 분포가 호라이즘에 따라 커집니다(최대 7→490).
Q: 에이전트가 툴콜을 계속 올바르게 하면 안전한가요? 아닙니다. GAIA에서 국소적으로 유효한 중간 결론이 이미 붕괴한 증거 상태 위에서 나온 사례가 있고, 그 격차(Δ_LG=0.857)가 핵심 결과 중 하나입니다.
Q: 이 논문이 보편적 멱법칙을 증명했나요? 아니요. 오히려 명시적으로 반증 쪽에 가깝습니다. 발산은 유계이고, 프롬프트 변형에 매크로 통계가 안정적이라는 것까지만 지지합니다.
Q: 프롬프트를 바꾸면 폭발 통계가 달라지나요? 태스크 그래프를 보존하는 표면 변형(패러프레이즈, 이름 변경, 디스트랙터, 순서 변경, 스타일 변경)에서는 붕괴 통계가 거의 유지됐습니다(KS 0.03–0.17).
Q: 실무 벤치마크에 바로 적용하려면? 에이전트 궤적 로그에 암시 상태 벡터를 남기고, 오류 시퀀스를 독립 널과 지속성 널과 비교하는 것부터 시작할 수 있습니다. 코드가 공개되어 있습니다.