결론 먼저
T1(arXiv 2609.11042, Tencent Hy Foundation Model Frontier 외, 2026-09-10)의 핵심은 이겁니다. Qwen3.5-122B-A10B를 실제 리눅스 셸에서 태스크당 최대 300턴 이상 돌리고, 태스크별 검증기(verifier)를 실행한 결과로 보상을 주는 강화학습만으로 Terminal-Bench 2.1을 43.8%에서 64.0%로 올렸다는 것입니다.
같은 Terminus-2 하네스 기준으로 GPT-5.4(54.8%), DeepSeek-V4-Flash(56.9%), Claude Opus 4.6(63.8%)보다 높고 Claude Opus 4.7(66.1%)에 근접합니다. 활성 파라미터는 10B입니다.
전체 상승분 20.2포인트 중 SFT가 5.6점, RL이 14.6점을 담당했습니다. 총 상승분의 약 4분의 3을 실행 기반 강화학습이 만들었다는 게 이 논문의 중심 근거입니다.
| 항목 | 값 |
|---|---|
| 베이스 모델 | Qwen3.5-122B-A10B (총 122B, 활성 10B, MoE) |
| Terminal-Bench 2.1 (베이스 → T1) | 43.8% → 64.0% |
| Long-Horizon Terminal-Bench | 27.9 (GPT-5.4 27.2, GLM-5.1 26.7 초과) |
| Terminal-Bench Hard | 38.0% |
| 태스크당 최대 도구 호출 | 300+ 턴 |
| 학습 데이터 | T1-15k (15,000개 합성 터미널 태스크) |
| 훈련-추론 log-prob 격차 | 0.021 → 0.013 (TITO + R3) |
| 기준일 | 2026-09-15, 논문 v1 기준 |
같은 하네스 기준 성능 비교
| 모델 | 크기 | Terminal-Bench 2.1 |
|---|---|---|
| Claude Opus 4.7 | – | 66.1 |
| Claude Opus 4.6 | – | 63.8 |
| Muse Spark | – | 62.2 |
| Hy3-Preview | 295B-A21B | 58.0 |
| DeepSeek V4 Flash | 295B-A21B | 56.9 |
| Kimi-K2.5 | 1040B-A32B | 56.4 |
| Minimax M2.7 | 229B-A10B | 55.4 |
| GPT-5.4 | – | 54.8 |
| Qwen3.5-122B-A10B (베이스) | 122B-A10B | 43.8 |
| T1 | 122B-A10B | 64.0 |
하네스가 바뀌면 점수가 크게 움직입니다. Claude Opus 4.6은 Claude Code 하네스에서 70.1, Terminus-2에서 63.8입니다. T1은 이 하네스에 맞춰 학습된 모델이라는 점을 논문이 직접 명시합니다.
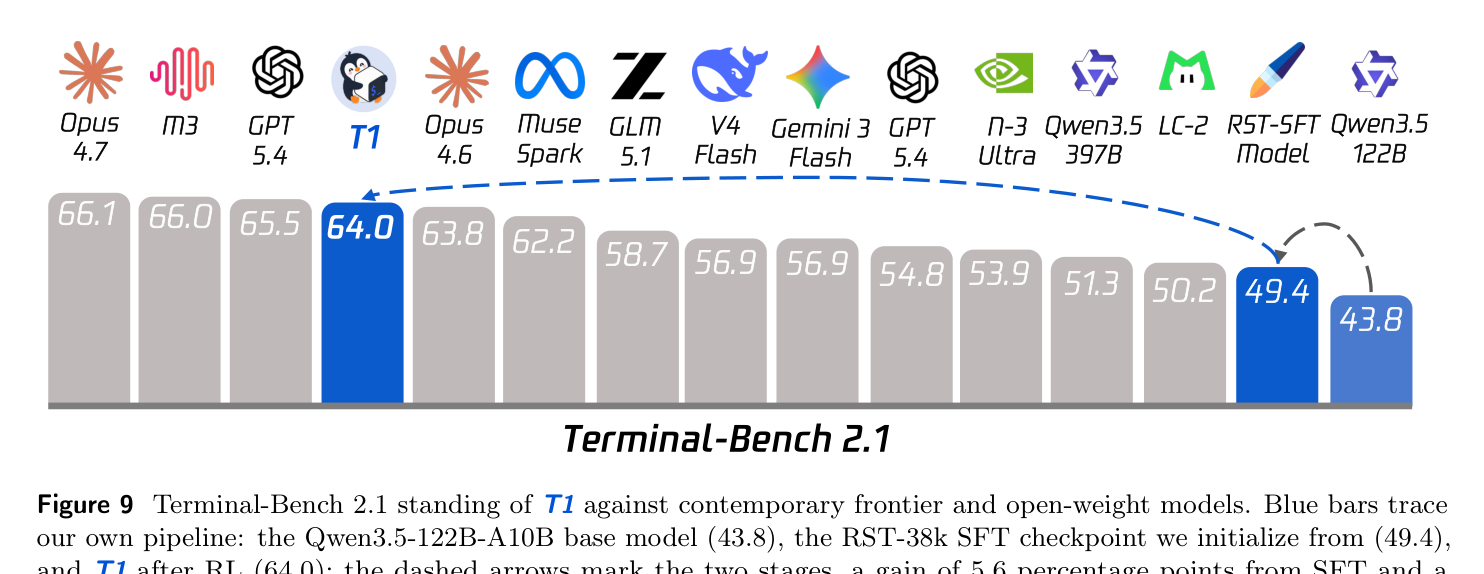
Figure 9. Terminal-Bench 2.1 순위. 파란 막대 세 개가 같은 모델의 세 단계(베이스 43.8 → SFT 49.4 → T1 64.0). 출처: arXiv 2609.11042 Figure 9.
문제 정의: 긴 호라이즌 터미널 RL의 난제 두 개
터미널 태스크는 코드 완성과 다릅니다. 명령의 결과가 환경 상태를 바꾸고, 다음 판단이 바뀐 상태를 보고 이루어집니다. 수백 개 커밋을 bisect해 결함을 찾고 패치하고 빌드로 증명하는 태스크가 대표적입니다.
난제 1은 학습-추론 불일치입니다. MoE 모델은 토큰마다 이산 라우터가 256개 전문가 중 8개를 고릅니다. 전체 121.4B 중 116.0B가 전문가 가중치입니다.
추론 스택과 학습 스택의 미세한 수치 차이가 이 선택을 뒤집으면 실제 행동을 만든 파라미터와 다른 파라미터에 그라디언트가 갑니다.
난제 2는 희소 보상입니다. 롤아웃 한 배치에 수백 sandbox-시간이 드는데 이진 통과/실패는 트랙토리당 1비트밖에 못 줍니다. 저자들의 첫 이진 보상 캠페인은 SFT 베이스라인을 넘지 못했습니다.
기법 1: TITO 토큰 단위 정합
TITO(Token-In-Token-Out)는 멀티턴 로그를 학습 샘플로 이을 때 샘플러가 실제 뽑은 정확한 토큰 식별자 그대로 학습하는 것입니다. 재인코딩된 근사 토큰은 학습 스트림에 절대 들어가지 않습니다.
- 턴 경계에서 프리픽스 관계를 점진적으로 약한 순서로 테스트하고, 떨어지는 만큼만 수리합니다.
- 툴 출력 같은 관측은 마스킹된 컨텍스트로 들어가고 그라디언트를 받지 않습니다.
- 1,402개 샘플 운영 실행에서 loss 영역의 드리프트율이 정확히 0.0000%로 측정됐습니다.
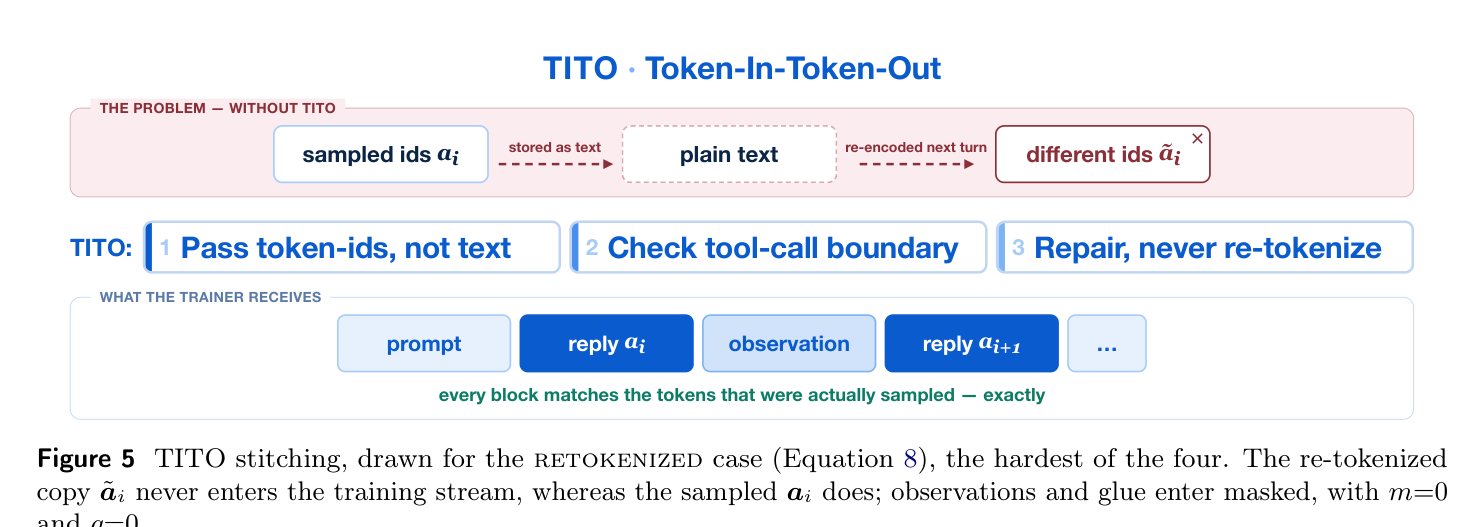
Figure 5. TITO 스티칭. 재토큰화된 복사본이 아니라 샘플링된 원본 토큰이 학습 스트림에 들어갑니다. 출처: arXiv 2609.11042 Figure 5.
기법 2: R3 롤아웃 라우팅 재생
R3(rollout routing replay)는 라우팅 문제를 구조로 해결합니다. 추론 시 기록한 전문가 선택 마스크를 학습 forward에서 그대로 재사용하는 방식입니다. 정규화는 살아있는 logits로 하되 선택은 기록된 마스크로 고정합니다.
TITO와 R3를 합쳐 훈련-추론 log-probability 차이를 0.021에서 0.013으로 줄였고 loss 영역에서 토큰 드리프트가 0이 됐습니다.
기법 3: 밀집 검증 보상
보상 설계가 이 논문의 절반입니다. 검증기가 각 어설션(assertion)별로 통과/실패를 따로 보고하니, 통과한 어설션 절대 개수를 전역 고정 스케일로 점수화하는 밀집 프로세스 보상을 씁니다.
- 스케일 S=20을 전 런에 걸쳐 고정했습니다. 배치 최댓값 정규화는 극단 샘플 하나가 배치 전체 보상 스케일을 바꿀 수 있어서 쓰지 않습니다.
- 보상은 마지막 응답 토큰에 들어가고 크리틱이 호라이즘 전체에 크레딧을 분배합니다.
- 크리틱은 배우 학습률의 30배로 warm-start했습니다.
- 보상 해킹 방지로 숨은 요구사항·테스트 누출·솔루션 지름길·검증기 약함에 해당하는 태스크를 하드 리젝하고, 런 중 턴 수 증가를 모니터링했습니다. 27B 실험에서는 턴 폭주가 관찰됐지만 122B 런에서는 없었다고 합니다.
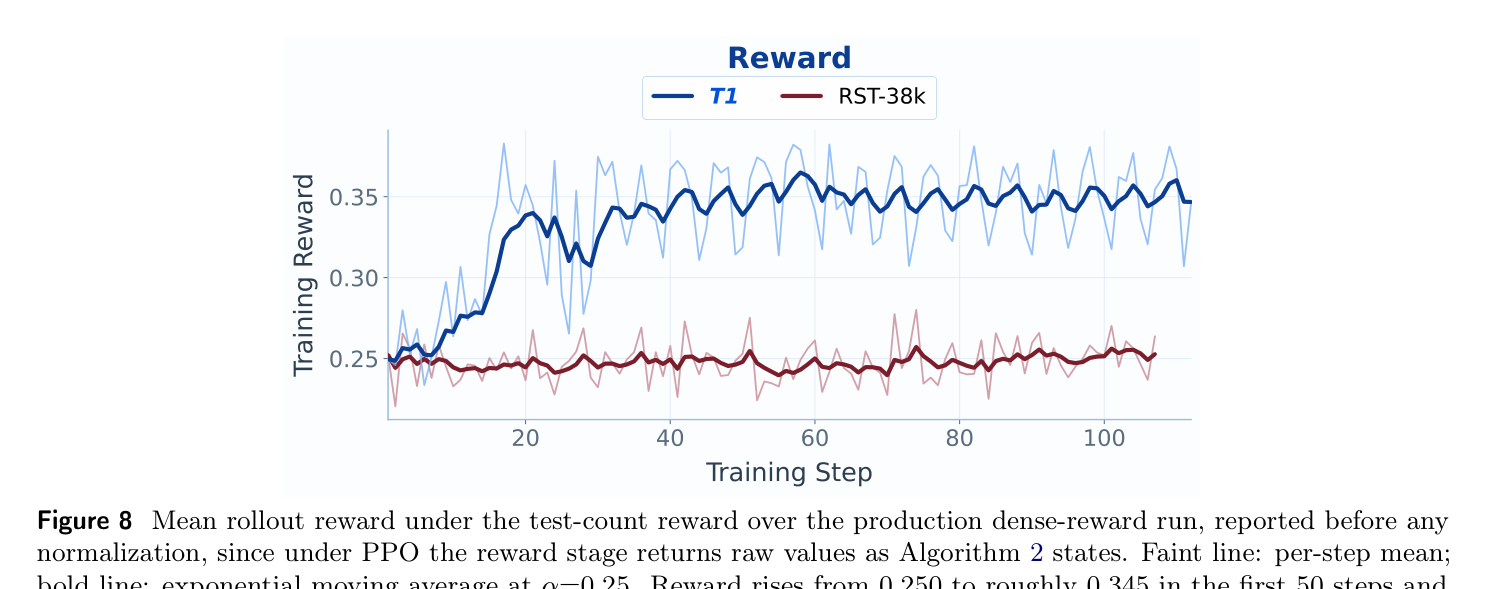
Figure 8. test-count 보상 하의 평균 롤아웃 보상. 출처: arXiv 2609.11042 Figure 8.
학습 데이터: T1-15k 구성
태스크 풀 구성이 결과를 좌우합니다.
| 풀 | 규모 | 보상 | 결과 |
|---|---|---|---|
| Tmax-15k | 14,601개 (공개 코퍼스 변환) | 이진만 가능 | 47.2% |
| RST-38k | 37,484개 (재귀 합성) | 밀집 | 59.9% |
| T1-15k | 15,000개 (감사 선별) | 밀집 | 64.0% |
T1-15k는 8개 감사 차원(지시-검증기 정렬 20%, 검증기 공정성 15%, 솔루션 정확도 15% 등)으로 선별했습니다. 평가 벤치마크 세 개는 어느 학습 풀에도 태스크를 제공하지 않습니다. 그래서 성능 향상이 벤치마크 오염을 배제한 실제 전이라는 주장의 근거가 됩니다.
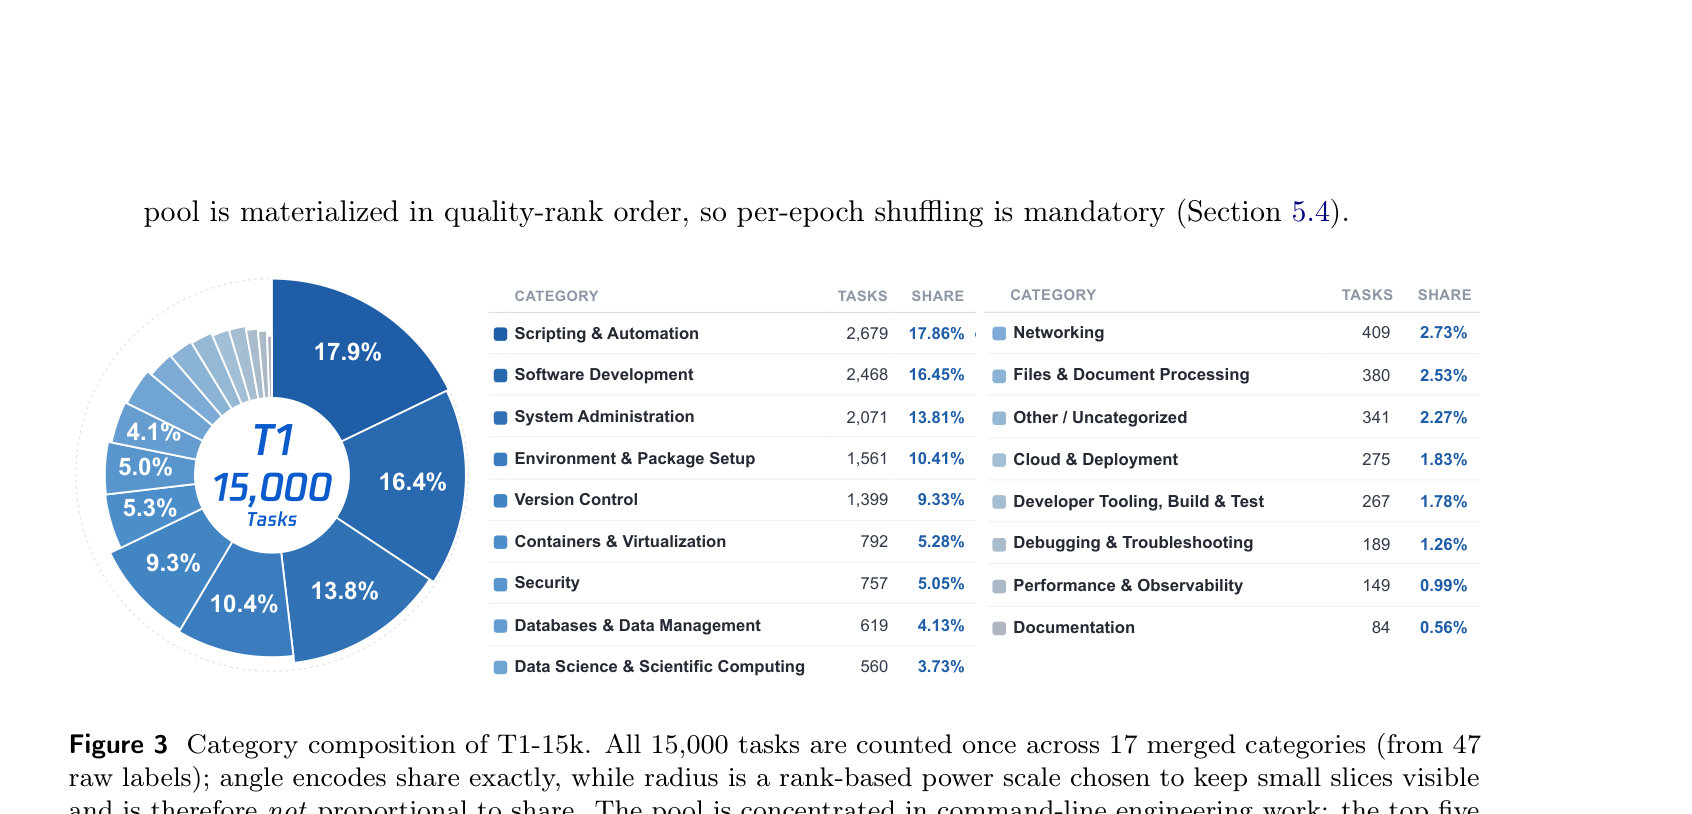
Figure 3. T1-15k의 카테고리 구성. 상위 5개 카테고리가 67.9%. 출처: arXiv 2609.11042 Figure 3.
카테고리 편중도 결과를 예측합니다. 스크립팅·소프트웨어 개발·시스템 관리가 3분의 2를 차지하고 디버깅은 1.3%뿐인데, 결과는 디버깅 100.0, 시스템 관리 88.9였습니다. 데이터 구성이 강점으로 그대로 나타난 셈입니다.
인프라
slime v0.3.0 + Megatron-Core v0.16.0rc0 + SGLang v0.5.12.post1 + DeepEP v1.2.1 스택에서 공동 배치된 122B 액터-크리틱 쌍을 며칠씩 유지합니다. 평가는 Harbor v0.7.0 + Daytona 샌드박스 v0.168.0에서 돌립니다.
시간 단위 스텝이 가능한 실행 기반 RL 인프라가 실제로 며칠간 살아있다는 사실 자체가 결과의 상당 부분입니다.
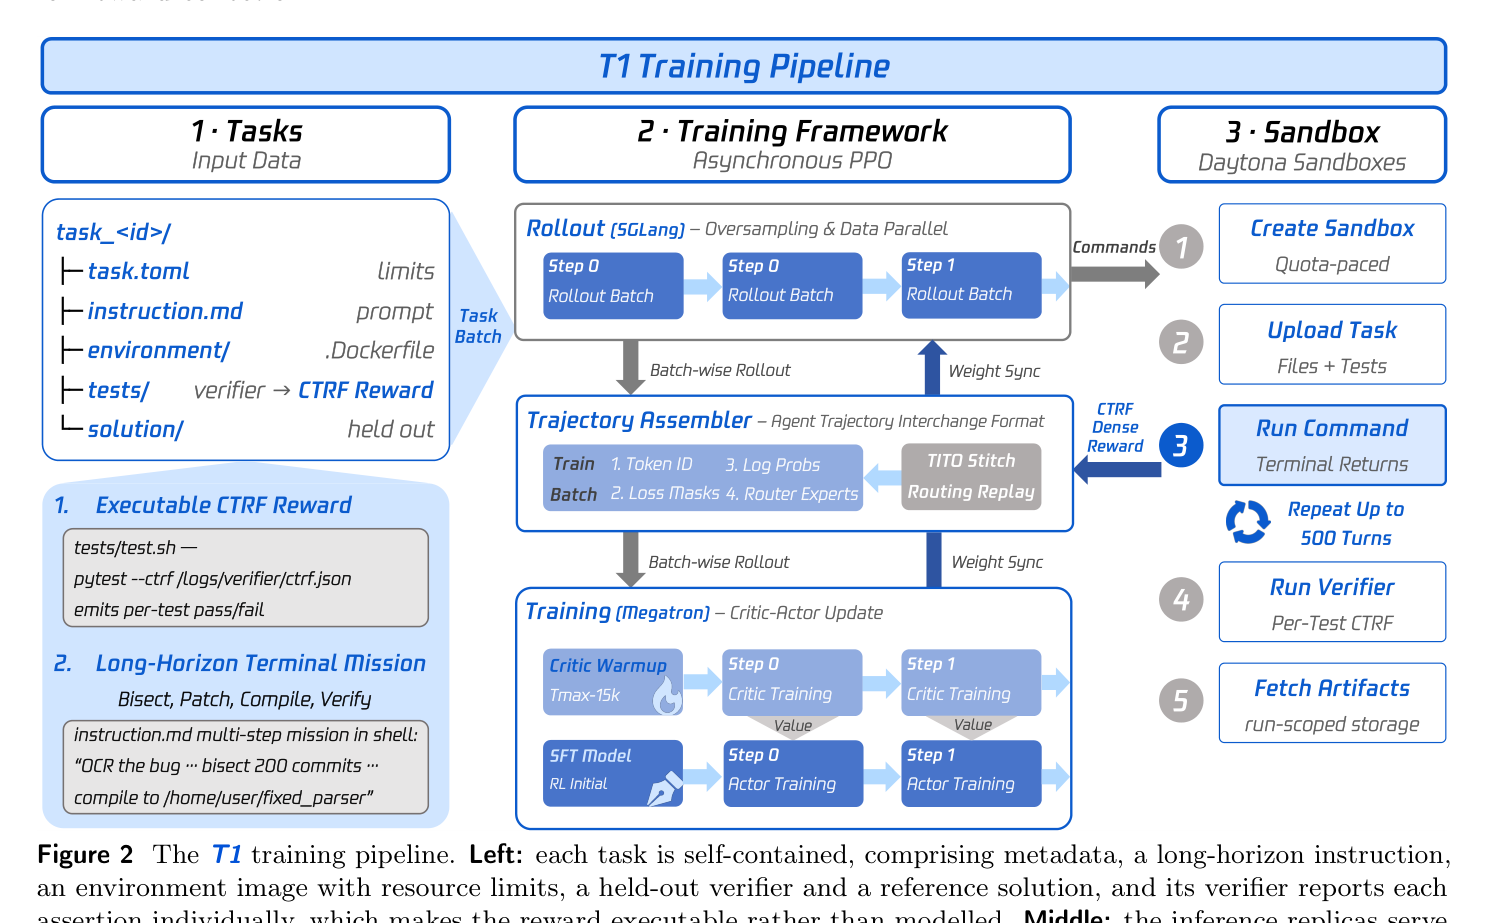
Figure 2. T1 학습 파이프라인 전체 구조. 출처: arXiv 2609.11042 Figure 2.
실패 기록과 교훈
9장의 실패 기록이 실용적으로 유익합니다.
-
크리틱 보정이 좋아져도 정책이 나아지지 않는 경우가 있습니다. 27B pathfinding에서 설명 분산은 step 30까지 앞당겨졌는데 롤아웃 보상은 그대로였습니다.
어려운 태스크가 전부 0을 받으면 그걸 잘 예측해도 소용이 없습니다. 보정과 정책 개선은 따로 진단해야 합니다.
-
컨텍스트 관리가 학습 가능성을 결정합니다. 요약 길이 mismatch로 전체 요약 시도의 98.3%가 실패한 캠페인에서 에이전트는 완료한 작업을 반복했고 평균 턴이 22에서 30으로 늘었습니다. 길이 페널티를 주면 메모리 실패는 그대로 둔 채 증상만 누르게 됩니다.
-
롤아웃 처리량이 학습 분포를 바꿉니다. 스케줄러가 초과 발사 후 빨리 끝난 것만 받으면 느린 어려운 태스크의 트랙토리가 취소됩니다. 측정된 한 스텝에서 561개 중 48개가 취소됐습니다.
풍부한 보상도 취소된 트랙토리에서 감독 신호를 되살릴 수 없습니다.
-
GRPO가 정체된 이유도 명시적입니다. 그룹 내 전원 실패/전원 성공이 흔한 긴 호라이즌 태스크에서 그룹 상대 advantage는 그라디언트를 주지 못하고, 동일 태스크 G번 샘플링 요구가 태스크 다양성과 경쟁합니다. 같은 예산에서 GRPO는 51.7%에서 정체됐습니다.
내 해석
원문 근거와 구분해서 제 해석을 적습니다.
이 논문의 진짜 기여는 64.0%라는 숫자보다 레시피의 검증 가능성입니다. TITO·R3·밀집 보상·크리틱 warm-start가 각각 어떤 불일치를 몇 점씩 줄이는지 수치로 보여줬으니, 같은 조건을 맞춘 다른 팀도 비슷한 하한선을 기대할 수 있습니다.
한계도 명확합니다. 동일 하네스 보상 최적화라는 점, 카테고리 편중, 롤아웃 취소로 인한 긴 태스크 커버리지 손실은 논문이 인정하는 열린 문제입니다. LHTB에서는 GLM-5.2(31.6)와 DeepSeek-V4-Pro(30.7)가 여전히 앞섭니다.
하네스 의존성 숫자도 얕게 읽으면 안 됩니다. 같은 모델이 하네스에 따라 6점 이상 움직이니, 벤치마크 표를 볼 때 하네스 컬럼을 확인하는 습관이 이 논문의 부수 교훈입니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
T1이 정확히 뭔지
Qwen3.5-122B-A10B를 터미널 태스크 강화학습으로 후학습한 MoE 에이전트 모델입니다. Tencent Hy Foundation Model Frontier와 NUS 등이 arXiv 2609.11042(2026-09-10)로 공개했습니다.
통과한 테스트 개수로 점수를 매기는 이유
한 롤아웃 배치에 수백 sandbox-시간이 드는데 이진 결과는 트랙토리당 1비트뿐입니다. 어설션 단위 밀집 보상은 부분 진행을 보이게 만들어 어려운 태스크에서도 학습 신호가 나옵니다.
MoE 강화학습에서 라우팅 재생(R3)이 필요한 이유
추론과 학습의 미세한 수치 차이가 전문가 선택을 뒤집으면 행동을 만든 파라미터와 다른 파라미터가 업데이트됩니다. R3은 추론 시 기록한 라우팅 마스크를 학습에 재사용해 이 불일치를 구조적으로 제거합니다.
벤치마크 향상이 오염인지 확인하는 방법
학습 코퍼스가 평가 세트와 분리돼 있고 세 평가 벤치마크가 학습 풀에 태스크를 제공하지 않는다고 논문이 명시합니다. LHTB 27.9로 더 긴 호라이즌 전이도 확인됐습니다.
참고
- 논문: arXiv 2609.11042 — T1: Terminal Agent Reinforcement Learning for Long-Horizon Tasks
- 벤치마크: Terminal-Bench 2.1, Long-Horizon Terminal-Bench, Terminal-Bench Hard
- 기준일: 2026-09-15, 논문 v1 기준