결론 먼저
LLM 강화학습(GRPO/PPO)의 표준 방식은 최종 정답만 맞으면 1, 틀리면 0인 희소(sparse) 결과 보상입니다. 이 방식은 문제가 길어질수록 성공 트랙토리가 지수적으로 희귀해져서 학습 신호가 사실상 죽습니다. Berkeley/CMU의 PPM(Progressive Point Matching) 논문은 트랙토리 하나에서 뽑은 중간 추론 지점(reasoning points)에 “도달했는가”를 세그먼트 단위로 측정해서 편향 없는(unbiased) 밀도(dense) 보상을 만들고, 이론적으로도 실험적으로도 희소 보상 대비 지수적으로 빠른 학습을 보여줍니다. 가장 인상적인 결과는 베이스 모델 성공률이 0.004인 거의 불가능한 수학 문제 세트에서 PPM만 학습에 성공했다는 점입니다.
| 항목 | 내용 |
|---|---|
| 논문 | Long-Horizon Language Model Reinforcement Learning via Progressive Point Matching (arXiv:2609.07303) |
| 저자 | Preston Fu, Kevin Frans (공동 1저자), Oleh Rybkin, Sergey Levine (UC Berkeley), Aviral Kumar (CMU) |
| 문제 | 희소 결과 보상은 태스크 길이 n에 대해 SNR이 Θ(p^(n/2))로 지수 감소 |
| 방법 | 참조 트랙토리의 reasoning points 도달 수를 측정해 세그먼트별 보상 r̂ = φ(s_{t+1}) − φ(s_t) |
| 이론 | Proposition 4.1: PPM 보상의 최적 정책 = 결과 보상의 최적 정책 (동일) |
| 핵심 실험 | GSM-Infinite n=24에서 PPM segment 0.191 vs 희소 보상 0.091 (400M 토큰, Qwen3-1.7B) |
| 극한 설정 | POPE-hard: 베이스 pass rate 0.004(8K)/0(4K)에서 PPM 최고 성능 |
| 기준일 | 2026-09-15 기준, arXiv v1 (2026-09-07 게시) |
희소 보상이 긴 문제에서 실패하는 구조
논문의 Figure 1 예시가 직관적입니다. 하위 문제 n개를 모두 풀어야 최종 정답이 나오는 태스크에서, 각 하위 문제를 p 확률로 푼다면 전체 성공 확률은 p^n입니다.
n이 커지면 성공 트랙토리가 관측 자체가 안 됩니다. 논문의 시뮬레이션에서는 성공 샘플 1개를 관측하려면 1,200만 개 이상의 샘플이 필요한 설정도 나옵니다.
정리하면 Theorem 5.1(비공식)의 SNR 비교입니다.
| 보상 설계 | 정책 그래디언트 SNR |
|---|---|
| 희소 결과 보상 | Θ(p^(n/2)) — 지수 감소 |
| PPM 트랙토리 레벨 | Θ(n^(−1/2)) |
| PPM 턴(세그먼트) 레벨 | Ω(1/log n) — 길어져도 거의 유지 |
즉 희소 보상은 n이 늘수록 신호가 지수적으로 죽는데, PPM 세그먼트 레벨은 태스크가 길어져도 SNR이 로그 수준으로만 감소합니다.
PPM 방법: reasoning points와 숏컷
핵심 아이디어는 추론을 “상태 공간 통과”로 보는 겁니다.
- 긴 추론에서 중간 결과(보조정리, 계산 결과)는 이후 단계의 충분 통계가 됩니다. 이걸 reasoning points라고 부릅니다.
- 상태 s는 “지금까지 도달한 reasoning points의 집합”이고, 태스크는 골 지점(정답)을 포함하는 상태에 도달하는 겁니다.
- 참조 트랙토리(문제당 1개)에서 reasoning points를 뽑고, 측정 함수 φ(s)는 현재 상태가 참조 reasoning points 중 몇 개를 포함하는지 셉니다.
- 세그먼트 보상은 그 증분입니다: r̂(s_t, a_t) = φ(s_{t+1}) − φ(s_t). 이건 potential shaping과 같은 형태라 티슐링(telescoping) 합이 φ(s_T)로 수렴합니다.
여기서 “이미 앞선 지점을 도달했으면 뒤진 중간 지점에 full credit을 준다”는 shortcutting 구조가 들어갑니다.
골에 도달하면 모든 reasoning points가 도달 처리되므로, Proposition 4.1이 성립합니다: PPM 보상 하의 최적 정책과 결과 보상 하의 최적 정책이 일치합니다. 순진한 부분 보상(중간 점수만 많이 따는 정책)이 최적이 되는 편향 문제를 막는 장치입니다.
재미있는 성질은 reasoning points 설계로 모방학습과 강화학습 사이를 보간할 수 있다는 점입니다. 토큰 단위 접두 전부를 reasoning point로 쓰면 토큰 레벨 모방학습, 정답 하나만 쓰면 희소 보상 RL, 그 중간이 PPM입니다.
구현은 GRPO에 플러그인 형태로 붙입니다. 트랙토리를 턴 경계나 등분 청크로 나누고, 각 prefix에 대해 φ를 측정해서 세그먼트 보상을 만들고, GRPO 그룹 정규화로 토큰 어드밴티지를 계산합니다.
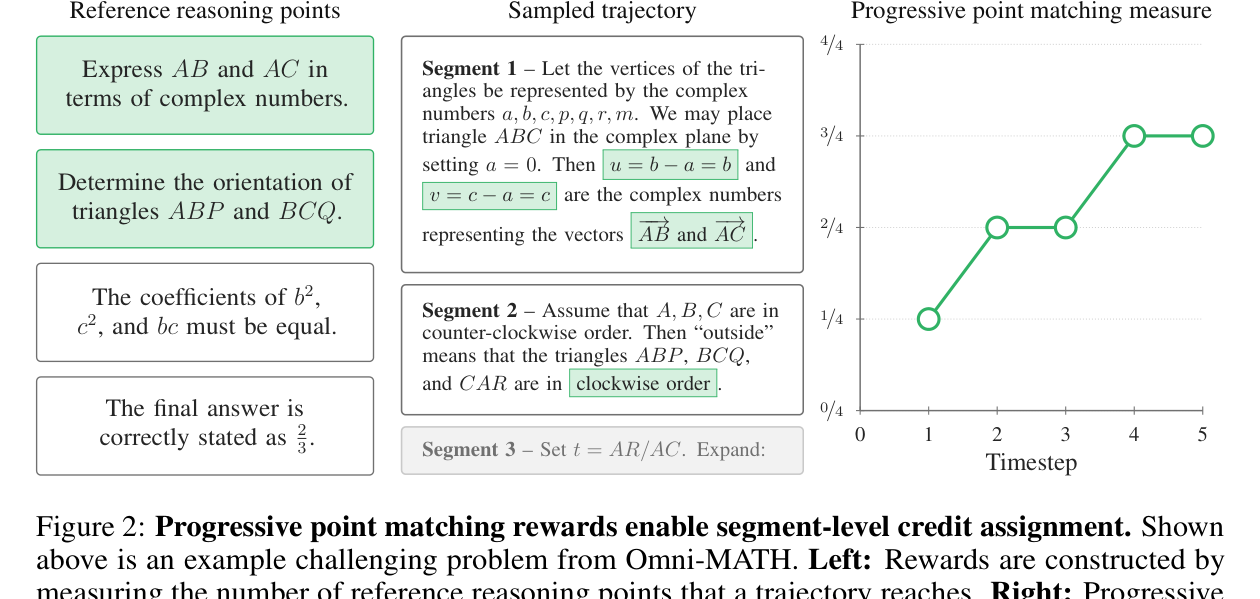
Figure 2 (원논문): 성공 트랙토리는 보상이 0→1로 단조 증가하고, 이탈한 트랙토리는 중간에 평탄해짐. 출처: arXiv:2609.07303 Figure 2
합성 환경: 길이가 늘수록 격차가 벌어진다
세 가지 합성 환경으로 길이 효과를 분리해 측정했습니다.
- Multi-Countdown: Countdown 산술 문제 n개를 모두 풀어야 함. 하위 문제가 서로 독립인 구조.
- Matrix Manipulation: 행렬 연산을 순서대로 누적 수행. 완전 순차 의존 구조.
- GSM-Infinite: 그래프에서 생성되는 수학 문제, 최단 경로 길이로 난도 조절.
Multi-Countdown(Qwen3-1.7B, GRPO 기반)에서는 n이 커질수록 희소 보상과 PPM의 격차가 지수적으로 벌어집니다. 매트릭스 조작(Qwen3-4B-Instruct)에서도 PPM이 일관되게 앞섭니다.
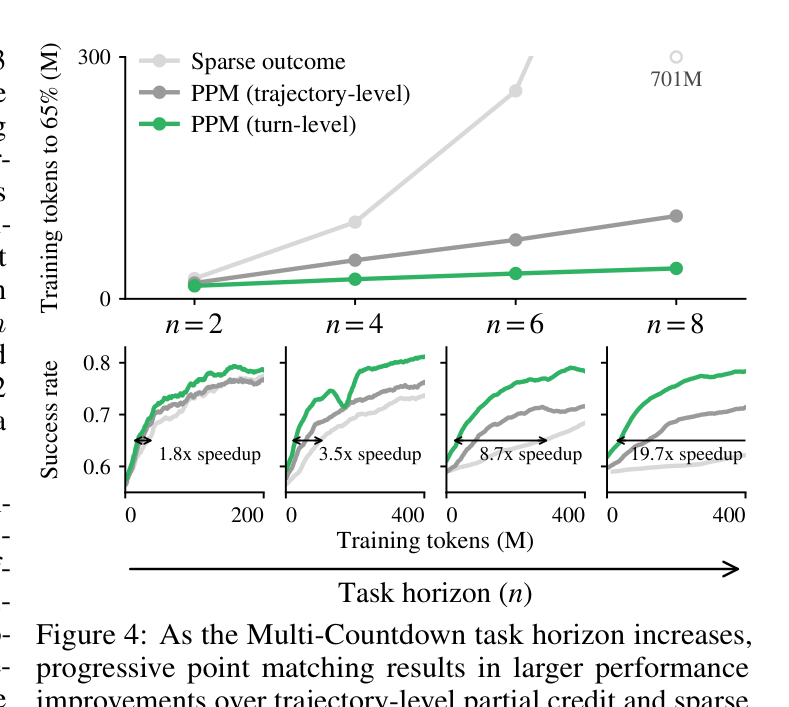
Figure 4 (원논문): x축 태스크 horizon 증가 시 세 가지 보상 설계의 학습 곡선 비교. 출처: arXiv:2609.07303 Figure 4
GSM-Infinite 400M 학습 토큰 시점의 성공률이 핵심 표입니다.
| 방법 (Qwen3-1.7B) | n=8 | n=16 | n=24 |
|---|---|---|---|
| 베이스 모델 | 0.134 | 0.056 | 0.056 |
| 희소 결과 보상 (GRPO) | 0.684 | 0.084 | 0.091 |
| Verifree | 0.828 | 0.126 | 0.098 |
| OPSD | 0.283 | 0.102 | 0.078 |
| Process reward | 0.329 | 0.075 | 0.080 |
| PPM (트랙토리) | 0.758 | 0.334 | 0.089 |
| PPM (세그먼트) | 0.652 | 0.415 | 0.191 |
짧은 문제(n=8)에선 Verifree가 이기지만, 길어질수록 세그먼트 레벨 PPM이 확실하게 이깁니다. n=24에서 희소 보상 대비 2배 이상입니다. 트랙토리 레벨과 세그먼트 레벨의 차이도 길어질수록 커지는 게 포인트입니다.
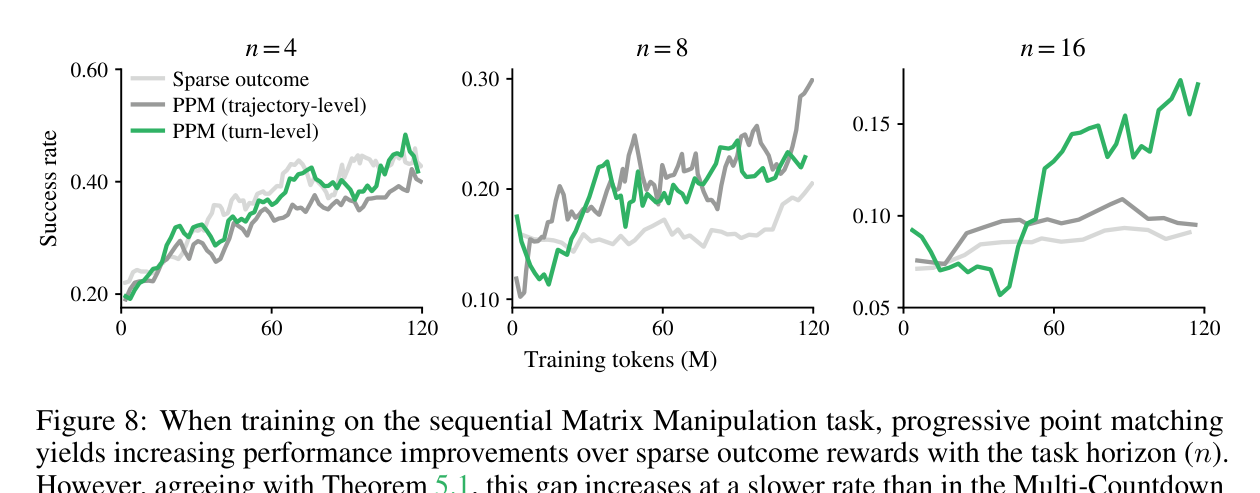
Figure 8 (원논문): Matrix Manipulation 학습 곡선. 출처: arXiv:2609.07303 Figure 8
판정자 φ를 만드는 검증 기준
합성 환경은 문자열 매칭으로 φ를 만들면 되지만, 일반 수학 추론에는 정답 중간 라벨이 없습니다. 논문의 검증 기준이 실용적입니다.
φ(s_t)가 잘 측정했다면, “s_t를 프롬프트에 넣고 이어서 풀게 했을 때 몬테카를로 성공률”이 φ와 선형 관계여야 합니다. 참조 접두를 점점 길게 주면서 두 값을 스윕해서 상관을 재면 판정자 품질을 측정할 수 있습니다. Gemini 판정자 프롬프트를 이 기준으로 튜닝해 Kendall 순위상관 0.856을 얻었습니다(일반 루브릭 프롬프트는 0.768).
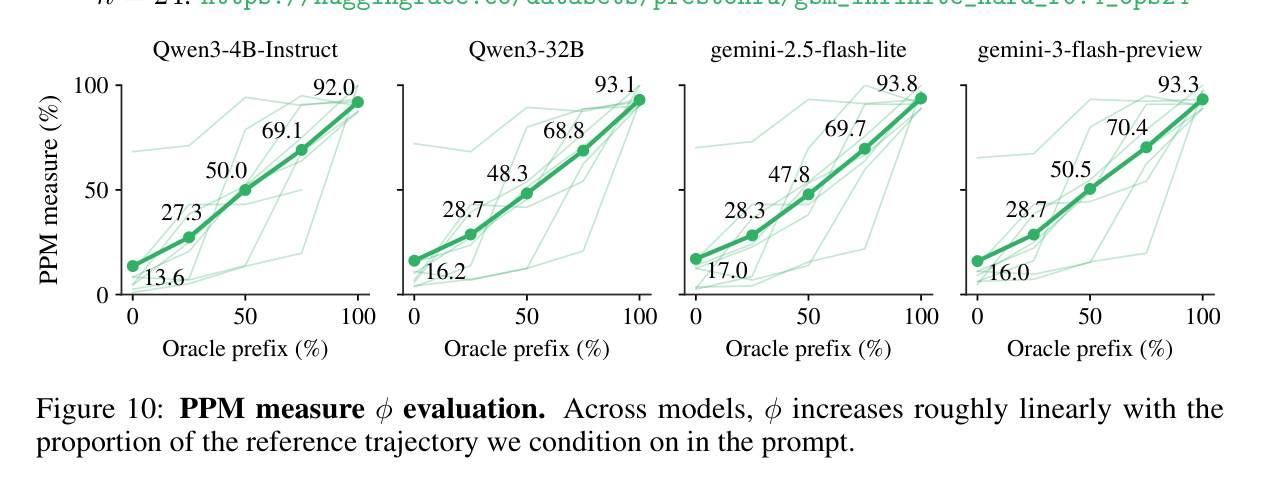
Figure 10 (원논문): 모델별 φ-반환 관계. 출처: arXiv:2609.07303 Figure 10
실제 수학 추론: 외삽과 거의 불가능한 문제
Polaris 데이터셋(검증 가능한 수치 답 + gemini-3-flash 오라클 해답)에서 Qwen3-4B를 8K 토큰 예산으로 학습하고 16K로 평가했습니다.
PPM은 AIME25 pass@1 0.459 / HMMT25 pass@1 0.379로 대부분 베이스라인을 앞서고, 특히 학습 예산보다 긴 추론 예산에서 성능이 외삽됩니다. SFT는 HMMT25에서 0.060으로 오히려 베이스(0.510)보다 크게 붕괴하는데, 모방학습의 분포 시프트 문제를 보여줍니다.
가장 강력한 결과는 POPE-hard입니다. 8K 토큰 16번 시도에서 베이스 Qwen3-4B-Instruct가 단 한 번도 성공하지 못하는(통합 pass rate 0.004, 4K에선 0) 문제들만 필터링한 세트입니다.
이런 데이터에선 희소 보상은 신호가 아예 없고, POPE(참조 접두 조건화 탐색)가 베이스라인 중 최선이지만 PPM이 전체 최고 성능을 냅니다.
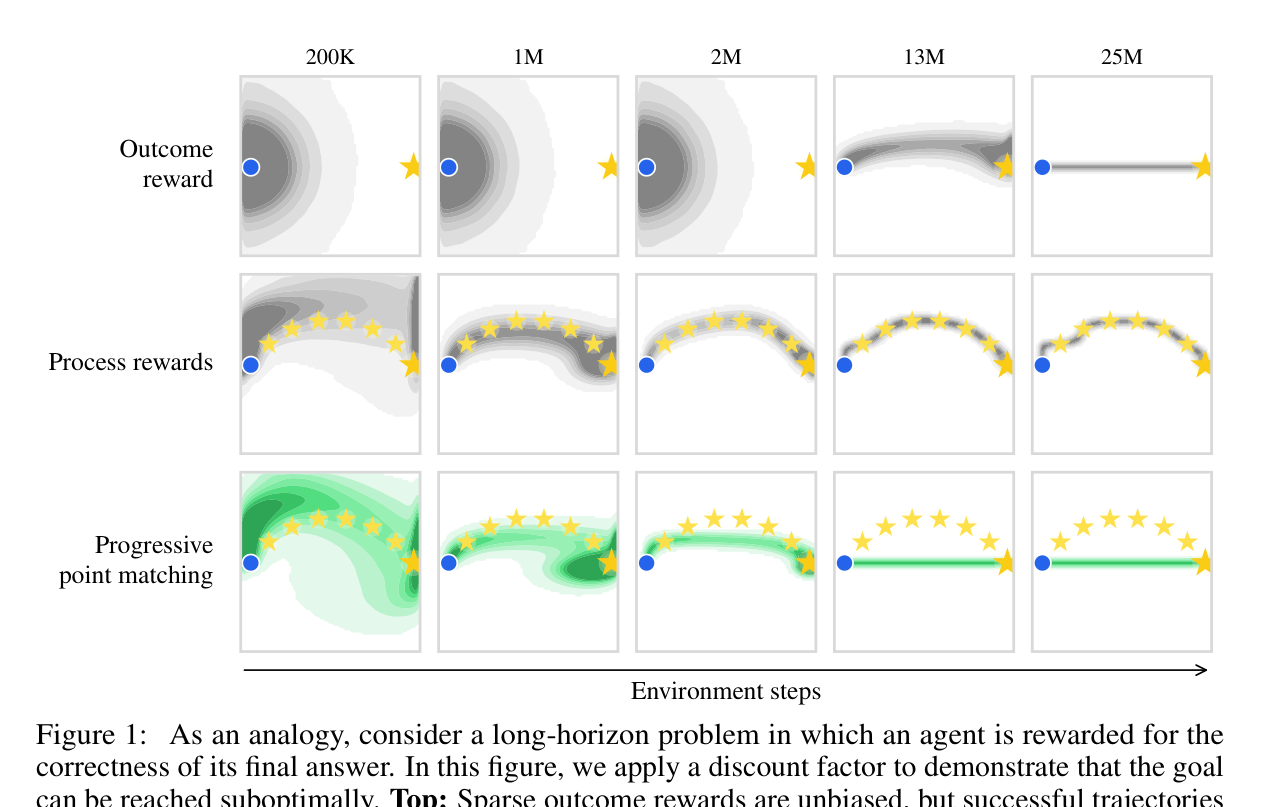
Figure 1 (원논문): 세 가지 보상 설계 비교 예시. 출처: arXiv:2609.07303 Figure 1
여기서 나온 반직관적 발견 하나: 4K 토큰 예산으로 학습한 정책이 8K로 학습한 것보다 16K 평가에서 낫습니다.
8K로 학습하면 예산 안에 끝내려는 탐욕적 단축 추론으로 길이가 붕괴하는데, 4K는 성공 자체가 불가능해 전 signal이 중간 지점 도달에서만 오기 때문입니다. 논문은 이걸 (i) 매우 짧은 예산 — 부분 진행 최대화, (ii) 중간 예산 — 길이 압박으로 탐욕 붕괴, (iii) 충분한 예산 — 완료 최적화의 3개 레짐으로 설명합니다. 세그먼트 레벨 보상을 쓸 때도 (ii) 레짐에선 탐욕 붕괴를 못 막는 게 한계로 명시돼 있습니다.
내 해석: 어디에 쓸 수 있나
제가 보기에 이 논문의 실용적 가치는 두 군데입니다.
데이터 필터링 관습을 뒤집을 수 있습니다. 지금은 “베이스 모델이 가끔이라도 풀 수 있는 문제”만 RL 훈련셋에 남기는데, PPM은 참조 해답만 있으면 성공률 0 문제에서도 학습됩니다. 어려운 문제를 버리지 않고 쓰는 경로가 열립니다.
또 하나는 문제당 참조 트랙토리 1개만 있으면 된다는 점입니다. 값비싼 process reward 모델이나 밸류 모델 학습 없이 GRPO에 모듈로 붙입니다. 다만 판정자 φ를 LLM(Gemini)으로 돌려야 하는 일반 추론 설정에선 판정자 비용과 품질(상관 0.856 수준)이 새 의존성으로 들어옵니다.
한계도 분명합니다. 실험 스케일이 Qwen3 1.7B~4B로 작고, 멀티턴 에이전트/코딩 같은 훨씬 긴 호라이즌은 미래 과제로 남아 있습니다. 세 레짐 중 (ii)에서의 탐욕 붕괴도 열린 문제입니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
PPM은 process reward model(PRM)과 무엇이 다른가요? PRM은 각 단계가 “논리적으로 올바른가”를 판정하는데, 논리적 정합성이 실제 성공과 상관 없을 수 있습니다. PPM은 정확성 판정 없이 참조 reasoning points에 도달했는가만 측정하고, 결과 보상과 최적 정책이 일치함이 증명됩니다.
PPM을 쓰려면 문제당 몇 개의 참조 해답이 필요한가요? 문제당 참조 트랙토리 1개면 됩니다. 그 하나에서 reasoning points를 뽑아 보상을 구성합니다.
PPM이 기존 GRPO 코드에 붙기 쉬운가요? 논문은 PPO/GRPO류 정책 그래디언트에 대한 모듈형 수정으로 제시합니다. 트랙토리를 세그먼트로 나누고 φ 증분으로 세그먼트 보상을 만들어 GRPO 그룹 정규화에 넣는 방식입니다.
희소 보상이 실패하는 정확한 조건은 무엇인가요? 태스크가 하위 문제 n개로 구성되고 각각 p 확률로 풀린다면 전체 성공 확률은 p^n입니다. n이 커질수록 성공 트랙토리 관측이 지수적으로 어려워져 정책 그래디언트 SNR이 Θ(p^(n/2))로 떨어집니다.
참고
- 원논문: Long-Horizon Language Model Reinforcement Learning via Progressive Point Matching (arXiv:2609.07303)
- HTML 버전: arxiv.org/html/2609.07303v1
- 수치 출처: 논문 Table 1(GSM-Infinite), Table 2(Polaris), Table 7·Figure 5(POPE-hard), Theorem 5.1, Proposition 4.1. 기준일 2026-09-15, arXiv v1.