결론 먼저
레포지토리 하나에 붙는 SKILL.md(에이전트에게 읽히는 .md 문서)를 자동 최적화하는 실험에서, GEPA가 만든 문서는 테스트 점수를 평균 4.9pp 올렸지만, 20~26개짜리 홀드아웃에서는 에이전트 실행 분산과 통계적으로 구분되지 않았습니다(최고 p=0.29). SkillOpt 문서는 사실상 제자리(+0.1pp)구요.
대신 정성 평가에서 차이가 명확했습니다. 실제 레포 메인테이너는 GEPA 문서를 “초안으로 받아서 다듬겠다”고 했고, SkillOpt 문서는 “일반론이 많다”고 평가 절반을 덜어냈습니다.
핵심 교훈은 이겁니다.
- 합성 태스크가 너무 쉬우면 최적화가 무의미해집니다. 결함 주입 방식은 유능한 에이전트가 문서 없이도 거의 다 풀어버립니다.
- 머지된 PR을 되돌려 만든 태스크는 더 어렵지만, 레포 하나에서 나오는 양이 적어서 통계 검정력이 부족합니다.
- 그래서 저자들의 결론은 “더 싼 롤아웃과 pass rate 이외의 평가 지표, 그리고 다수 리뷰어 검증이 필요하다”입니다.
핵심 요약
| 항목 | 값 |
|---|---|
| 논문 | Skill Issue: Lessons from Optimizing Repository SKILLs for Coding Agents (arXiv 2609.12742) |
| 대상 | Claude Code + Sonnet 4.6, 코딩 에이전트의 컨텍스트에 로드되는 단일 SKILL.md |
| 태스크 생성 | 머지된 PR을 단일 고정 베이스 커밋에서 되돌리기 (PR mirroring, JVM/Kotlin 재구현) |
| 최적화기 | GEPA(전체 재작성, Pareto frontier 기반) vs SkillOpt(증분 편집, 개선 게이트) |
| 결과 | GEPA 평균 +4.9pp, SkillOpt +0.1pp (p>0.05, 분산과 구분 안 됨) |
| 레포 | koog, kotest, ktor (Kotlin/JVM 3개) |
| 비용 | 3레포 × 2최적화기 총 $2,013.98, 69.2시간 |
| 정성 평가 | 메인테이너 1인: GEPA 문서 “초안으로 채택”, SkillOpt “일반론 과다” |
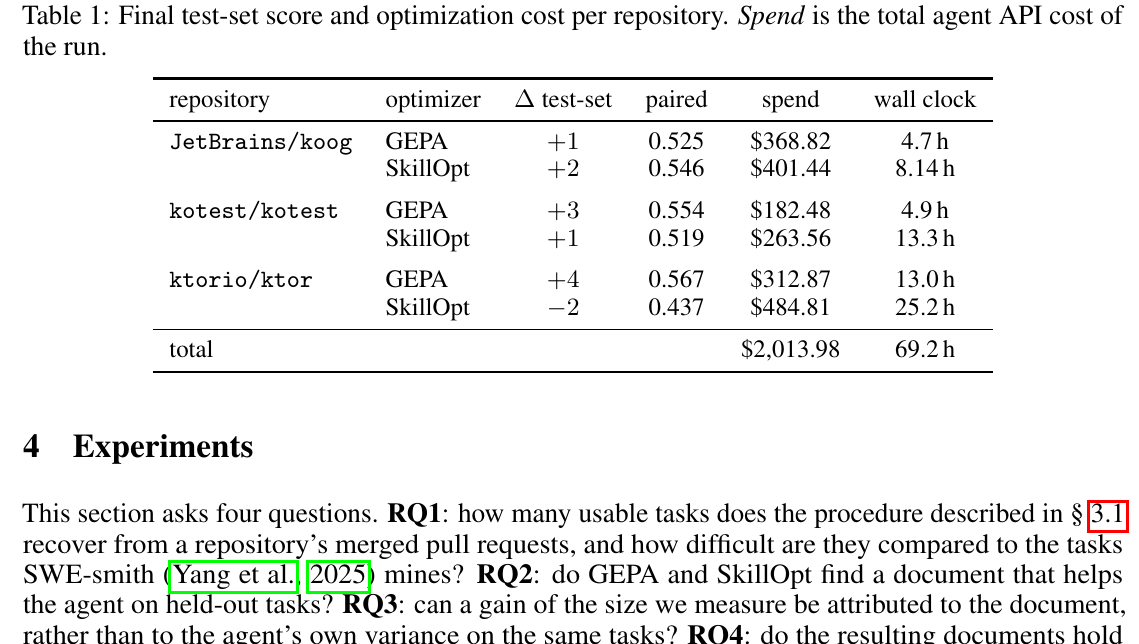
테스트 점수와 비용표입니다. 기준일: 2026-09-14, 전부 논문 보고값입니다.
배경: 레포 SKILL이 뜨는 이유
에이전트 메모리 연구는 임베딩 스토어, 검색 서비스, LLM-as-a-judge 갱신 루프 같은 레포 바깥에 상주하는 인프라를 요구하는 경우가 많았습니다. 반면 SKILL 방식은 .md 파일이 코드와 함께 버전 관리되고, PR로 리뷰되고, 그냥 머지됩니다.
규모도 이미 커졌습니다. AGENTS.md 포맷은 오픈소스 6만 개 프로젝트 이상에서 쓰이고, SKILL 스펙은 45개 이상 에이전트 도구에서 지원된다고 논문은 밝힙니다.
문제는 이 문서를 사람이 손으로 쓴다는 겁니다. 그래서 “에이전트 실행 로그에서 SKILL을 자동 합성하자”는 연구 라인이 나왔고, 이 논문은 그 중 단일 레포지토리 특화 SKILL 케이스를 다룹니다.
태스크: 결함 주입 대신 PR 되돌리기
기존 SWE-smith 스타일은 동작하는 코드에 결함을 심어 “고쳐라”는 태스크를 만듭니다. 근데 이렇게 만든 태스크는 대부분 단일 파일 수준이라, 유능한 에이전트가 SKILL 없이도 거의 다 풀어버립니다. 점수에 움직일 여지가 없다는 얘기죠.
저자들은 Kotlin을 타깃으로 잡았고(SWE-smith는 Python ast와 pytest를 가정해서 JVM을 못 다룸) PR mirroring 전략을 JVM에 재구현했습니다. 핵심 설계는 이겁니다.
- 머지된 PR을 스트리밍해서 구현/테스트 부분으로 분리
- SWE-bench식 “부모 커밋에서 테스트만 주고 구현 요청” 대신, 단일 고정 베이스 커밋에서 되돌리기
- .git을 지운 격리 체크아웃에서 실행(원본 변경을 훔쳐보지 못하게)
왜 고정 베이스인가. 부모 커밋 방식은 태스크마다 다른 시점의 레포를 붙잡습니다. 그러면 의존 PR 때문에 컴파일이 안 되는 태스크가 생기고, 최적화된 SKILL이 존재하지 않는 모듈 구조를 단정하는 낡은 지식을 담는 문제도 나왔다고 합니다.
수율은 대략 5개 중 1개입니다. koog 660개 PR → 119 태스크, ktor 452 → 131, kotest 100. 손실은 역적용 실패, 되돌려도 테스트가 안 깨지는 변경, 채점 불가 등에 분산돼 있어요.
최적화: GEPA vs SkillOpt
둘 다 “자연어 문서를 최적화 대상으로 삼고 에이전트 롤아웃을 반성해서 편집 제안”한다는 점은 같습니다. 차이는 편집 방식이에요.
| GEPA | SkillOpt | |
|---|---|---|
| 후보 관리 | Pareto frontier에서 샘플링 | 단일 진화 문서 |
| 편집 단위 | 전체 재작성 | add/delete/replace 증분 편집 |
| 수용 규칙 | 미니배치 개선 시 풀 추가 | 홀드아웃 엄격 개선 게이트 |
| 편집 예산 | - | 학습률처럼 감쇠하는 edit budget |
인프라가 없다는 조건을 지키기 위해 둘 다 채택했다고 합니다. 평가는 후보 실행과 시드(빈 문서) 실행을 같은 태스크에서 짝지어 비교하는 paired 방식이고요.
결과: 점수는 오르는데 통계는 안 잡힌다
홀드아웃에서 GEPA 문서의 점수는 kotest 0.554(16/20… 정확히는 20개 중 16), ktor 0.567(26 중 20), koog 0.525(23 중 15)로 시드 대비 전부 상승했습니다. SkillOpt는 koog 0.546, kotest 0.519로 소폭 오르고 ktor 0.437로 떨어졌습니다.
문제는 RQ3입니다. 문서가 아무 효과 없으면 두 롤아웃이 교환 가능하니 절반씩 이겨야 하는데, 부호 검정으로는 어떤 실행도 p=0.05를 못 넘었습니다(최고 p=0.29). 20~26개 규모에서 유의해지려면 다섯 번 중 네 번을 이겨야 하고, 69개 풀어도 셋 중 둘이 필요해요.
이 라인의 선행 연구 보고 효과도 전부 이 선 아래에 있다는 게 논문의 정직한 지적입니다. pass rate 백 개짜리로는 감도가 부족하다는 거죠.
메인테이너 리뷰: 숫자보다 문서가 낫다
RQ4에서 koog 메인테이너가 문서를 섹션별로 읽었습니다. GEPA 문서에서 건질 만하다고 표시한 부분은 전부 프로젝트에 몸담지 않으면 얻을 수 없는 지식이었습니다.
- 멀티플랫폼 소스셋: “우리가 여기서 많이 고생했다, 에이전트는 보통 여기서 뭘 해야 할지 모른다”
- 소스셋 경계를 넘지 말라는 규칙: “전부 맞다, 잘 넣었다”
- 모듈 간 의존성 방향: “매우 중요”
빠진 것도 구체적이었습니다. @Tool 어노테이션(코틀린 함수를 도구로 만드는 가장 단순한 방법)이 빠진 건 “very strange”, expect/actual에서 팀이 쓰는 중복 회피 패턴이 빠진 것도 지적됐습니다.
SkillOpt 문서에서는 “새 모듈 등록이 3파일 변경”이라는 항목 하나만 “great and important”로 꼽혔고, 나머지는 “에이전트가 스스로 알아야 할 일반론”이라고 잘렸습니다. 메인테이너 원칙이 재밌는데요, 일반 베스트 프랙티스는 글로벌 스킬로, 레포 특화 조각만 레포에 남겨라입니다.
“PR로 도착하면 머지하겠나”라는 질문에는 GEPA 문서를 “초안으로 받아 다드겠다”고 답했습니다.
한계와 시사점
저자들이 스스로 적은 한계가 이 실험 전체의 결론이기도 합니다.
- 태그 100개는 3-way 스플릿을 만드는 최소 조건일 뿐, 검정력을 보증하지 않는다
- tracy는 패키지 개명 때문에 역적용이 전부 실패했다(203개 중 5개 생존). http4k는 검증에서 100개 미달이었다. 레포 채굴이 항상 태스크 풀을 보장하지 않는다
- 메인테이너 평가는 1인 1레포, 다수 리뷰어 검증이 필요
실무자 관점에서 가져갈 것:
- SKILL 자동 최적화를 돌릴 거면 태스크 난이도부터 확인하세요. 시드 상태 통과율이 이미 높으면 최적화가 붙일 게 없습니다.
- 작은 홀드아웃에서 몇 pp 오른 건 런-to-런 분산일 가능성이 큽니다. 부호 검정 한 번은 돌려보세요.
- 문서 품질 평가는 pass rate보다 레포를 아는 사람의 리뷰가 낫습니다. 이 논문에서 유일하게 확실하게 갈린 지표에요.
더 실습해보고 싶은 분들께
자주 묻는 질문
SKILL.md 자동 최적화는 지금 실사용 가능한가요?
점수 상승이 통계적으로 확정되지 않았습니다. 다만 메인테이너 정성 리뷰에서 GEPA 문서는 초안으로 채택할 가치가 있다고 나왔으니, “자동 생성 초안 + 사람이 다듬기” 워크플로우로 쓰는 게 이 논문 기준 합리적입니다.
기존 결함 주입 방식 대비 장점은 뭔가요?
머지된 PR을 되돌려 만든 태스크가 더 어려워서, 유능한 에이전트에게도 SKILL이 영향을 줄 여지가 생깁니다. 결함 주입 태스크는 문서 없이도 거의 다 풀립니다.
왜 Kotlin 레포였나요?
SWE-smith의 엔티티 추출이 Python ast에, 하네스가 pytest에 묶여 있어 JVM을 지원하지 않기 때문입니다. 저자들은 PR mirroring을 JVM에 재구현했습니다.
AGENTS.md와 SKILL의 관계는 뭔가요?
둘 다 레포 안에 사는 .md 지식 파일 포맷입니다. AGENTS.md는 오픈소스 6만 개 이상 프로젝트에서 쓰이고, SKILL 스펙은 45개 이상 에이전트 도구에서 지원된다고 논문은 밝힙니다.
출처
- 논문: Skill Issue: Lessons from Optimizing Repository SKILLs for Coding Agents (arXiv 2609.12742)
- 실험 코드/부록: 논문 부록 A~J (문서 원문, 커버리지 통계 포함)
- 기준일: 2026-09-14, 본문 수치는 전부 논문 보고값이며 내 해석은 별도 표기 없이 서술부에 담았습니다.