결론 먼저
Fudan NLP 연구팀이 공개한 Sci-MMR 벤치마크는 멀티모달 연구 에이전트를 “정답 맞혔는가”만으로 평가하면 안 되는 이유를 수치로 보여줍니다.
핵심은 이겁니다.
- 8개 최전선 모델 모두 정답 정확도가 완전 증거 복원률보다 20% 이상 높게 나왔습니다. 정답은 맞췄는데 근거는 절반쯤 복원한 케이스가 구조적으로 많다는 뜻입니다.
- 오류의 57.2%는 증거 확보 문제, 31.8%는 증거 해석 문제입니다. 즉 그림을 읽어 증거를 모으는 단계와 모은 증거를 결론으로 연결하는 단계가 별개의 실패 축이라는 진단입니다.
- 정답 증거를 아예 줘도 최강 모델도 어려운 과제에서 69.1% 정확도에 그칩니다.
핵심 요약 표
| 항목 | 값 |
|---|---|
| 논문 | Sci-MMR (arXiv 2609.11243, 2026-09-10) |
| 소속 | Fudan NLP Group |
| 과제 수 | 235개 멀티홉 과제 |
| 범위 | 4개 학문 분야, 35개 도메인 |
| 과제당 그림 패널 | 평균 9개 |
| 출처 논문 | Nature, Science, Cell, PNAS 등 800편 (2020–2026) |
| 평가 모델 | 8개 (GPT-5.5, Claude Opus 4.8, Gemini 3.1 Pro 등) |
| 최고 정확도 (Direct) | GPT-5.5 67.7% |
기준일: 2026-09-14 기준, arXiv v1 초록과 본문 수치입니다.
벤치마크 구성
Sci-MMR은 각 과제를 Argument Graph로 표현합니다. 그림 패널(시각 노드) → 관찰 문장(증거 노드) → 인용 지식(지식 노드) → 중간 주장 → 최종 결론 순으로 이어지는 DAG 구조입니다.
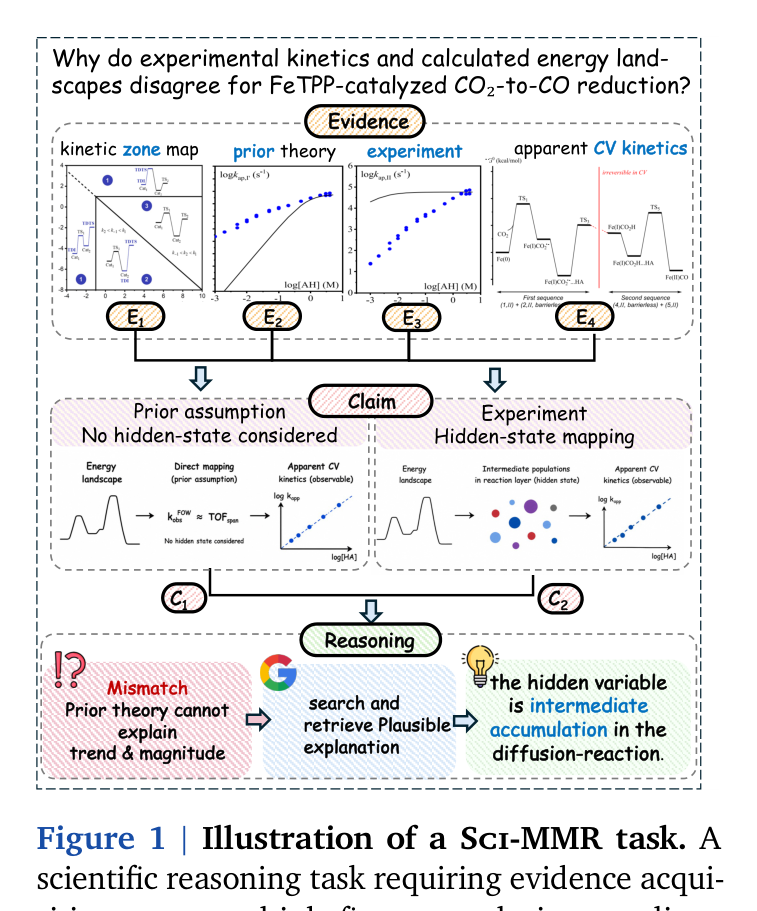
Figure 1. 여러 그림 패널을 넘나들며 증거를 수집하고, 중간 주장을 거쳐 전제를 검증하는 과제 예시. 출처: arXiv 2609.11243 Figure 1.
구축 파이프라인은 사람-자동화 혼합입니다.
- MinerU로 논문에서 그림/표/캡션 추출
- LLM이 초기 Argument Graph 생성, 인용 문헌에서 지식 노드 검색
- 도메인 전문가가 증거를 시각 영역에 위치시키고 문장을 다듬음
- 결정적 필터로 54% 탈락, 8차원 LLM 품질 루브릭으로 추가 17% 필터
- 전문가 최종 검수
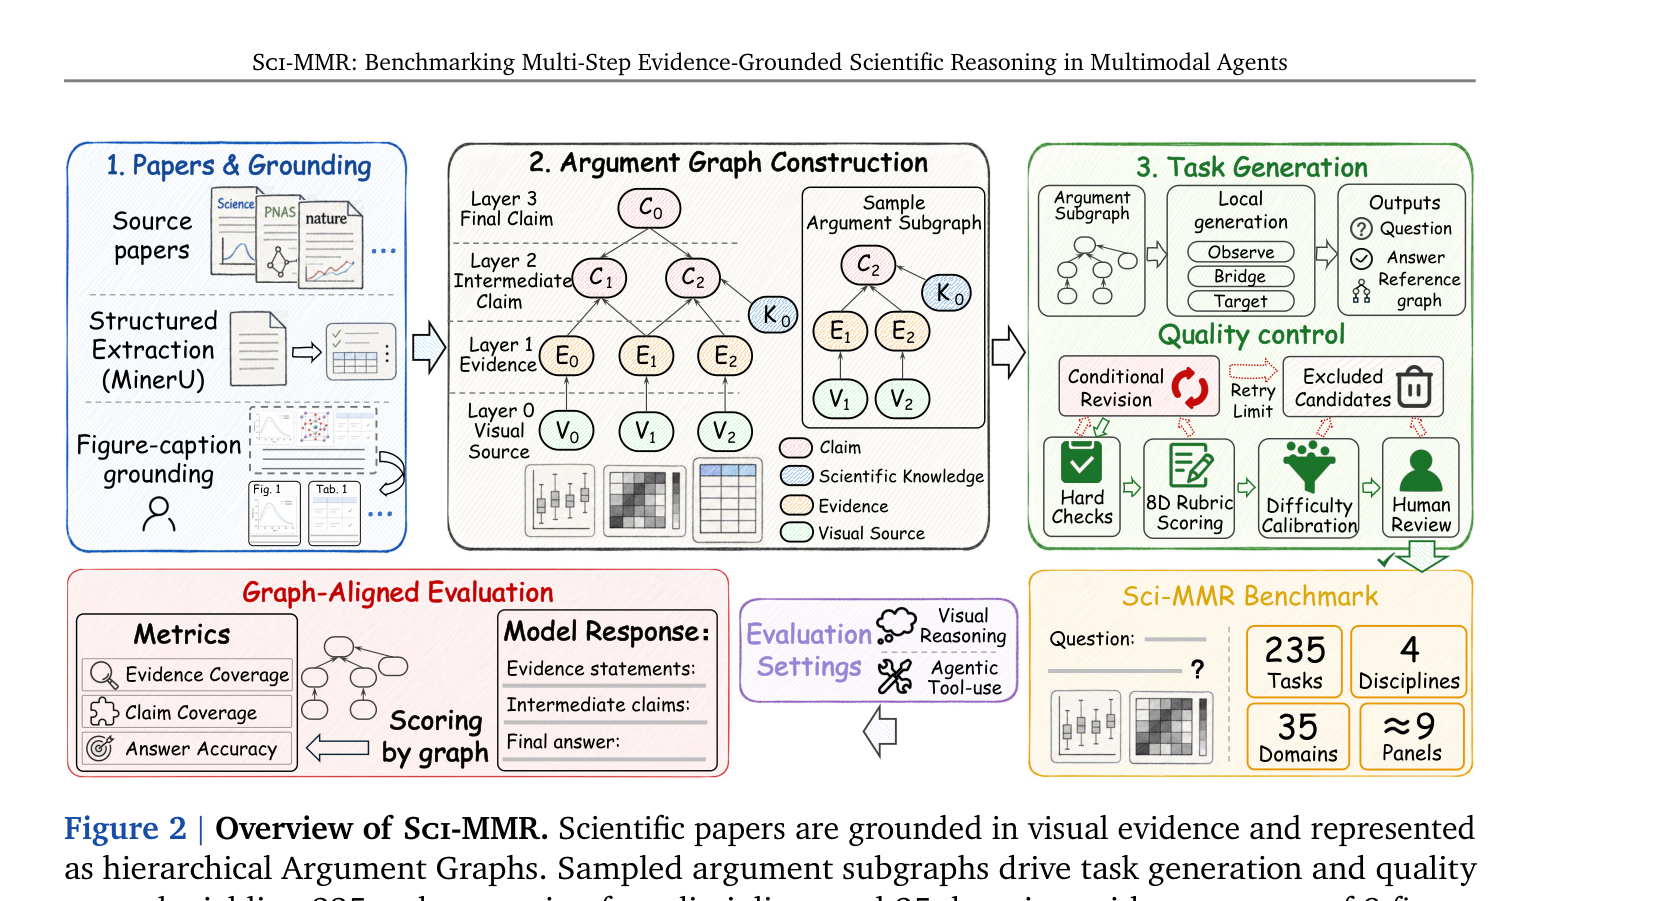
Figure 2. 논문을 Argument Graph로 변환하고 과제를 샘플링해 235개 과제를 만드는 전체 파이프라인. 출처: arXiv 2609.11243 Figure 2.
4가지 평가 설정
같은 과제를 조건을 달아 4번 평가합니다.
| 설정 | 입력 | 측정 대상 |
|---|---|---|
| Caption-only | 캡션 텍스트만 | 텍스트만으로 풀리는 정도 |
| Direct Visual Reasoning | 질문 + 원본 그림 | 자율 증거 획득 포함 전체 |
| Evidence-Hint | 질문 + 그림 + 정답 증거 문장 | 증거 통합 능력 단독 |
| Agentic Tool-Use | 질문 + 그림 + 크롭/확대 도구 | 대화형 증거 획득 효과 |
메트릭도 3개로 나뉩니다. Answer Accuracy(최종 결론 일치), Evidence Coverage(필요 증거를 응답에 실제로 표현했는가), Claim Coverage(중간 주장을 복원했는가).
결과: 정답률과 증거 복원이 갈라진다
Direct Visual Reasoning 전체 순위입니다.
| 모델 | 정확도 | 비고 |
|---|---|---|
| GPT-5.5 | 67.7% | 최고 성적 |
| Claude Opus 4.8 | 54.9% | |
| Kimi K2.7 Code | 50.6% | |
| MiniMax-M3 | 45.5% | E-Cov 61.5%, C-Cov 51.7%로 커버리지는 1위 |
| Intern-S2-Preview | 26.8% | 최하위 |
눈에 띄는 패턴 두 개입니다.
첫 번째, 난이도 붕괴. GPT-5.5는 쉬운 과제 96.8%에서 어려운 과제 29.6%로 떨어집니다. MiniMax-M3는 93.5%에서 4.9%까지 추락해서 낙폭이 가장 큽니다.
두 번째, 커버리지-정답률 분리. MiniMax-M3는 증거 커버리지와 주장 커버리지에서 모두 1위인데 정답률은 5위입니다. 근거를 많이 모아도 결론으로 연결하지 못하는 모델이 실제로 존재합니다.
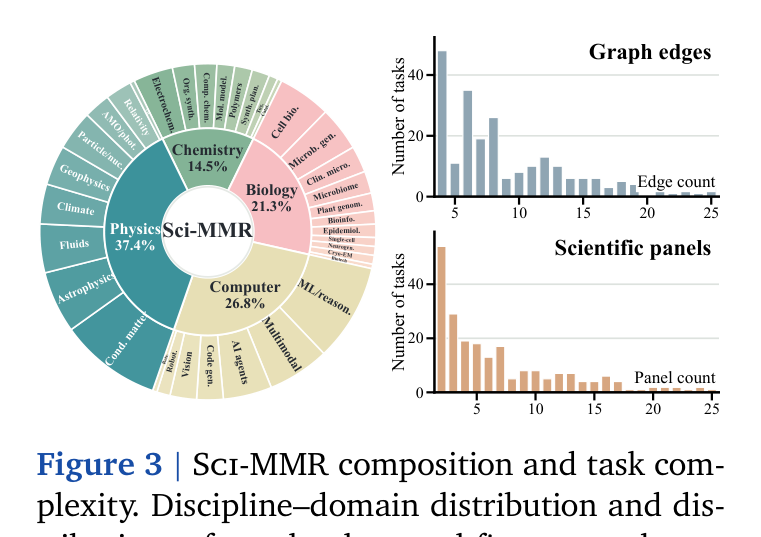
Figure 3. 분야별 분포와 과제당 그래프 엣지/그림 패널 수 분포. 출처: arXiv 2609.11243 Figure 3.
정답 증거를 줘도 부족하다
Evidence-Hint 설정에서 정답 증거 문장을 그대로 줬을 때의 변화입니다.
- 모델 평균 정확도는 46.1% → 73.5% (+27.4점)로 오릅니다.
- 어려운 과제 평균은 그래도 54.8%에 그칩니다.
- 최하위 Intern-S2는 +33.6점, 최상위 GPT-5.5는 +19.1점. 약한 모델일수록 증거 확보가 발목을 잡았다는 신호입니다.
증거 제공은 필요조건이지 충분조건이 아니다가 논문의 RQ1 결론입니다.
크롭 도구를 준 Agentic Tool-Use도 마찬가지입니다. Claude Opus 4.8가 +5.1점으로 최대 개선이고, GPT-5.5는 69.8%까지 오르지만 격차는 닫히지 않습니다. 크롭 도구는 +4.5점 수준의 modest한 이득입니다.
오류를 해부하면
잘못된 응답 전부를 6개 유형으로 분해한 결과입니다.
| 오류 유형 | 비중 | 축 |
|---|---|---|
| 접근/지역화 실패 | 40.1% | 증거 |
| 골드 증거 미활용 | 14.0% | 증거 |
| 시각 추출 오류 | 3.1% | 증거 |
| 해석 실패 | 27.5% | 추론 |
| 최종 답 불일치 | 4.2% | 추론 |
| 기타 | 11.0% | — |
접근/지역화 실패가 모든 모델에서 최대 오류 유형입니다 (Claude 37% ~ Kimi 48%). 크롭 호출이 발생한 실행 중 요구 영역을 최소 하나 맞춘 비율은 62.1%, 전부 맞춘 비율은 12.7%에 불과합니다. 관련 영역을 하나 찾는 것과 필수 영역 전체를 모으는 것은 다른 능력입니다.
내 해석을 붙이면, 이 수치는 딥리서치 에이전트 설계에 직접적인 함의가 있습니다. RAG나 검색으로 텍스트를 긁어오는 파이프라인은 이제 흔한데, 논문의 핵심 근거 상당수가 그림 패널에 분산되어 있다는 게 이 벤치마크의 출발점입니다. 그림 증거 수집을 전제하지 않은 리서치 에이전트 평가는 정답률만 믿다가 근거 없는 결론을 놓치기 쉽습니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
Sci-MMR에서 정답률과 증거 복원률의 격차는 얼마나 되나요?
8개 모델 모두 정답 정확도가 완전 증거 복원률보다 20% 이상 높았습니다. 정답 중심 평가가 증거 기반 추론 능력을 과대평가한다는 것이 논문의 핵심 측정 결과입니다.
증거를 직접 주면 성능이 오르나요?
평균 +27.4점(46.1%→73.5%) 올라갑니다. 다만 어려운 과제 평균은 54.8%, 최강 모델도 어려운 과제에서 69.1%에 그쳐 증거 통합 자체가 남은 병목입니다.
크롭 도구를 주면 해결되나요?
아니요. 크롭 도구의 이득은 약 +4.5점으로 modest하고, 최대 모델 개선(Claude Opus 4.8)도 +5.1점입니다. 필수 영역 전체를 모으는 능력이 부족해서입니다.
어떤 모델이 가장 강했나요?
Direct Visual Reasoning과 Agentic Tool-Use 모두 GPT-5.5가 1위(67.7% / 69.8%)입니다. 쉬운 과제 96.8%에서 어려운 과제 29.6%로 하락해도 어려운 부분에서 최강을 유지했습니다.
참고 자료
- 원문: arXiv:2609.11243 — Sci-MMR: Benchmarking Multi-Step Evidence-Grounded Scientific Reasoning in Multimodal Agents
- HTML 버전: https://arxiv.org/html/2609.11243v1
- DOI: https://doi.org/10.48550/arXiv.2609.11243
원문 근거와 내 해석 구분: 수치와 인용은 전부 arXiv 2609.11243 v1 기준이고, “딥리서치 에이전트 설계 함의” 문단은 제 해석입니다.