결론 먼저
LLM 에이전트가 내는 액션은 에러 없이 조용히 실패(silent failure)하는 경우가 핵심 위험입니다. 이 논문은 셸 명령과 코드 편집 두 가지 액션에 대해 실행 전 결정론적 검증(pre-action verification)을 걸면 얼마나 막을 수 있는지 측정했습니다. 핵심 숫자는 입니다.
| 항목 | 내용 |
|---|---|
| 논문 | Look Before You Leap: Pre-Action Verification for LLM Agents (arXiv:2609.11957) |
| 핵심 주장 | 실행 전 저렴한 정적 검증이 모델 호출 없이 조용한 실패를 거의 제거한다 |
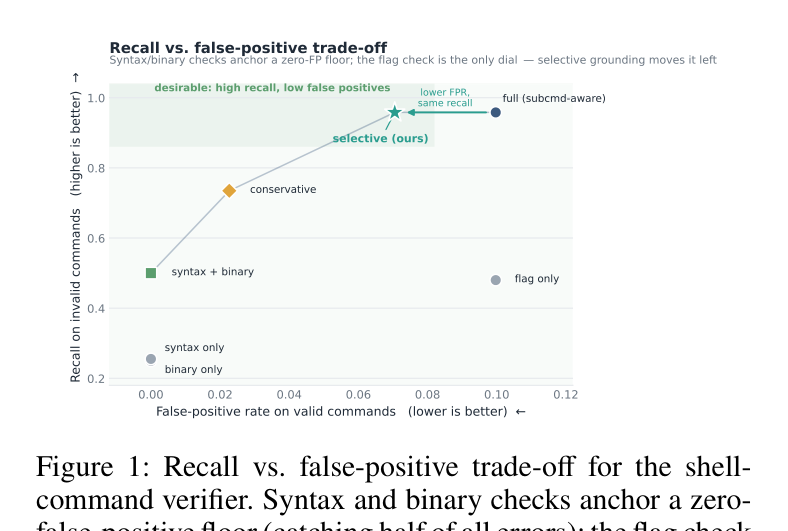
| 셸 명령 | 9,930개 명령·482개 도구에서 무효 명령 95.8% 검출(위양성 10.0%) |
| 코드 편집 | 라인 번호 편집은 1줄 밀림에 99.1% 파일 손상 |
| 가드 적용 후 | Robust-Apply는 8,320회 시행 중 조용한 오적용 1건(0.01%) |
| 검증 비용 | 마이크로초~밀리초, 모델 호출 0회 |
| 저자/소속 | Asaad Althoubi, Oklahoma State University |
기준일: 2026-09-14 기준, arXiv v1 본문을 근거로 정리했습니다. 원문: arXiv:2609.11957
문제 정의: 조용한 실패
에이전트가 세상에 작용하는 방식은 액션을 내보내는 겁니다. 셸 명령을 실행하거나, 코드 편집을 적용하습니다.
문제는 잘못된 액션이 항상 크게 실패하지 않는다는 겁니다. 그럴듯한 결과를 내면서 조용히 틀리는 경로가 실제로 존재합니다.
- 에러가 나는 실패(clean failure): 복구 가능
- 에러가 안 나는 실패(silent failure): 관측으로는 절대 발견되지 않음
논문의 제안은 액션의 올바른 효과를 실행 전에 구성으로 고정하는 겁니다. 그러면 조용한 실패를 직접 측정할 수 있고, 검증기는 확실하지 않을 때 판단 대신 기권(abstain)하면 됩니다.
셸 명령 정적 검증 결과
벤치마크 구성이 특이합니다. 유효 명령 1,986개는 tldr 코퍼스에서 뽑고, 무효 명령은 존재하지 않는 바이너리·잘못된 문법·잘못된 롱옵션·잘못된 숏옵션 4종으로 변이해 만들었습니다.
검증기가 검사하는 규칙으로 벤치마크를 만들면 자기합격(self-consistency)만 측정하게 되니까, 검증기와 독립적인 행동 오라클(behavioral oracle)로 무효성을 확정한 게 핵심입니다.
검증기는 3가지 검사를 돌립니다. bash -n 문법 검사, which 바이너리 존재 검사, --help에서 추출한 플래그 집합 대조습니다. 서브커맨드 인식이라 git commit 플래그와 git 플래그를 분리 처리합니다.
| 무효 카테고리 | 검출률 |
|---|---|
| 존재하지 않는 바이너리 | 1.000 |
| 잘못된 문법 | 1.000 |
| 잘못된 롱 플래그 | 0.916 |
| 잘못된 숏 플래그 | 0.916 |
문법·바이너리 검사는 위양성 0의 오라클-정확(exact) 코어고 전체 오류의 절반을 잡습니다. 플래그 검사는 헬프텍스트 커버리지(91.1%)에만 제한되고, 모든 위양성이 여기서 나옵니다.
코드 편집 포맷별 안전성 결과
640개 편집·224개 파일로 apply 단계만 분리해서 측정했습니다. 결과가 극명하게 갈립니다.
- 콘텐츠 앵커 포맷(search/replace, unified diff): 실패해도 깨끗하게 실패
- 위치 앵커 포맷(라인 번호, 함수명): 조용히 실패
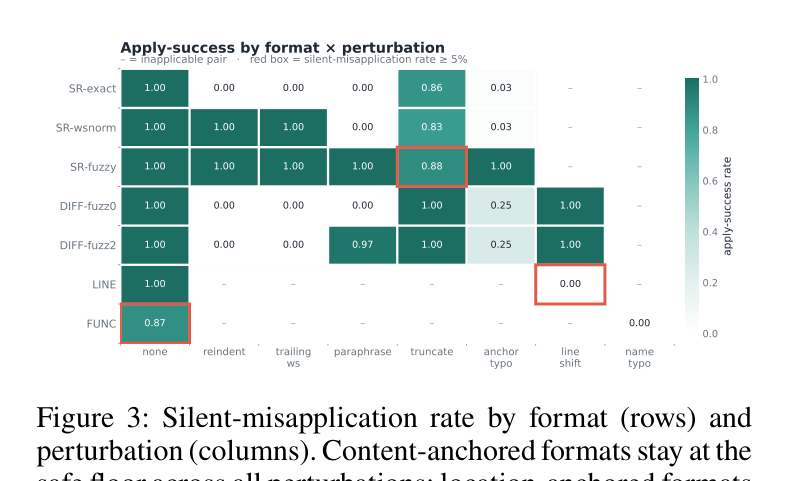
구체적인 숫자입니다. 라인 번호 편집은 1줄 밀림 perturbation에서 99.1% 파일을 손상시킵니다. 함수명 편집은 12.7% 확률로 엉뚱한 함수를 수정합니다. 반면 unified diff는 자기 콘텍스트를 독립적으로 검증하니까 퍼지 0이든 2이든 조용한 실패가 0입니다.
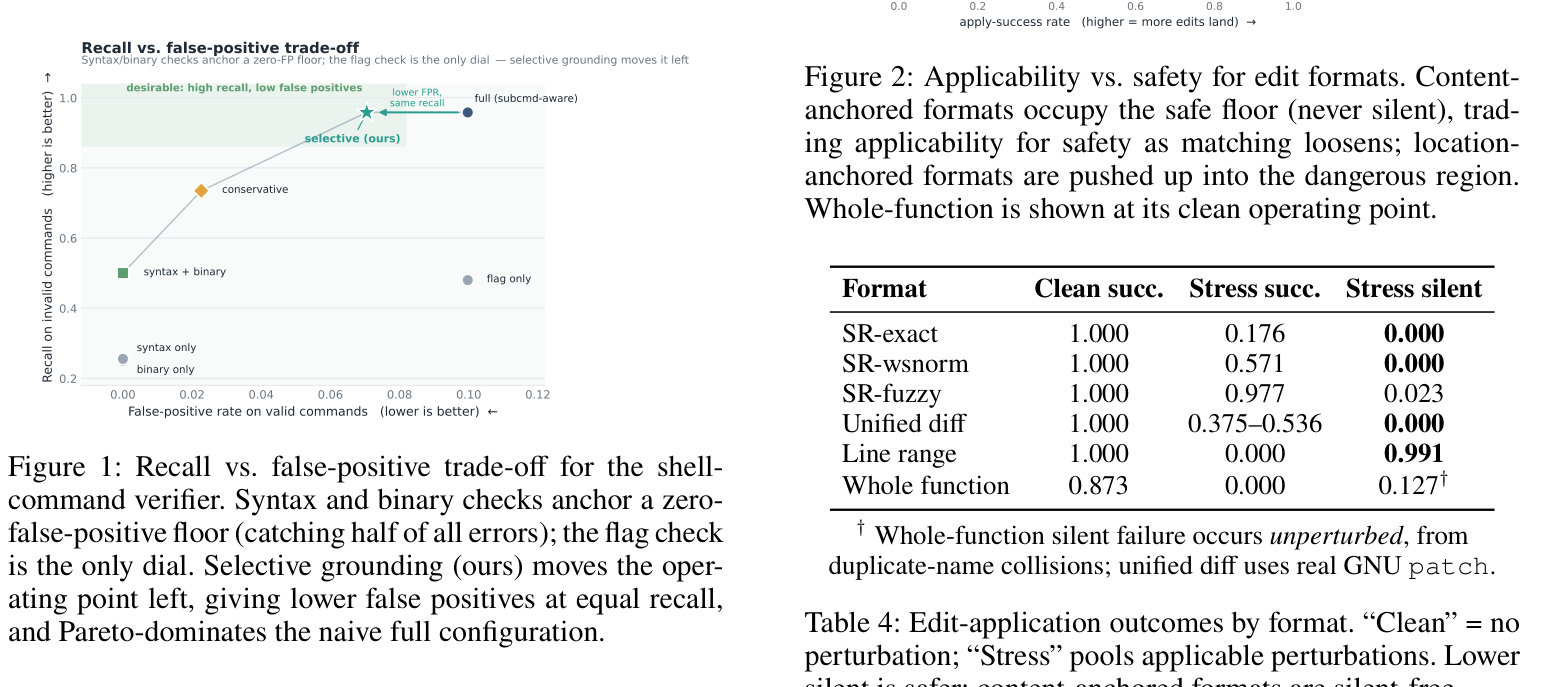
멀티헝크 편집에서는 더 흥미로운 분화가 나옵니다. SR-fuzzy는 단일 편집에선 2.3%로 안전합니다. 그러나 헝크가 늘며 앵커가 짧아지면 조용한 실패율이 39.3%까지 치솟고 기각률이 0이라 전부 복구 불가로 갑니다. requests 라이브러리 서드파티 재현에서도 같은 패턴이 유지됩니다. 포맷 자체의 문제로 보는 게 맞습니다.
배포 가능한 가드 구조
논문은 두 가지 실사용 가드를 제안합니다.
| 가드 | 대상 | 운영점 |
|---|---|---|
| Selective grounding (2단계 게이트) | 셸 명령 | R 0.958 @ FPR 0.070 |
| Robust-Apply (앵커-검증 메타어플라이어) | 코드 편집 | 8,320회 중 조용한 오적용 1건 |
Robust-Apply는 포맷 비의존 메타어플라이어입니다. 최소 앵커 크기 Kmin=2, 유사도 상한 τhi=0.90, 차등 δ=0.20을 충족할 때만 real patch로 커밋하습니다. 애매하면 거부합니다. 확실하지 않으면 적용을 거부하는 정책이 조용한 실패를 복구 가능한 실패로 바꿉니다.
두 모달리티의 공통 구조 분석
저자의 종합이 깔끔합니다. 두 설정 모두 같은 구조를 가집니다.
오라클-정확 코어(문법+바이너리, exact/ws-norm 매칭)가 있고, 커버리지에 제한된 부분(플래그 추출, 퍼지 매칭)이 나머지 적용률을 사면서 유일한 오류원이 됩니다. 위험한 표현은 정확히 콘텐츠 검증이 불가능한 것들 — 참조에 없는 플래그, 앵커 없는 라인 번호·함수명. 이런 표현은 맞는 대상과 틀린 대상을 구분 못 하니까 조용히 실패합니다.
이 원칙은 다른 액션으로도 확장됩니다. 파일 연산은 경로 존재·쓰기 가능 확인, API 호출은 스키마 검증 후 확실할 때만, DB 쓰기는 커밋 전 제약 검사입니다.
설계 질문은 항상 같습니다. 위반 시 확실히 틀리다는 걸 증명할 수 있는 오라클-정확 속성이 있고, 액션을 매칭할 콘텐츠 앵커가 있는가.
한계와 실무 적용 판단
논문 스스로 밝힌 한계도 정직합니다. bash -n은 불완전한 조각을 거부하고 which는 alias·셸 함수·세션 PATH를 못 봅니다.
실제 모델 출력 프루빙은 42개 명령·9개 편집으로 가볍고, 실제 에러 분포에 대한 검출률은 아직 추정 안 됨이라 멀티모델 트라젝토리 연구가 다음 단계입니다.
내 판단을 붙이면, 하네스 설계자에게 바로 쓸 수 있는 교훈이 입니다. 에이전트의 편집 인터페이스에 라인 번호 포맷을 쓰고 있다면 이 논베이스로 바꾸는 걸 진지하게 검토해야 합니다.
그리고 self-refine은 에러가 관측된 뒤의 수정이고, pre-action 검증은 관측 자체가 안 되는 조용한 실패를 다룬다는 구분이 두 접근을 조합하는 지점입니다.
더 실습해보고 싶은 분들께
자주 묻는 질문
- LLM 에이전트의 조용한 실패(silent failure)란 무엇인가요? — 에러 없이 그럴듯한 결과를 내면서 틀리는 실패입니다. 라인 번호 편집이 대표적이며 1줄 밀림만으로 99.1%의 파일이 손상되지만 실행 에러는 나지 않습니다.
- 실행 전 검증(pre-action verification)은 어떻게 동작하나요? — 액션이 실행되기 전에 문법·바이너리 존재·플래그 유효성 같은 정적 검사를 돌리고, 확실하지 않으면 기권합니다. 셸 명령에서 무효 명령의 95.8%를 위양성 10.0%로 검출합니다.
- 코드 편집에서 가장 안전한 포맷은 무엇인가요? — unified diff와 exact search/replace입니다. 콘텐츠 앵커로 위치를 찾기 때문에 실패해도 깨끗하게 실패하고, 라인 번호·함수명 포맷은 조용히 실패합니다.
- 검증 비용은 얼마나 드나요? — 마이크로초에서 밀리초 수준이고 모델 호출이 없습니다. Robust-Apply는 8,320회 시행에서 조용한 오적용 1건(0.01%)을 기록했습니다.
- 기존 self-refinement와 어떻게 다른가요? — self-refinement는 에러가 관측된 뒤 수정하고, pre-action 검증은 관측되지 않는 조용한 실패를 실행 전에 차단합니다. 상호 보완적입니다.